जो OCR विशेषज्ञ कभी उस नौकरी के लिए प्रशिक्षित नहीं हुआ
आधारित शोध-पत्र: Multi-Expert Routing for Multi-Domain Low-Resource OCR: A Manchu Case Study — Zhan Chen, Jiqiao Ma, Chih-wen Kuo
मुझे चौंका देने वाला निष्कर्ष
मुझे चौंका देने वाला निष्कर्ष यह था: शोधकर्ताओं ने एक ऐसा सिस्टम बनाया जो 17वीं सदी के मंचू (Manchu) हाथ से लिखे हुए दस्तावेज़ों की किसी भी पृष्ठ के लिए सर्वोत्तम OCR मॉडल का चयन करता है, और तीन में से दो बार, जिस मॉडल का चयन किया गया, उसे उस प्रकार के लेखन को पढ़ने के लिए वास्तव में कभी प्रशिक्षित नहीं किया गया था। यह किसी और चीज़ के लिए प्रशिक्षण के एक उप-प्रभाव (side effect) के रूप में इसमें कुशल हो गया था, और जब तक वे जाँच नहीं की, तब तक किसी को इसकी जानकारी नहीं थी।
यह वह प्रकार का परिणाम है जो तब तक एक बग रिपोर्ट (bug report) जैसा लगता है जब तक आप पेपर (Zhan Chen, Jiqiao Ma, और Chih-wen Kuo द्वारा arXiv 2607.14041) को नहीं पढ़ लेते और यह नहीं समझ लेते कि यह वास्तव में एक समस्या से निपटने का एक समझदारी भरा तरीका है जिसका सामना OCR टीमों को लगातार करना पड़ता है: पर्याप्त लेबल किया गया डेटा नहीं होना, और ऐसे दस्तावेज़ जो सभी एक जैसे नहीं दिखते।
मंचू भाषा OCR के लिए एक सिरदर्द क्यों है
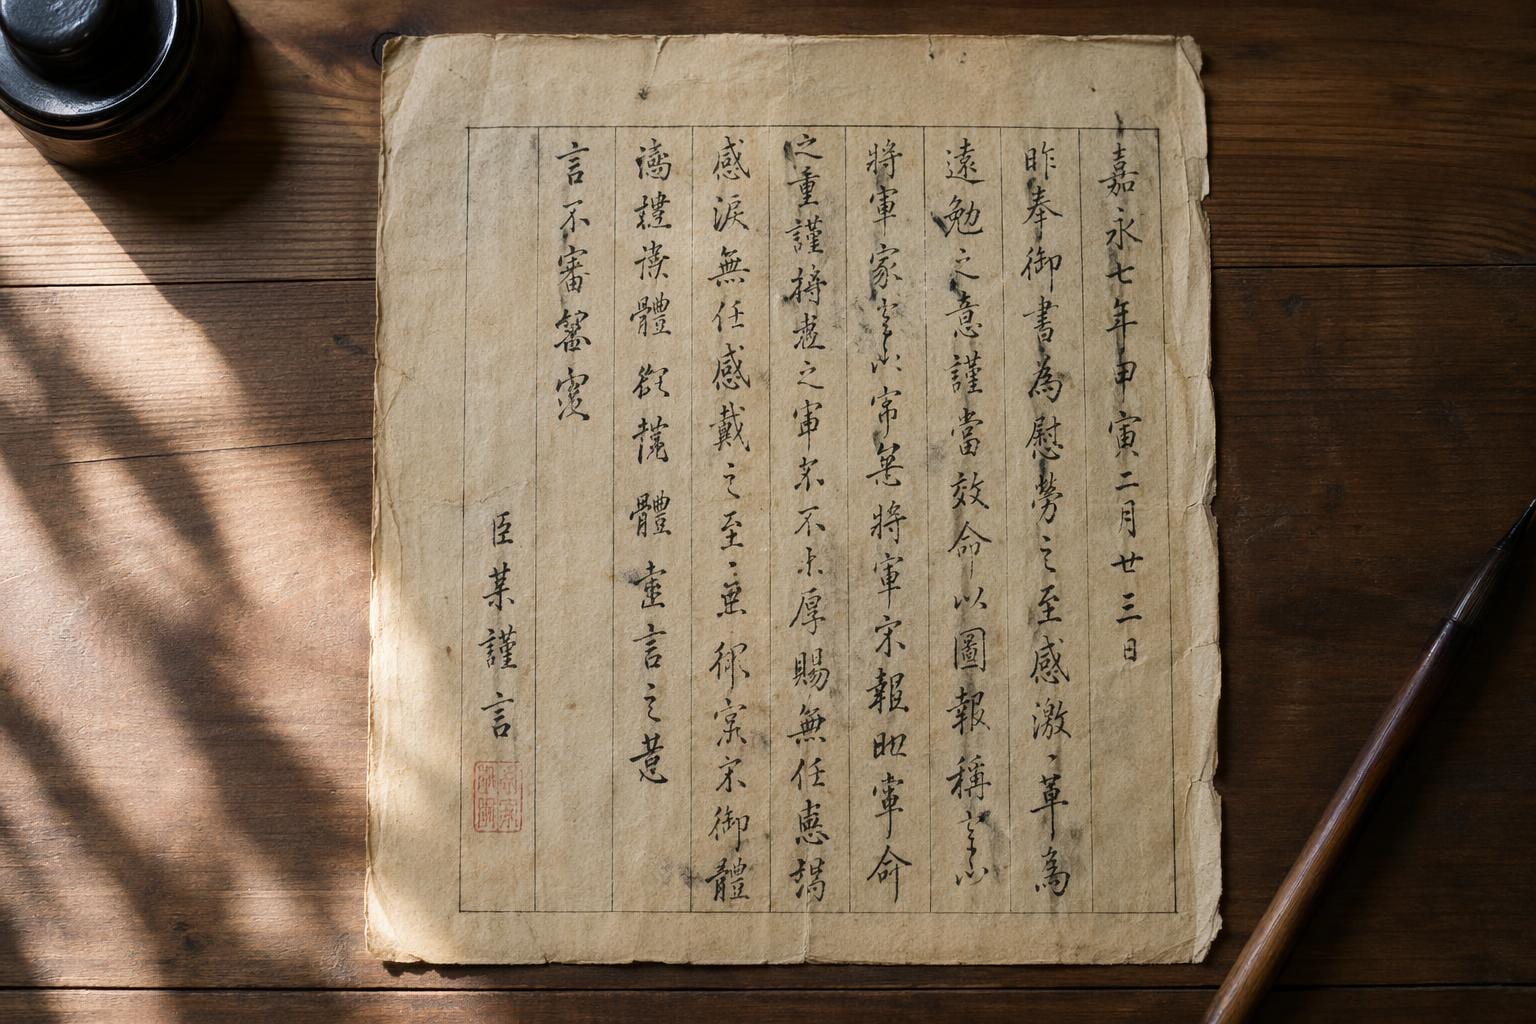
मंचू चिंग राजवंश के दरबारी भाषा है, जो मंगोल लिपि से व्युत्पन्न एक ऊर्ध्वाधर लिपि में ऊपर से नीचे लिखी जाती है। यदि आप इसके लिए एक OCR सिस्टम बना रहे हैं, तो आपको एक साथ दो समस्याएं संभालनी पड़ती हैं।
पहली, यह एक कम-संसाधन (low-resource) भाषा है। अंग्रेजी या चीनी की तरह मंचू पाठ का कोई विशाल लेबल डेटासेट उपलब्ध नहीं है। प्रशिक्षण या मूल्यांकन के लिए उपयोग किया गया प्रत्येक वर्ण-स्तरीय ट्रांसक्रिप्शन किसी ऐसे व्यक्ति द्वारा तैयार किया जाना था जो वास्तव में मंचू पढ़ सकता है, और ऐसे लोगों की संख्या बहुत कम है।
दूसरी, और यह वह हिस्सा है जो इसे एक अच्छे स्ट्रेस टेस्ट बनाता है, मंचू दस्तावेज़ लेखक और उद्देश्य के आधार पर अत्यधिक भिन्न हाथ की लिखाई के शैलियों में आते हैं। यह पेपर तीन शैलियों पर काम करता है: नियमित लिपि (सावधानीपूर्वक, औपचारिक, मुद्रित शैली के करीब), रनिंग लिपि (तेज, अधिक प्रवाहमय, अक्षर एक-दूसरे में विलीन हो जाते हैं), और अर्ध-संक्षिप्त "चैंसरी हैंड" जो विशेष रूप से पैलेस मेमोरियल्स (दरबारी रिपोर्ट) में उपयोग किया जाता था, जो चिंग अधिकारी सम्राट को भेजते थे। एक मॉडल जो इनमें से एक शैली को पढ़ने के लिए प्रशिक्षित हो, दूसरी शैली पर विफल हो सकता है, ठीक वैसे ही जैसे एक इंसान जो साफ मुद्रित अंग्रेजी पढ़ता है, वह किसी डॉक्टर की हाथ से लिखी पर्ची को पढ़ने में संघर्ष कर सकता है।
इन दोनों समस्याओं को मिलाएं और आपको वास्तविक चुनौती मिलती है: आपको एक ऐसा सिस्टम चाहिए जो तीन दृश्य रूप से भिन्न लेखन शैलियों को अच्छी तरह से संभाल सके, लेकिन आपके पास किसी भी एक शैली के पर्याप्त लेबल उदाहरण नहीं हैं कि आप समस्या को हल करने के लिए बस अधिक डेटा डाल सकें।
मुख्य विचार: एक मॉडल की ट्रेनिंग रोकें, सही मॉडल पर राउटिंग शुरू करें
जब आपके पास एक बड़े सामान्य मॉडल के लिए पर्याप्त डेटा नहीं होता है, तो मानक कदम फाइन-ट्यून करना होता है: एक प्री-ट्रेनड मॉडल लें और अपने टारगेट डेटा पर उसे निरंतर अपडेट करते रहें, रास्ते में चेकपॉइंट्स सेव करते हुए। आमतौर पर आप सभी इंटरमीडिएट चेकपॉइंट्स को फेंक देते हैं और केवल अंतिम वाला रखते हैं।
इस पेपर की अंतर्दृष्टि यह है कि उन फेंके गए चेकपॉइंट्स में कचरा नहीं है। इटरेटिव फाइन-ट्यूनिंग के दौरान, एक मॉडल विभिन्न चरणों से गुजरता है, और इस प्रक्रिया के किसी बिंदु पर यह डेटा की किसी विशिष्ट अनोखी बात को संभालने में असाधारण रूप से अच्छा हो सकता है, भले ही वह ट्रेनिंग का लक्ष्य न हो। लेखक इन चेकपॉइंट्स का एक पूल बनाए रखते हैं और उन्हें डोमेन स्पेशलिस्ट के रूप में मानते हैं।
फिर वे एक लाइटवेट राउटर बनाते हैं: एक छोटा इमेज क्लासिफायर जो पेज को देखता है और भविष्यवाणी करता है कि वह किस तीन लिखावट शैलियों (नियमित, रनिंग, या चैंसरी मेमोरियल) को देख रहा है, और फिर उस पेज को उस चेकपॉइंट पर भेज देता है जो उस शैली के लिए ज्ञात विशेषज्ञ है। यदि पूल में किसी डोमेन के लिए कोई अच्छा विशेषज्ञ नहीं है, तो वे एक ट्रेन करते हैं और उसे जोड़ देते हैं।
इसका एक उचित सादृश्य अस्पताल ट्रायज है। आप नहीं चाहते कि एक डॉक्टर हर मरीज का इलाज करे। आप चाहते हैं कि फ्रंट डेस्क पर एक नर्स हो जो मरीज को देखकर यह जान सके कि उसे हॉल के अंदर किस विशेषज्ञ के पास भेजा जाए। यहाँ असामान्य बात यह है कि उनमें से कुछ "विशेषज्ञ" कभी आधिकारिक तौर पर अपनी विशेषज्ञता में ट्रेन नहीं हुए थे। उन्होंने उस कौशल को किसी और चीज़ के लिए ट्रेनिंग के उपउत्पाद के रूप में हासिल किया था, और सिस्टम ने उन्हें टेस्ट करके पता लगाया, यह पूछकर नहीं कि वे किसमें अच्छे होने वाले थे।
उन्होंने क्या मापा, और CER वह संख्या है जो मायने रखती है
यहाँ मुख्य मेट्रिक CER, यानी कैरेक्टर एरर रेट (character error rate) है: OCR सिस्टम द्वारा मानव-सत्यापित ट्रांसक्रिप्शन की तुलना में गलत पहचाने गए कैरेक्टर्स का प्रतिशत। जितना कम, उतना बेहतर, और परिपक्व OCR पाइपलाइनों में एक अच्छे और एक औसत मॉडल के अंतर अक्सर CER के एक प्रतिशत बिंदु से भी कम होता है, जो कि छोटे या चुने हुए (cherry-picked) टेस्ट सेट के साथ नकली बनाने में आसान चीज़ों में से एक है। इस पेपर में तुलना स्थिर रखने के लिए तीन फ्रोजन टेस्ट सेट्स का उपयोग किया गया है, हर लिखने की शैली के लिए एक।
राउटेड सिस्टम के परिणाम, शैली के अनुसार:
- रेगुलर स्क्रिप्ट: 0.30% CER
- पैलेस मेमोरियल्स (चैंसरी हैंड): 1.57% CER
- रनिंग स्क्रिप्ट: 4.83% CER
दो चीज़ें नज़र आती हैं। पहला, ये संख्याएँ उसी के मेल खाती हैं जो आपको तब मिलतीं यदि आप पहले से ही हर पेज के लिए सही डोमेन जानते हों और उसे मैन्युअली सबसे अच्छे विशेषज्ञ को राउट करते। दूसरे शब्दों में, ऑटोमैटिक राउटर गलत अनुमान लगाने से सटीकता खो नहीं रहा है। यह ऐसे प्रदर्शन करता है जैसे उसे उत्तर कुंजी (answer key) सौंप दी गई हो।
दूसरा, रनिंग स्क्रिप्ट तीनों में सबसे कठिन है, और भी बड़े अंतर से, रेगुलर स्क्रिप्ट की तुलना में 16 गुना से अधिक एरर रेट के साथ। यह सामान्य OCR पैटर्न के अनुरूप है जहाँ सबसे बड़ी चुनौतियाँ लगभग हमेशा सबसे ढीली, सबसे अनौपचारिक हैंडराइटिंग होती हैं, साफ़-सुथरी लिखाई नहीं।
राउटर स्वयं, जो छोटा क्लासिफायर है जो तय करता है कि कौन सा पेज कहाँ जाता है, ने सही लिखने की शैली की पहचान करने में 99.3% पेज-लेवल सटीकता हासिल की। यह एक मजबूत संख्या है, जो वास्तव में एक मुश्किल विजुअल क्लासिफिकेशन टास्क के लिए है: एक स्क्रिप्ट के तीन प्रकारों को अलग करना, जिसे आज के अधिकांश लोग बिल्कुल नहीं पढ़ सकते, बल्कि एक नज़र में अलग भी नहीं कर सकते।
गलती से मिले विशेषज्ञ की खोज, और यह वास्तव में मुख्य समाचार क्यों है
उस विवरण पर वापस जाएं जिससे यह लेख शुरू हुआ था। पेपर रिपोर्ट करता है कि तीन विशेषज्ञों में से जिन पर राउटर ने अंततः भरोसा किया, उनमें से केवल रनिंग-स्क्रिप्ट (running-script) विशेषज्ञ ही वह चेकपॉइंट था जिसे मूल रूप से रनिंग स्क्रिप्ट को अपना इच्छित लक्ष्य बनाकर प्रशिक्षित किया गया था। अन्य दो, जो रेगुलर स्क्रिप्ट और पैलेस मेमोरियल्स को संभाल रहे थे, वे उन चेकपॉइंट्स से आए थे जो अलग-अलग लक्ष्यों की ओर इशारा करने वाले पुनरावृत्त फाइन-ट्यूनिंग प्रक्रिया के उत्पाद थे।
यह बात पहले दिखाई देने से कहीं अधिक महत्वपूर्ण है। यह सुझाव देता है कि कम संसाधन वाले वातावरण में, कोई मॉडल किसी विशेष डोमेन में अच्छा कैसे बनता है, यह पूरी तरह से इस बात से पूर्वानुमानित नहीं है कि आपने उसे किस चीज़ पर प्रशिक्षित करने की योजना बनाई थी। प्रशिक्षण गतिशीलता (training dynamics) पार्श्व प्रभाव पैदा करती है, और उन पार्श्व प्रभावों में से कुछ ऐसे उपयोगी विशेषज्ञ हैं जिन्हें आप जानबूझकर बनाने के बारे में कभी नहीं सोचेंगे। व्यावहारिक निहितार्थ यह है कि यदि आपके पास पिछले फाइन-ट्यूनिंग रनों से मध्यवर्ती चेकपॉइंट्स का एक ढेर है, तो उन्हें निपटान योग्य मानना इसका मतलब हो सकता है कि आप उन विशेषज्ञों को फेंक रहे हैं जिन्हें बनाने के लिए आपने पहले ही भुगतान कर दिया है।
यह इस बात को भी पुनः परिभाषित करता है कि "राउटर" वास्तव में क्या कर रहा है। यह केवल ट्रैफिक को निर्देशित नहीं कर रहा है। यह एक प्रकार की अंधी ऑडिशन चला रहा है, जो एक हल्के क्लासिफायर को यह खोजने देता है कि आपके मौजूदा संपत्तियों में से कौन सी गुप्त रूप से उस काम में अच्छी है जिसके लिए किसी ने उन्हें नहीं नियत किया था, और फिर यह उस खोज के आधार पर कार्य करता है, न कि इस धारणा के आधार पर कि प्रत्येक चेकपॉइंट किसके "लिए" था।
यदि आप OCR बना रहे हैं या खरीद रहे हैं तो यह क्यों मायने रखता है
यदि आप किसी भी वास्तविक मात्रा में दस्तावेज़ों को OCR से गुज़ारते हैं, तो संभावना है कि आप पहले से ही इस समस्या के किसी रूप से निपट रहे हैं, बस ऐतिहासिक-हस्तलिखित पृष्ठभूमि के बिना। स्कैन किए गए अनुबंध, हाथ से भरे गए फॉर्म, फीके पड़े रसीदें और मिश्रित-गुणवत्ता वाले PDFs सभी एक मॉडल के ध्यान के लिए प्रतिस्पर्धा करने वाले अलग-अलग दृश्य डोमेन हैं, ठीक वैसे ही जैसे नियमित लिपि, रनिंग स्क्रिप्ट और चैंसरी हैंड यहाँ प्रतिस्पर्धा करते हैं।
सीख यह नहीं है कि "आपको एक मंचू विशेषज्ञ को ट्रेन करना चाहिए।" बल्कि यह है कि एकल "सर्वश्रेष्ठ" OCR मॉडल, जो आप लीडरबोर्ड से चुनते, अक्सर गलत दृष्टिकोण है। एक राउटर जो अलग-अलग दस्तावेज़ प्रकारों को अलग-अलग विशेषज्ञों के पास भेजता है, जो प्रत्येक उस प्रकार के लिए ट्यून किए गए या बस खोजे गए हैं, किसी भी एकल मॉडल से बेहतर प्रदर्शन कर सकता है जो हर जगह इस्तेमाल किया जाता है। यह वही तर्क है जिसके पीछे एक सेवा जो प्रति दस्तावेज़ कई OCR इंजिन आज़माती है और सर्वश्रेष्ठ परिणाम रखती है, अक्सर हर बार एक इंजिन पर दांव लगाने से बेहतर प्रदर्शन करती है।
यह पुराने मॉडल चेकपॉइंट्स को जल्दी डिलीट न करने का एक कारण भी है। यदि आपने कभी कई पुनरावृत्तियों के माध्यम से एक मॉडल को फाइन-ट्यून किया है और केवल अंतिम संस्करण रखा है, तो यह पेपर एक मामला है कि मध्यवर्ती चेकपॉइंट्स को रखें और नियमित रूप से परीक्षण करें कि क्या उनमें से कोई भी चुपचाप किसी चीज़ में महान साबित हुआ है जिसका आपने योजना नहीं बनाई थी। एक चेकपॉइंट स्टोर करने का खर्च सस्ता है। एक विशेषज्ञ को फिर से ट्रेन करने का खर्च, जिसे आपने पहले से ही फेंक दिया था, सस्ता नहीं है। मजबूत अंग्रेजी OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा होगा; इसलिए विभिन्न लिपियों के लिए अलग-अलग मॉडल रखना और उनकी विशिष्ट ताकतों का लाभ उठाना अक्सर अधिक प्रभावी होता है।
इस दृष्टिकोण की ईमानदार सीमाएं
यह एक छोटा, सावधानी से परिभाषित अध्ययन है, कोई सामान्य-उद्देश्यीय रेसिपी नहीं, और पेपर इसे अतिशयोक्ति से नहीं प्रस्तुत करता।
तीन डोमेन राउटर के लिए अलग करने के लिए एक प्रबंधनीय संख्या है। यह स्पष्ट नहीं है कि यह दस या बीस दृश्य रूप से भिन्न दस्तावेज़ प्रकारों के साथ कैसे काम करता है, जहां एक हल्का पेज क्लासिफायर राउटिंग में अधिक गलतियां करना शुरू कर सकता है, और जहां गलत राउटिंग निर्णय अधिक महंगे हो जाते हैं क्योंकि गलत होने के अधिक तरीके होते हैं।
सिस्टему को अभी भी एक फॉलबैक की आवश्यकता है: जब चेकपॉइंट पूल में डोमेन के लिए कोई संभावित विशेषज्ञ नहीं होता है, तो किसी को एक नए विशेषज्ञ को प्रशिक्षित करना होगा, जिसका अर्थ है कि किसी को अभी भी उस डोमेन के लिए लेबल किए गए डेटा को उत्पादित करना होगा। यह दृष्टिकोण आपको ताज़ा प्रशिक्षण डेटा की आवश्यकता कितनी बार होती है, उसे कम करता है, लेकिन इसकी आवश्यकता को समाप्त नहीं करता है।
यहाँ राउटिंग पृष्ठ स्तर पर होती है, पंक्ति-दर-पंक्ति या शब्द-दर-शब्द नहीं। एक ऐसा एकल पृष्ठ जो दो लेखन शैलियों को मिलाता है (वास्तविक ऐतिहासिक दस्तावेज़ों में यह असामान्य नहीं है, जहाँ एक लेखक पृष्ठ के बीच में हाथ बदल सकता है) एक ऐसे राउटर को भ्रमित कर सकता है जो एक पृष्ठ प्रति वर्गीकरण के इर्द-गिर्द बनाया गया है।
और यह विशेष रूप से मंचू है: एक लिपि जिसमें इसके शैली विविधताओं के बीच स्पष्ट संरचनात्मक अंतर हैं। डोमेन जो एक-दूसरे में अधिक धुंधले हो जाते हैं (कहें, एक ही सामान्य लेखन शैली के स्कूल में कई लोगों की कर्सिव हैंडराइटिंग) एक हल्के क्लासिफायर के लिए अलग करना बहुत कठिन हो सकता है, जो आत्मविश्वास से भरे राउटिंग के पूरे सिद्धांत को कमजोर कर देगा।
इनमें से कोई भी मुख्य परिणाम को मिटाता नहीं है। पेपर चेकपॉइंट पूल से अधिक मूल्य निकालने का एक वास्तव में चतुर तरीका दिखाता है, और एक याद दिलाता है कि "एक बहुत अच्छा मॉडल बनाएं" हमेशा सही प्रश्न नहीं है। कभी-कभी सही प्रश्न "मैंने जो चीजें पहले से बनाई हैं, उनमें से इसमें गुप्त रूप से सबसे अच्छा कौन सा है," होता है, और एक ऐसा सिस्टम बनाना जो वास्तव में यह पता लगा सके।