読み込み中...
OCR API
すべての OCR エンジンを、ひとつの API で
PDF や画像を送るだけでテキストが返ってきます。PDF の分割、各プロバイダーの SDK、認証は OpenOCR が引き受けます。コードを変えずにエンジンを切り替えたり、同じ文書を別のモデルで再試行したりできます。
アプリとドキュメントは現在英語のみでご提供しています。
すべてのエンジンを、ひとつの統合で
クラウド API、オープンソースモデル、視覚言語モデルを、同じエンドポイントと同じレスポンス形式で利用できます。
クレジット残高はひとつ
プロバイダーごとのアカウントやキーは不要です。一度チャージすれば、どのエンジンでも使えます。
比べてから選べる
公開ランキングとベンチマークで精度・速度・料金を並べて比較し、文書に合ったエンジンを選べます。
従量課金
サブスクリプションは不要。処理したページ数に応じたお支払いで、登録は数分で完了します。
ブログの最新記事
すべての記事 →
23 分で読めます
SP-DocReader: 差分認識型セルフプレイでVary-600KのOCR誤り率を半減
Qwen3-VL-4Bにおいて、SP-DocReaderはバックボーンを凍結したままOCRモジュールを訓練し、Vary-600Kの文字誤り率を2エポックの教師あり微調整と比べて約54%削減します。
42 分で読めます
小型モデルと構造化データ:軽量VLMは複雑な文書抽出においてクラウドAPIを代替できるか?
4B〜7Bの視覚モデルはローカルGPU上で乱雑なアーカイブから構造化JSONを抽出できるのか? FAUエアランゲンの最新研究が、大学の所蔵資料を対象に8つのオープンウェイトVLMをベンチマーク評価。
23 分で読めます
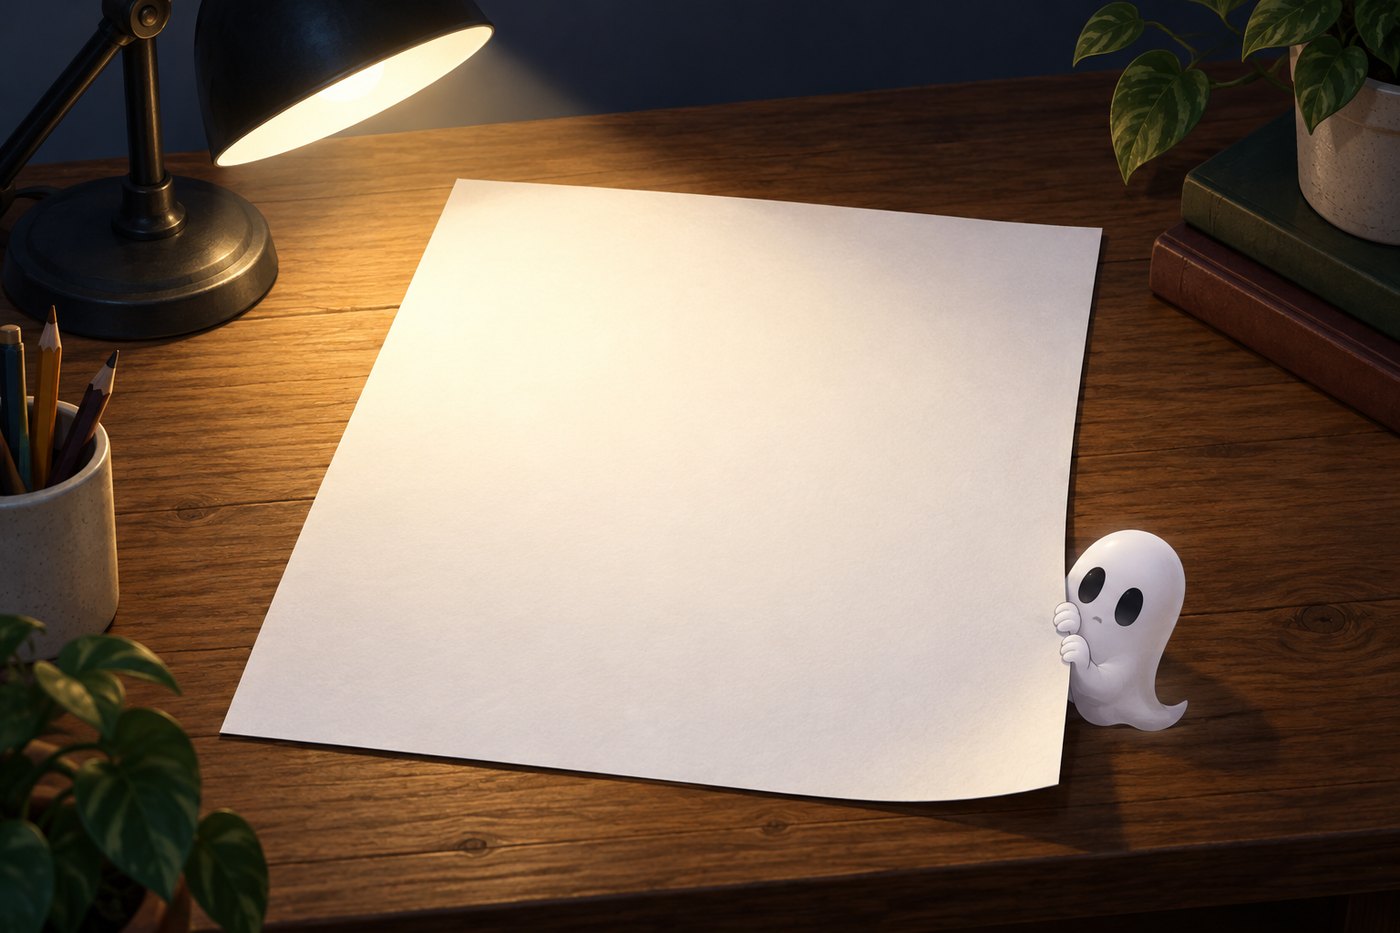
184種類のOCRエンジンに真っ白な空白ページを送信した結果:一部のモデルが存在しない文字を「読解」
800×1000ピクセルの白い空白画像を見せたところ、従来のOCRエンジンは何も出力しなかった一方、最新のビジョン言語モデルはUFOの目撃談やヴィクトリア朝の判例、腸活サプリの広告を勝手に創作し始めた。