加载中...
OCR API
一个 API,调用所有 OCR 引擎
上传 PDF 或图片,即可获得文本。OpenOCR 替你处理 PDF 拆分、各服务商的 SDK 和身份验证——无需修改代码即可切换引擎,或用另一个模型重试同一份文档。
应用和文档目前仅提供英文版。
所有引擎,一次集成
云端 API、开源模型和视觉语言模型都通过同一个接口调用,返回格式统一。
统一的额度余额
无需为每个服务商单独注册账号或申请密钥。充值一次,即可使用任意引擎。
先比较,再选择
公开的排行榜和基准测试并列展示准确率、速度和价格,帮助你为自己的文档选对引擎。
按量付费
无需订阅,按处理的页数计费,注册只需几分钟。
博客最新文章
全部文章 →
阅读约 17 分钟
SP-DocReader:基于差异感知自博弈,将 Vary-600K 的 OCR 错误率减半
在 Qwen3-VL-4B 上,SP-DocReader 在冻结骨干网络、仅训练 OCR 模块的前提下,相比两轮监督微调,将 Vary-600K 的字符错误率降低约 54%。
阅读约 35 分钟
小模型与结构化数据:轻量级 VLM 能否替代云端 API 完成复杂文档抽取?
4B–7B 参数的视觉模型能否在本地 GPU 上从杂乱的历史档案中抽取结构化 JSON?FAU 埃尔朗根-纽伦堡大学的一项新研究在三大高校馆藏档案集上对 8 款开源轻量级 VLM 展开了基准评测。
阅读约 21 分钟
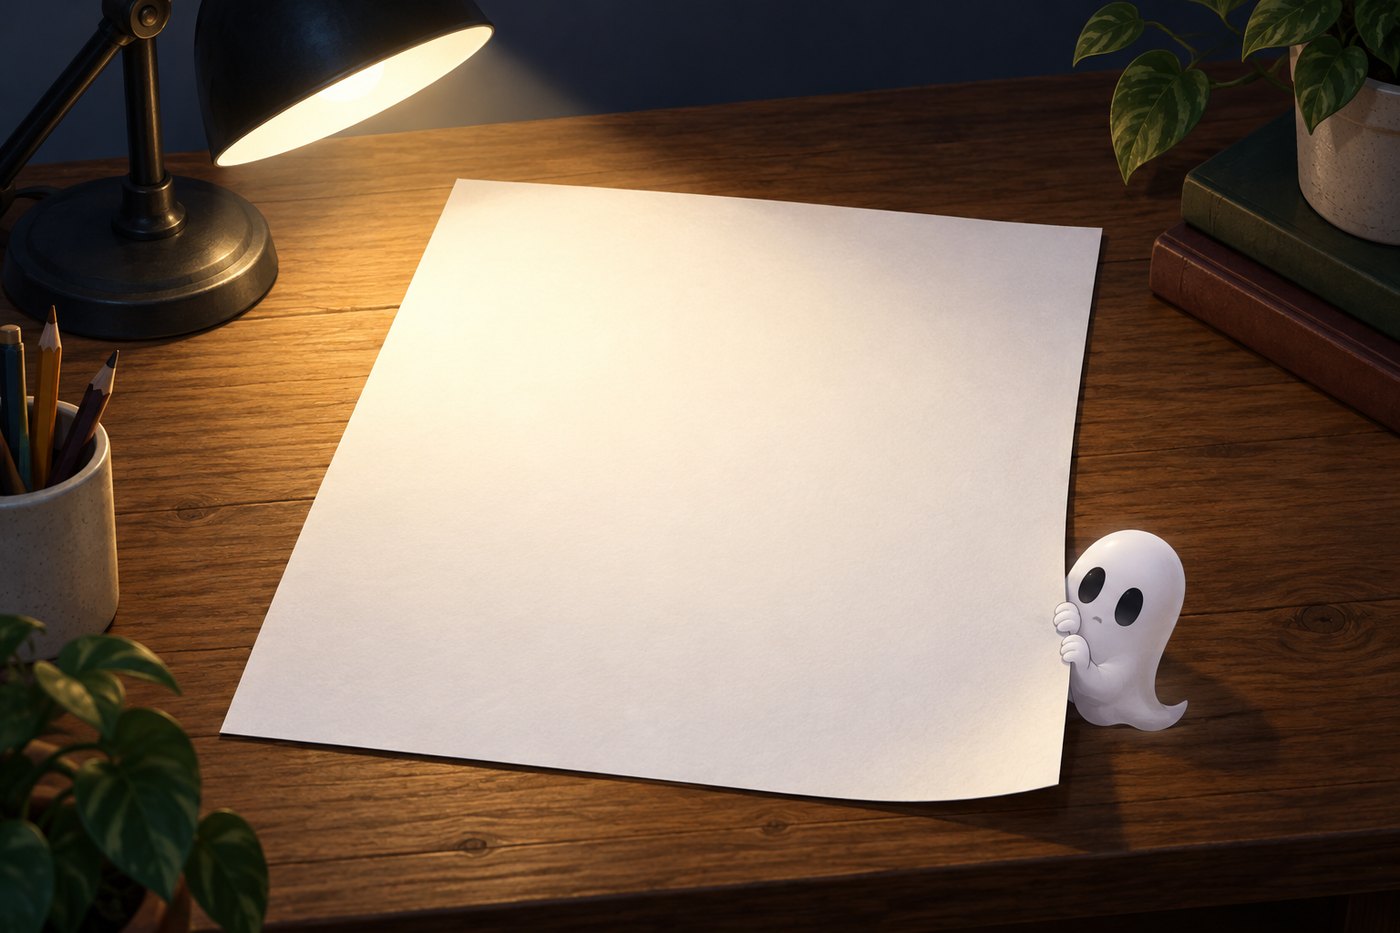
我们向 184 款 OCR 引擎发送了一张纯白空白页,有些居然“读”出了内容
当你向现代视觉模型输入一张 800×1000 的纯白空白图像时,传统 OCR 引擎会保持沉默,而新型模型却能凭空编造出 UFO 信件、维多利亚时代的诉讼判决以及肠道健康广告。