लोड हो रहा है...
OCR API
हर OCR इंजन के लिए एक API
PDF या इमेज भेजें और टेक्स्ट पाएँ। PDF को विभाजित करना, हर प्रदाता के SDK और प्रमाणीकरण — यह सब OpenOCR संभालता है। कोड बदले बिना इंजन बदलें या उसी दस्तावेज़ को किसी दूसरे मॉडल से दोबारा आज़माएँ।
ऐप और दस्तावेज़ीकरण फ़िलहाल केवल अंग्रेज़ी में उपलब्ध हैं।
सभी इंजन, एक इंटीग्रेशन
क्लाउड API, ओपन-सोर्स मॉडल और विज़न-लैंग्वेज मॉडल — सभी एक ही एंडपॉइंट और एक ही रिस्पॉन्स फ़ॉर्मेट में।
एक क्रेडिट बैलेंस
हर प्रदाता के लिए अलग खाते या कुंजियों की ज़रूरत नहीं। एक बार रिचार्ज करें और कोई भी इंजन इस्तेमाल करें।
चुनने से पहले तुलना करें
सार्वजनिक रैंकिंग और बेंचमार्क सटीकता, गति और कीमत को साथ-साथ दिखाते हैं, ताकि आप अपने दस्तावेज़ों के लिए सही इंजन चुन सकें।
जितना उपयोग, उतना भुगतान
कोई सब्सक्रिप्शन नहीं। आप प्रोसेस किए गए हर पेज के लिए भुगतान करते हैं, और साइन अप में बस कुछ मिनट लगते हैं।
ब्लॉग से नया
सभी लेख →
16 मिनट में पढ़ें
SP-DocReader: डिफ़रेंस-अवेयर सेल्फ़-प्ले से Vary-600K पर OCR एरर रेट आधा
Qwen3-VL-4B पर SP-DocReader बैकबोन को फ़्रीज़ रखते हुए एक OCR मॉड्यूल को ट्रेन करता है और दो-एपोक सुपरवाइज़्ड फ़ाइन-ट्यूनिंग की तुलना में Vary-600K का कैरेक्टर एरर रेट लगभग 54% घटा देता है।
24 मिनट में पढ़ें
छोटे मॉडल्स, संरचित डेटा: क्या जटिल दस्तावेज़ निष्कर्षण के लिए हल्के VLMs क्लाउड APIs का स्थान ले सकते हैं?
क्या 4B–7B विज़न मॉडल्स लोकल GPUs पर अव्यवस्थित अभिलेखागारों से संरचित JSON निकाल सकते हैं? FAU Erlangen का एक नया अध्ययन यूनिवर्सिटी कलेक्शन्स में 8 ओपन-वेट VLMs का बेंचमार्क करता है।
12 मिनट में पढ़ें
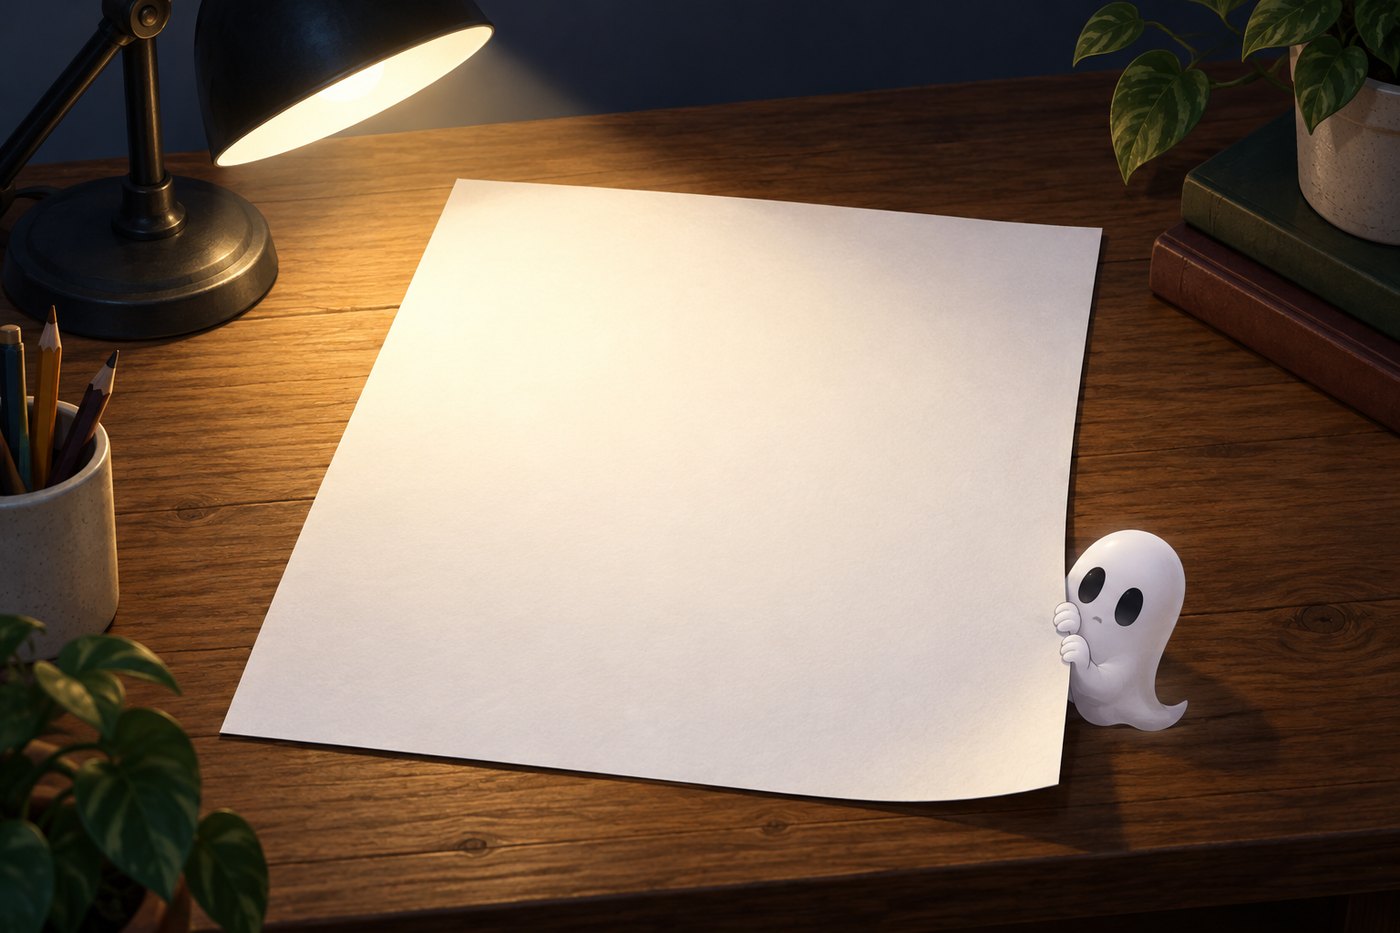
हमने 184 OCR इंजनों को एक कोरा सफ़ेद पेज भेजा। उनमें से कुछ ने फिर भी उसे पढ़ लिया।
जब आप आधुनिक विज़न मॉडल्स को 800x1000 की खाली सफ़ेद इमेज दिखाते हैं, तो पारंपरिक OCR इंजन शांत रहते हैं; वहीं नए मॉडल्स UFO पत्र, विक्टोरियन अदालती मामले और गट हेल्थ के विज्ञापन गढ़ लेते हैं।