Cuando alinear un modelo de imágenes lo empeora en ortografía
Basado en: Manifold Drift in Flow Preference Optimization: A Root Cause of Reward Hacking — Yansen Han, Shengyi Liao, Yuanxing Zhang, Pengfei Wan, Tao Lin
Pide a un generador de imágenes "una fachada de panadería con un letrero pintado a mano que diga ABIERTO" y muchos modelos acertarán con la iluminación cálida, los pasteles en la vitrina y el ladrillo envejecido. Luego miras el letrero. Dice "OPEEN". O las letras se desvanecen en algo que no pertenece a ningún alfabeto.
Eso no es un fallo aleatorio. Un artículo publicado esta semana, "Manifold Drift in Flow Preference Optimization", argumenta que es el resultado predecible de un error específico y corregible en la forma en que estos modelos se ajustan finamente para alinearse con las preferencias humanas. La solución que proponen, llamada ThermoDPO, mejora la precisión de OCR en imágenes generadas en un 47,5 % en un modelo de referencia. Para un sitio que vive y muere según lo bien que las máquinas lean el texto, vale la pena analizarlo.
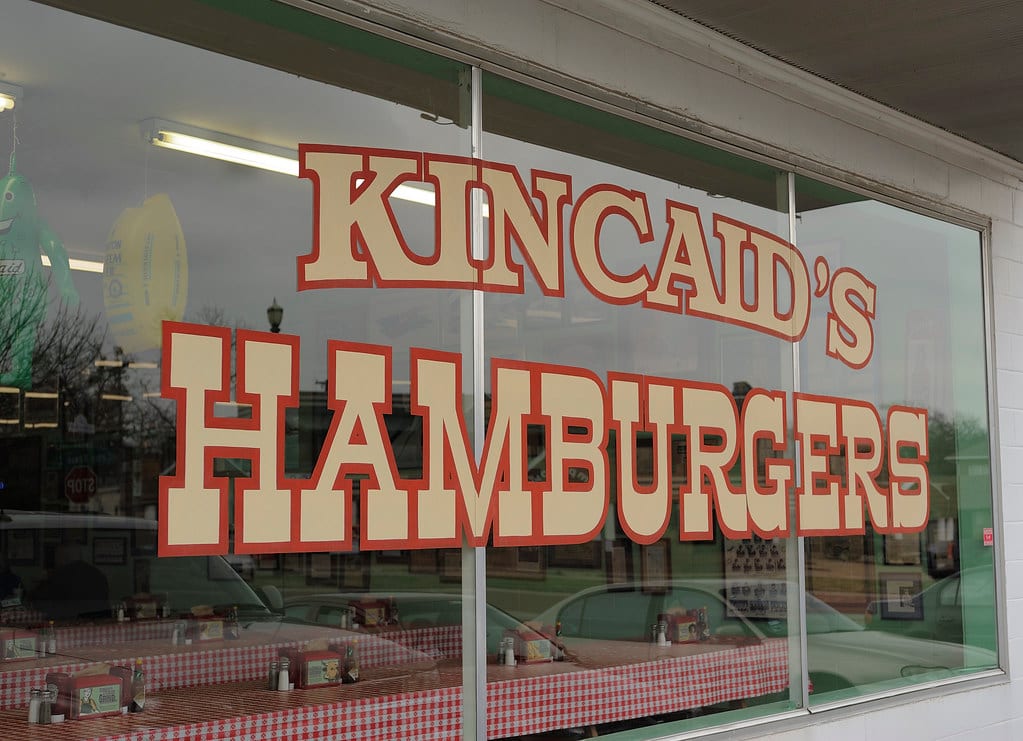
HAMBURGUESERÍA KINCAID: La ciudad dice que el letrero debe retirarse o la popular cadena de hamburguesas enfrentará multas diarias — por Robert W. Howington vía flickr, BY-SA 2.0.
Qué hace realmente el flow matching
Olvídate de las matemáticas por un momento y piensa en el proceso de entrenamiento de la siguiente manera: un modelo de flow matching aprende a transformar gradualmente ruido aleatorio en una imagen realista (o un clip de audio, o un fotograma de vídeo) siguiendo una trayectoria suave, paso a paso, desde estática pura hasta una imagen terminada. "Flow matching" es la receta líder actual para entrenar estos generadores que siguen trayectorias, y es el motor detrás de modelos como Stable Diffusion 3.
Lo crucial es que, cuando un modelo de flow está bien entrenado, los extremos de todas esas trayectorias caen directamente dentro de lo que los investigadores llaman el manifold de datos: el espacio de imágenes que realmente se parecen a fotografías reales, documentos reales, señales reales, cualquier cosa real. Si le das ruido aleatorio, produce de manera fiable algo que se asemeja a los datos de entrenamiento, porque eso es para lo que fue construido matemáticamente. La primera contribución real del paper es demostrar esto de forma clara: el flow matching óptimo recupera la verdadera distribución de datos. Sin deriva, sin sorpresas.
Dónde el ajuste de preferencias rompe el trato
Aquí está la parte que suele confundir a la gente. Una vez que tienes un generador de imágenes funcional, el siguiente paso en la mayoría de las pipelines modernas es la alineación: mostrarle al modelo pares de salidas, indicarle "a los humanos les gustó más esta" y ajustar sus pesos hacia la opción preferida. Esta es la misma idea detrás de DPO (Optimización Directa de Preferencias), la técnica que dominó el ajuste fino de modelos de lenguaje hace un par de años. Funciona bien para el texto. Trasladarlo al flow matching es donde las cosas se complican.
El problema es que las rutas de transporte de un modelo de flujo, los caminos desde el ruido hasta la imagen, no tienen una correa incorporada que los mantenga en la variedad de datos una vez que comienzas a tirar de ellos con una señal de recompensa. El artículo formaliza esto como "deriva de la variedad" (manifold drift): una actualización de preferencia aleja las salidas del modelo del espacio de imágenes realistas siempre que esa actualización tenga lo que ellos llaman un componente normal no nulo, lo que significa que el empujón tiene una parte apuntando perpendicularmente a la variedad en lugar de a lo largo de ella.
Imagina la variedad como la superficie de un estanque y las salidas del modelo como botes sobre esa superficie. Una buena actualización rema el bote hacia un mejor lugar en el estanque. Una actualización con deriva arranca el bote hacia arriba y fuera del agua por completo, y ahora técnicamente está más cerca de donde la función de recompensa quería que fuera, pero ya no es un bote en un estanque. Simplemente está equivocado de una manera que el modelo de recompensa no logró notar.
Esa última cláusula es la verdadera historia. Esto es hacking de recompensa: el modelo encuentra una manera de obtener buenas puntuaciones en la métrica que debería representar "a los humanos les gustó más" sin producir realmente algo que a los humanos les gustaría. El texto de letreros ilegible es una versión visible y fácil de detectar de este fallo. Versiones menos visibles, como artefactos de textura sutiles, manos anatómicamente extrañas o colores que están casi pero no del todo bien, son más difíciles de detectar y probablemente están ocurriendo en modelos de producción en este mismo momento.
ThermoDPO: manteniendo el barco en el agua
La solución que proponen los autores parte de un instinto sencillo: si el peligro es alejarse de muestras reales y conocidas como buenas, ancle la optimización directamente a esas muestras. ThermoDPO es un objetivo controlado por temperatura que fija las actualizaciones de preferencia por pares a la muestra preferida (ganadora) en cada par de comparación, en lugar de permitir que la actualización fluya libremente basándose únicamente en la diferencia de recompensa entre las dos opciones.
La parte "controlada por temperatura" es importante porque le da al método un dial. En una configuración, el objetivo se comporta como el ajuste fino mediante muestreo de rechazo, o RFT: se genera un montón de candidatos, se mantienen los que obtienen buenas puntuaciones y se entrena con ellos. RFT es seguro y se mantiene cerca del manifold de datos casi por construcción, pero desperdicia gran parte de la señal en un par de preferencias (nunca compara directamente la salida de baja calidad contra la de alta calidad, solo filtra). En otra configuración de temperatura, el objetivo converge hacia FlowDPO, el enfoque de optimización de preferencias más agresivo que utiliza la comparación completa pero es más propenso a la deriva. ThermoDPO se sitúa en un continuo entre los dos y permite elegir cuánto se quiere intercambiar seguridad por señal.
Los autores también muestran, y esta es la parte más técnica pero genuinamente útil, que su objetivo controla un sustituto basado en reconstrucción puntual para la distancia del manifold. En términos sencillos: encontraron una medida proxy que rastrea cuán lejos se ha alejado una muestra generada del manifold de datos, y su objetivo de entrenamiento mantiene ese número bajo control como efecto secundario del entrenamiento normal, no como una penalización adicional añadida después.
Una salvedad: a bajas temperaturas (donde se está más cerca del régimen seguro, similar a RFT), la señal de entrenamiento se debilita, porque se le está diciendo principalmente al modelo "esta muestra está bien" en lugar de darle un gradiente útil hacia la mejora. Su respuesta es ThermoDPO-weighted, una variante que repondera el objetivo para mantener la señal fuerte incluso cuando la temperatura se reduce hacia el extremo cauteloso. Es la versión que termina ganando la mayoría de sus benchmarks.
Los números y por qué son más grandes de lo que parecen
En el principal benchmark de prueba del artículo (un entorno controlado diseñado para aislar este modo de fallo exacto del ruido de un modelo de producción completo), la métrica de puntuación es algo que llaman StrictScore, que parece penalizar cualquier desviación del verdadero manifold de datos en lugar de simplemente recompensar la alineación de preferencias. FlowDPO simple obtiene 0.629. Añadir muestreo por rechazo sobre FlowDPO (FlowDPO+RFT) llega a 0.857. ThermoDPO ponderado alcanza 0.899. Esa es una gran brecha entre "alineado a preferencias" y "alineado a preferencias sin arruinar el modelo subyacente", y es la demostración más limpia del artículo de que la deriva es un costo real y medible, no una preocupación teórica.
El resultado que importará más a esta audiencia proviene de las pruebas en SD3.5-M, un modelo real de Stable Diffusion 3.5 a escala de producción, con una configuración de guía libre de clasificador (CFG) de 4.5, que es un parámetro estándar que controla cuán estrictamente el modelo sigue su prompt de texto. ThermoDPO mejoró la precisión de OCR en las imágenes generadas en un 47.5%, y mejoró el promedio de cuatro métricas de evaluación en un 16.0%.
Lee ese número de OCR cuidadosamente, porque está haciendo algo interesante. Los investigadores no están ejecutando un benchmark de OCR por su propio bien. Están usando la precisión de OCR como un sustituto de "¿el modelo realmente generó texto legible y bien formado en lugar de garabatos alucinados?", que es exactamente el tipo de fallo que es fácil que un evaluador humano pase por alto de un vistazo (el letrero parece bien en una miniatura) pero trivial para un motor de OCR detectar, porque un motor de OCR o lee palabras reales o no lo hace.
Por qué importa para quienes construyen o evalúan pipelines de OCR
Si tu trabajo toca document AI, generación de datos sintéticos o cualquier pipeline donde se creen o transformen imágenes con texto incrustado por un modelo generativo, este artículo es relevante aunque no mencione directamente el procesamiento de documentos. Algunos puntos clave concretos:
- La legibilidad del texto es una verificación sensible y económica para un problema mucho más amplio. Si estás evaluando o ajustando finamente cualquier generador de imágenes y quieres una señal de alerta temprana para reward hacking o drift del manifold, pasa las salidas generadas por un motor de OCR y verifica la precisión. Es un canario que detecta fallos más sutiles antes de que aparezcan en puntuaciones de calidad visual más difíciles de cuantificar.
- Los datos de entrenamiento sintéticos para sistemas de OCR son tan buenos como el generador que los produce. Muchos equipos de document AI generan facturas, formularios y letreros sintéticos para aumentar los conjuntos de entrenamiento. Si ese generador fue ajustado por preferencia sin un método consciente del drift como ThermoDPO, el texto sintético en esas imágenes puede ser sutilmente menos realista de lo que parece, lo que puede envenenar silenciosamente el entrenamiento de OCR aguas abajo.
- Una mejora del 47,5% en OCR en un modelo de producción real (no solo en un benchmark de juguete) sugiere que esto no es una solución académica de nicho. Si ThermoDPO o algo similar es adoptado por proveedores principales de modelos de imágenes, espera un renderizado de texto notablemente mejor en la próxima generación de documentos generados, letreros y maquetas de UI.
- El reward hacking no es solo un problema de LLM. Cualquiera que construya pipelines de evaluación alrededor de modelos generativos, de imagen, texto o de otro tipo, debería tratar "¿subió la métrica de recompensa?" y "¿mejoró realmente la calidad?" como dos preguntas separadas que necesitan dos verificaciones separadas.
Qué sigue abierto
Las cifras principales provienen de un benchmark de juguete diseñado para aislar exactamente este efecto, más un modelo de producción (SD3.5-M) en una configuración de guía. Eso constituye una prueba de concepto sólida, no un barrido exhaustivo a través de las familias de modelos y configuraciones que la gente realmente despliega. Vale la pena preguntarse cómo se comporta ThermoDPO con diferentes valores de CFG, en modelos más grandes o en la generación de video, donde el flow matching también se está convirtiendo cada vez más en el enfoque estándar y donde la deriva podría acumularse entre fotogramas.
El parámetro de temperatura también es un dial que hay que ajustar, y los propios resultados del paper muestran que equivocarse (ponerlo demasiado bajo) priva a la señal de entrenamiento, que es exactamente por lo que existe la variante ponderada como parche. Es un compromiso de ingeniería razonable, pero significa que ThermoDPO no es un reemplazo directo sin parámetros para las tuberías de ajuste de preferencias existentes. Los equipos que lo adopten necesitarán hacer su propio barrido para encontrar el régimen adecuado para su modelo y datos.
Aun así, la contribución teórica central, de que una actualización de preferencia sale del manifold preentrenado precisamente cuando tiene un componente normal no nulo, le da al campo una forma mucho más nítida de pensar por qué el alineamiento a veces tiene efectos contraproducentes en los modelos generativos de tiempo continuo. Ese es un modelo mental útil incluso para equipos que no planean adoptar ThermoDPO específicamente: cuando ajustas finamente un generador basado en flujos en preferencias, pregúntate si tu actualización está empujando a lo largo del manifold o fuera de él. El paper te da un nombre para el fallo y, por primera vez, algo cercano a una forma de medirlo.