あなたのビジョンエンコーダに隠された無料の昼食:SigLIP-HDが正しく捉えたこと
元論文: SigLIP-HD by Fine-to-Coarse Supervision — Lihe Yang, Zhen Zhao, Hengshuang Zhao
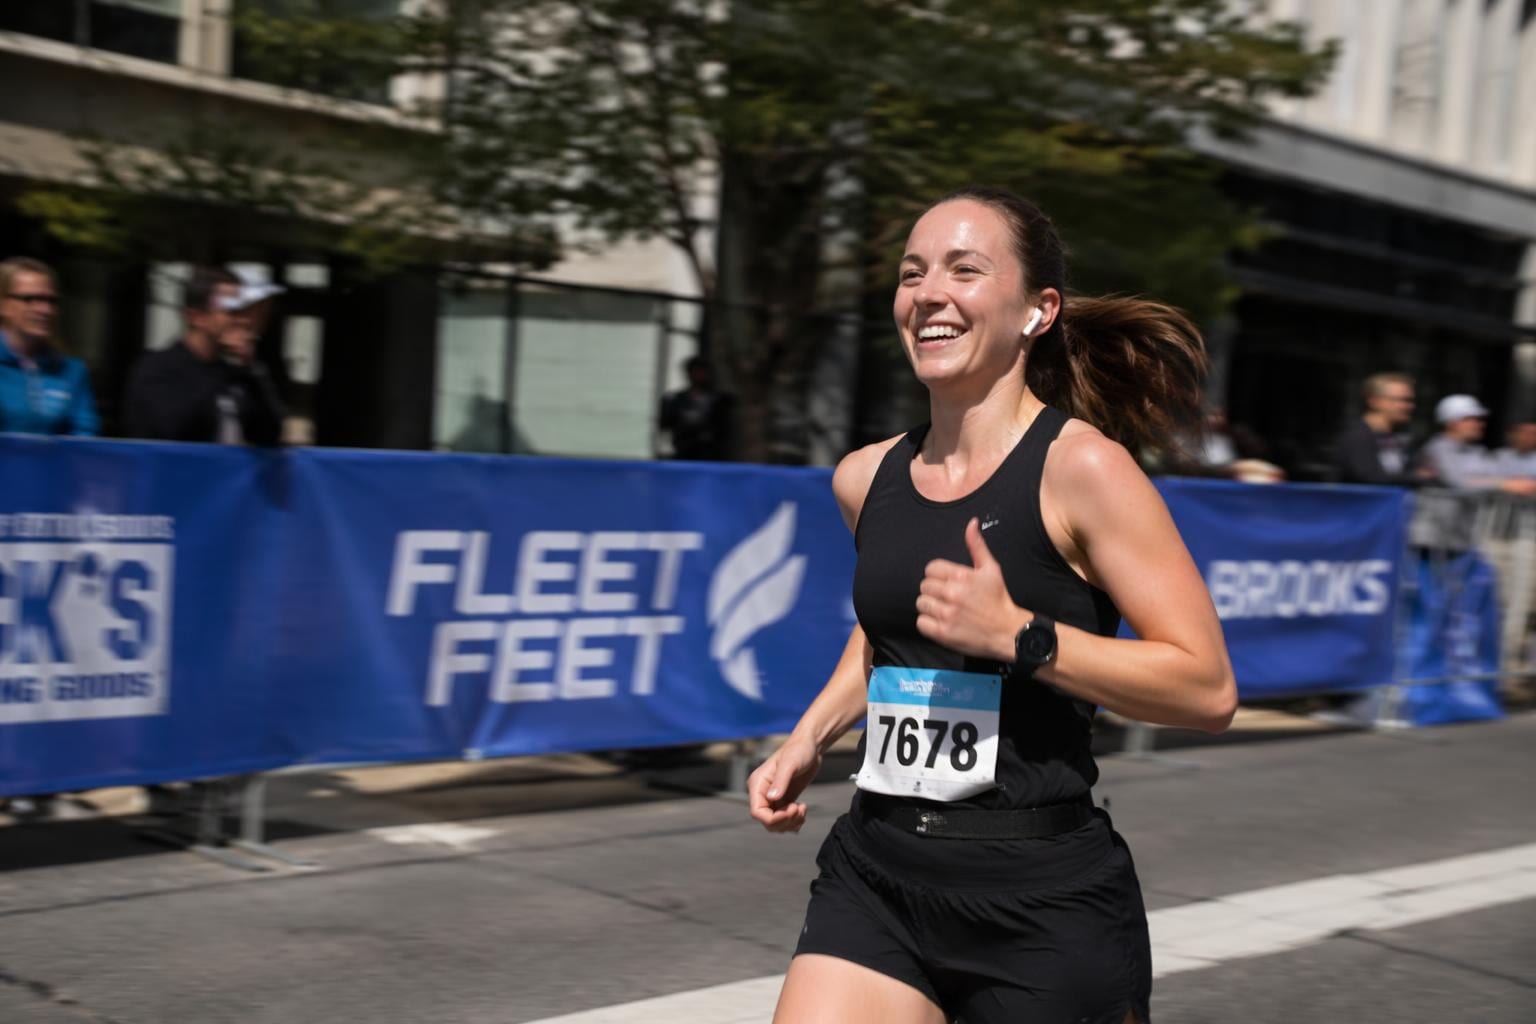
レース中にランナーがバナーの前を走ります。バナーには「HOKA TIME TO FLY」と書かれており、ランニングシューズのブランドを宣伝しています。その写真を最先端のビジョン言語モデルに読み込ませ、バナーに何と書かれているかを尋ねると、返ってくるのは「HOOKA TIME TO FLY」です。画像にタイプミスがあるわけではありません。モデルが作り出したタイプミスです。モデルが注目していた解像度では、文字がわずかにぼやけ、実在するブランド名が存在しない単語に変わってしまいました。
この失敗モードを解消するために構築されたのが、SigLIP-HDという新しい論文です。その解決策は、疑わしいほどシンプルです。より大きな画像も、推論時の追加計算も、新しいアーキテクチャも不要です。今日の数多くのマルチモーダルモデルにすでに搭載されている同じビジョンエンコーダーを、異なる方法でトレーニングするだけです。香港大学と上海AI研究所の研究者たちは、推論時に単一の追加ピクセルも要求することなく、SigLIP 2(広く使用されている画像エンコーダー)から、OCRとドキュメント理解の面で意味的に優れたパフォーマンスを引き出しました。
誰もが持つ直感、そしてそれが外見以上に高価な理由
マルチモーダル大規模言語モデル(MLLM:画像とテキストを入力し、テキストを出力するモデル。GPT-4VやLLaVAなど)が小さな文字を読み間違えた場合、明らかな解決策はより大きな画像を入力することです。入力されるピクセル数が増えれば、より細粒度な視覚トークンが出力され、すべての文字を捉える確率が上がります。まさにこれがこの分野が進んできた方向性です。LLaVAのような初期システムはすべての画像を固定の336×336にリサイズしていましたが、Qwen2.5-VLやInternVLのような新しいシステムはネイティブ解像度を維持しようとし、ドキュメントをタイルのグリッドに分割して、各タイルごとに別々にビジョンエンコーダを実行することもあります。
この手法は機能しますが、無料ではありません。画像をタイルに分割することは、単一の入力に対してエンコーダを複数回フォワードパスすることを意味します。タイル数が増えると、言語モデルに入力される視覚トークンも増え、トランスフォーマーのコストがシーケンス長に比例して増加するため、コストは急速に高騰します。そのため、システム側ではこれらのトークンを圧縮するためにリサンプリングやピクセルアンシャッフルなどの手法を追加しますが、これにより独自のエンジニアリング上の複雑さや障害モードが生じます。解像度を一段階上げるごとに、レイテンシとコストも一段階上昇し、ベンチマークの数値が更新される遥か以前に、本番環境でタイムアウトとして現れる種類の問題です。
著者たちは、そのような対策に着手する前に、より鋭い問いを投げかけます。すでに使用している解像度から、本当にすべての情報を引き出しているのでしょうか。その例示は非常に説得力があります。1722ピクセルの高さを持つ、統計情報が多いスポーツポスターのような縦長のインフォグラフィックを想定してください。これを標準的な「中程度」の解像度である512ピクセルにダウンスケールします。文字はぼやけます。しかし、人間が小さくなったバージョンを細目に凝視すれば、ほとんどを読み取ることができます。私たちは文脈や大まかな文字の形から、劣化した文字を再構築するのが得意です。ビジョンモデルも同様の再構築を行っているのでしょうか。それとも、単にすでに持っている情報に対して十分に注意を払っていないだけなのでしょうか。後者である場合、より大きな画像は必要ありません。必要なのは、すでにコストを支払って取得している画像から、モデルがより多くの情報を抽出できるように教えることです。
安価な画像に高価な画像のような視覚能力を教える
この手法は「細部から粗部への監督(fine-to-coarse supervision)」と呼ばれ、図を見れば約30秒で理解できる。まず、凍結された事前学習済みSigLIP 2エンコーダから始める。「凍結」とは、このステップ中に重みがロックされ、変更されないことを意味する。同じ画像を2つのスケールで入力する:512×512ピクセルの安価なベース版と、1024×1024の高価なズームイン版である。両方のパスは特徴ベクトルのグリッドを生成する(これらは、画像の各小さなパッチに含まれる内容のモデル内部の要約と考えることができる)。解像度の高いパスは明らかにより細かい詳細、小さなテキスト、より細かなエッジを捉えるが、ベース版の形状と一致しない大きなグリッドを生成する。
そこで、著者たちは双線形補間を用いて高解像度の特徴グリッドをダウンサンプリングし、ベース解像度のグリッドと同じ形状に合わせた後、パッチごとに単純に平均化する。この平均化された結果が「教師」特徴量であり、高価なパスから得られた細部を真正面から捉えつつ、安価な出力と同じ形状でパッケージ化されている。
次に実際のトレーニングステップである。同じ事前学習済みエンコーダの別のコピーを取得する。このエンコーダは凍結されておらず、トレーニング可能で、安価な512×512画像のみを表示する。このエンコーダが生成する特徴量が、パッチごとに教師特徴量と一致するようにファインチューニングする(要約すると、2つの特徴グリッド間の絶対差を最小化する)。テキストラベル、合成キャプション、手動で注釈されたデータは一切使用しない。ここでの「監督」は、異なるサイズの生画像のみを用いてモデルが自らを教えることである。
トレーニング後、高価なマルチスケール教師セットアップは完全に破棄される。残るのは、正確に同じ512×512入力を受け取り、正確に同じ数のトークンを生成し、MLLMにドロップインチェックポイント交換としてスロットインできる単一のエンコーダである。しかし、その重みには、その画像のより詳細なバージョンがどのように見えるかの概念がエンコードされている。同じ入力、同じコスト、より良い出力。 これがトリックのすべてであり、知識蒸留の通常のセットアップであるより大きな別の教師モデルからの蒸留ではなく、同じ画像のより多くのピクセルを見る同じモデルからの蒸留である。
また、生成コストも安い。著者たちは450万枚の画像で90,000ステップトレーニングし、32台のA100 GPUで全体が34時間で完了した。これは、論文が「数百万GPU時間」と10億枚の画像のデータセットを消費すると述べている、ゼロからビジョンエンコーダを事前学習することと比較される。これは、ゼロから構築された新しいモデルではなく、既存のエンコーダに追加された軽量な磨き上げパスである。
パリ - メトロ路線図 1973 — roger4336 による flickr からの画像、CC BY-SA 2.0
スケールと損失の試行錯誤が実際に明らかにしたこと
最終的な手法にたどり着く前に、著者たちはいくつかの予備実験を行った。その結果は「大きいほど良い」という単純なものではなく、むしろ興味深い知見をもたらしたため、ここで詳しく見ていく価値がある。
教師信号のための単一スケール入力と複数スケール入力を比較したところ、512²のベースビューと1024²のズームインビューを組み合わせることで、どちらか一方のみを使用した場合よりも、12のベンチマーク中10で性能が向上した。しかし、第3のスケール(1536²)や第4のスケール(2048²)を追加しても、ほとんど効果が見られず、場合によっては性能が低下することさえあった。また、ベーススケールを伴わずに単独で高解像度のビューを使用した場合、組み合わせよりも性能が劣った。モデルは、単に詳細な情報を積み重ねるのではなく、粗いグローバルなビューと細かなローカルなビューの両方を必要とするようだ。
さらに、エンコーダが固定された小さなサイズでしか訓練されていない場合、高解像度画像をどのように処理するかについても検証した。セグメンテーションなどの密な予測タスクから借用された直感的なアプローチは、画像全体に重なり合うウィンドウをスライドさせてスライスし、重要な情報がタイルの境界に不適切に位置することを避ける方法である。しかし、ここではこの手法は逆効果だった。重なり合わないウィンドウの方が優位に立った。著者たちの推測では、重なり合う領域が一貫性のない扱いを受ける(一部のパッチが実質的に「二重にカウント」される)か、同じコンテンツが複数のウィンドウに現れる際に位置エンベディングが競合するためだと考えられる。いずれにせよ、コンピュータビジョンの別の分野からの先行する知見は、ここでは通用しなかった。
そして、複数スケールの特徴を組み合わせる際にも、最もシンプルな手法が勝った。形状を合わせるために双線形補間を行い、その後単純な非加重平均を行う手法が、チャネル方向の連結やピクセルアンシャッフルによるダウンサンプリングの両方を上回った。さらに、ドキュメントVQAのように詳細が重要なベンチマークでは、より多くの詳細が最も重要な場所でより多くの助けになるとの理論に基づき、高解像度の特徴に平均値を傾ける試みも行った。しかし、これも効果はなかった。単純な1:1の平均が、常に最良の結果を残し続けた。
実際の数値と、いくつかの実際の誤読の修正
70億パラメータのVicuna LLMを備えた標準的なLLaVAトレーニングパイプラインに組み込み、OCRに重点を置いたLLaVA-NeXTのインストラクションチューニングデータを使用することで、SigLIP-HDはSigLIP 2ベースラインに対して、推論コストを同一に保ちつつ、DocVQA(スキャンされた文書内のテキストを読み取るベンチマーク)を56.0から59.6へ、ChartQA(チャートやグラフからデータを読み取るベンチマーク)を61.6から65.2へ、HRBench(細粒度の視覚的詳細に特化したベンチマーク)を43.5から48.3へと向上させました。テストされたすべてのベンチマークを平均すると、このトレーニング設定は62.8から64.4へと向上しました。
この向上は特定のLLMに限定されるものではありませんでした。より小規模なLlama-3.2-3Bに置き換えると、ChartQAは45.2から49.8へと跳ね上がり、Qwen2.5-7Bに置き換えると、DocVQAは62.5から64.2へと向上しました。また、これはSigLIP 2だけの話でもありません。2021年のOpenAI CLIPエンコーダというはるかに古いモデルに適用した場合でも、同じ自己蒸留手法によりDocVQAは22.4から33.2へと押し上げられました。この手法が何を行っているのかに関わらず、それは特定のエンコーダの特性に縛られているわけではありません。
2つの結果が、単なるリーダーボードのノイズ以上のものとして際立っています。第一に、この手法は「ネイティブ解像度を使用する」アプローチ(AnyResタイル分割)と競合するのではなく、積み重ねることができます。AnyResの上に適用した場合でも、SigLIP-HDはChartQAをさらに3.5ポイント押し上げました。第二に、これは論文の抄録の主張が実際に現れる部分です。論文の定性的な例には、この記事の冒頭で述べたHOKA/HOOKAの誤読が正確に含まれており、さらにホワイトボードの写真では、ベースラインモデルが手書きの名前を「Brian Owens」と読み取るのに対し、ファインチューニングされたバージョンは正しく「Bryan Owens」と認識しています。これらは小さく具体的で、きれいなスキャンページではなく、野外で手書きやぼやけたバナーにカメラを向けた際に実際に発生する種類のエラーです。
OCRパイプラインの構築・購入において、なぜこれが重要なのか
ここで得られる最大の教訓は、SigLIPそのものに関するものではありません。むしろ、OCRやドキュメントAIエンジンの仕様としてベンダーが提示する「解像度」と「トークン予算」という数値だけでは、モデルが画像から実際にどれだけ情報を抽出しているかを完全に把握できないという点にあります。2つのエンコーダが全く同じ512×512の画像を入力し、同じ数のトークンを生成し、推論時のコストも同じであっても、トレーニング方法の違いにより、ドキュメントやチャートのベンチマークで数ポイントの差が生じる可能性があります。もし解像度の仕様とトークン数だけでエンジンを評価しているなら、同等に重要な変数を見過ごしていることになります。
実務的には、これはOCRをラボでのベンチマークではなく、本番環境で大量処理する人々にとって朗報です。高解像度のタイル分割パイプラインは小さな文字を捉えるための有効な手段ですが、フォワードパスとトークン数を増やすため、1ドキュメントあたりのレイテンシとコストが増大し、1日数千ページを処理する際には無視できない実数値となります。一方、サービングコストを増やさずに精度を向上させるための34時間の自己教師ありファインチューニングは、正当化が容易な変更であり、もし効果がない場合はチェックポイントの交換で済むため、再構築に比べて元に戻すのも容易です。
著者が明記し、隠していない正直な注意事項として、これが高解像度ネイティブ処理を陳腐化させるものではありません。画像をダウンスケーリングすると、一部のディテールは本当に失われ、モデルがそれを見る前に平均化されて消えたピクセルを、いかに巧妙なトレーニングで取り戻すことはできません。ここで得られるのは、すでにコミットした解像度予算の中から、より多くの精度を絞り出すことです。これは、高価なマルチタイルパイプラインで全てのドキュメントを処理する余裕がないチームにとって、まず最初に引くべきレバーとなるかもしれません。ただし、日本語のOCR実装においては、漢字や縦書きレイアウトといった、英語中心の論文やモデルがカバーしきれない特有の難しさがあるため、これらの要素がトレーニングデータや評価指標にどう反映されているかも併せて確認する必要があります。