ナビゲーション向けに訓練した500Mビジョンモデル、OCR-Benchのスコアが2倍以上に向上
元論文: Small yet Assistive: Spatially-Aware Post-Training for Low Vision — Rishabh Choudhary, Shreyansh Raj, Umesh Goyal, Shubh Kashyap, Shrestha Kumar, Sushovan Jena, Komal Kumar, Hisham Cholakkal, Aditya Nigam
ナビゲーション支援向けに訓練されたコンパクトなビジョン言語モデル(VLM)は、OCRに特化した個別の学習フェーズを経ずとも、OCR-Benchのスコアを大幅に向上させることができる。これは、IIT Mandi(インド工科大学マンディ校)およびMohamed bin Zayed University of Artificial Intelligence(ムハンマド・ビン・ザーイド人工知能大学)の研究チームによる論文『Small yet Assistive: Spatially-Aware Post-Training for Low Vision』における最も驚くべき成果の一つである。
2026年9月23日に公開された本論文では、Rishabh Choudhary氏らの研究チームが、視覚障害者およびロービジョン者(BLV: Blind and Low Vision)向けのオンデバイス型ビジュアルナレーターを構築した取り組みについて解説されている。研究チームは、5億750万(507.5M)パラメータの小型モデル「SmolVLM2-500M」を採用し、空間グラウンディング(空間認識への紐付け)、方向表現、メートル単位の距離測定、および危険検知をターゲットとした事後学習パイプラインを適用した。
完成したモデルを標準的なビジョン言語ベンチマークで評価したところ、その結果は目覚ましいものだった。OCR-Benchにおいて、モデルのANLSスコアは32.54%から65.54%へと上昇した。これは相対的に101.5%の向上である。またTextVQAでも、正解率が37.75%から54.47%へと44.2%向上した。
論文では、これらの結果を「BLVに特化した空間的な事後学習が、一般的な視覚テキスト推論(visual-text reasoning)能力へと転移し得る証拠」と解釈している。この性能向上は、文書認識に特化した学習フェーズによるものではなく、空間的にグラウンディングされた動画説明文(video description)の学習からもたらされたものである。
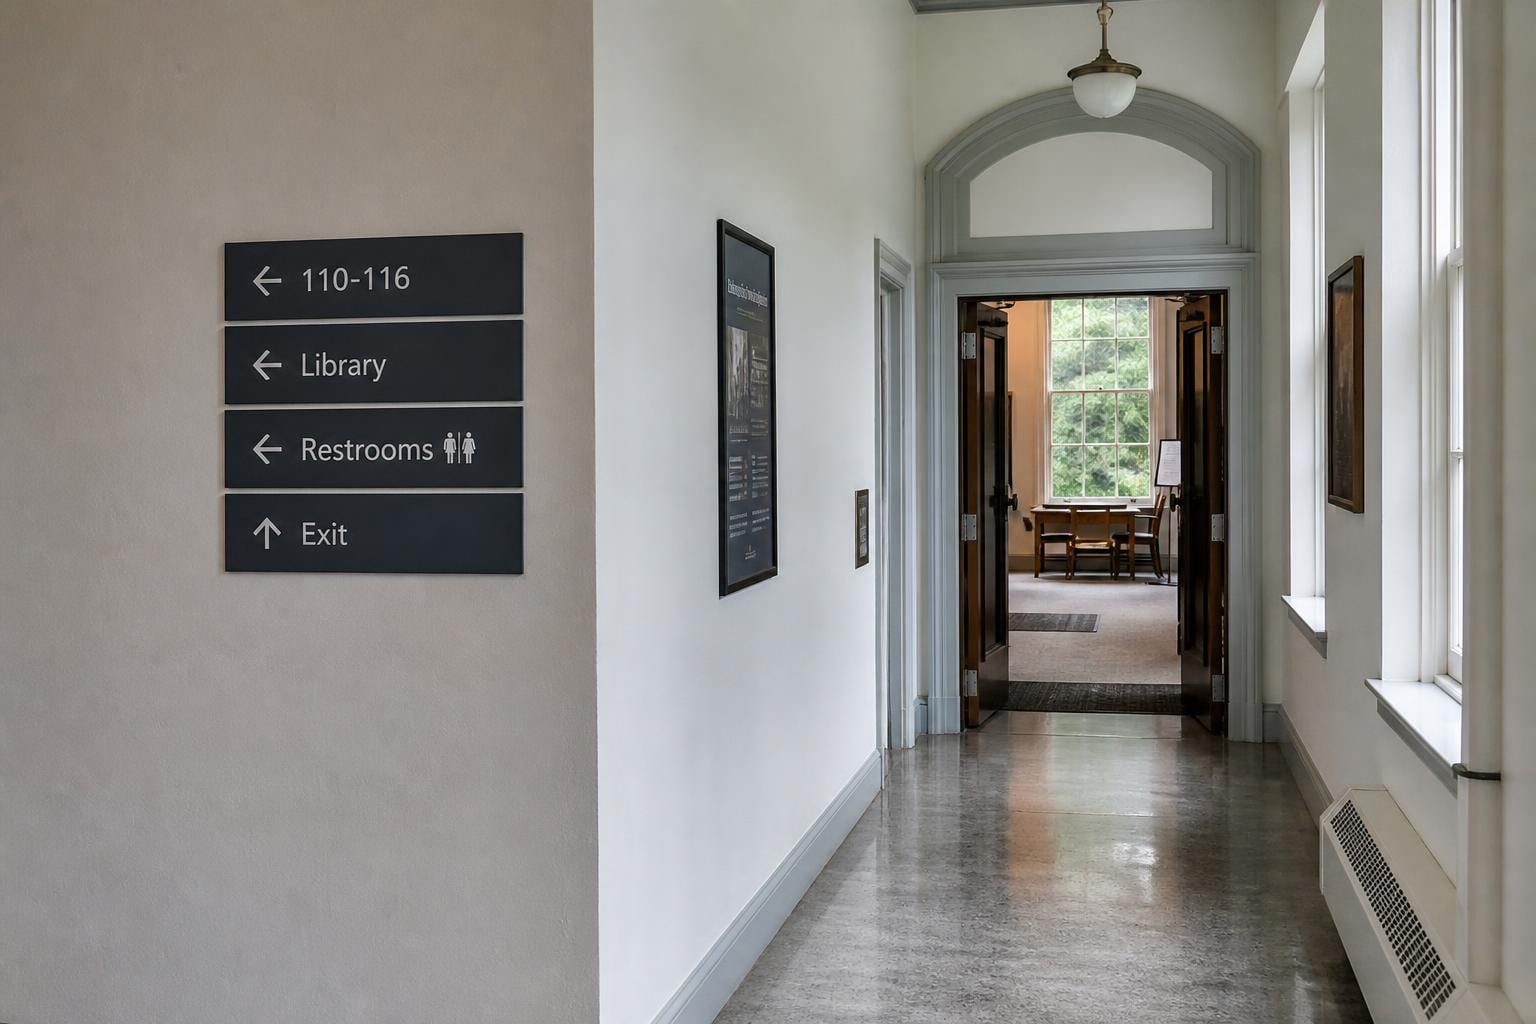
「Polite Hallway(無難な廊下)」問題
現在のビジョン言語モデルに部屋の様子を説明させると、「ドアと何人かの人がいる廊下」といった一般的で無難なキャプションを生成しがちだ。
画像キャプション生成のベンチマークであればこれでも十分かもしれないが、現実世界のナビゲーション支援としては不十分であると論文は指摘する。ITC(英国独立テレビジョン委員会)が策定し、Netflixや全米視覚障害者協議会(ACB)が採用しているプロフェッショナルな音声解説(オーディオディスクリプション)のガイドラインでは、現在形を用い、空間的にグラウンディングされ、危険要因を最優先にした客観的なナレーションが求められている。
音声解説ガイドラインに準拠したナレーターであれば、次のように表現するだろう。「前方に約8メートルの廊下が続いています。左側3メートルの位置に半開きのドアがあります。奥から人がこちらに向かって歩いてきます。」
大規模なVLMであれば、音声解説ガイドラインに準拠した高品質なナレーションを生成できるが、モバイル端末上で実行することはできないと論文は指摘している。一方、小型のVLMは実用的なレイテンシを実現できるものの、BLVのナビゲーション支援に必要な空間の詳細、方向の手がかり、危険要因への認識が欠けていることが多い。
研究者らはベースモデルとして「SmolVLM2-500M-Video-Instruct」を選択した。その基本アーキテクチャは以下の3つの要素で構成されている:
- 384×384ピクセルの入力を処理する、約8,640万(86.4M)パラメータのSigLIPビジョントランスフォーマータワー。
- LayerNormを備え、視覚特徴量を言語モデルのトークンへとマッピングする、約1,180万(11.8M)パラメータの線形射影コネクタ。
- 32ブロック、8,192トークンのコンテキストウィンドウを備えた、約4億930万(409.3M)パラメータのLLaMAアーキテクチャ採用SmolLM2言語デコーダ。
総パラメータ数は約507.5M(約5億750万)である。論文中では「500M」という表記は厳密なパラメータ総数ではなく、モデルクラスの呼称として用いられている。目指したのは、空間的にグラウンディングされたBLV向けの説明を生成でき、かつオンデバイス推論が現実的なコンパクトモデルである。
事後学習のアセンブリライン
著者らは、合成教師データによる指導、段階的な教師あり微調整(SFT)、ルールベースの強化学習、そしてリカバリーパッチを組み合わせた4段階のパイプラインを構築した。
[4 Video Keyframes (LUV Delta)] + [BLV Prompt]
                     │
                     ▼
         ┌───────────────────────┐
         │ Phase 1: SigLIP Only  │  (First 25% of training steps)
         └───────────┬───────────┘
                     ▼
         ┌───────────────────────┐
         │ Phase 2: LoRA Unfreeze│  (All LoRA adapters; Vision LR halved)
         └───────────┬───────────┘
                     ▼
         ┌───────────────────────┐
         │   GRPO Reinforcement  │  (6 rule rewards: distance, hazards, no hedging)
         └───────────┬───────────┘
                     ▼
         ┌───────────────────────┐
         │   SFT Recovery Patch  │  (50 curated samples)
         └───────────┬───────────┘
                     ▼
         [Fold 3 LoRAs into Base Weights] -> Single 969 MB FP16 Checkpoint
ステージ1:追加のモデル推論を伴わないキーフレーム抽出
学習用の入力を準備するため、チームはLUV色空間における知覚的色差を用いて、動画1本あたり4つのキーフレームを抽出した。まず各動画を均等な間隔で最大64フレームまでサブサンプリングし、フレーム間の平均絶対差分を計算して、最初のフレームに加えて最も差分の大きかった3フレームを選択した。
これにより、別のモデルによる推論ステップを挟むことなく、シーンの転換や重要な動きのイベントを捉えることができた。論文では、この低コストなLUV手法とDINOv2を対比させており、DINOv2は約8,600万パラメータと50〜100ミリ秒のオーバーヘッドを追加することになると説明している。
ステージ2:フェーズ切り替え型SFTによるGemma 4の蒸留
合成学習データを生成するため、チームは教師モデルとしてGemma-4-31B-ITを使用した。そのシステムプロンプトには、プロ仕様の音声解説ガイドラインが組み込まれていた。すなわち、現在形、安全に関わる重要な内容の優先、距離を含む明確な空間位置、観察可能な特徴のみの言及、第1文での環境タイプの提示、危険要因や障害物の明示、能動態、そして最大4文という制約である。
この教師モデルにより、9,646本の動画(Charadesから7,985本、AVCapsから1,661本)に対するキャプションが生成された。
フェーズの切り替えは、著者らが「アライメントされていない特徴への初期段階での過学習」と呼ぶ学習リスクに対処するためのものである。彼らは2つのフェーズからなる単一の学習ランを実装した:
-
視覚アライメント(最初の25%のステップ): SigLIPエンコーダとマルチモーダルコネクタのみを学習可能とした。視覚表現をまず音声解説の分布にアライメントさせるため、LoRAアダプタは凍結されたままとした。
-
完全な適応(残り75%のステップ): すべてのLoRAアダプタの凍結を解除し、ビジョンエンコーダの学習率を半分の5×10⁻⁶に引き下げた。独自の
DifferentialLRTrainerを用いて、AdamWのパラメータグループを個別に管理した。
システム指示、ユーザーテキスト、画像トークンを含むプロンプトトークンには-100のマスクが施され、因果的言語モデル(causal LM)の損失計算はアシスタントの応答トークンに対してのみ行われた。
ステージ3:決定論的リワードを用いたGRPO
教師あり微調整(SFT)は、モデルに音声解説の構造を学習させる。その後チームは、グループ相対方策最適化(GRPO: Group Relative Policy Optimization)を用いて、BLV特有の挙動を最適化した。
各プロンプトに対して、GRPOは4つの完了候補(completion)をサンプリングし、グループ内でその報酬を正規化した。学習済みリワードモデルを使用する代わりに、著者らはサンプルあたり1ミリ秒未満で計算可能な6つの決定論的・ルールベースの評価要素を構築した:
- 注意喚起・危険認識(Caution or hazard awareness): 参照データと生成テキストの双方が注意喚起項目を含んでいる場合に+0.40、参照データに含まれているのに生成で省略された場合に-0.30、参照の裏付けがないのに生成で勝手に追加された場合に-0.10。
- 方向のグラウンディング(Directional grounding):
{left, right, center, ahead, behind}(左、右、中央、前方、後方)の各単語に対して+0.08(最大+0.24)。 - メートル単位の距離(Metric distance): 一致するメートル距離が1つ以上含まれる場合に+0.20。
- 構造の簡潔性(Structural economy): 2〜4文の場合に+0.16、6文を超える場合に-0.10。
- 曖昧な表現へのペナルティ(Hedging penalty): 「〜と思われる(appears to be)」や「できません(I cannot)」などの表現に対して-0.20。
- 環境の識別(Environment identification): 第1文で14種類の環境用語のいずれかを用いてシーンの種類を言及している場合に+0.10。
これらのルールが組み合わさることで、本論文におけるBLV固有のリワードが定義されている。
ステージ4:リカバリーパッチ
複数ステージにわたる事後学習は、破局的忘却(catastrophic forgetting)を引き起こす可能性があると論文には記されている。一般的な記述能力を回復しつつ、BLV特有の空間グラウンディングを維持するために、著者らは軽量なSFTパッチを適用した。具体的には、GRPOのチェックポイントをベースとし、厳選された50件のGemmaキャプションを用いて、ランク64、alpha 128、学習率5×10⁻⁵、バッチサイズ2、勾配クリッピング1.0の新規LoRAアダプタで3エポックの学習を行った。
推論時には、SFTv2、GRPO、およびSFTパッチのアダプタが基本の重みへと順次マージされ、追加の推論オーバーヘッドのない単一のモデルが生成された。
報告された指標は、全方位的な向上というよりはトレードオフの存在を示している。表8において、MCF Ambience(雰囲気)スコアはGRPO適用時が3.44であったのに対し、最終パッチ適用後は2.94となっている。表7では、Action(動作)のカバレッジが88%から62%に低下している。その一方で、パッチ適用後のモデルはLLMジャッジの8つのサブ評価項目のうち7つで最高スコアを達成し、多くのキーワード指標や自然言語処理(NLP)評価尺度で最も強力な結果を残した。
ナビゲーションの事後学習がOCR-Benchスコアを倍増させた理由
最も驚くべき結果は、モデルの一般的な視覚能力に何が起きたかである。
| Model | Parameters | OCR-Bench ANLS | TextVQA Accuracy | TextVQA ANLS |
|---|---|---|---|---|
| SmolVLM2-256M (base) | 256M | 16.49% | 1.08% | 3.09% |
| SmolVLM2-500M (base) | 500M | 32.54% | 37.75% | 47.52% |
| SmolVLM2-2.2B (base) | 2.2B | 25.44% | 27.51% | 29.64% |
| LLaVA-1.5-7B | 7B | 28.78% | 47.79% | 62.96% |
| PaliGemma-3B | 3B | 69.76% | 76.09% | 87.36% |
| Smol-VL-BLV (Ours) | 500M | 65.54% | 54.47% | 65.97% |
| Qwen2.5-VL-3B | 3B | 88.56% | 81.12% | 90.39% |
OCR-Benchのスコアは、ベースラインであるSmolVLM2-500Mの32.54%から、Smol-VL-BLVでは65.54%へと急上昇した。TextVQAの精度も37.75%から54.47%へと向上した。
このファインチューニングされたモデルは、OCRにおいて2.2BパラメータのSmolVLM2ベースラインを約40パーセンテージポイント上回った。また、OCR-Bench ANLSおよびTextVQA正解率の双方でLLaVA-1.5-7Bを上回った。ただし、Qwen2.5-VL-3Bのようなより大規模なモデルが全体としてはリードを保っている。
空間的にグラウンディングされたシーン説明の学習が、なぜネットワークの文字読み取り能力を高めるのだろうか?
論文の考察では、教師データの内容がその要因として挙げられている。Gemmaが生成した説明文には、周囲の環境の状態、近くの危険物、方向の手がかり、人物の位置、衣服の色、そして動きが含まれていた。著者らは、こうした空間的グラウンディングに基づく教師信号が、小型モデルにおける空間マップの構築を促し、文字やテキスト文字列の幾何学的境界をよりシャープに解析できる構造的アライメントを生み出すと論じている。
これが転移に関して論文が提示している説明である。報告された実験はOCRおよびVQAにおけるゲインを実証しているものの、特定の注意機構(アテンションメカニズム)を特定したわけではなく、ナビゲーションとOCRが常に同一の内部表現に依存していると証明したわけではない。
ナビゲーション性能向上の詳細分析
458サンプルの評価セットにおいて、著者らは標準的なNLP指標とともにBLV関連キーワードのカバレッジを測定した。累積結果からは、各学習ステージが明確な寄与を果たしていると同時に、一部の側面でトレードオフが存在することが見て取れる。
| Metric | Condition A (Base) | Condition B (SFT) | Condition C (+GRPO) | Condition D (+Patch) | Change A→D |
|---|---|---|---|---|---|
| Spatial Coverage | 79% | 81% | 97% | 100% | +21 |
| Directional Cues | 29% | 51% | 88% | 100% | +71 |
| Distance Mentions | 45% | 20% | 22% | 100% | +55 |
| Obstacle Mentions | 77% | 85% | 92% | 96% | +19 |
| Moving Hazards | 16% | 21% | 17% | 66% | +50 |
| Step Changes | 4% | 7% | 7% | 5% | +1 |
| BLEU-4 | 0.74 | 1.66 | 1.97 | 13.53 | +12.79 |
| ROUGE-L | 10.74 | 17.66 | 17.93 | 30.49 | +19.75 |
SFTは基本的な記述構造を確立し、ROUGE-Lを10.74から17.66へ、BLV Mean(平均スコア)を79%から86%へと引き上げた。続くGRPOによってBLV Meanは93%へと上昇し、障害物のカバレッジは85%から92%へ、方向のカバレッジは51%から88%へと向上した。しかし、距離への言及は22%にとどまり、移動する危険物(moving hazards)のカバレッジは21%から17%へと低下した。
パッチの適用は最も強力なNLPスコアをもたらし、条件Dにおける方向と距離のカバレッジを100%、障害物カバレッジを96%、移動する危険物のカバレッジを66%へと押し上げた。ただし、すべての項目が改善されたわけではない。Action(動作)のカバレッジはGRPO後の88%から62%へと低下し、BLV Meanも93%から90%へとわずかに減少した。
別の人間による評価では、晴眼者のクラウドワーカー20名が5本のリアルタイム実演動画をレビューした。0〜5の評価尺度において、最終システムは「ナビゲーションとの関連性(Navigation Relevance)」で平均4.0、「注意・警告の正確さ(Caution/Alert Accuracy)」で3.5、「空間および方向の精度(Spatial and Directional Precision)」で4.5、「応答の簡潔さ(Response Conciseness)」で4.5、「総合的な信頼性(Overall Trustworthiness)」で4.0のスコアを獲得した。これらのスコアはモデルがナビゲーション支援という目標に適合していることを裏付けているが、完全な視覚障害者が単独で安全に移動できることを保証するものではない。
OCR転移が示す意義
軽量マルチモーダル研究の観点から、本論文は以下の3つのより限定的な結論を提示している:
1. 空間グラウンディングを意識した教師データは、画像内テキスト認識ベンチマークに転移し得る。 ただしこの結果は、あらゆるPDFやレシート、文書認識パイプラインが自動的に改善されることを意味するわけではない。なお、本研究は英語環境を前提としており、多くのOCRやVLMにとって最大の難所となる漢字・仮名の混在や縦書き看板への有効性はカバーされていない点に留意する必要がある。本研究が示したのは、このモデルと評価設定において、BLV向け事後学習が空間描写の品質とともにOCR-BenchおよびTextVQAのスコアを向上させたという点である。
2. 今回の構成において、オンラインGRPOは検証されたオフラインの選好学習手法を上回った。 バランス調整された評価セットにおいて、DPOのMCFスコアは3.89、RLAIF-V DPOは3.88にとどまり、いずれもSFT v2のスコア(4.38)を下回った。対してGRPOはMCFで4.18、NAFで4.20を達成した。著者らは、方向表現、距離への言及、危険認識を徹底させるには、オンラインリワードの方が適していたと論じている。
3. 教師・生徒型の蒸留により、アクセシビリティに特化した記述動作をコンパクトなモデルに転移できる。 Gemma-4-31B-ITが生成した9,646件の音声解説準拠キャプションを、507.5Mパラメータの生徒モデルが合成教師データとして利用した。論文ではこれを、強力な教師モデルが生成したデータによって小型VLMにより精密な空間グラウンディングを誘導できる証拠として提示している。
高架鉄道の駅の標識は非常に見づらかった — shankar s. 作、flickrより、BY 2.0
442メガバイトへの圧縮
モデルの学習には48GBのRTX A6000 GPUを1基使用した。しかし、その成果物をスマートフォン上で動作させるには、個別の変換および量子化プロセスが必要だった。
著者らは学習済みの3つのLoRAアダプタをベースの重みにマージし、969MBのfloat16 HuggingFaceチェックポイントを作成した。これをGGUF形式にエクスポートすることで、モデルは2つのデプロイ用コンポーネントに分離された:
- 言語モデルバックボーン:float16で783MB。
- ビジョンプロジェクター(
mmproj.gguf):float16で191MB。
標準的なQ4_K_M量子化により言語モデルは290MBまで削減されたが、一律の4ビット圧縮では位置推論能力が低下することが報告された。そのため著者らは、重要度重み付け非線形量子化であるIQ4_NLを採用した。
まず、約500件のBLVキャプションからなるキャリブレーションセットに対してllama-imatrixを実行した。これにより、どの重みチャネルが最も頻繁に活性化されるかを記録し、非均一なビット割り当てのための重要度マトリクス(importance matrix)を生成した。
┌────────────────────────────────────────────────────────┐
│               Deployed Package (442 MB)                │
├────────────────────────────┬───────────────────────────┤
│ LM Backbone (251 MB)       │ Vision Projector (191 MB) │
│ - Self-Attention: Q5_K     │ - Native Float16          │
│ - Other Layers: IQ4_NL     │ - Unquantized             │
│ - Importance-Matrix Tuned  │                           │
└────────────────────────────┴───────────────────────────┘
次に、混合精度のオーバーライドを適用した。自己注意機構の射影(q_proj、k_proj、v_proj)はより高精度なQ5_Kで量子化し、ネットワークのその他の大半の層にはIQ4_NLを使用した。著者らは、これらのアテンション機構が方向の一貫性を維持する上で重要であると説明している。
付録によると、このオーバーライドによる容量増は約15MBにとどまり、251MBの言語バックボーンが完成した。191MBのfloat16ビジョンプロジェクターと合わせることで、オンデバイスパッケージ全体の容量は442MBとなった。
オンデバイスにおけるレイテンシの厳しい現実
著者らはこの442MBのパッケージを、Exynos 1480プロセッサと8GBのRAMを搭載したSamsung Galaxy A55にデプロイした。Termux経由でllama.cppをネイティブコンパイルし、4つのCPUスレッドを用いて最終構成を実行した。
最終的な21フレームのベンチマークにおいて、モデルは平均291ミリ秒でRAMにロードされ、ピーク時のRAM使用量は約780MBに達したが、クラッシュやOOM(メモリ不足)エラーは発生しなかった。生成速度は平均39.3トークン/秒で、生成自体は約1.4秒で完了した。
しかし残念なことに、視覚入力から説明文の生成完了までに要した合計時間は27.1秒に及んだ。
その大半の時間はプロンプト評価(prompt evaluation)に費やされていた。A55のCPU上で視覚入力とプロンプトトークンを処理するのに、生成開始前に平均25.1秒を要したのである。
| Platform | Hardware Backend | TTFT (Prompt Eval) | Generation Speed | Total Latency |
|---|---|---|---|---|
| Cloud | Nvidia T4 GPU | 1.39 s | 187.42 tok/s | 1.70 s |
| MacBook | Apple Silicon (Metal) | 1.95 s | 132.6 tok/s | 2.41 s |
| Samsung A55 | Exynos 1480 (CPU Only) | 25.10 s | 42.9 tok/s | 27.10 s |
論文では、21フレームの最終ベンチマークにおける平均として39.3トークン/秒、ハードウェア間比較において42.9トークン/秒と報告されており、これらは異なるベンチマークの集計値を示している。いずれの場合も、A55のレイテンシはCPUのみによるプロンプト評価処理が支配的となっている。
同じ量子化モデルをMetal対応のApple Silicon Macで実行した場合、マルチモーダルの全処理が2.41秒で完了し、クラウドのNvidia T4 GPU上では1.70秒で完了した。著者らは、A55の処理が遅い原因はモデル単体の生成速度にあるのではなく、利用可能なハードウェアアクセラレーションへのサポートが得られなかったことにあるとしている。
論文では、いくつかのアスペクト(高速化アプローチ)が調査された:
- Android NNAPI:
llama.cppのAndroidビルドはNNAPI実行プロバイダを提供していない。そのGPUパスはOpenCLとVulkanを対象としているが、SamsungのExynos NNAPIドライバはサポートされていない演算に対して頻繁にGPUへのフォールバックを行う。 - ONNX Runtime Mobile: Hugging Face OptimumはSmolVLM2をエクスポートできなかった。モデルのSigLIPエンコーダとシーケンス途中での視覚トークン挿入がエクスポート対象として登録されていなかったため、エクスポーターが
KeyError: 'smolvlm2'を送出した。 - MLC-LLM: テストされたアクセラレーションパスはLLaMA、Mistral、Qwenモデルをサポートし、Snapdragonハードウェアをターゲットとしている。SmolVLM2は含まれていなかったため、Exynos端末はCPUへとフォールバックした。
- VulkanおよびOpenCL: Vulkanのヘッダーは利用可能だったが、ベンダー固有のMali ICDローダーが存在しなかった。対応するプロプライエタリなOpenCLドライバもTermuxからはアクセスできなかった。
- Samsung ONE SDK: ExynosのNPUを直接プログラミングするには秘密保持契約(NDA)の締結が必要であり、TFLiteまたはONNXから生成された
.nnc形式のモデルが必要とされた。プロジェクト期間中にアクセス権は付与されなかった。
端末には専用のNPUが搭載されているものの、テストされたTermuxデプロイ環境ではそれを利用することができなかった。その結果、モデル自体は端末のメモリに快適に収まるものの、負荷の高いビジュアルプレフィックスの計算を汎用CPUコアに頼らざるを得ない状況となった。
死角:いまだ課題として残る点
著者らはモデルの限界について率直に述べている。アクセシビリティやミッションクリティカルな空間把握タスクに向けたシステムを設計する場合、以下のギャップを理解しておくことが不可欠である:
- 段差の変化はいまだ言及されにくい: 条件Dでは方向のカバレッジが100%に達したものの、段差の変化(step changes)に関してはわずか5%にとどまった。著者らはこの要因を、元データセットにおいて階段、縁石、高低差などのシナリオが過小にしか含まれていなかったためとしている。
- 移動する危険物の検知は不完全: 移動する危険物(moving hazards)のキーワードカバレッジは最終条件でも66%にとどまり、依然として改善の余地が大きい。
- 距離推定は合成データ由来: 「前方3メートル」といった距離情報は、教師モデルによって生成された大まかな視覚的判断であり、センサーによって計測された実測値ではない。
- シーンカバレッジの限界: データセットには屋内外のシーンが一定数含まれているものの、著者らは道路、混雑したシーン、その他ナビゲーションが困難な環境を今後の課題として挙げている。
- ロービジョンと完全な視覚障害の違い: 本研究は主にロービジョンのユーザーを対象としている。著者らは、完全な視覚障害者が安全に単独歩行するために求められる信頼性にはまだ達していないと述べている。
- 晴眼者による人間評価: 報告された人間による評価は、20名の晴眼者のクラウドワーカーによって実施された。著者らは、BLV当事者による評価を重要な次のステップとして位置づけている。
展望
Smol-VL-BLVは、スマートフォン上でオフライン動作可能なデプロイ性を維持しながら、空間グラウンディングを伴うナビゲーション向けシーンナレーションに小型VLMを特化させられることを示した。
教師モデルが生成したデータによる指導と決定論的強化学習を組み合わせることで、Choudhary氏らのチームは、507.5MパラメータのモデルにおいてBLV固有の空間グラウンディング能力と一般的な視覚テキストベンチマーク性能の双方を向上させた。
OCR研究にとって重要な成果は、実測された能力転移(transfer)である。SmolVLM2-500Mベースラインと比較して、OCR-BenchのANLSスコアは相対的に101.5%向上し、TextVQAの精度は44.2%上昇した。著者らは、空間グラウンディングを意識した記述学習がより優れた空間マップの構築や幾何学的解析を促すためと説明しているが、本論文ではこれをOCRに関する普遍の法則ではなく、一つの実験結果および仮説として提示している。
著者らは今後、階段、縁石、高低差、移動する危険物をカバーするデータの追加収集、段差変化に特化した専用リワードの導入、混雑した横断歩道や交通量の多い交差点での評価、幾何学に基づく空間正確性評価指標の開発、そして誤った方向指示や事実無根の危険警告、架空の距離推定を検出・抑制する事実性(factuality)チェック機能の追加を計画している。