加载中...
博客
用通俗易懂的语言解读正在塑造 OCR 与文档 AI 的最新研究。
阅读约 17 分钟arXiv:2610.11148
SP-DocReader:基于差异感知自博弈,将 Vary-600K 的 OCR 错误率减半
在 Qwen3-VL-4B 上,SP-DocReader 在冻结骨干网络、仅训练 OCR 模块的前提下,相比两轮监督微调,将 Vary-600K 的字符错误率降低约 54%。
阅读约 35 分钟arXiv:2610.11818
小模型与结构化数据:轻量级 VLM 能否替代云端 API 完成复杂文档抽取?
4B–7B 参数的视觉模型能否在本地 GPU 上从杂乱的历史档案中抽取结构化 JSON?FAU 埃尔朗根-纽伦堡大学的一项新研究在三大高校馆藏档案集上对 8 款开源轻量级 VLM 展开了基准评测。
阅读约 21 分钟
我们向 184 款 OCR 引擎发送了一张纯白空白页,有些居然“读”出了内容
当你向现代视觉模型输入一张 800×1000 的纯白空白图像时,传统 OCR 引擎会保持沉默,而新型模型却能凭空编造出 UFO 信件、维多利亚时代的诉讼判决以及肠道健康广告。
阅读约 21 分钟arXiv:2610.07091
别再把每一页都送给视觉模型:来自花旗、安永与英伟达研究员的实践启示
一篇关于文档摄入的预印本论文指出,其内部语料库中 92% 的页面无需页面级 OCR;文章深入解析了结构感知分块技术,并量化了提取耗时的具体分布。
阅读约 7 分钟
OpenOCR 现已支持捕获 Gemini 3.1 Flash-Lite 及后续所有引擎返回的空结果
Google 的 Gemini 3.1 Flash-Lite 有时在页面完全可读时返回空文本却判定为成功;OpenOCR 现已可在所有引擎上检测此类情况,明确告知失败原因,保留多页 PDF 中的其他有效页面,且计费绝不超过服务商实际收取的费用。
阅读约 18 分钟arXiv:2610.02880
找到了却读不懂:为什么视觉语言模型依然离不开 OCR
在 FoveDoc-Bench 上加入 CPU OCR 提取文本使文档问答准确率提升了 13 到 16 个百分点,揭示了“检索到证据”与“有效利用证据”之间的鸿沟。
阅读约 14 分钟
推出 OpenOCR Stratify
我们正在设计 Stratify,旨在将复杂文档拆解为可读单元,为每个部分挑选最合适的工具,并使识别结果始终与原始出处保持关联。
阅读约 17 分钟arXiv:2610.01191
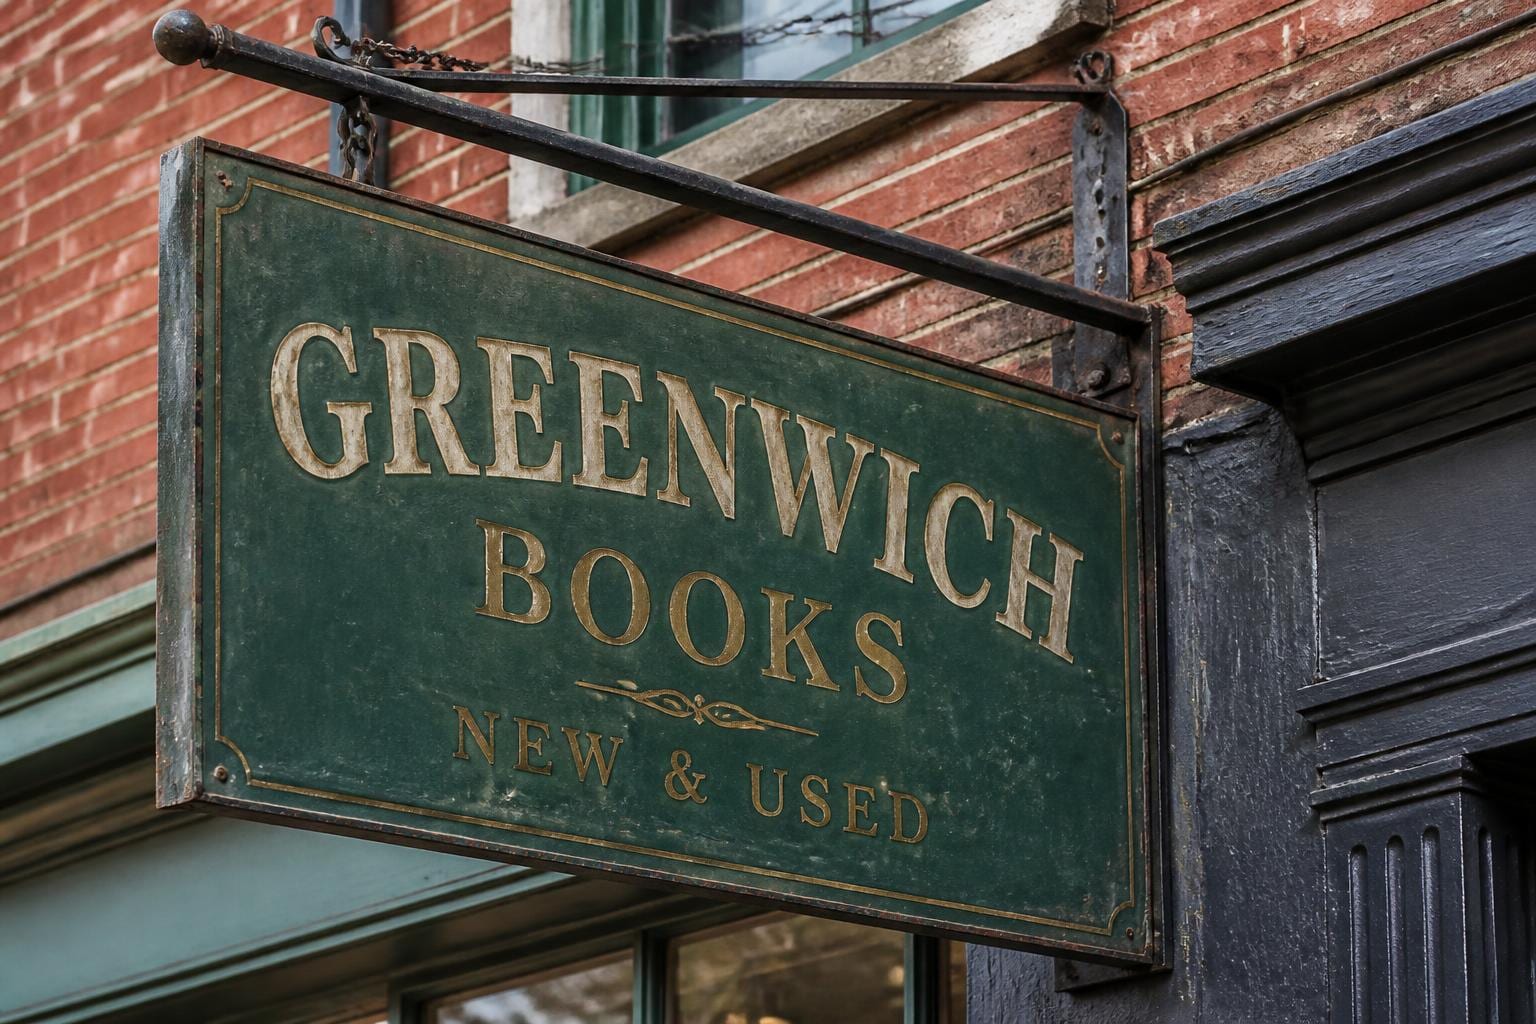
无需深度学习的手写孟加拉文切分:图像处理技术深度解析
KUET 研究人员如何利用自适应图像处理与迭代轮廓计数,在彩色纸张与阴影干扰下实现手写孟加拉文词语切分。
阅读约 26 分钟arXiv:2609.40356
视频场景文本编辑为何频频失效:ViTeX-Bench 如何揭示多重权衡
ViTeX-Bench 对真实视频中的精准文本替换进行了深入评测,其结果揭示了字符准确性、运动稳定性与场景保真度之间的权衡困境。
阅读约 19 分钟arXiv:2609.28757
教 500M 视觉模型学习导航,意外使其 OCR-Bench 得分提升超过一倍
研究人员针对盲人与低视力辅助对一个 500M 视觉语言模型进行了后训练,使其 OCR-Bench ANLS 得分提高了 101.5%,表明空间定位能力可以迁移至视觉文本推理。
阅读约 16 分钟arXiv:2609.29240
打破幻觉循环:TOLA 如何将扩散文本超分辨率压缩至单步
扩散模型虽能清晰化模糊文本,但在迭代修复过程中错误的文本先验往往会强化错误的字符识别;TOLA 采用单次图像预测机制,将实测推理耗时从 9.95 秒骤降至 132 毫秒。
阅读约 10 分钟arXiv:2608.13783
14 年来,ImageNet 一直在用错误的“标准答案”给模型打分
一项针对 ImageNet-1k 的最新重新标注发现,其 12% 的标签存在错误,且三分之一的图像实为多标签;修正这些错误后,模型准确率最高提升了 6 个百分点。
阅读约 11 分钟arXiv:2608.12911
当 OCR 模型看不清字段时,它会凭记忆“猜”出你的真实生日
最新基准测试表明,文档 AI 模型在遇到模糊的证件字段时不仅会识别错误,还会直接调用训练数据中的记忆强行填补,从而泄露真实用户的个人隐私。
阅读约 13 分钟arXiv:2608.18957
深入解析哈佛构建的 2260 万图像处理管线:如何发掘被 OCR 忽视的书籍配图
哈佛大学的新管线利用专用轻量模型替代昂贵的 VLM,从百万本扫描图书中成功提取出 2260 万张插图。
阅读约 9 分钟arXiv:2608.18696
一套传统 OCR 流水线刚刚在梵文识别上击败了 Gemini、GPT 和 Claude
仅需校正三页,微调后的 CRAFT+GNN+CTC 流水线在历史梵文手稿识别准确率上便超越了 Gemini、GPT 和 Claude。
阅读约 9 分钟arXiv:2608.22366
将糟糕的 OCR 猜测喂给 AI 校正器:何时能成助力,何时毁掉整页
一项针对阿拉伯语手稿的最新研究发现,“让 AI 修复 OCR 错误”的做法,只有在 OCR 初步识别结果足够接近真实内容、值得参考时才真正奏效。
阅读约 9 分钟arXiv:2608.22346
按评分细则打分,而非凭感觉:一份独特的考试数据集
一份全新的数据集将 485 份扫描答卷与实际评分细则逐项匹配,记录每项标准的具体得分,而非仅仅给出一个最终总分。
阅读约 9 分钟arXiv:2608.26091
保留图纸几何信息读懂公路设计图:深入解读 PlanSightRAG
一种新型 RAG 系统完全跳过 OCR,直接基于工程图图像进行推理,在 DOT 图纸上的检索准确率达到 91%。
阅读约 17 分钟arXiv:2609.03445
编译器在环:腾讯 DocEDR 如何通过渲染检查与修复 OCR
腾讯 DocEDR 利用预测结果的渲染图进行 OCR 诊断与修复,在公式诊断 Case-F1 指标上相比 DOCR-Inspector-7B 提升了 30.99 个百分点。
阅读约 20 分钟arXiv:2609.03595
合成数据能将泰语OCR带向何方?揭秘达到1.24%中位字符错误率的秘诀
受控合成文档重建帮助一个0.9B的泰语OCR模型在五个评估集上超越了Typhoon OCR 7B,但在手写识别方面存在重要局限且存在严重错误。
阅读约 15 分钟arXiv:2609.02486
别再给视觉大模型塞十页文档:深入解析ViSAR的免训练自适应检索
固定Top-k视觉检索会降低视觉大语言模型的速度并损害准确性,ViSAR利用多向量几何减少上下文大小,将延迟降低高达58.7%。
阅读约 13 分钟arXiv:2608.31107
OCR基准测试中隐藏的捕获设备偏差:VeriCam跨设备测量的内容
VeriCam 研究 LPLCv2 交通图像中的捕获设备偏差,使用成对验证和图聚类来对未知的捕获设备类别进行分组。
阅读约 16 分钟arXiv:2608.28248
合成布局,更优的竖排日文OCR:深入 Synth-JDoc
Synth-JDoc 结合程序化 HTML/CSS 布局、生成图像和文档退化,提升了五个评估的视觉语言模型中四个的垂直日文 OCR 性能。
阅读约 8 分钟arXiv:2608.26921
阿拉伯语手稿并非从上到下阅读,现在有一个数据集承认了这一点
AraMS-28k 是一个包含 28,600 行真实历史阿拉伯语手稿的数据集,它最终告诉 OCR 模型页边注在文本中的实际归属位置。
阅读约 9 分钟arXiv:2608.27169
AI阅读了一枚2000年前的印章,并即兴创作了一首诗
一项新基准在3000年中国文物上测试OCR,即使最佳模型准确率也不足58%,且会充满自信地产生幻觉。
阅读约 9 分钟arXiv:2608.20011
当对齐图像模型使其拼写能力变差时
一篇新论文揭示了偏好调优流模型为何会悄然破坏生成文本,并提出了一种将OCR准确率提升47.5%的修复方法。
阅读约 9 分钟arXiv:2608.20122
旨在让 GPT-5 失败的 OCR 基准测试
GPT-4o 对扭曲、带水印或 AI 混合文本的识别准确率为 23%。一种新的训练方法在保持正常 OCR 性能的同时,将该准确率提高了近三倍。
阅读约 8 分钟arXiv:2608.12898
为什么拍摄文档仍然会破坏大多数OCR模型
NaviDC-OCR 在一个模型中处理扫描和手机拍摄的文件,解决现有基于 VLM 的解析器难以处理的页面扭曲、表格和公式问题。
阅读约 7 分钟arXiv:2608.15698
你的聊天机器人找不到包含答案的图表。这篇论文试图解决这个问题。
ConceptFormer 教导检索模型在图表和布局中寻找证据,而不仅仅是文本,以两位数的优势击败了 OCR 和视觉基线。
阅读约 8 分钟arXiv:2607.27558
像工程师而非扫描仪那样阅读蓝图的AI
Drawing-Recode 将扫描 CAD 图纸上的尺寸文本与其测量的精确几何图形关联起来,然后从结果中编写可编辑的 3D CAD 代码。
阅读约 10 分钟arXiv:2607.27902
一个补丁足矣:2B参数模型如何在路牌识别上超越GPT-5.4
一个2B参数模型通过为每个单词精确指向一个图像块,在识别路标方面击败了GPT-5.4、Claude和Gemini。
阅读约 8 分钟arXiv:2607.25390
让扩散模型真正适用于OCR的一步技巧
新论文表明,经过适当调优的单次确定性扩散传递在分类、检测和OCR任务上优于较慢的多步修复方法。
阅读约 8 分钟arXiv:2607.24651
别再让 AI 画框了:一种证明答案来源的更好方法
一项新研究发现,要求视觉语言模型引用其证据而非绘制边界框,可使它们正确引用文档相关部分的频率大致翻倍。
阅读约 8 分钟arXiv:2607.22200
OCR模型正在读取你的空白页边距,这就是它速度慢的原因
一篇新论文通过让模型忽略空白边距,将基于VLM的OCR视觉token减少了50%,且几乎不损失准确率。
阅读约 8 分钟arXiv:2607.15509
三个AI模型走进来,从零开始设计了自己的OCR网络
GPT-5、GPT-4o 和 Claude Sonnet 4 运行了 270 次实验,自主设计手写识别网络,全程无人类架构师参与。
阅读约 8 分钟arXiv:2607.17052
跳过视觉层有效,直到你要求它阅读文本
进化搜索为VLMs找到了比朴素剪枝更便宜的视觉路径,但针对任务的捷径可能会悄悄破坏OCR准确率。
阅读约 9 分钟arXiv:2607.19315
为什么训练集中看起来最繁忙的扫描图像可能会损害您的OCR模型
一种新的无标签度量标准统计图像激活的特征方向数量,通过该标准进行剪枝有助于OCR模型通过剔除最繁忙的文档来提升性能。
阅读约 7 分钟arXiv:2607.20385
波斯语有1.1亿使用者,但几乎没有OCR数据。本文伪造了34.3万页数据来解决这一问题
一个新的数据集伪造了34.3万张波斯语文档图像,以修复OCR最严重的盲点:一种字母形状会随相邻字符变化的书写系统。
阅读约 9 分钟arXiv:2607.18217
必须正确识别你Logo的视频AI
一篇新的视频生成论文将OCR输出直接输入扩散模型,从而避免产品Logo和标签文字变得模糊不清。
阅读约 9 分钟arXiv:2607.16060
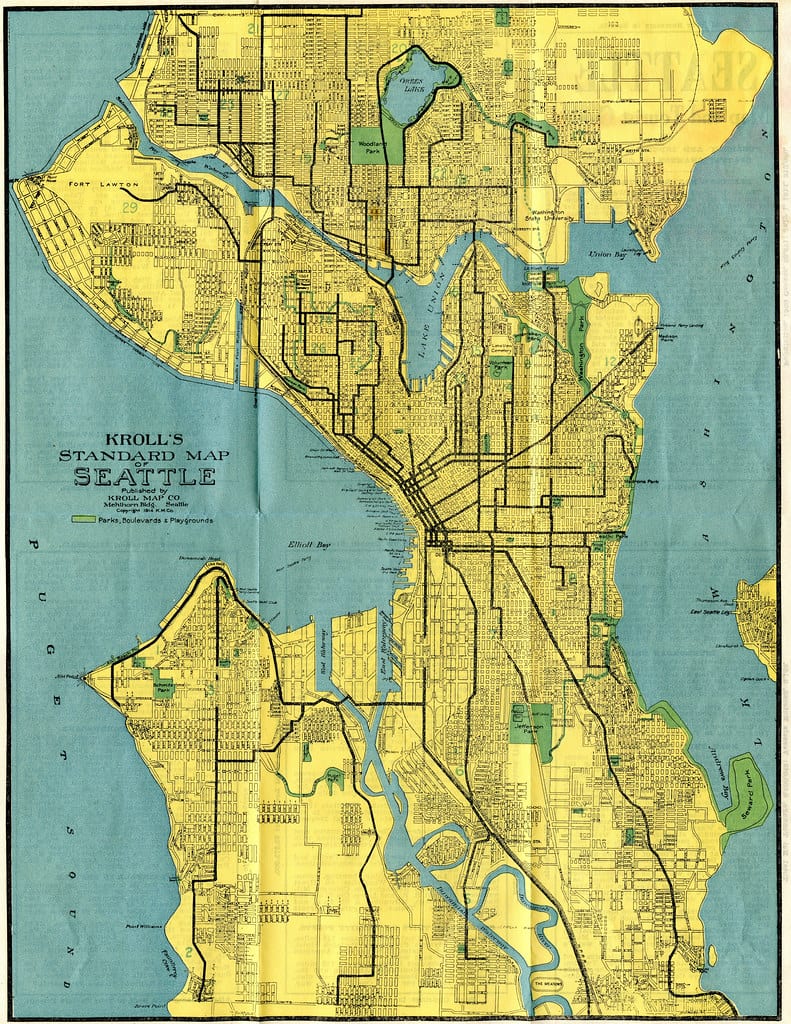
AI能否在不歪曲数据的情况下为你绘制漂亮的图表?
一项新基准显示,图像模型在处理艺术图表时经常出错,包括柱状图高度错误、标签混乱、图例不匹配,并测试了一种能同时确保艺术性和数学准确性的修复方案。
阅读约 11 分钟arXiv:2607.09068
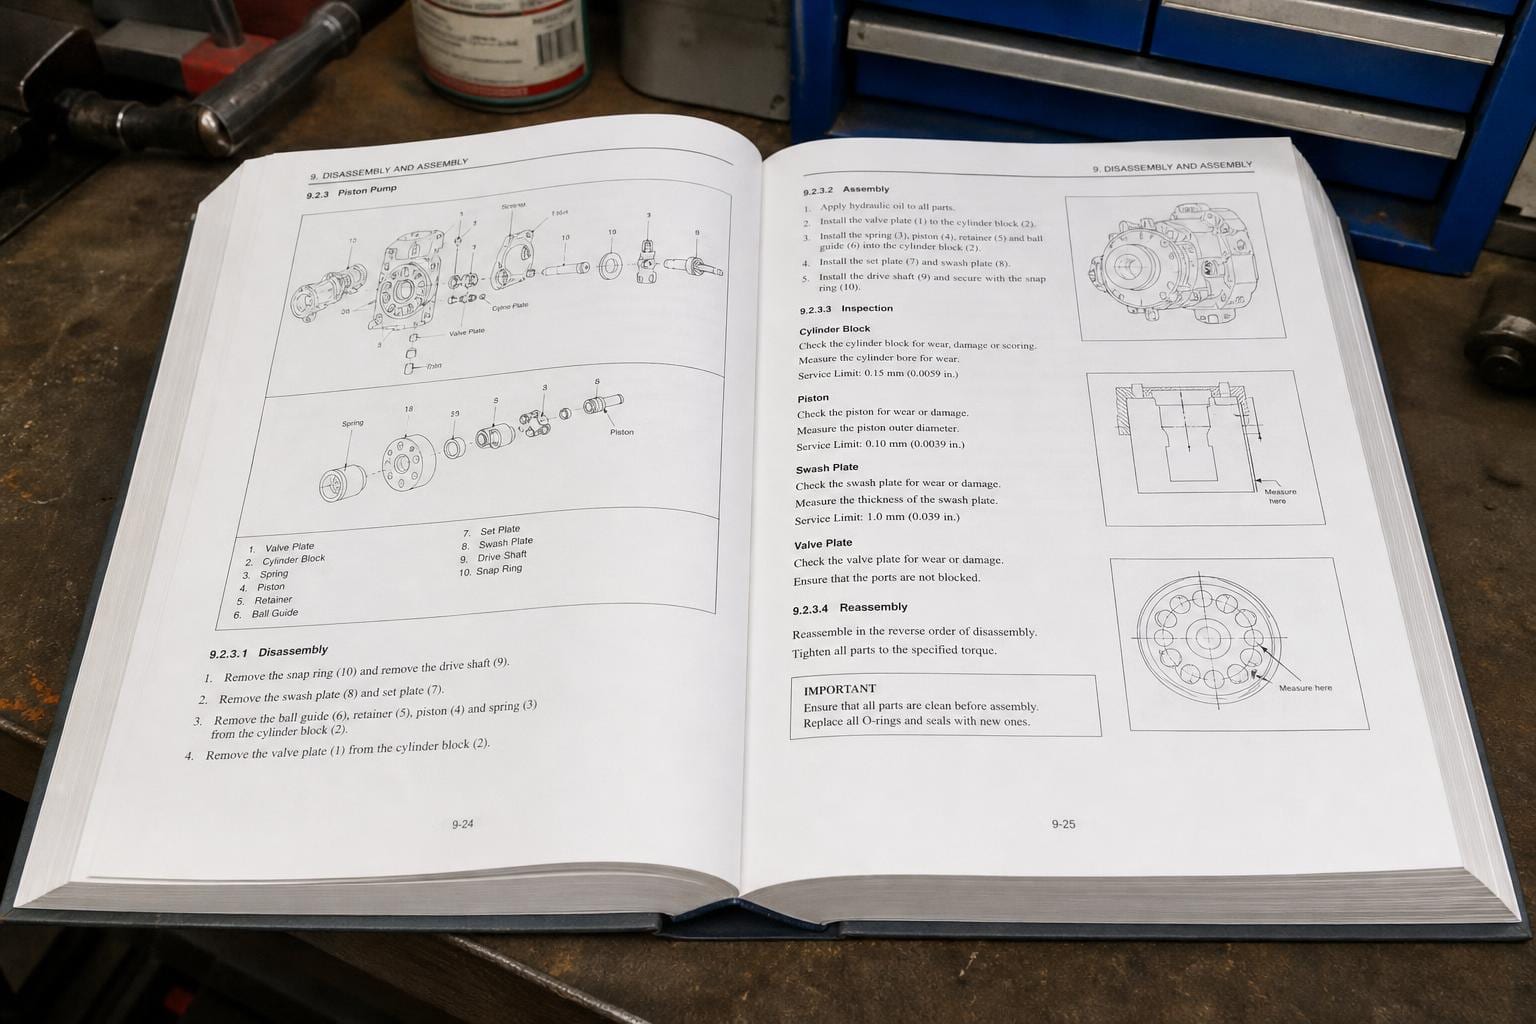
能捕捉AI模型伪造视觉的地图基准测试
OmniMapBench 显示顶级 AI 模型在地图问题上的得分上限为 75%,揭示了众多“视觉”基准测试实际上仅靠文本即可解决。
阅读约 8 分钟arXiv:2607.10400
为什么AI文档阅读器在处理长PDF时会中途“卡壳”
一项新的合成基准测试显示,顶级视觉语言模型在读取长文档中间部分时的表现明显下降,图表理解能力也大幅减弱。
阅读约 8 分钟arXiv:2607.13458
OCR在处理弯曲和倾斜文本时表现不佳的隐藏原因
一种新的位置编码技巧教会OCR Transformer进行二维思考,其增益恰好出现在你预期的地方:弯曲、旋转和扭曲的文本。
阅读约 7 分钟arXiv:2607.14041
从未接受过职业训练的OCR专家
一篇新论文根据手写风格将历史满文手稿路由给OCR专家,而针对每种风格表现最佳的专家往往并未在该风格上进行过训练。
阅读约 9 分钟arXiv:2607.11192
最佳AI模型在PDF上仍有85%失败率的基准测试
GDP.pdf 使用真实的专业 PDF 而非玩具级 OCR 任务来测试 AI。表现最佳的模型仅通过了 15% 的项目。以下是这一差距为何重要的原因。
阅读约 8 分钟arXiv:2607.11562
为什么擅长处理照片的模型却不擅长阅读你的发票
MonkeyOCRv2 在 1.13 亿张文档图像上训练其视觉编码器,而非借用为猫和汽车构建的编码器,且一个仅 0.7B 的模型击败了 3B 的竞争对手。
阅读约 9 分钟arXiv:2607.09488
隐藏在你视觉编码器中的免费午餐:SigLIP-HD 做对了什么
一种新的训练技巧使视觉编码器在相同分辨率和相同推理成本下能更好地读取文本,无需更大的图像。
阅读约 6 分钟arXiv:2607.08014
一家从不分享照片的工厂,却学会了阅读标签
FedTR在无法共享数据的工厂间训练OCR模型,在不泄露任何图像的情况下实现了95.5%的单词准确率。
阅读约 8 分钟arXiv:2309.11419
Microsoft 的 KOSMOS-2.5:一个 OCR 模型,两种截然不同的任务
微软的 KOSMOS-2.5 通过一个 1.3B 参数的单一模型,同时以两种方式读取文档:bounding-box OCR 和完整的 markdown 重构。
阅读约 9 分钟arXiv:2502.18443
你的 PDF 价值数万亿个 Token,而大多数 OCR 流水线正在将它们浪费掉。
olmOCR 展示了经过微调的 7B 视觉模型如何在阅读 PDF 方面击败 GPT-4o,且每页成本仅为后者的 1/35。
阅读约 7 分钟arXiv:2403.04473
TextMonkey:教视觉语言模型指向它刚刚阅读的行
TextMonkey 完全跳过 OCR,将文档作为图像读取,并用显示其查看位置的边界框为每个答案提供支持。
阅读约 9 分钟arXiv:2109.10282
TrOCR:当你抛弃 OCR 的所有传统方案时会发生什么
Microsoft 的 TrOCR 完全摒弃了 CNN 和 RNN,通过使用两个预训练的 Transformers,以更简单的流水线超越了最先进的 OCR 模型。
阅读约 8 分钟arXiv:2409.01704
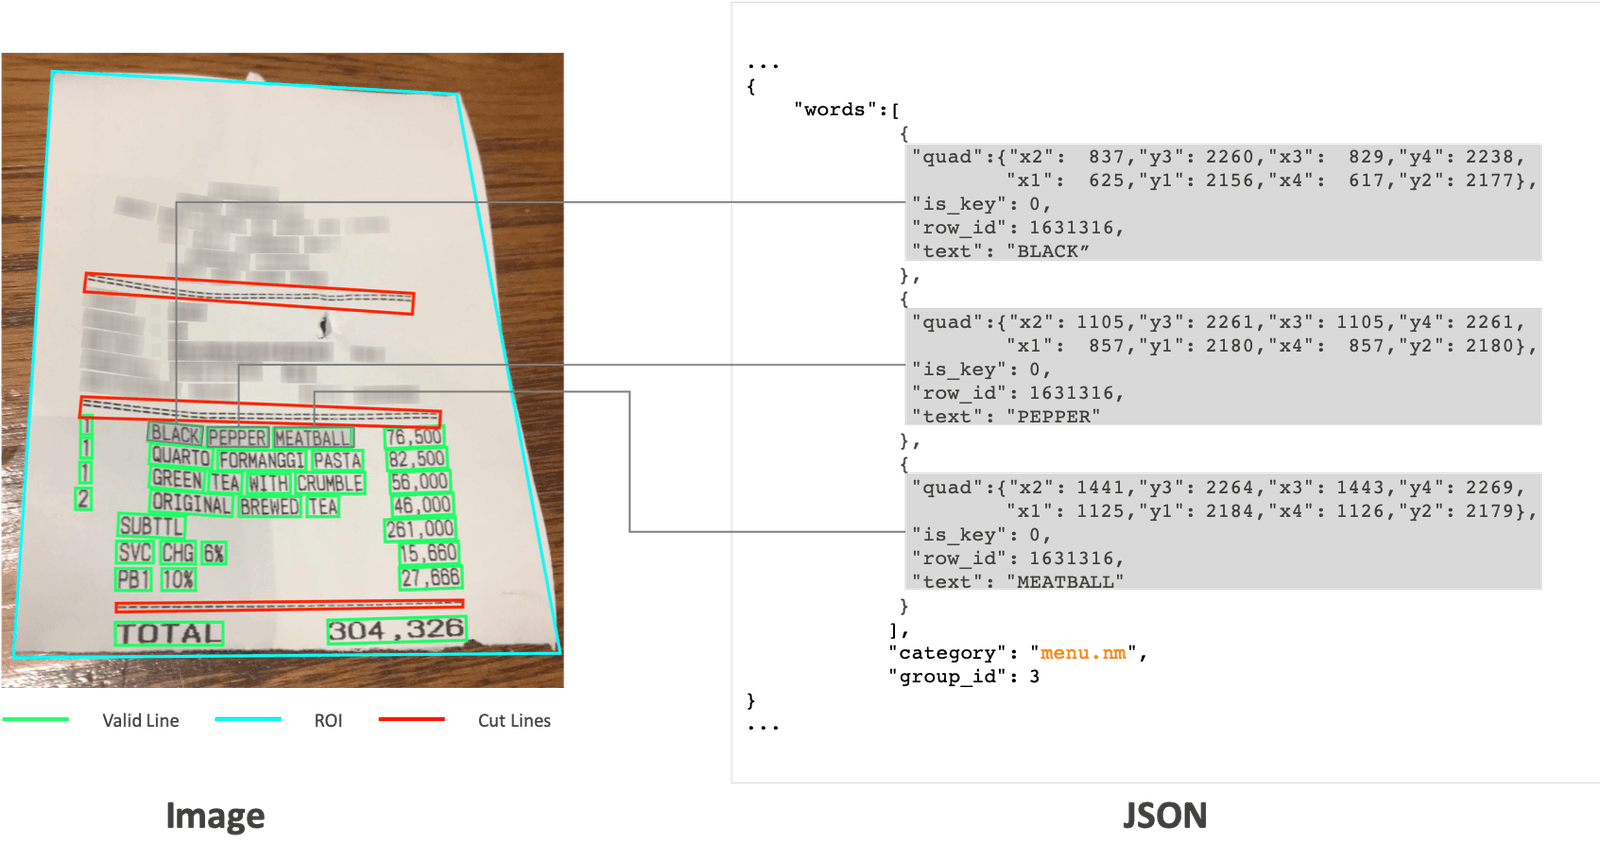
GOT-OCR2.0:一个能够阅读文本、公式、乐谱和图表的 580M 参数模型
GOT 是一个拥有 5.8 亿参数的端到端模型,可通过一个提示驱动系统读取文本、数学公式、表格、乐谱和化学图表,无需任何流水线。
阅读约 8 分钟arXiv:2111.15664
Donut 完全跳过了 OCR,但依然能读取你的收据
Donut 在无需先运行 OCR 的情况下即可读取文档。本文探讨了完全跳过文本识别如何在速度和准确率上超越 OCR 流水线。
阅读约 9 分钟arXiv:2308.13418
为什么在 Nougat 出现之前,最好的 PDF 转数学公式工具的准确率不足 10%
Meta 的 Nougat 能直接读取扫描论文并写出 LaTeX 数学公式,完全跳过了 OCR 和边界框步骤。以下是其工作原理以及目前仍存在的问题。
阅读约 8 分钟arXiv:2412.02210
CC-OCR 对九大顶级 AI 模型进行 7,058 份真实文档测试,多数模型基础能力不及格
CC-OCR 对九大领先多模态 AI 模型在杂乱真实文档上的表现进行了测试。即便是 GPT-4o 和 Gemini 也在旋转文本、外文字符及重复循环问题上表现不佳。