El truco de un solo paso que podría hacer que los modelos de difusión sean realmente útiles para OCR
Basado en: Noise-Free One-Step LoRA for Task-Driven Image Restoration with Diffusion Priors — Jaeha Kim, Kyoung Mu Lee
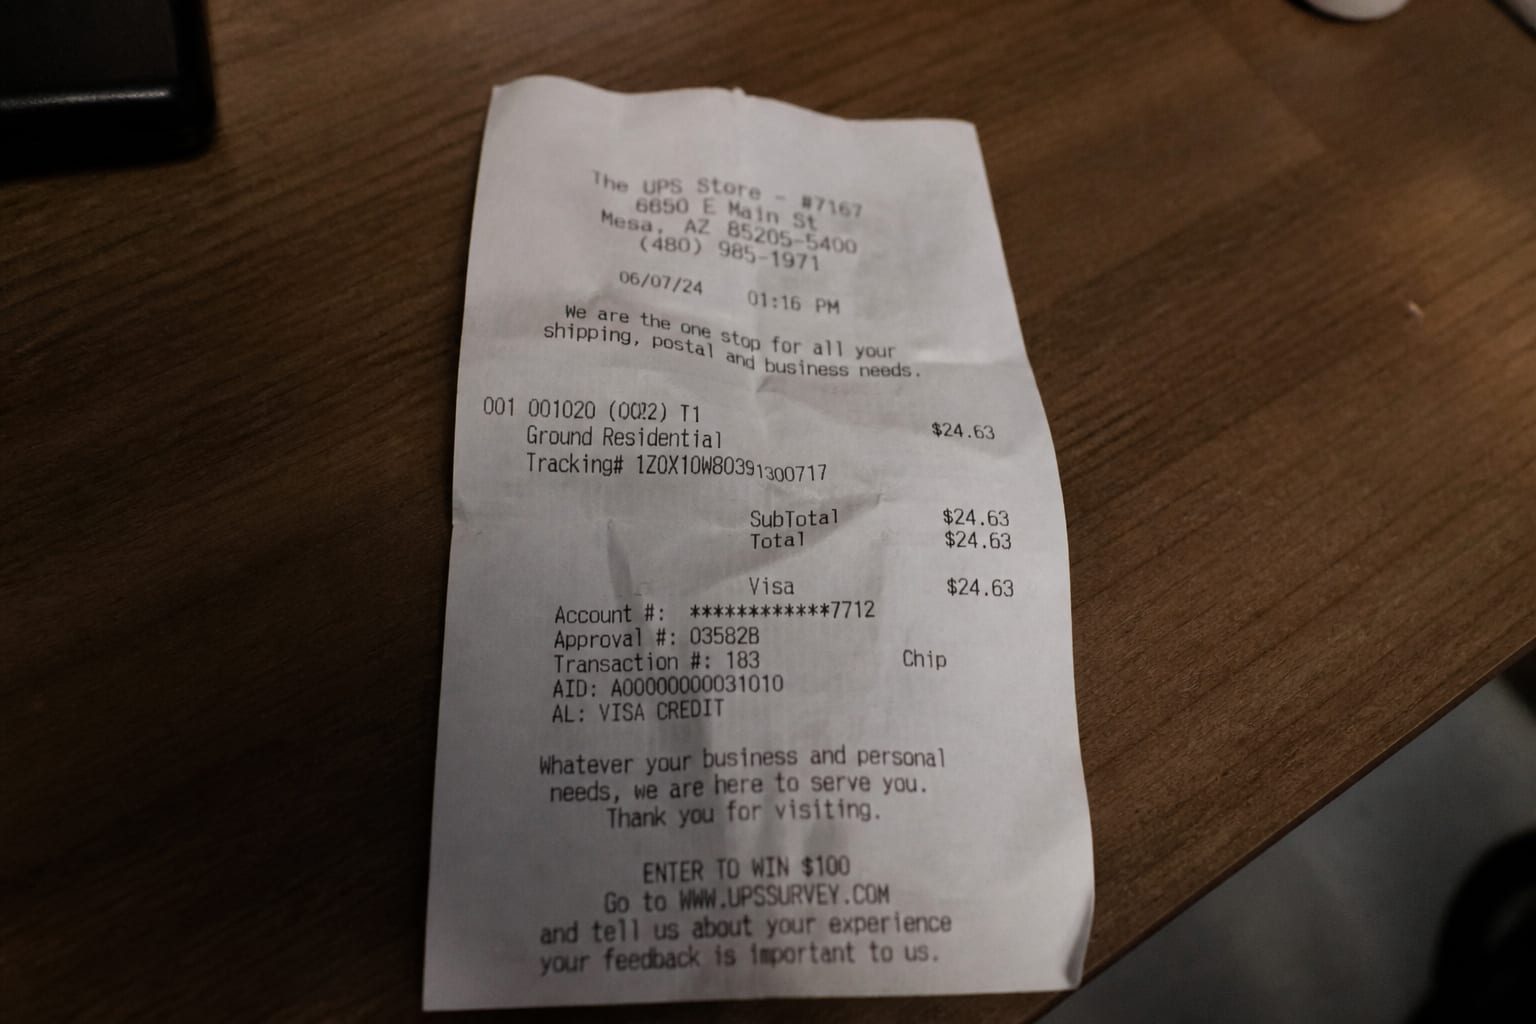
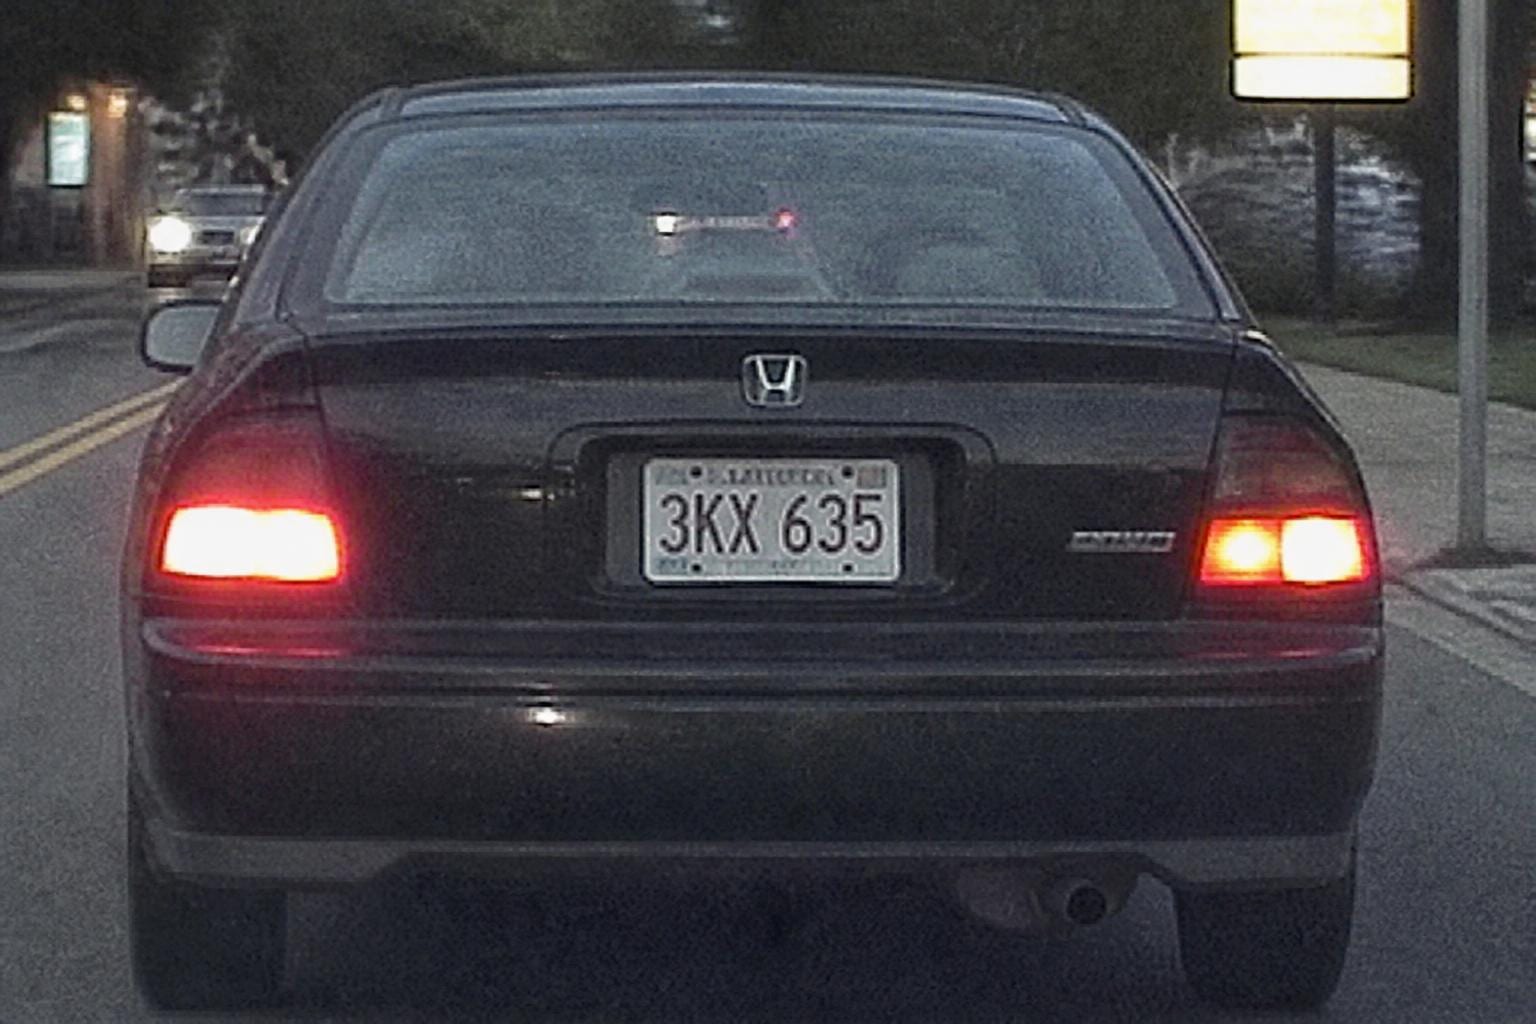
Imagina una cámara en un almacén leyendo etiquetas de envío dañadas, una aplicación móvil escaneando un recibo arrugado con poca luz o un sistema de seguridad intentando leer una matrícula a través de la lluvia. En todos estos casos, la imagen que llega a tu modelo de OCR no es el documento nítido y bien iluminado de un video de demostración. Es ruidosa, borrosa o comprimida hasta la inutilidad por la cadena de procesos que la movió desde la cámara hasta el servidor. Y aquí está la parte que debería preocupar a cualquiera que construya sobre OCR: la solución a la que la gente recurre, pasar la imagen por un modelo de difusión para limpiarla primero, ha estado trabajando silenciosamente en su contra.
Ese es el contexto de un nuevo artículo de Jaeha Kim y Kyoung Mu Lee de la Universidad Nacional de Seúl, "Noise-Free One-Step LoRA for Task-Driven Image Restoration with Diffusion Priors". El hallazgo es casi vergonzoso por lo simple que suena una vez que lo escuchas: la aleatoriedad inherente a los modelos de difusión, la misma característica que los hace buenos para generar imágenes atractivas, es un lastre cuando tu objetivo real es que una tarea posterior como clasificación, detección u OCR funcione correctamente. Elimina la aleatoriedad y el modelo mejora en lo que realmente te importa. No un poco mejor. Suficiente como para superar enfoques que utilizan cinco o diez veces más potencia de cálculo.
Por qué "limpiarlo primero" no funciona como uno pensaría
La restauración y el reconocimiento parecen deber ir de la mano. Si una imagen se ve más limpia, lo que la lea después debería funcionar mejor, ¿verdad? La restauración de imágenes impulsada por tareas (TDIR, por sus siglas en inglés) es el área de investigación que toma esto en serio: en lugar de restaurar una imagen para que se vea bien para un humano, la restauras específicamente para ayudar a un modelo aguas abajo, ya sea un clasificador, un detector de objetos o un reconocedor de texto, a hacer su trabajo.
Los modelos de difusión se convirtieron en una herramienta popular aquí porque son extremadamente buenos alucinando detalles plausibles. Alimenta un modelo de difusión con una foto borrosa y puede adivinar convincentemente bordes, texturas y formas que se perdieron. El problema es la palabra "adivinar". Los modelos de difusión funcionan comenzando desde ruido aleatorio y eliminándolo gradualmente durante muchos pasos, y esa aleatoriedad es una característica cuando se desean resultados variados y creativos. Es un error cuando se necesita que el modelo tome la misma decisión cada vez que ve la misma entrada.
Aquí está la analogía que hace que todo encaje. Imagina pedirle a diez diferentes artistas de bocetos forenses que reconstruyan una foto borrosa de un rostro. Cada uno llena los vacíos con sus propias suposiciones, y obtienes diez rostros diferentes, todos plausibles, ninguno garantizado como correcto. Ahora imagina que necesitas que ese boceto coincida con una base de datos policial. La variación entre artistas no es solo ruido, perjudica activamente tu precisión de coincidencia, porque la reconstrucción "correcta" sigue cambiando bajo tus pies. Eso es lo que la restauración estocástica de difusión le hace a un clasificador o modelo de OCR aguas abajo: misma entrada borrosa, reconstrucciones ligeramente diferentes en cada ejecución, y la confianza del modelo de tarea fluctúa en consecuencia.
El argumento central del artículo es que si estás utilizando modelos de difusión como un prior (una fuente de conocimiento aprendido sobre cómo se ven las imágenes reales) para una tarea que necesita consistencia, deberías eliminar la aleatoriedad por completo.
Qué significa realmente un paso "sin ruido y de un solo paso"
La restauración por difusión estándar ejecuta el modelo durante decenas o incluso cientos de pasos de eliminación de ruido, cada uno acercando un punto de partida ruidoso hacia una imagen limpia, con un término de ruido aleatorio influyendo en cada paso del proceso. Este artículo hace algo mucho más directo: ejecuta un único paso de inferencia determinista a través de la red de difusión preentrenada, sin muestreo iterativo y sin ningún término de ruido aleatorio.
Piense en ello menos como un artista que realiza un boceto gradual con múltiples borradores y más como un solo trazo seguro. No está pidiendo al modelo que alucine una imagen limpia plausible mediante un lento proceso de ida y vuelta. Está pidiéndole que haga una predicción directa y repetible utilizando todo lo que aprendió durante el preentrenamiento. Si lo hace dos veces con la misma entrada, obtendrá el mismo resultado dos veces. Ese determinismo es exactamente lo que necesita un clasificador o un lector de texto aguas abajo.
El truco, y esta es la parte que los autores señalan como la verdadera contribución técnica, es que eliminar el ruido solo funciona si se adapta el modelo de difusión de la manera correcta. Probaron dos formas populares de orientar un modelo de difusión preentrenado hacia una tarea específica:
- LoRA (Adaptación de Bajo Rango): una técnica ligera que inserta pequeñas matrices entrenables en un modelo existente en lugar de volver a entrenar todo el sistema, lo que permite especializar de forma económica un gran modelo preentrenado para una nueva tarea.
- Condicionamiento estilo ControlNet: un enfoque de adaptación diferente que alimenta señales de guía adicionales al modelo para orientar su salida, utilizado comúnmente para controlar la generación de imágenes por difusión.
Con el ruido eliminado, la adaptación LoRA siguió ofreciendo mejoras consistentes. El condicionamiento estilo ControlNet no lo hizo. Los autores no explican completamente por qué en el resumen, pero la implicación práctica es clara: si desea la velocidad y la consistencia de la restauración por difusión de un solo paso, la forma en que ajuste finamente el modelo no es un detalle menor de implementación, es la diferencia entre que el método funcione o no.
El problema de calidad que nadie quiere admitir
Existe una tensión bien conocida en la restauración de imágenes entre dos objetivos que no se alinean naturalmente: hacer que una imagen se vea bien para un humano y hacerla útil para un modelo posterior. Si se insiste demasiado en la calidad visual, se pueden introducir texturas y detalles que un modelo de tareas no estaba entrenado para esperar, lo que perjudica la precisión incluso cuando la imagen parece más nítida en pantalla. Si se prioriza únicamente la precisión de la tarea, se pueden obtener resultados que se ven planos o artificiales, lo cual importa si un humano necesita revisar la misma imagen en algún momento.
Para abordar esto, el artículo introduce lo que denomina una "estrategia de entrenamiento GAN que preserva la tarea". Las GAN, o redes generativas adversarias, son un tipo diferente de modelo generativo donde dos redes compiten: una intenta producir imágenes realistas, mientras que la otra intenta distinguir las imágenes reales de las generadas, y esta competencia mejora la calidad de la salida con el tiempo. Los autores añaden un objetivo de entrenamiento estilo GAN a su pipeline de restauración, pero lo restringen para que la búsqueda de pulido visual no se haga a costa de la precisión de la tarea posterior. En la práctica, esto significa que el modelo obtiene un impulso en la calidad perceptual sin retroceder en las puntuaciones de clasificación, segmentación o detección, lo cual es el tipo de resultado fácil de enunciar pero genuinamente difícil de lograr.
Los resultados: rápido y preciso vence a lento y preciso
El artículo evalúa el método en tres tareas estándar de visión por computadora: clasificación, segmentación y detección de objetos, y reporta ganancias consistentes sobre los métodos TDIR anteriores en las tres. Lo que destaca más que las cifras en sí es la afirmación de eficiencia: su enfoque de un solo paso supera a los métodos de referencia TDIR basados en difusión de múltiples pasos, lo que significa que una única pasada determinista directa superó a métodos que gastan decenas de pasos de desruido por imagen.
Este es un resultado práctico significativo, independiente de las cifras de precisión. La restauración con difusión de múltiples pasos es lenta. Si una sola pasada te ofrece un mejor rendimiento en la tarea que veinte o cincuenta pasos iterativos, has reducido tanto la latencia como el costo computacional de una tubería de restauración, haciéndola más precisa, no menos. Para cualquiera que haya intentado implementar restauración basada en difusión en una tubería en tiempo real o de alto volumen, esta combinación es rara.
Los autores también validan el método en imágenes degradadas del mundo real y específicamente en OCR, en lugar de limitarse a los benchmarks estándar de clasificación y detección en los que se apoyan la mayoría de los artículos de restauración. Este es el detalle que vale la pena considerar si estás leyendo esto en el blog de una empresa de OCR: el OCR no fue un añadido posterior en la evaluación de este artículo. Se posiciona como una prueba de aplicación real junto a la clasificación y la detección, y la premisa del método, de que un paso de restauración rápido y determinista protege la precisión de las tareas posteriores, se ajusta directamente a la realidad cotidiana del OCR: una foto de un documento tomada con el móvil, un escaneo con artefactos de compresión, un fotograma de una cámara de seguridad con una matrícula medio oculta por un reflejo.
Por qué importa para quien construye o elige una pipeline de OCR
Si estás evaluando motores de OCR, o construyendo una pipeline que pre-procesa imágenes antes de enviarlas a uno, la conclusión práctica aquí no es "siempre añade un paso de restauración con difusión". Es más específico que eso, y más útil:
- El pre-procesamiento que se comporta de forma diferente ante la misma entrada es una carga, no solo una molestia. Si tu paso de restauración introduce varianza entre ejecuciones, la precisión de tu OCR también variará, incluso con entradas idénticas, y esa varianza es difícil de depurar porque parece inestabilidad en el motor de OCR cuando la causa real está aguas arriba.
- La adaptación determinista y ligera supera a las pipelines pesadas y estocásticas. El ángulo de la eficiencia importa tanto como el de la precisión. Un método de un solo paso que supera a un método de cincuenta pasos tanto en velocidad como en precisión aguas abajo es el tipo de resultado que debería cambiar lo que se despliega en producción, no solo lo que se publica.
- La restauración ajustada únicamente para calidad visual puede dañar silenciosamente la precisión del OCR. Esta es la parte que es fácil pasar por alto si juzgas un paso de pre-procesamiento por si la salida "se ve más limpia". Una imagen que parece más nítida no es automáticamente más legible para un modelo, y la estrategia de entrenamiento que preserva la tarea del paper existe específicamente porque esa brecha es real.
- Si estás construyendo tu propia capa de pre-procesamiento sobre un modelo de difusión pre-entrenado, la elección del método de adaptación no es un detalle menor. La división entre LoRA y ControlNet en este paper es una advertencia concreta: dos técnicas de adaptación que parecen intercambiables en el paper produjeron resultados muy diferentes aguas abajo una vez que los investigadores eliminaron el ruido de muestreo.
Los límites honestos
Hay algunos aspectos que vale la pena señalar antes de considerar este problema como resuelto. En primer lugar, el resumen no especifica deltas de precisión exactos ni indica qué conjuntos de datos y benchmarks de OCR específicos se utilizaron, por lo que la afirmación de "ganancias consistentes" requiere revisar el artículo completo (o, mejor aún, realizar benchmarks independientes) antes de que nadie lo tome como verdad absoluta para sus tipos de documentos específicos. Los artículos que validan el OCR como una tarea secundaria suelen utilizar benchmarks de OCR más estrechos o más limpios que los documentos desordenados y variados que un sistema de producción realmente enfrenta: recibos, formularios manuscritos, escaneos de baja calidad y texto en idiomas extranjeros.
En segundo lugar, esta es investigación sobre restauración, no un motor de OCR. Es una técnica de preprocesamiento que, en principio, podría colocarse delante de cualquier modelo de OCR, pero integrarla en una tubería real implica volver a entrenar o ajustar finamente contra su propio modelo de OCR aguas abajo y su propia distribución de imágenes. Las ganancias reportadas para clasificación, segmentación y detección en el artículo no se transferirán automáticamente de uno a uno a cada configuración de reconocimiento de texto.
En tercer lugar, el artículo es explícito al indicar que la adaptación estilo ControlNet no funcionó con el enfoque libre de ruido. Este es un resultado negativo útil, pero también significa que el método no es una receta universal. Es una receta específica: prior de difusión preentrenada, un paso determinista hacia adelante, adaptación LoRA y ajuste fino de GAN que preserva la tarea. Cambiar cualquier componente sugiere, según los propios experimentos del artículo, que quizás no se obtengan las mismas ganancias.
Aún así, la idea central es uno de esos hallazgos que parecen obvios a posteriori y que no se estaban aplicando: si su paso de restauración alimenta una tarea que necesita respuestas consistentes, no le entregue un generador de números aleatorios. Hágalo determinista, hágalo rápido y solo entonces preocúpese por hacerlo estéticamente agradable. Para un campo que ha estado tratando "ejecutar más pasos de difusión" como la forma predeterminada de mejorar la calidad, esta es una corrección genuinamente útil.