O truque de um passo que pode tornar os modelos de difusão realmente úteis para OCR
Baseado em: Noise-Free One-Step LoRA for Task-Driven Image Restoration with Diffusion Priors — Jaeha Kim, Kyoung Mu Lee
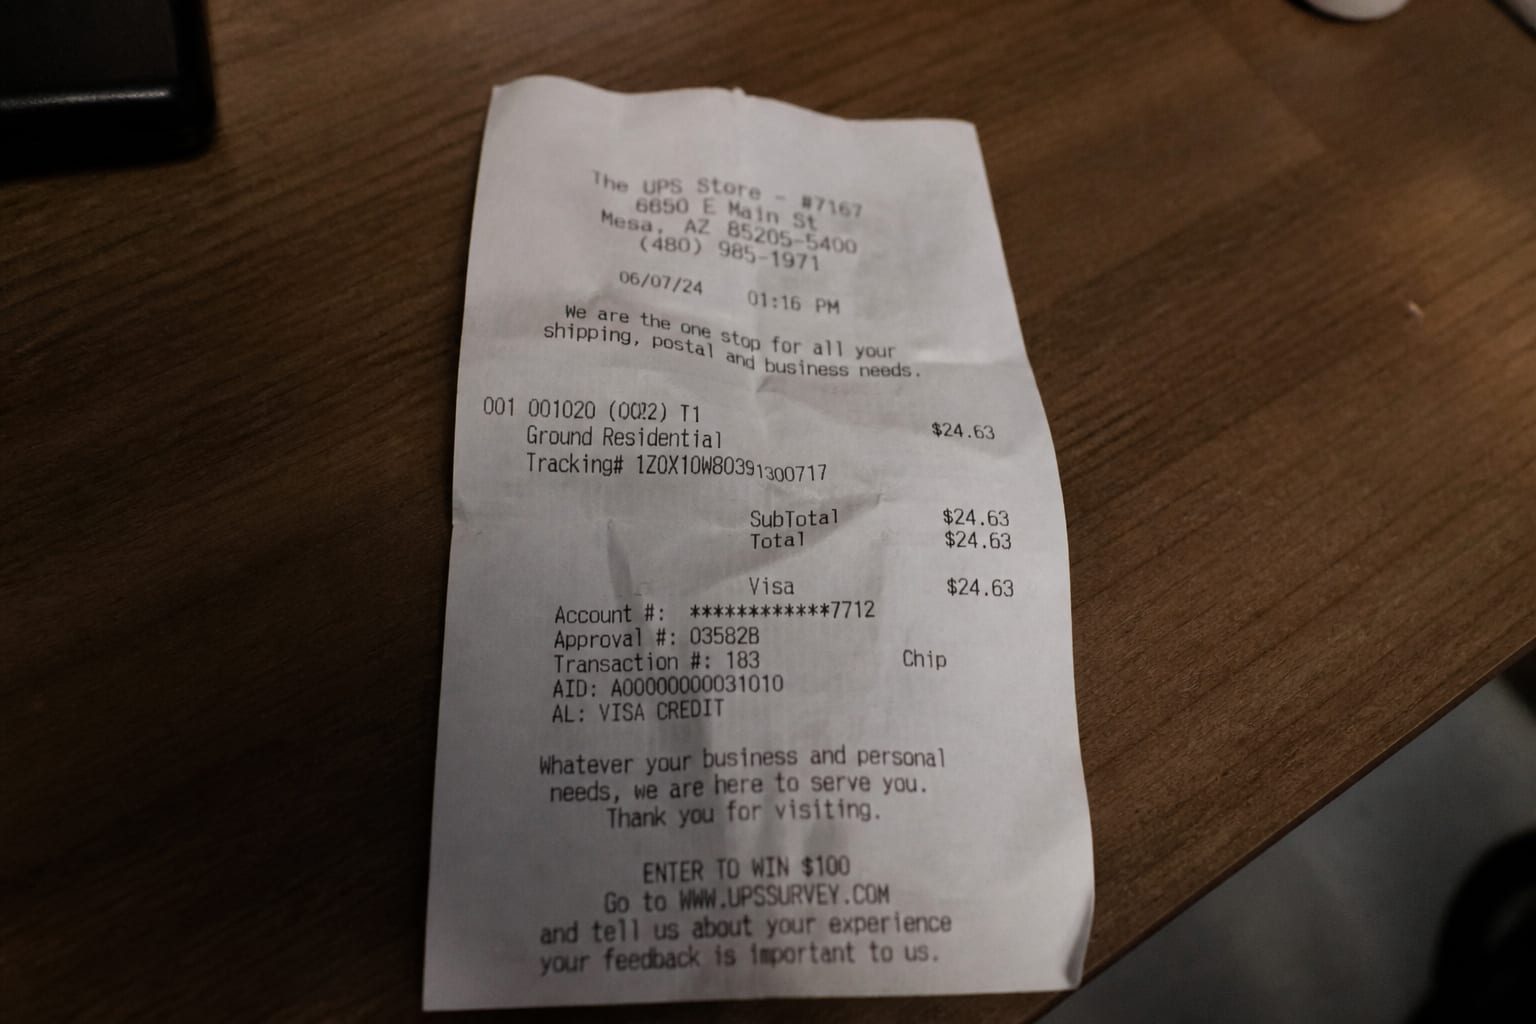
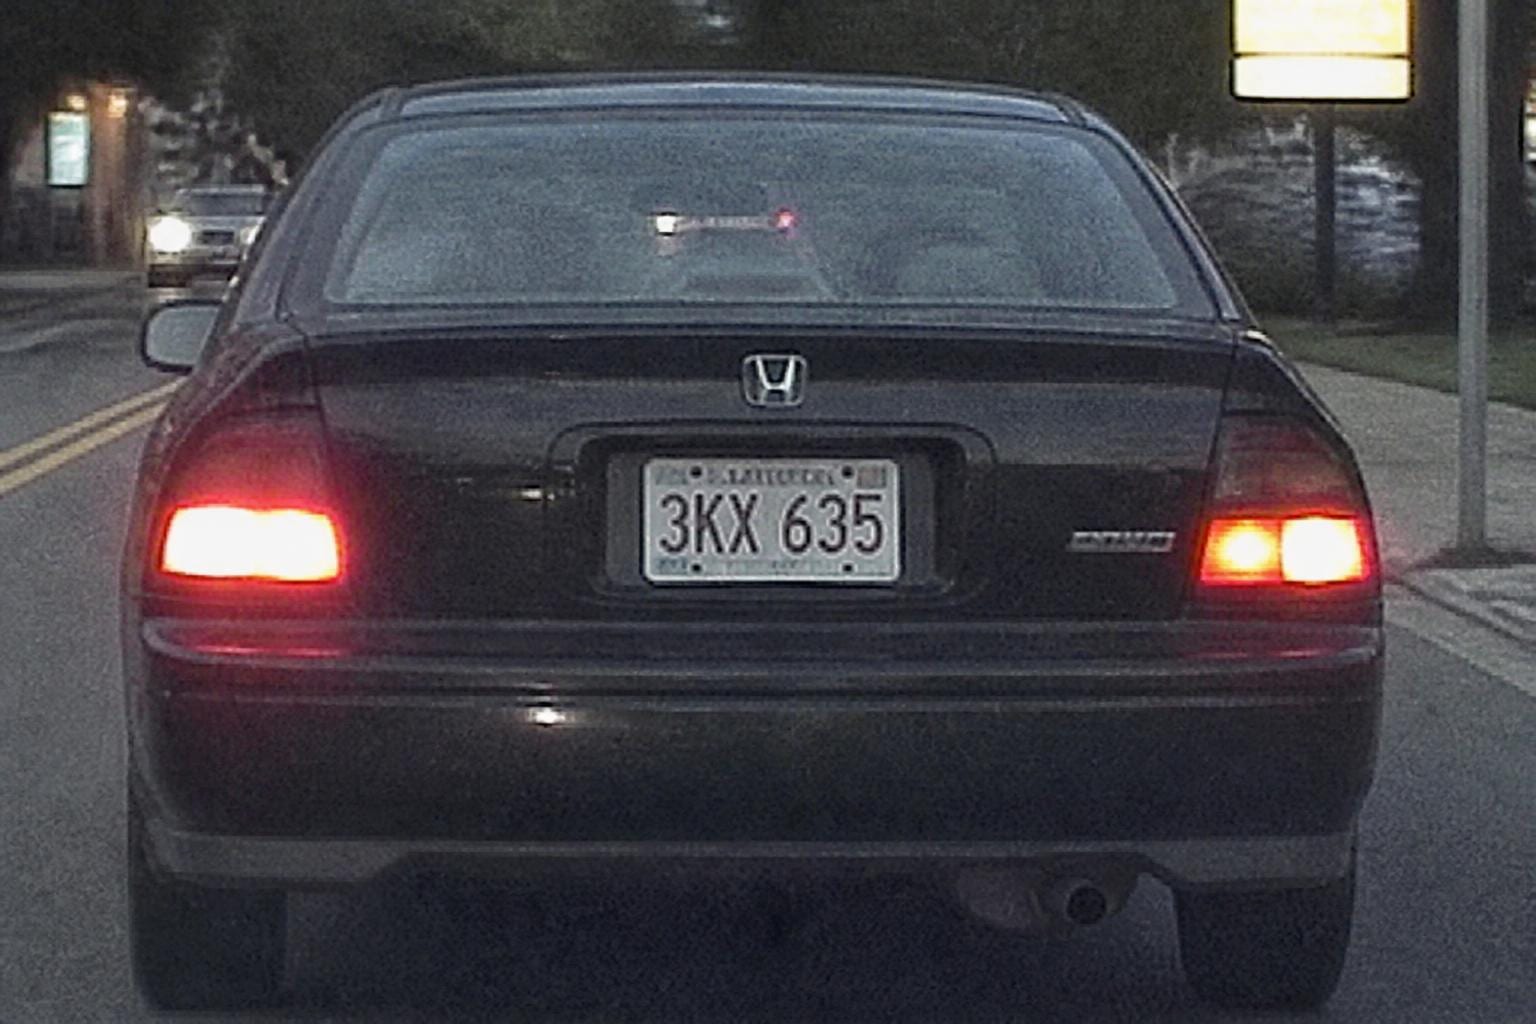
Imagine uma câmera de armazém lendo etiquetas de envio danificadas, um aplicativo de celular escaneando um recibo amassado em péssima iluminação ou um sistema de segurança tentando ler uma placa de carro através da chuva. Em todos esses casos, a imagem que chega ao seu modelo de OCR não é o documento limpo e bem iluminado dos vídeos de demonstração. Ela está ruidosa, borrada ou comprimida até ficar irreconhecível pelo pipeline que a transportou da câmera ao servidor. E aqui está o ponto que deveria incomodar qualquer pessoa construindo soluções baseadas em OCR: a correção mais comum, passar a imagem por um modelo de difusão para limpá-la primeiro, tem trabalhado silenciosamente contra você.
Esse é o cenário por trás de um novo artigo de Jaeha Kim e Kyoung Mu Lee da Universidade Nacional de Seul, "Noise-Free One-Step LoRA for Task-Driven Image Restoration with Diffusion Priors". A descoberta é quase constrangedora pela sua simplicidade: a aleatoriedade inerente aos modelos de difusão, exatamente o que os torna bons para gerar imagens bonitas, é uma desvantagem quando o objetivo real é fazer com que uma tarefa subsequente, como classificação, detecção ou OCR, funcione corretamente. Remova a aleatoriedade e o modelo melhora significativamente na tarefa que realmente importa. Não um pouco melhor, mas o suficiente para superar abordagens que usam cinco ou dez vezes mais poder computacional.
Por que "limpar primeiro" não funciona como você pensaria
Restauração e reconhecimento parecem coisas que deveriam andar de mãos dadas. Se uma imagem parece mais limpa, qualquer sistema que a leia depois deve funcionar melhor, certo? A Restauração de Imagem Orientada a Tarefas (TDIR, na sigla em inglês) é a área de pesquisa que leva isso a sério: em vez de restaurar uma imagem para que ela fique bonita para um humano, você a restaura especificamente para ajudar um modelo subsequente, seja ele um classificador, um detector de objetos ou um reconhecedor de texto, a fazer seu trabalho.
Os modelos de difusão se tornaram uma ferramenta popular aqui porque são extremamente bons em alucinar detalhes plausíveis. Alimente um modelo de difusão com uma foto embaçada e ele pode adivinhar de forma convincente bordas, texturas e formas que se perderam. O problema está na palavra "adivinhar". Modelos de difusão funcionam começando a partir de ruído aleatório e removendo-o gradualmente ao longo de muitas etapas, e esse aleatoriedade é uma característica quando você deseja saídas variadas e criativas. É um bug quando você precisa que o modelo faça a mesma decisão toda vez que vê a mesma entrada.
Aqui está a analogia que faz tudo fazer sentido. Imagine pedir a dez diferentes artistas forenses que reconstituam uma foto embaçada de um rosto. Cada um preenche as lacunas com suas próprias suposições, e você obtém dez rostos diferentes, todos plausíveis, nenhum garantido como correto. Agora imagine que você precisa que esse desenho corresponda a um banco de dados policial. A variação entre os artistas não é apenas ruído, ela prejudica ativamente sua precisão de correspondência, porque a reconstituição "correta" continua mudando sob seus pés. É isso que a restauração estocástica por difusão faz a um classificador subsequente ou a um modelo de OCR: mesma entrada embaçada, reconstituições ligeiramente diferentes em cada execução, e a confiança do modelo de tarefa oscila junto com isso.
O argumento central do artigo é que, se você está usando modelos de difusão como um prior (uma fonte de conhecimento aprendido sobre como as imagens reais parecem) para uma tarefa que precisa de consistência, você deve remover completamente a aleatoriedade.
O que significa realmente uma passagem "de um passo, sem ruído"
A restauração por difusão padrão executa o modelo por dezenas ou até algumas centenas de etapas de desruído, cada uma aproximando um ponto inicial ruidoso de uma imagem limpa, com um termo de ruído aleatório influenciando cada etapa ao longo do caminho. Este artigo faz algo muito mais direto: executa uma única passagem feed-forward determinística através da rede de difusão pré-treinada, sem amostragem iterativa e sem nenhum termo de ruído aleatório.
Pense nisso menos como um artista que faz esboços graduais em múltiplos rascunhos e mais como um único traço confiante. Você não está pedindo ao modelo para alucinar uma imagem limpa plausível através de um processo lento de ida e volta. Você está pedindo que ele faça uma previsão direta e repetível, utilizando tudo o que aprendeu durante o pré-treinamento. Faça isso duas vezes na mesma entrada e você obterá a mesma saída duas vezes. Esse determinismo é exatamente o que um classificador ou leitor de texto a jusante deseja.
O detalhe, e esta é a parte que os autores destacam como a verdadeira contribuição técnica, é que a abordagem sem ruído só funciona se você adaptar o modelo de difusão da maneira correta. Eles testaram duas maneiras populares de direcionar um modelo de difusão pré-treinado para uma tarefa específica:
- LoRA (Low-Rank Adaptation): uma técnica leve que insere pequenas matrizes treináveis em um modelo existente, em vez de retreinar tudo, permitindo especializar de forma econômica um grande modelo pré-treinado para uma nova função.
- Condição no estilo ControlNet: uma abordagem de adaptação diferente que alimenta sinais de orientação extras no modelo para direcionar sua saída, comumente usada para controlar a geração de imagens por difusão.
Com o ruído removido, a adaptação LoRA continuou entregando ganhos consistentes. A condição no estilo ControlNet não funcionou. Os autores não explicam completamente o motivo no resumo, mas a implicação prática é clara: se você deseja a velocidade e a consistência da restauração por difusão de um passo, a forma como você ajusta finamente o modelo não é um mero detalhe de implementação, é a diferença entre o método funcionar ou não.
O problema de qualidade que ninguém quer admitir
Existe uma tensão bem conhecida na restauração de imagens entre dois objetivos que não se alinham naturalmente: fazer com que uma imagem pareça boa para um humano e torná-la útil para um modelo subsequente. Se você se esforçar demais pela qualidade visual, pode introduzir texturas e detalhes que um modelo de tarefa não foi treinado para esperar, prejudicando a precisão, mesmo que a imagem pareça mais nítida na tela. Se você se concentrar apenas na precisão da tarefa, pode acabar com saídas que pareçam planas ou artificiais, o que importa se um humano precisar revisar a mesma imagem.
Para lidar com isso, o artigo introduz o que chama de "estratégia de treinamento GAN que preserva a tarefa". GANs, ou redes generativas adversariais, são um tipo diferente de modelo generativo onde duas redes competem: uma tenta produzir imagens realistas, a outra tenta distinguir imagens reais das geradas, e a competição impulsiona a qualidade da saída ao longo do tempo. Os autores adicionam um objetivo de treinamento estilo GAN ao seu pipeline de restauração, mas o restringem para que a busca por polimento visual não venha ao custo da precisão da tarefa subsequente. Na prática, isso significa que o modelo recebe um impulso de qualidade perceptiva sem regressão nas pontuações de classificação, segmentação ou detecção, o que é o tipo de resultado fácil de declarar e genuinamente difícil de alcançar.
Os resultados: rápido e preciso supera lento e preciso
O artigo testa três tarefas padrão de visão computacional, classificação, segmentação e detecção de objetos, e relata ganhos consistentes em relação aos métodos TDIR anteriores em todas as três. O que se destaca mais do que os números brutos é a afirmação de eficiência: sua abordagem de uma única etapa supera as linhas de base convencionais de difusão TDIR de múltiplas etapas, o que significa que uma única passagem direta determinística superou métodos que gastam dezenas de etapas de desruído por imagem.
Esse é um resultado prático significativo, independente dos números de precisão. A restauração por difusão de múltiplas etapas é lenta. Se uma única passagem oferece um desempenho de tarefa melhor do que vinte ou cinquenta etapas iterativas, você reduziu tanto a latência quanto o custo computacional de um pipeline de restauração, tornando-o mais preciso, não menos. Para quem já tentou colocar a restauração baseada em difusão em um pipeline em tempo real ou de alto volume, essa combinação é rara.
Os autores também validam em imagens degradadas do mundo real e especificamente em OCR, em vez de parar nos benchmarks padrão de classificação e detecção na maioria dos artigos de restauração se apoiam. Esse é o detalhe que vale a pena considerar se você está lendo isso no blog de uma empresa de OCR: o OCR não foi uma reflexão tardia na avaliação deste artigo. Ele é posicionado como um teste de jusante genuíno ao lado da classificação e detecção, e a premissa do método, de que uma etapa de restauração rápida e determinística protege a precisão de jusante, mapeia diretamente para a realidade cotidiana do OCR: uma foto de celular de um documento, uma digitalização com artefatos de compressão, um quadro de câmera de segurança com uma placa parcialmente obscurecida por reflexo.
Por que isso importa para quem está construindo ou escolhendo um pipeline de OCR
Se você está avaliando motores de OCR ou construindo um pipeline que pré-processa imagens antes de enviá-las para um deles, a lição prática aqui não é "sempre adicionar uma etapa de restauração por difusão". É mais específico e mais útil:
- Pré-processamento que se comporta de forma diferente na mesma entrada é um passivo, não apenas um inconveniente. Se sua etapa de restauração introduzir variância entre execuções, a precisão do seu OCR também variará, mesmo em entradas idênticas, e essa variância é difícil de depurar porque parece ser instabilidade no motor de OCR, quando a causa real está a montante.
- Adaptação determinística e leve supera pipelines pesados e estocásticos. O ângulo da eficiência é tão importante quanto o da precisão. Um método de uma etapa que supera um método de cinquenta etapas tanto em velocidade quanto em precisão a jusante é o tipo de resultado que deveria mudar o que é implantado em produção, não apenas o que é publicado.
- Restauração ajustada apenas para qualidade visual pode silenciosamente prejudicar a precisão do OCR. Esta é a parte fácil de perder se você estiver julgando uma etapa de pré-processamento por se a saída "parece mais limpa". Uma imagem com aparência mais nítida não é automaticamente mais legível para um modelo, e a estratégia de treinamento que preserva a tarefa do artigo existe especificamente porque esse abismo é real.
- Se você está construindo sua própria camada de pré-processamento em um modelo de difusão pré-treinado, a escolha do método de adaptação não é um detalhe menor. A divisão entre LoRA e ControlNet neste artigo é um aviso concreto: duas técnicas de adaptação que parecem intercambiáveis no papel produziram resultados a jusante muito diferentes assim que os pesquisadores removeram o ruído de amostragem.
Os limites honestos
Algumas coisas valem a pena destacar antes de tratar isso como um problema resolvido. Primeiro, o resumo não especifica deltas de precisão exatos ou quais conjuntos de dados e benchmarks de OCR específicos foram usados, então a alegação de "ganhos consistentes" precisa de uma olhada no artigo completo (ou melhor, benchmarking independente) antes que alguém deva tratá-la como verdade absoluta para seus tipos específicos de documentos. Artigos que validam o OCR como uma tarefa secundária frequentemente usam benchmarks de OCR mais estreitos ou mais limpos do que os documentos variados e desordenados que um sistema de produção realmente vê: recibos, formulários manuscritos, digitalizações de baixa qualidade, texto em idiomas estrangeiros.
Segundo, esta é pesquisa de restauração, não um mecanismo de OCR. É uma técnica de pré-processamento que, em princípio, poderia ficar na frente de qualquer modelo de OCR, mas integrá-la em um pipeline real significa treinar novamente ou ajustar finamente contra seu próprio modelo de OCR downstream e sua própria distribuição de imagens. Os ganhos relatados para classificação, segmentação e detecção no artigo não se transferirão automaticamente um-para-um para cada configuração de reconhecimento de texto.
Terceiro, o artigo é explícito de que a adaptação estilo ControlNet não funcionou com a abordagem livre de ruído. Esse é um resultado negativo útil, mas também significa que o método não é uma receita universal. É uma receita específica: prior de difusão pré-treinada, uma passagem direta determinística de um passo, adaptação LoRA, ajuste fino de GAN preservando a tarefa. Troque qualquer uma dessas peças e os próprios experimentos do artigo sugerem que você pode não obter os mesmos ganhos.
Ainda assim, a ideia central é uma daquelas descobertas que parecem óbvias em retrospecto e não estavam sendo aplicadas: se sua etapa de restauração alimenta uma tarefa que precisa de respostas consistentes, não lhe entregue um gerador de números aleatórios. Torne-o determinístico, torne-o rápido e só então se preocupe em torná-lo bonito. Para um campo que tem tratado "executar mais etapas de difusão" como a maneira padrão de melhorar a qualidade, essa é uma correção genuinamente útil.