लूप में कंपाइलर: Tencent का DocEDR किस तरह OCR की जाँच और सुधार के लिए रेंडरिंग का उपयोग करता है
आधारित शोध-पत्र: OCR-EDR: Rendering-Aware Diagnosis and Repair for Closed-Loop OCR Improvement — Linnan Zhao, Kang Liu, Hao Yu, Jiabo Zhan, Chong Sun, Chen Li
एक OCR मॉडल समीकरणों की एक मुद्रित प्रणाली (printed system of equations) को प्रोसेस करता है। शोध-पत्र के एक सचित्र उदाहरण में, जिस पद (term) में $\nabla^2$ होना चाहिए था, वह मॉडल के LaTeX आउटपुट में सबस्क्रिप्ट वाले ऑपरेटर के रूप में सामने आता है: \vec{\nabla}_{2}। यहाँ घातांक (exponent) सपाट होकर एक इंडेक्स में बदल गया है। यह स्ट्रिंग अभी भी गणितीय मार्कअप के रूप में पहचानी जा सकती है, लेकिन इसकी रेंडर की गई संरचना अब मूल स्रोत से मेल नहीं खाती।
अब एक अन्य व्यंजक (expression) पर विचार करें: $T \ge 0$। मॉडल इसे T \geq 0 के रूप में ट्रांसक्राइब करता है, जबकि संदर्भ (reference) में T \ge 0 का उपयोग किया गया है। शाब्दिक स्ट्रिंग तुलना (literal string comparison) यहाँ अंतर पकड़ लेती है। फिर भी, दोनों व्यंजक बिल्कुल एक जैसे रेंडर होते हैं। इस अंतर को पहचान की त्रुटि (recognition error) मान लेना वास्तव में ऐसी गलती के लिए दंडित करना है जो मौजूद ही नहीं है।
यह दोहरी समस्या डॉक्यूमेंट पार्सिंग की एक बुनियादी चुनौती को दर्शाती है। एक तरफ, OCR प्रेडिक्शन्स सामग्री को छोड़ सकते हैं, प्रतीकों को गलत पहचान सकते हैं, या गैर-समर्थित संरचना जोड़ सकते हैं। दूसरी तरफ, स्ट्रिंग-आधारित मूल्यांकन (string-based evaluation) वैध आउटपुट्स को केवल इसलिए गलत ठहरा सकता है क्योंकि मार्कअप में किसी उपनाम (alias) या समतुल्य निरूपण (equivalent representation) का उपयोग किया गया है।
Tencent में WeChat Vision की एक रिसर्च टीम ने इन दोनों समस्याओं के समाधान का एक तरीका प्रस्तावित किया है। उनका 3 सितंबर, 2026 का शोध-पत्र, OCR-EDR: Rendering-Aware Diagnosis and Repair for Closed-Loop OCR Improvement, एक डायग्नोसिस-एंड-रिपेयर फ्रेमवर्क को परिभाषित करता है और Qwen3.5-9B पर निर्मित मॉडल DocEDR को प्रस्तुत करता है। एक सोर्स क्रॉप (मूल दस्तावेज़ की छवि), एडिट करने योग्य OCR प्रेडिक्शन और उसकी रेंडरिंग दिए जाने पर, DocEDR उनकी निरंतरता (consistency) का आकलन करता है, आवश्यकता पड़ने पर सुधार लागू करता है, और परिणाम की समीक्षा के लिए एक नई रेंडरिंग का अनुरोध कर सकता है।
रिपोर्ट किए गए निष्कर्ष उल्लेखनीय हैं। अपने नए तैयार किए गए बेंचमार्क, OCRErrBench पर, DocEDR ने 94.78% डायग्नोस्टिक सटीकता (diagnostic accuracy) हासिल की, जो Qwen3.5-397B-A17B(FP8) से बेहतर है। DOCRcaseBench पर ज़ीरो-शॉट फॉर्मूला डायग्नोसिस में, यह DOCR-Inspector-7B की तुलना में Case-F1 को 30.99 प्रतिशत अंक बढ़ाता है। इसके अतिरिक्त, यह OCRErrBench के 86.23% त्रुटिपूर्ण इनपुट्स को सुधारकर उनके संदर्भों के साथ विज़ुअल समानता की स्थिति में लाता है। इस शोध का मुख्य योगदान एक ऐसा लूप है जो त्रुटि का पता लगाने (error detection) को निष्पादन योग्य संपादन (executable edits) और रेंडरिंग-आधारित पुनर्मूल्यांकन (rendering-based reassessment) से जोड़ता है।
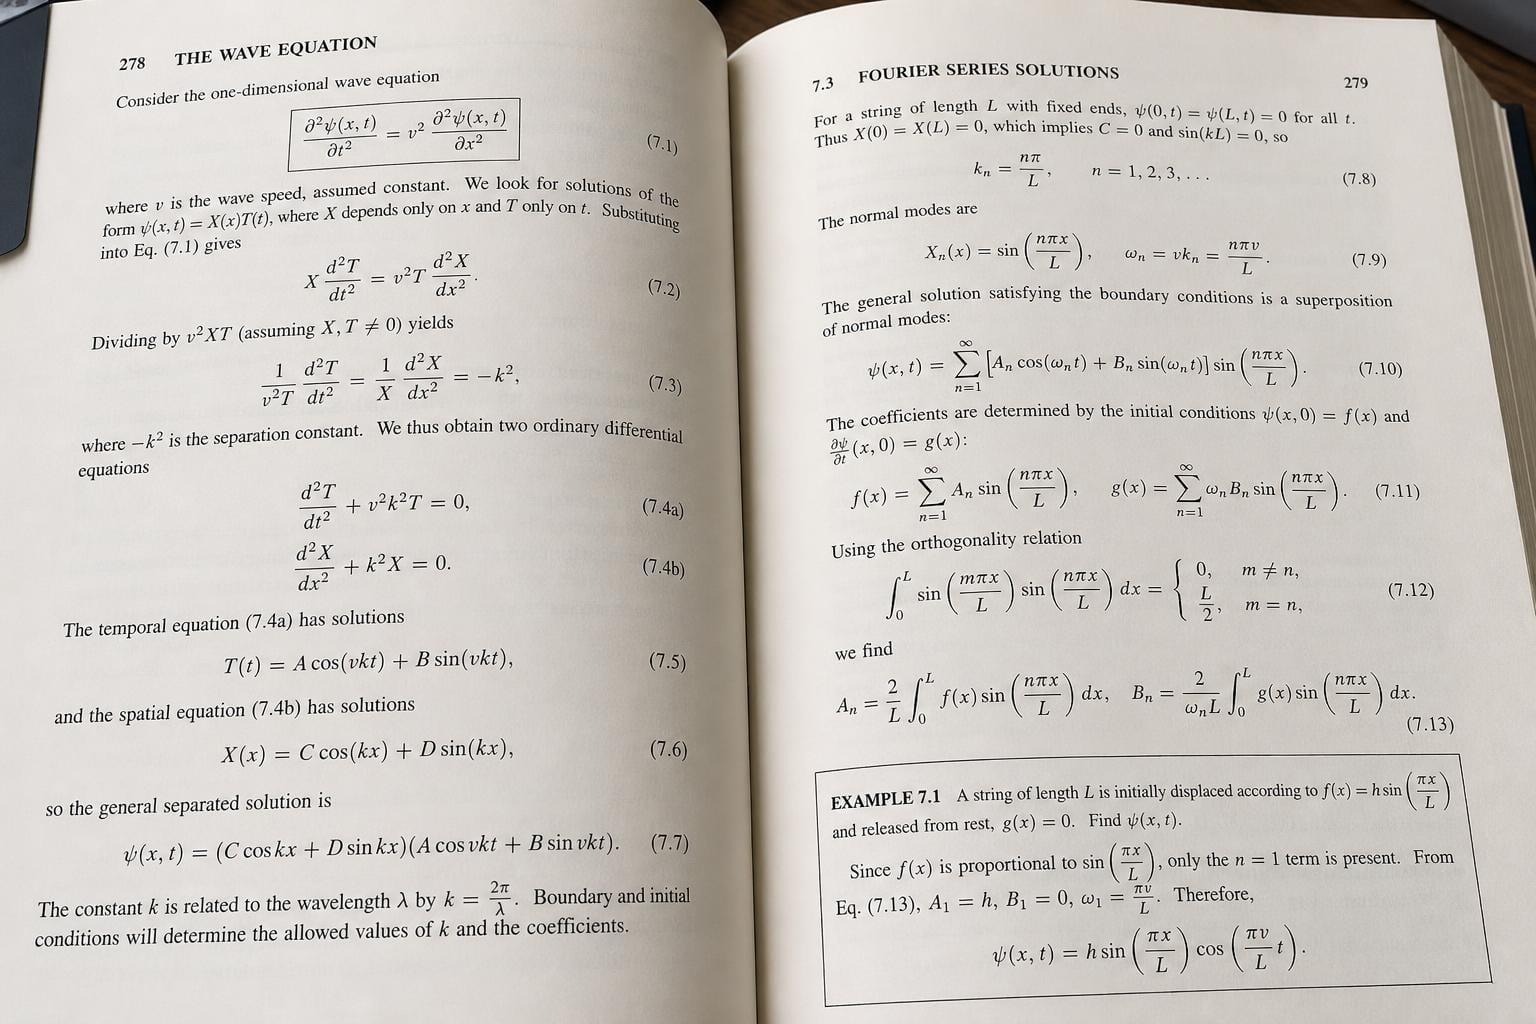
स्ट्रिंग ट्रैप: मानक OCR मूल्यांकन अच्छे कोड को क्यों दंडित करता है
यह समझने के लिए कि टीम ने DocEDR क्यों बनाया, इस बात पर विचार करें कि स्ट्रिंग-आधारित OCR मेट्रिक्स वास्तव में क्या मापते हैं। एडिट डिस्टेंस (Edit distance) किसी प्रेडिक्शन और संदर्भ (reference) के बीच के अंतरों की गणना करता है। यह अपने आप में यह निर्धारित नहीं करता कि दो अलग-अलग स्ट्रिंग्स समान दृश्य सामग्री (visible content) और संरचना को बनाए रखती हैं या नहीं।
गणितीय मार्कअप के लिए यह अंतर अत्यंत महत्वपूर्ण है। शोध-पत्र में इस तरह के उदाहरण दिए गए हैं:
\toबनाम\rightarrow{\bf x}बनाम\textbf{x}T \ge 0बनामT \geq 0
ये युग्म एक जैसी रेंडरिंग तैयार करने के लिए अलग-अलग सोर्स कोड का उपयोग करते हैं। शोध-पत्र में ग्रीक-प्रतीक निरूपण, डेलिमिटर के आकार और टाइपसेटिंग के सामान्य अंतरों से जुड़े वैध उदाहरण भी प्रस्तुत किए गए हैं। ऐसे अंतरों की संदर्भ के अनुसार जाँच की जानी चाहिए: उदाहरण के लिए, विभिन्न डेलिमिटर कमांड्स सार्वभौमिक रूप से एक-दूसरे के स्थान पर उपयोग नहीं किए जा सकते।
लेखक ऐसे वैध लेकिन गैर-समान निरूपणों को रेंडरिंग-समतुल्य सकारात्मक (rendering-equivalent positives) कहते हैं। Table 3 में रिपोर्ट किए गए बाउंड्री-डायग्नोसिस सबसेट में, 0.1 के सामान्यीकृत एडिट डिस्टेंस थ्रेशोल्ड ने 57.14% रेंडरिंग-समतुल्य टेक्स्ट प्रेडिक्शन्स को खारिज कर दिया। DOCR-Inspector-7B ने उस तालिका में मूल्यांकित किए गए 75.81% समतुल्य सकारात्मक मामलों को खारिज कर दिया। इसने अपने आधिकारिक सिंगल-इमेज प्रोटोकॉल को बनाए रखा; यह तुलना यह स्थापित नहीं करती कि यह केवल रॉ स्ट्रिंग्स की ही जाँच करता है।
इसके विपरीत समस्या भी सामने आती है। सोर्स-कोड में एक छोटा सा बदलाव एक महत्वपूर्ण दृश्य संबंध को बदल सकता है। \nabla^2 को \nabla_2 में बदलने के लिए केवल एक कैरेक्टर को बदलने की आवश्यकता होती है, लेकिन यह प्रतीक को सुपरस्क्रिप्ट से सबस्क्रिप्ट में स्थानांतरित कर देता है। इसलिए, एक कम समग्र एडिट डिस्टेंस (low aggregate edit distance) भी किसी वास्तविक संरचनात्मक त्रुटि के साथ मौजूद हो सकता है।
शोध-पत्र इस सीमा के दोनों पक्षों का परीक्षण करता है। इसका संदर्भ-आधारित फॉर्मूला मानदंड (0.9 से कम CDM) चयनित सबसेट में केवल 2.94% समतुल्य सूत्रों को खारिज करता है, लेकिन अपने लागू दायरे में मूल्यांकित सभी स्थानीय त्रुटियों (local errors) को पकड़ने में चूक जाता है। इसी तरह टेक्स्ट एडिट-डिस्टेंस मानदंड भी अपने दायरे की स्थानीय त्रुटियों को छोड़ देता है। ये परिणाम चयनित मामलों और थ्रेशोल्ड्स के लिए हैं, न कि इस बात का प्रमाण कि कोई भी मीट्रिक सार्वभौमिक रूप से अप्रभावी है।
केवल-टेक्स्ट पोस्ट-करेक्शन (Text-only post-correction) की भी इसी प्रकार की सीमा होती है। यह OCR अनुक्रम को बेहतर बनाने के लिए भाषाई पैटर्न का उपयोग कर सकता है, लेकिन यह सीधे तौर पर यह निरीक्षण नहीं कर सकता कि संशोधित आउटपुट मूल छवि की दृश्य सामग्री को पुनर्स्थापित करता है या नहीं। OCR-EDR सुधार प्रक्रिया में उस दृश्य साक्ष्य (visual evidence) को जोड़ता है।
मुख्य आर्किटेक्चर: डॉक्यूमेंट सुधार को स्टेट मशीन में बदलना
DocEDR ने OCR सुधार को एक एजेंटिक स्टेट मशीन (agentic state machine) के रूप में पुनर्गठित किया है। प्रारंभिक प्रेडिक्शन को एक स्थिर आउटपुट मानने के बजाय, मॉडल एक संपादन योग्य उम्मीदवार (editable candidate) बनाए रखता है और संयुक्त रूप से तीन इनपुट्स का मूल्यांकन करता है:
- सोर्स इमेज ($I$): मूल दस्तावेज़ का विज़ुअल क्रॉप, जो बाहरी साक्ष्य प्रदान करता है।
- वर्तमान OCR प्रेडिक्शन ($p$): संपादन योग्य सिंबॉलिक स्ट्रिंग, जैसे फॉर्मूला मार्कअप या टेक्स्ट।
- रेंडर की गई इमेज ($R(p)$): वर्तमान प्रेडिक्शन को रेंडर करने का विज़ुअल परिणाम।
मॉडल सिंबॉलिक और विज़ुअल दोनों तरह की जानकारी का उपयोग करता है। OCR अनुक्रम सटीक स्थानीयकरण (precise localization) और संपादन का समर्थन करता है, जबकि इसकी रेंडरिंग उस अनुक्रम के दृश्य परिणामों को सामने लाती है। यदि कोई वैकल्पिक कमांड स्रोत की सामग्री और संरचना को बनाए रखती है, तो अपेक्षित व्यवहार प्रेडिक्शन को स्वीकार करना और प्रक्रिया को रोकना है।
जब प्रेडिक्शन स्रोत के साथ असंगत होता है, तो मॉडल इसका डायग्नोसिस और रिपेयर कर सकता है। लेखकों ने पाँच परस्पर अनन्य (mutually exclusive) प्राथमिक त्रुटि श्रेणियों को परिभाषित किया है:
- अमान्य आउटपुट (Invalid Output - ग्लोबल): आवश्यक निरूपण में खाली, विकृत, अपार्सनीय (unparsable) या अरेंडरनीय (unrenderable) आउटपुट।
- ग्लोबल बेमेल (Global Mismatch - ग्लोबल): समग्र रूप से स्रोत के साथ असंगत प्रेडिक्शन्स, जैसे कि किसी गलत क्षेत्र से ली गई सामग्री।
- पूर्णता (Completeness - लोकल): छूटे हुए शब्द, छोड़े गए पद (omitted terms), या अनावश्यक/अतिरिक्त सामग्री।
- सामग्री (Content - लोकल): गलत व्यक्तिगत वर्ण या प्रतीक, जैसे लैटिन $k$ को ग्रीक $\kappa$ समझ लेना।
- संरचना (Structure - लोकल): गलत पठन क्रम, समूहीकरण (grouping), पदानुक्रम (hierarchy), या स्थानिक और मार्कअप संबंध, जिनमें सपाट सुपरस्क्रिप्ट और टूटे हुए भिन्न (broken fractions) शामिल हैं।
प्रत्येक प्राथमिक त्रुटि को एक श्रेणी में रखा जाता है, हालाँकि एक प्रेडिक्शन में कई त्रुटियाँ हो सकती हैं। स्थानीयकृत संपादन अनुपयुक्त होने पर ग्लोबल विफलताओं के लिए global_rewrite ऑपरेशन का उपयोग किया जाता है। स्थानीय सुधारों के लिए insert, delete, या replace का उपयोग होता है।
महत्वपूर्ण बात यह है कि DocEDR प्रत्येक संपादन के बाद स्वचालित रूप से दोबारा रेंडर नहीं करता है। इसके पॉलिसी-स्तरीय एक्शन स्पेस (policy-level action space) में inspect, diagnose_scope, localize, patch, global_patch, request_render, और stop शामिल हैं। ये क्रियाएं पूरी प्रक्रिया को नियंत्रित करती हैं; ये OCR अनुक्रम पर लागू होने वाले टेक्स्टुअल ऑपरेशन्स से अलग हैं।
संपादन के बाद, पिछली रेंडरिंग को 'stale' (पुरानी) चिह्नित कर दिया जाता है। मॉडल बिना किसी अन्य विज़ुअल जाँच के रुक सकता है या अपडेट किए गए उम्मीदवार के निरीक्षण के लिए request_render कॉल कर सकता है। रेंडरिंग विफलता की अपनी एक स्पष्ट स्थिति (explicit state) होती है, जो पुरानी छवि से अलग होती है। इसलिए यह फ्रेमवर्क यह रिकॉर्ड करता है कि विज़ुअल फीडबैक वर्तमान है, पुराना है, या रेंडरिंग विफल होने के कारण अनुपलब्ध है।
DocEDR के अंदर: एक बड़े बेसलाइन को पछाड़ने के लिए 9B पैरामीटर मॉडल का प्रशिक्षण
DocEDR को Qwen3.5-9B से इनिशियलाइज़ किया गया है। लेखक इसे डायग्नोस्टिक सुपरवाइज्ड फाइन-ट्यूनिंग, तीन-चरणीय रिपेयर पाठ्यक्रम और रीइन्फोर्समेंट लर्निंग के माध्यम से प्रशिक्षित करते हैं। ये चरण वैधता मूल्यांकन को संपादन और रिपेयर लूप के नियंत्रण से उत्तरोत्तर जोड़ते हैं।
चरण 1: वेरिफायर सुपरवाइज्ड फाइन-ट्यूनिंग (Verifier Supervised Fine-Tuning)
मॉडल सबसे पहले विज़ुअल निरंतरता सत्यापन (visual consistency verification) सीखता है। सोर्स इमेज, OCR टेक्स्ट और रेंडर की गई इमेज दिए जाने पर, इसे वैधता और संरचित त्रुटि जानकारी की भविष्यवाणी करने के लिए एक युग (epoch) के लिए प्रशिक्षित किया जाता है। त्रुटिपूर्ण प्रेडिक्शन्स के लिए, उस जानकारी में त्रुटि वर्ग, स्थान और प्रस्तावित सुधार शामिल होते हैं।
इसके बाद डायग्नोस्टिक चेकपॉइंट दो रास्तों का अनुसरण करता है। एक कॉपी को रिवॉर्ड वेरिफायर (reward Verifier) के रूप में कार्य करने के लिए फ्रीज कर दिया जाता है। दूसरी कॉपी इंटरैक्टिव रिपेयर पॉलिसी के रूप में प्रशिक्षण जारी रखती है। यह एक स्थिर डायग्नोस्टिक संकेत बनाए रखता है जबकि रिपेयर मॉडल नए व्यवहार सीखता है।
चरण 2: करिकुलम रिपेयर SFT (Curriculum Repair SFT)
इसके बाद, एजेंट सुपरवाइज्ड फाइन-ट्यूनिंग के तीन क्रमिक चरणों से गुजरता है:
- स्टेज 1 (सिंगल-टर्न रिपेयर): मॉडल रिपेयर प्रक्रिया के दौरान बिना रेंडरिंग के सीधा सुधार करना सीखता है।
- स्टेज 2 (टूल चयन): मॉडल प्रत्येक सुधार को टूल कॉल की आवश्यकता के रूप में मानने के बजाय, अपडेटेड रेंडरिंग का अनुरोध करने और रुकने के बीच चयन करना सीखता है।
- स्टेज 3 (मल्टी-टर्न विज़ुअल रिकवरी): मॉडल संपादन के बाद वास्तविक रेंडरिंग फीडबैक प्राप्त करता है। यह बची हुई त्रुटियों (residual errors) को पहचानना, अप्रभावी संपादनों से उबरना और आवश्यकता पड़ने पर सुधार जारी रखना सीखता है।
स्टेज 1 एक युग (epoch) के लिए चलता है; स्टेज 2 और 3 दो-दो युगों के लिए चलते हैं। बेंचमार्क को सोर्स-डॉक्यूमेंट स्तर पर इन प्रशिक्षण चरणों से पूरी तरह अलग रखा गया है।
चरण 3: GRPO के माध्यम से रीइन्फोर्समेंट लर्निंग (Reinforcement Learning via GRPO)
अंतिम पॉलिसी को 400 अपडेट्स में ग्रुप रिलेटिव पॉलिसी ऑप्टिमाइज़ेशन (GRPO) का उपयोग करके अनुकूलित किया गया है। प्रत्येक प्रॉम्प्ट के लिए, प्रशिक्षण आठ ट्रैजेक्टरीज़ के एक समूह का नमूना लेता है और लेबल-कंडीशन्ड रिवॉर्ड (label-conditioned reward) का उपयोग करके उन्हें स्कोर करता है।
रिवॉर्ड वैध इनपुट्स को त्रुटिपूर्ण इनपुट्स से अलग करता है:
- वैध इनपुट्स के लिए ($y_0 = \text{good}$): मॉडल को सामान्यीकृत प्रारंभिक प्रेडिक्शन को संरक्षित रखने के लिए पुरस्कृत किया जाता है। अनावश्यक बदलाव, अतिरिक्त टर्न और रेंडरिंग कॉल्स के लिए पेनल्टी लगाई जाती है।
- त्रुटिपूर्ण इनपुट्स के लिए ($y_0 = \text{bad}$): टर्मिनल गुणवत्ता में सामान्यीकृत एडिट समानता, सटीक संदर्भ सहमति, फ्रीज किए गए वेरिफायर का विज़ुअल-कंसिस्टेंसी निर्णय, और आउटपुट-फॉर्मेट वैधता शामिल हैं। एक प्रोसेस टर्म रिकवरी को पुरस्कृत करता है और मूल्यांकित कैंडिडेट स्थितियों के बीच प्रतिगमन (regression) पर पेनल्टी लगाता है।
यह ऑप्टिमाइज़ेशन बार-बार संपादन, अत्यधिक रेंडरिंग और त्रुटिपूर्ण अंतिम परिणाम के साथ इंटरैक्शन बजट को समाप्त करने को भी हतोत्साहित करता है। समतुल्य सकारात्मक (Equivalent positives) संरक्षण शाखा में बने रहते हैं, इसलिए प्रशिक्षण में उन्हें किसी पसंदीदा विहित प्रतिलेखन (canonical transcription) में दोबारा लिखने की आवश्यकता नहीं होती है।
इस चरण ने एक मापने योग्य दक्षता लाभ (efficiency dividend) उत्पन्न किया। स्टेज 3 SFT से अंतिम GRPO तक, सभी मामलों में औसत ट्रैजेक्टरी लंबाई 2.594 टर्न से घटकर 2.313 टर्न हो गई, जो 10.8% की कमी है। त्रुटिपूर्ण मामलों पर औसत रेंडरिंग कॉल्स 2.104 से गिरकर 1.598 हो गईं, यानी 24.0% की गिरावट। इसके साथ ही रिपेयर और प्रिजर्वेशन स्कोर्स में भी सुधार हुआ।
समीक्षा के दायरे में ग्राउंड ट्रुथ: OCRErrBench का निर्माण
फ्रेमवर्क का मूल्यांकन करने के लिए, शोधकर्ताओं ने प्रिजर्वेशन, डायग्नोसिस, लोकलाइज़ेशन और रिपेयर के इर्द-गिर्द OCRErrBench का निर्माण किया। इसमें वैध वैकल्पिक निरूपणों का समावेश सीधे तौर पर उस सीमा का परीक्षण करता है जिसे सख्त स्रोत मिलान (strict source matching) अस्पष्ट कर सकता है।
इस बेंचमार्क में OmniDocBench और PureDocBench पर DeepSeek-OCR, PaddleOCR-VL-1.5 और Qwen3.5-27B से एकत्र किए गए 900 वास्तविक OCR प्रेडिक्शन्स शामिल हैं। इसे टेक्स्ट क्रॉप्स और गणितीय फॉर्मूला क्रॉप्स के बीच समान रूप से विभाजित किया गया है, जिसमें प्रत्येक के 450 मामले हैं।
इसमें 457 वैध इनपुट और 443 त्रुटिपूर्ण इनपुट हैं। वैध मामलों में से, सामान्यीकरण के बाद 141 संदर्भ से मेल खाते हैं, जबकि 316 रेंडरिंग-समतुल्य सकारात्मक (rendering-equivalent positives) हैं। लेखकों ने डायग्नोस्टिक SFT, रिपेयर SFT और GRPO प्रशिक्षण से इन दोनों मूल बेंचमार्कों से उत्पन्न सामग्री को बाहर रखा है।
एनोटेशन (Annotation) स्वतंत्र मॉडल समीक्षा को विशेषज्ञ फॉलबैक (expert fallback) के साथ जोड़ता है। GPT-5.6 Sol, Claude Opus 4.8, और Gemini 3.1 Pro स्वतंत्र रूप से सोर्स क्रॉप, प्रेडिक्शन और रेंडरिंग फीडबैक का आकलन करते हैं। स्वचालित स्वीकृति के लिए एनोटेशन पर पूर्ण सहमति और रेंडरिंग-सत्यापित सुधार पर अभिसरण (convergence) आवश्यक है। यह एक सहमति की आवश्यकता है, त्रुटि-मुक्त लेबलों की गारंटी नहीं।
कठिन या असंगत मामले तीन स्वतंत्र डोमेन विशेषज्ञों के पास जाते हैं। सर्वसम्मत एनोटेशन सीधे स्वीकार कर लिए जाते हैं; शेष विवादों को केवल तभी बरकरार रखा जाता है जब सुलझाया गया सुधार निर्दिष्ट त्रुटि प्रकारों से सहमत हो और संदर्भ को पुनर्प्राप्त करता हो।
सभी रेंडरिंग-समतुल्य सकारात्मक मामलों का एक अतिरिक्त मैन्युअल ऑडिट किया जाता है। समतुल्यता जाँच (Equivalence checks) KaTeX 0.16.11, मार्कडाउन पार्सिंग, निश्चित डिस्प्ले सेटिंग्स और Fandol फोंट सहित एक निश्चित फ़ॉन्ट इन्वेंट्री के साथ एक फ्रोजन स्थानीय Playwright/Chromium वातावरण का उपयोग करती है। रेंडरिंग की विफलता को कभी भी समतुल्यता के प्रमाण के रूप में स्वीकार नहीं किया जाता है।
स्कोरकार्ड: चार बाहरी OCR इंजनों में वास्तविक बढ़त
OCRErrBench के 900 मामलों में एंड-टू-एंड डायग्नोसिस पर, DocEDR ने 94.78% सटीकता, 94.75% संतुलित सटीकता (balanced accuracy), और 94.59% Bad-F1 हासिल किया। बेस Qwen3.5-9B ने 81.44% सटीकता दर्ज की, जबकि DOCR-Inspector-7B ने 78.78% हासिल किया। Qwen3.5-397B-A17B(FP8) 87.78% तक पहुँचता है, जो DocEDR से सात प्रतिशत अंक कम है।
स्थानीयकरण (localization) के लिए, DocEDR ने टेक्स्ट स्पैन पर 92.72% और फॉर्मूला-टोकन स्पैन पर 73.26% का इवेंट-स्तरीय माइक्रो-F1 दर्ज किया। ये स्कोर तीन सामान्यीकृत वर्णों या टोकन की बाउंड्री टॉलरेंस के साथ वन-टू-वन त्रुटि मिलान का उपयोग करते हैं। बेंचमार्क प्रोटोकॉल के तहत फॉर्मूला स्थानीयकरण पर GLM-4.6V-Flash और InternVL3.5-8B क्रमशः 0.61% और 1.23% स्कोर करते हैं।
सुधार (Repair) और संरक्षण (Preservation) का अलग-अलग मूल्यांकन किया जाता है:
- विज़ुअल फिक्स (VisFix): 443 त्रुटिपूर्ण इनपुट्स पर, DocEDR 86.23% हासिल करता है। इसके लिए उसी फ्रोजन कंपाइलर के तहत रेंडर किए गए सुधार और रेंडर किए गए लक्ष्य के बीच पिक्सेल-स्तरीय समानता (pixel-level identity) की आवश्यकता होती है।
- सटीक स्ट्रिंग फिक्स (Exact String Fix): उन्हीं त्रुटिपूर्ण इनपुट्स पर, यह 82.17% सामान्यीकृत लक्ष्य सहमति (normalized target agreement) प्राप्त करता है।
- संरक्षण दर (Preservation Rate): 457 वैध इनपुट्स पर, यह 93.44% प्राप्त करता है।
डायरेक्ट वन-स्टेप Qwen3.5-397B 72.23% VisFix और 26.19% ExactFix तक पहुँचता है। Qwen3.5-9B द्वारा वन-पास सुधार को निर्देशित करने वाला DOCR-Inspector-7B 65.46% VisFix तक पहुँचता है। ये बेसलाइन ऑनलाइन री-रेंडरिंग का उपयोग नहीं करते हैं। बड़े डायरेक्ट मॉडल का प्रिजर्वेशन स्कोर भी DocEDR से अधिक है: 93.44% की तुलना में 94.75%।
ज़ीरो-शॉट डायग्नोसिस का परीक्षण 637 संगत DOCRcaseBench मामलों पर किया गया है, जिसमें 445 टेक्स्ट मामले और 192 फॉर्मूला मामले शामिल हैं। फॉर्मूला Case-F1, DOCR-Inspector-7B के 56.69% से बढ़कर DocEDR के लिए 87.68% हो जाता है, जो कि 30.99 प्रतिशत अंकों का लाभ है। शोध-पत्र अलग से 61 अतिरिक्त सही फॉर्मूला वर्गीकरणों की रिपोर्ट करता है। ये डायग्नोस्टिक परिणाम हैं, फॉर्मूला-रिपेयर दर नहीं।
अंत में, लेखकों ने UniMER-Test के सिंपल और कॉम्प्लेक्स प्रिंटेड एक्सप्रेशन सबसेट्स से प्रति पार्सर 12,683 सूत्रों पर रिफाइनमेंट का परीक्षण किया। DocEDR उन प्रेडिक्शन्स को संरक्षित रखता है जिन्हें वह सही मानता है और जिन्हें त्रुटिपूर्ण मानता है उनकी मरम्मत करता है। रिपोर्ट किए गए लाभ प्रत्येक निश्चित, मॉडल-पहचाने गए 'Bad' विभाजन पर लागू होते हैं:
- MinerU2.5: 32.50% को 'Bad' के रूप में पहचानता है; उस विभाजन के कैरेक्टर डिटेक्शन मैचिंग (CDM) में 2.93 प्रतिशत अंकों का सुधार करता है।
- PaddleOCR-VL-1.5: 22.19% को 'Bad' के रूप में पहचानता है; उस विभाजन के CDM में 2.24 अंकों का सुधार करता है।
- InternVL3.5-8B: 25.92% को 'Bad' के रूप में पहचानता है; उस विभाजन के CDM में 3.72 अंकों का सुधार करता है।
- GLM-4.6V-Flash: 37.18% को 'Bad' के रूप में पहचानता है; उस विभाजन के CDM में 4.62 अंकों का सुधार करता है।
पार्सर्स के सुधार-पूर्व समग्र CDM स्कोर 65.59% से 94.12% के बीच हैं। प्रत्येक पहचाने गए Bad विभाजन में सुधार होता है। हालाँकि, DocEDR का 'Good' निर्णय संदर्भ-स्तरीय शुद्धता स्थापित नहीं करता है: InternVL3.5-8B और GLM-4.6V-Flash के Good विभाजनों के सुधार-पूर्व CDM स्कोर 66.97% और 78.65% हैं।
डॉक्यूमेंट इंजीनियरिंग और LLM पाइपलाइन्स के लिए यह क्यों महत्वपूर्ण है
डॉक्यूमेंट इंजीनियरिंग के लिए, इस शोध-पत्र का सबसे ठोस व्यावहारिक सबक यह है कि मूल्यांकित कार्यों पर विशेष डायग्नोसिस और रिपेयर प्रशिक्षण किसी बहुत बड़े मॉडल की सीधी प्रॉम्प्टिंग से बेहतर परिणाम दे सकता है। यह एक समर्पित सुधार चरण (dedicated correction stage) की पड़ताल का समर्थन करता है। यह यह स्थापित नहीं करता कि सिंगल-पास OCR स्केलिंग की उच्चतम सीमा तक पहुँच गया है या प्रत्येक डॉक्यूमेंट पाइपलाइन को निष्पादन लूप की आवश्यकता है। वैसे, इस शोध के सीमित दायरे के संदर्भ में यह ध्यान रखना भी प्रासंगिक है कि अंग्रेज़ी में सशक्त OCR का तात्पर्य देवनागरी जैसी जटिल लिपि के लिए स्वतः ही अच्छे OCR से नहीं होता।
दूसरा, पहचान (recognition) के बाद भी सोर्स इमेज उपयोगी बनी रहती है। OCR-EDR संपादन योग्य टेक्स्ट और उसकी रेंडरिंग के साथ-साथ पूरी सुधार प्रक्रिया के दौरान इसे एक साक्ष्य के रूप में बनाए रखता है। इससे पॉलिसी यह जांचने में सक्षम होती है कि क्या प्रस्तावित परिवर्तन दृश्य सामग्री और संरचना को पुनर्स्थापित करता है। शोध-पत्र में रिट्रीवल, RAG, गणितीय प्रश्नोत्तरी (QA), या अन्य डाउनस्ट्रीम अनुप्रयोगों का मूल्यांकन नहीं किया गया है, इसलिए उन प्रणालियों में सुधार अभी भी अप्रमाणित हैं।
तीसरा, मूल्यांकन को पहचान की त्रुटियों से निरूपण के अंतरों को अलग करने से लाभ होता है। OCRErrBench में वास्तविक त्रुटियों के साथ-साथ सटीक सकारात्मक (exact positives) और रेंडरिंग-समतुल्य सकारात्मक (rendering-equivalent positives) दोनों को स्पष्ट रूप से शामिल किया गया है। इसके परिणाम दर्शाते हैं कि किसी बेंचमार्क को सुधार के साथ-साथ संरक्षण (preservation) का भी परीक्षण क्यों करना चाहिए: जो मॉडल कई टूटे हुए प्रेडिक्शन्स को सुधारता है, वह अभी भी वैध प्रेडिक्शन्स में अनावश्यक बदलाव कर सकता है।
एब्लेशन (Ablations) इस सबक को और स्पष्ट करते हैं। एक समकक्ष प्रयोग में, पोस्ट-एडिट फीडबैक के बिना वन-स्टेप सेटिंग की तुलना में, अपडेटेड रेंडरिंग के बिना पुनरावृत्ति (iteration) ExactFix को 72.46% से घटाकर 66.82% कर देती है। वहीं, अपडेटेड रेंडरिंग के साथ पुनरावृत्ति को जोड़ने से ExactFix बढ़कर 82.17% और VisFix बढ़कर 86.23% हो जाता है। केवल अतिरिक्त टर्न ही इस बढ़त की व्याख्या नहीं करते; मॉडल को अपने संपादनों के बारे में उपयोगी साक्ष्य की आवश्यकता होती है।
अंत में, बाहरी-पार्सर प्रयोग एक ठोस एकीकरण पैटर्न (integration pattern) प्रदर्शित करता है: मौजूदा OCR प्रेडिक्शन लें, उसका डायग्नोसिस करें, उसे सुरक्षित रखें या सुधारें, और परिणाम मापें। चयनित दस्तावेज़ क्षेत्रों को ऐसे चरण में रूट करना एक संभावित परिनियोजन विस्तार (deployment extension) है। शोध-पत्र में कॉन्फिडेंस-आधारित रूटिंग का परीक्षण नहीं किया गया है और न ही इसकी परिचालन लागत स्थापित की गई है।
इंजीनियरिंग ट्रेड-ऑफ और अनसुलझी कठिन समस्याएं
परिणाम प्रभावशाली हैं, लेकिन रिपोर्ट किए गए प्रयोग परिनियोजन (deployment) से जुड़े कई प्रश्नों को अनुत्तरित छोड़ देते हैं।
पहली समस्या लेटेंसी (latency) की है। DocEDR सभी OCRErrBench मामलों में औसतन 2.313 इंटरैक्शन टर्न और त्रुटिपूर्ण इनपुट्स पर 1.598 रेंडरिंग कॉल लेता है। ये आंकड़े इंटरैक्शन दक्षता का वर्णन करते हैं, न कि बीते हुए प्रसंस्करण समय (elapsed processing time) का। शोध-पत्र में वॉल-क्लॉक लेटेंसी, थ्रूपुट, या परिनियोजन लागत की रिपोर्ट नहीं की गई है, इसलिए वे यह स्थापित नहीं कर सकते कि यह प्रणाली इंटरैक्टिव स्कैनिंग या बड़े पैमाने के बैच प्रोसेसिंग के अनुकूल है या नहीं।
दूसरी समस्या रेंडरिंग वातावरण की है। बेंचमार्क की समतुल्यता जाँच और विज़ुअल रिपेयर मानदंड एक फ्रोजन कंपाइलर और फ़ॉन्ट सेटअप पर निर्भर करते हैं। यह रिपोर्ट की गई तुलनाओं को चुने गए परिवेश में पुनरुत्पादित करने योग्य बनाता है। यह मनमाने मार्कअप, फोंट या दस्तावेज़ प्रारूपों के कवरेज को स्थापित नहीं करता है। फ्रेमवर्क रेंडरिंग विफलताओं को स्पष्ट रूप से निरूपित करता है, लेकिन शोध-पत्र असमर्थित वैध संरचनाओं (unsupported valid constructs) के लिए कोई सामान्य समाधान प्रस्तुत नहीं करता है।
संबंधित मेट्रिक्स के तहत फॉर्मूला स्थानीयकरण भी टेक्स्ट स्थानीयकरण की तुलना में कमजोर बना हुआ है: 92.72% F1 के मुकाबले 73.26%। इनपुट एब्लेशन एक उपयोगी स्पष्टीकरण जोड़ता है। सोर्स इमेज और OCR टेक्स्ट पूर्ण ट्रिपलेट की तुलना में उच्च स्थानीयकरण स्कोर प्राप्त करते हैं, जबकि रेंडरिंग जोड़ने से वैधता और त्रुटि-प्रकार के सबसे मजबूत परिणाम मिलते हैं। रेंडरिंग मदद तो करती है, लेकिन यह हर मापी गई क्षमता में सुधार नहीं करती।
समतुल्य-सकारात्मक (Equivalent-positive) परिणामों पर विशेष ध्यान देने की आवश्यकता है। Table 3 अपने बाउंड्री-डायग्नोसिस विश्लेषण में DocEDR के लिए 25.81% की फॉल्स-पॉजिटिव दर की रिपोर्ट करती है, जबकि DOCR-Inspector-7B के लिए यह 75.81% है। Table E1 पूर्ण-इनपुट मॉडल के लिए अलग से 4.75% समतुल्य-सकारात्मक फॉल्स पॉजिटिव की रिपोर्ट करती है। शोध-पत्र इन आंकड़ों का स्पष्ट रूप से समाधान नहीं करता है, इसलिए 25.81% को वैध कोड विविधताओं के लिए एक सार्वभौमिक दर के रूप में प्रस्तुत नहीं किया जाना चाहिए। इसके अलावा, एक डायग्नोस्टिक फॉल्स पॉजिटिव अपने आप में यह भी स्थापित नहीं करता कि कोई संपादन हुआ ही था।
संरक्षण (Preservation) अभी भी अपूर्ण है, जैसा कि वैध इनपुट पर 93.44% का परिणाम दर्शाता है। न ही प्रत्येक सुधार को एक नई विज़ुअल जाँच मिलती है: दूसरी रेंडरिंग का अनुरोध करना एक पॉलिसी निर्णय है, और मॉडल संपादन के बाद रुक भी सकता है। रिपेयर स्कोर बेंचमार्क की मूल्यांकन प्रक्रिया के तहत प्रदर्शन स्थापित करते हैं, न कि प्रत्येक आउटपुट के लिए कोई गारंटी।
इन सीमाओं के बावजूद, OCR-EDR एक ठोस प्रगति प्रस्तुत करता है। यह सोर्स-ग्राउंडेड डायग्नोसिस, निष्पादन योग्य सुधार और वैकल्पिक विज़ुअल पुनर्मूल्यांकन को एक ही पॉलिसी में जोड़ता है—और सफल सुधारों के साथ-साथ वैध प्रेडिक्शन्स के संरक्षण दोनों को मापता है।