小型モデルと構造化データ:軽量VLMは複雑な文書抽出においてクラウドAPIを代替できるか?
元論文: From Pixels to Structure: Lightweight Vision-Language Models for Document OCR and Structured JSON Extraction — Uddipan Basu Bir, Vincent Christlein, Andreas Maier, Mathias Zinnen
整ったデジタルの請求書をマルチモーダルモデルに渡せば、キーと値のペアを抽出することは一見容易に思えるかもしれません。しかし、同じモデルに筆記体で書かれたドイツの歴史的な考古学台帳や、印刷されたラベル、手書きの記入、専門的なチェックボックスが混在する建築調査票を渡してみるとどうでしょうか。文字を読み取ることは、全体の作業のほんの一端に過ぎません。
従来のアプローチでは、画像の二値化、レイアウトセグメンテーション、Tesseractなどの外部光学文字認識(OCR)エンジン、そしてLayoutLMのような後段の主要情報抽出(KIE: Key Information Extraction)モデルなど、複数のステージを組み合わせていました。大規模な商用Vision-Language Model(VLM)は別の手段を提供しますが、独自のデプロイ上の制約を伴います。
GLAM分野(美術館・博物館、図書館、公文書館:Galleries, Libraries, Archives, and Museums)の機関にとって、クラウドAPIの利用は大きな障壁となり得ます。アーカイブ記録を商用プロバイダーに送信することは、データ主権(データ自律性)の懸念を生じさせ、継続的なコストを発生させ、大規模計算による環境負荷への疑問を投げかけます。これらの懸念がローカルでの代替手段を模索する動機となっていますが、本研究自体がコストやエネルギー消費量を測定したわけではありません。
フリードリヒ・アレクサンダー大学エアランゲン=ニュルンベルク(FAU)の研究チームは、論文『From Pixels to Structure: Lightweight Vision-Language Models for Document OCR and Structured JSON Extraction』(Uddipan Basu Bir, Vincent Christlein, Andreas Maier, Mathias Zinnen、2026年10月8日、arXiv:2610.11818)において、このボトルネックに取り組みました。著者らは直接的なエンジニアリングの問いを投げかけています:パラメータ数70億(7B)以下の軽量VLMは、歴史的文書を転記し、機関自身が管理・制御可能な処理に適したスキーマ準拠のJSONを生成できるのか?
研究者らは、ドイツの3つの専門的なアーカイブコレクションを対象に8つのモデルを評価しました。その過程で、特にプロンプトでのデモンストレーション(Few-Shot例示)、古典的な画像フィルタ、複数コレクションにわたる単一チェックポイントの学習に関して、文書処理における従来の通説を覆す実践的な知見を明らかにしました。
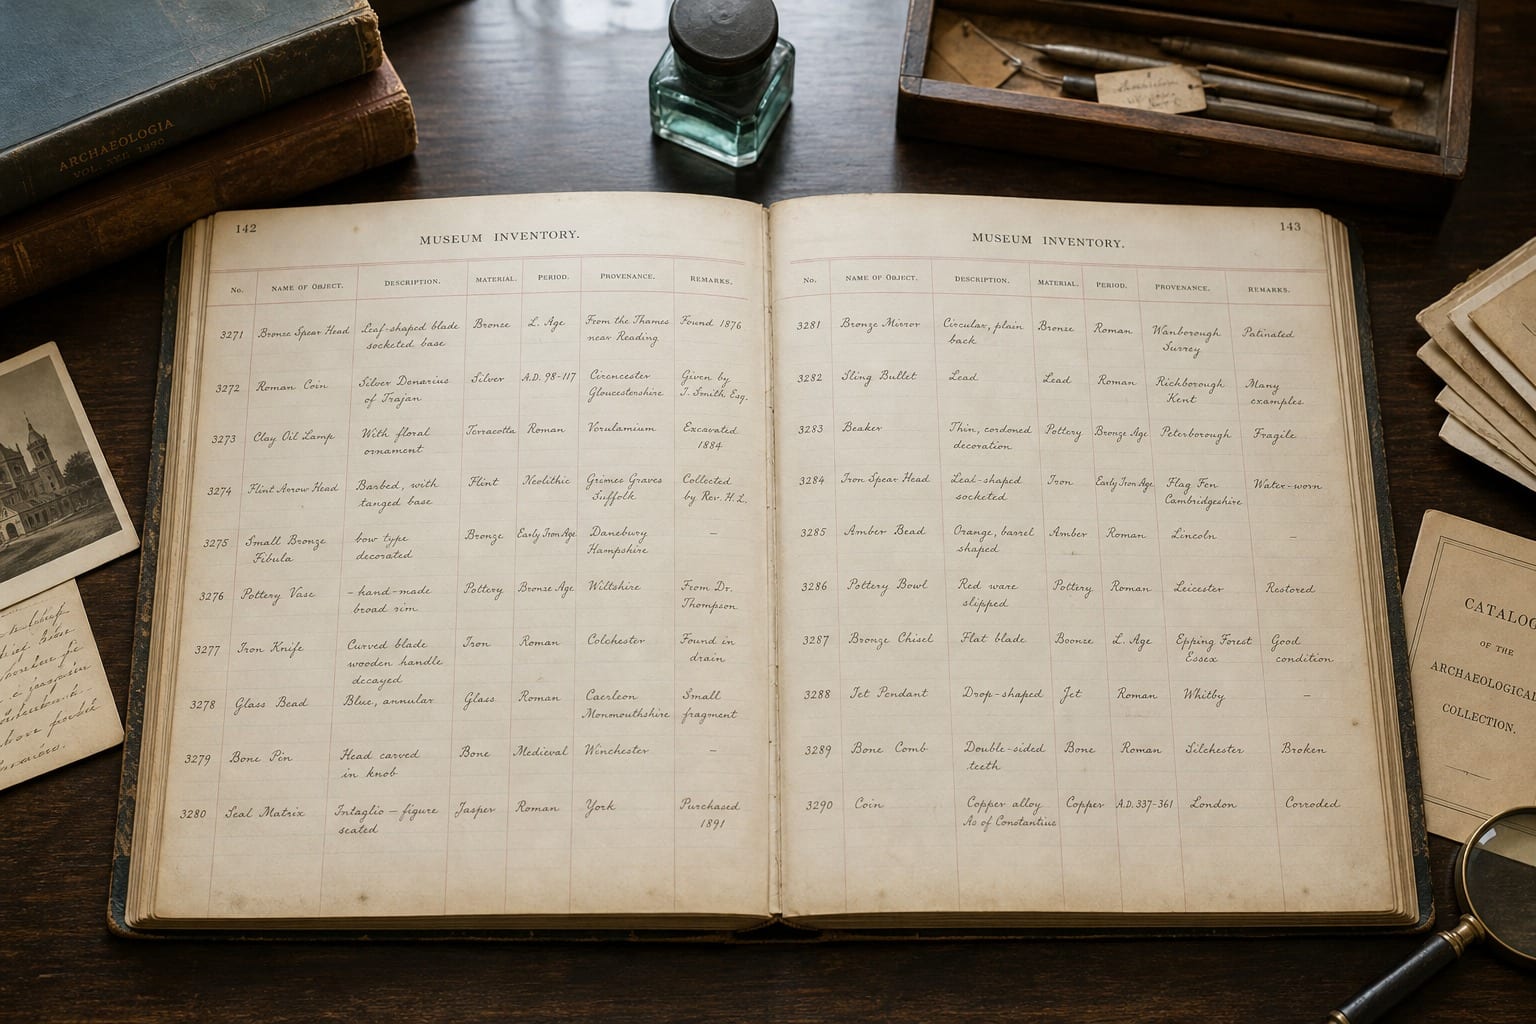
3つのコレクション、3つの悪夢:筆記体、目録カード、そして入れ子構造の階段
構造化文書抽出の評価には、現実のアーカイブが抱える課題に対してモデルをテストすることが求められます。著者らは、3つの異なるコレクションにわたる計1,062件の文書ベンチマークを構築し、概ね訓練(Train)70%、検証(Val)15%、テスト(Test)15%の分割を用いました:
+------------------------+-------+-------+-----+------+-------------------+--------------------------------+
| Dataset                | Total | Train | Val | Test | Text Type         | Schema Complexity              |
+------------------------+-------+-------+-----+------+-------------------+--------------------------------+
| Erlangen-Prehistoric    |   308 |   216 |  46 |   46 | Handwritten       | Medium (8 top-level fields)    |
| Pforzheim Jewelry       |   590 |   413 |  88 |   89 | Mostly printed    | Medium (17 flat fields)        |
| Regensburg Scalalogy    |   164 |   114 |  25 |   25 | Mixed (print/pen) | High (deeply nested, booleans)  |
| Total                  | 1,062 |   743 | 159 |  160 | —                 | —                              |
+------------------------+-------+-------+-----+------+-------------------+--------------------------------+
各コレクションは、それぞれ異なる構造的ハードルを表しています:
- Erlangen-Prehistoric Dataset: FAUの『Inventarbuch der Anthropologisch Prähistorischen Sammlung』(人類学・先史時代コレクション目録簿)に由来するこの308ページは、印刷されたヘッダーやラベルとともに歴史的な手書き文字が含まれています。例示されたターゲットJSONスキーマには、画像識別子や、
L、B、Dへとネストされた遺物の寸法(Maße)を含む8つのトップレベルフィールドがあります。その他のフィールドには、出土地点(Fundort)、発見時期(Fundzeit)、説明文(Beschreibungstext)などがあります。グラウンドトゥルース(正解)の転記データはGeminiを使用して生成され、Zenodoで公開される前に手動で検証されました。 - Pforzheim Jewelry Dataset: プフォルツハイム大学(HS Pforzheim)のKUPFER研究プロジェクトから提供されたこのコレクションには、1879年から1970年の間に取得された宝飾品を記載した590枚の歴史的な在庫目録カードが含まれています。これらのカードは、1980年頃に対象物がプフォルツハイム宝飾博物館へ永久寄託された際に、歴史的書籍から作成されたものです。文書の大部分は活字印刷ですが、素材、重量、購入価格、保険価格(
Vers.-Wert)などを網羅する高密度な17フィールドのスキーマにわたる抽出が要求されます。 - Regensburg Scalalogy Dataset: 構造面における最大のストレステスト。レーゲンスブルク東バイエルン工科大学(OTH Regensburg)のフリードリヒ・ミールケ階段学研究所(FMIS)から提供されたこの164枚の調査票は、専門用語を用いて階段の建築様式を記録しています。ターゲットJSONスキーマは深くネストされており、整数値の測定値や階段の段数(
STUFEN)に加えて、内側・外側のハウジング区分(GEHÄUSE)、回転方向(LAUF)、手すりの配置(HANDLAUF)などの構造的特徴を示すブール値(真偽値)フラグを備えています。
アーカイブのフィールドが判読不能または存在しない場合、タスクではテキストフィールドを空文字列("")、ブール値フィールドを false に設定することが求められました。各コレクションには固定のターゲットスキーマが設定されていたため、文字を認識することだけでなく、抽出した内容を適切なフィールドに正確に配置することが成功の条件でした。
8つのモデルの直接対決とプロンプト手法の隔たり
著者らは、論文中でオープンソースVLMと表現されている、200Mから7Bパラメータにおよぶ8つのモデルを評価しました:
- Donut-Base (200M) および Donut-CORD (200M): OCRフリーのエンコーダ・デコーダモデル。
- Florence-2-Large (0.77B): 統合型ビジョン・言語モデル。
- PaddleOCR-VL (0.9B): OCR特化型のビジョン・言語モデル。
- Nanonets-OCR-s (4B): OCR特化型VLM。
- Gemma-3-4B (4B): 指示調整済み(instruction-tuned)VLM。
- Phi-3.5-Vision (4.2B): 指示調整済みVLM。
- Qwen2.5-VL-7B (7B): 指示調整済みVLM。
本研究の重要な貢献の一つは、その**制約を考慮した評価プロトコル(constraint-aware evaluation protocol)**にあります。多様なVLMのベンチマークは、サポートされているインターフェースがそれぞれ異なるため非常に困難です。
本研究のプロトコルの下では、Donut、Florence-2-Large、PaddleOCR-VLは、<OCR> や <s_cord-v2> といった固定のOCR形式プロンプトやタスク固有トークンを使用しました。これらには任意の対話型指示やFew-Shotデモンストレーションは与えられませんでした。著者らは、JSONパースを試みる前に、ラッパー、チャット接頭辞、空白、コードフェンスの削除など、最小限の後処理を適用しました。
対照的に、Gemma-3-4B、Phi-3.5-Vision、Qwen2.5-VL-7B、Nanonets-OCR-sは、カスタムの自然言語プロンプトを用いて評価されました。ゼロショット評価では、それらのプロンプトにターゲットJSONの骨格が含まれ、そのスキーマに従った出力を要求しました。
この違いは結果を解釈する上で重要です。本ベンチマークは、すべてのモデルに同一のスキーマ付きプロンプトを与えるのではなく、本研究で採用されたそれぞれのインターフェースを介したOCRからJSONへの変換性能を測定しています。
標準的なOCRメトリクスが構造化JSONの失敗を見逃す理由
構造化文書AIの評価には、出力の忠実度(文字認識の正確さ)と構造的な信頼性の両方を測定することが不可欠です。モデルが不正な形式のJSONを返したり、誤ったフィールドに値を割り当てたりした場合、文字自体が認識できていても直接のシステム取り込みには利用できません。
著者らは、相互に補完し合う3つのメトリクスを追跡しました:
- Character Error Rate (CER): カノニカル化されたグラウンドトゥルースJSON文字列に対する文字レベルの編集距離エラーをリファレンス長で正規化して測定します(低いほど優れています)。パースされた予測結果は、比較前に同一のカノニカル形式にシリアライズされます。パースに失敗した場合は、未加工の出力がカノニカルリファレンスと比較されます。これにより、単なる転記精度だけでなく、構造を含めたJSONテキスト全体の忠実度が測定されます。
- Approximate Normalized Levenshtein Similarity (ANLS*): 閾値 $\tau = 0.5$ を用いた構造化類似度メトリクスであり、閾値を下回る類似度はゼロと見なされます。出力がJSONとしてパースできる場合はネストされたオブジェクトを評価し、パースに失敗した場合はカノニカルなグラウンドトゥルースJSON文字列に対する文字列レベルの類似度へとフォールバックします。
- Mean Average Precision F1 (mAP-F1): 本研究における構造重視のメトリクス。物体検出の評価プロトコルやDANのmAPCERに着想を得ており、予測と正解を
GEHÄUSE.innen.1のようにドット表記された末端キーへとフラット化します。フィールドごとの一致スコア($1 - \text{CER}$)は4つの閾値 $\theta \in {0.3, 0.5, 0.7, 0.8}$ で評価されます。各閾値においてフィールド間でPrecisionとRecallをマクロ平均してF1スコアを算出し、mAP-F1はその4つの閾値の平均値となります。
決定的に重要なのは、出力が json.loads によってPythonの辞書型にパースできない場合、mAP-F1は 0.0% として採点されるという点です。一方、CERとANLS*は生のテキスト比較を通じて部分点を付与することができます。
著者らはJSONの妥当性も別途追跡しました。メインの表からは除外されているものの、Gemma-3、Phi-3.5-Vision、Qwen2.5-VLは、すべてのデータセットおよび設定において約95%〜100%の妥当性を維持しました。ただし、パースに成功したこと自体が、すべてのフィールドや値が正しいことを証明するわけではありません。
一方で、Donut、Florence-2、PaddleOCR-VLのJSON妥当性ははるかに低いものでした。CERやANLS*において出力がリファレンス内容の一部を保持していることが示されていた場合でも、ゼロショット評価ではすべてmAP-F1が0.0%となりました。
ゼロショット、Few-Shot、そしてインコンテキスト・プロンプティングの罠
ゼロショット設定では、柔軟なプロンプトに対応できるモデルが構造化抽出の結果をリードしました。Qwen2.5-VL-7Bは、3つすべてのデータセットにおいて最も高いANLS*とmAP-F1を達成しました。Pforzheim Jewelryでは、Nanonets-OCR-sが1.9%とより低いCERを記録したものの、Qwen2.5-VL-7BはCER 2.6%、ANLS* 96.0%、mAP-F1 96.3%に達しました。手書きのErlangen-Prehistoric記録において、QwenはCER 21.4%、mAP-F1 56.2%を達成しました。
以下の結果表におけるすべてのメトリクス値はパーセンテージです。
+------------------+--------------------------+--------------------------+--------------------------+
|                  |   Erlangen-Prehistoric   |     Pforzheim Jewelry    |   Regensburg Scalalogy   |
| Zero-Shot Model  |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |
+------------------+--------------------------+--------------------------+--------------------------+
| Donut-Base       |  93.4      0.0      0.0  |  97.2      0.0      0.0  |  90.1      0.0      0.0  |
| Donut-CORD       |  78.8      0.0      0.0  |  91.9      0.0      0.0  |  93.1      0.0      0.0  |
| Florence-2-Large |  45.6     50.4      0.0  |  33.6     66.4      0.0  |  75.6      0.0      0.0  |
| Nanonets-OCR-s   |  25.7     49.4     28.5  |   1.9     86.5     86.5  |  39.3     22.8     15.2  |
| PaddleOCR-VL     |  69.2     20.1      0.0  |  51.3     57.0      0.0  |  78.1      0.0      0.0  |
| Gemma-3-4B       |  33.6     41.8     34.6  |   4.4     92.1     87.4  |  37.6     26.3     22.5  |
| Phi-3.5-Vision   |  50.9     28.1     23.4  |   7.3     85.3     67.9  |  28.7     57.1     27.9  |
| Qwen2.5-VL-7B    |  21.4     54.0     56.2  |   2.6     96.0     96.3  |  21.3     67.0     33.3  |
+------------------+--------------------------+--------------------------+--------------------------+
著者らがFew-Shotインコンテキスト学習をテストした際、訓練セットからサンプリングされた画像とJSONのデモンストレーションペアを提供しました(Pforzheim Jewelryには1例、Erlangen-PrehistoricとRegensburg Scalalogyには2例)。これには柔軟なプロンプト入力に対応した4つのモデルのみが参加しました。
その結果は有益な警告となりました:Few-Shotプロンプティングは、複雑な文書の抽出を一貫して改善するわけではなかったのです。
+------------------+--------------------------+--------------------------+--------------------------+
| Few-Shot Model   |   Erlangen-Prehistoric   |     Pforzheim Jewelry    |   Regensburg Scalalogy   |
| (1-2 Examples)   |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |
+------------------+--------------------------+--------------------------+--------------------------+
| Nanonets-OCR-s   |  61.9     53.3     44.7  |   1.7     93.1     90.7  |  33.3     44.5     44.9  |
| Gemma-3-4B       |  26.8     61.7     53.6  |   2.0     97.3     92.1  |  34.9     33.8     20.2  |
| Phi-3.5-Vision   |  59.3     40.7     38.9  |   7.2     85.9     71.1  |  52.7     27.5     23.1  |
| Qwen2.5-VL-7B    |  18.9     79.0     74.7  |   0.9     98.9     99.4  |  24.1     55.6     30.7  |
+------------------+--------------------------+--------------------------+--------------------------+
Few-Shotプロンプティングは、Pforzheim Jewelryにおいて報告されたすべてのメトリクスで4モデルすべてに好影響を与えました。Qwen2.5-VLのCERは2.6%から0.9%へと低下し、mAP-F1は99.4%に上昇しました。しかし、他のデータセットでは結果が分かれました:
- Nanonets-OCR-sは、Erlangen-Prehistoricの手書き文字において、ANLS*とmAP-F1が改善したにもかかわらず、CERが25.7%から61.9%へと悪化しました。
- Gemma-3-4Bは、Regensburg ScalalogyにおいてCERとANLS*が改善したにもかかわらず、mAP-F1が22.5%から20.2%へと低下しました。
- Phi-3.5-Visionは、ScalalogyにおいてCERが28.7%から52.7%へと悪化し、他の2つのメトリクスも低下しました。
- QwenとGemmaはErlangen-Prehistoricで3つのメトリクスすべてが改善した一方、NanonetsはScalalogyで3つのメトリクスすべてが改善しました。
なぜデモンストレーションはある設定では有効に働き、別の設定では悪影響を与えたのでしょうか? 著者らは、プロンプトが長くなることで指示の複雑さが増す可能性を示唆していますが、実験ではアテンションや視覚エンコーディングに関する特定のメカニズムまでは立証されていません。得られた教訓はより限定的です:例文の提示はテストすべき適応戦略の一つであり、必ず性能が向上する保証ではないということです。
ローカル環境でのファインチューニング:32GB GPU上でのQLoRA
著者らはまた、評価対象となったすべてのモデルに対してファインチューニングを実施しました。
1Bパラメータ未満のモデルに対しては、全パラメータのファインチューニングを行いました。より大規模なモデルに対しては、ベースモデルの重みを凍結したままアテンション層とMLP層にLoRAアダプタを適用し、4ビット量子化と組み合わせたQLoRA(Quantized Low-Rank Adaptation)を用いました。論文の手法セクションでは、このQLoRA構成に32GBのVRAMを搭載したNVIDIA V100を使用したことが明記されています。
チェックポイントの選定には、自己回帰的な検証CERが最も低いものが使用され、テスト評価にも自己回帰生成が用いられました。これは文書全体の出力を一度のフォワードパスで一括生成するのではなく、画像からJSONへの逐次生成です。
+------------------+--------------------------+--------------------------+--------------------------+
| Fine-Tuning      |   Erlangen-Prehistoric   |     Pforzheim Jewelry    |   Regensburg Scalalogy   |
| Baseline Results |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |
+------------------+--------------------------+--------------------------+--------------------------+
| Donut-Base       |  16.4     78.0      0.0  |   6.3     93.6      0.0  |  59.5      0.0      0.0  |
| Donut-CORD       |  20.6     75.0      0.0  |   6.9     92.9      0.0  |  66.0      0.0      0.0  |
| Florence-2-Large |  10.7     75.5     45.4  |  11.1     89.9      0.0  |  57.4      4.3      0.0  |
| Nanonets-OCR-s   |  23.0     82.5     81.2  |   0.5     96.7     87.2  |  20.2     79.9     50.7  |
| PaddleOCR-VL     |  13.7     90.1     85.3  |   1.1     98.7     84.7  |  65.1      0.0      0.0  |
| Gemma-3-4B       |  10.4     88.6     83.1  |   0.9     99.0     99.4  |  14.6     73.8     46.9  |
| Phi-3.5-Vision   |  17.9     86.5     82.2  |   0.3     99.4     99.5  |   6.3     90.1     72.0  |
| Qwen2.5-VL-7B    |   5.8     91.0     90.0  |   0.5     99.2     99.4  |   7.6     87.0     62.8  |
+------------------+--------------------------+--------------------------+--------------------------+
ファインチューニングは、強力な構造化抽出モデルに対して、ゼロショット評価と比べて大幅な改善をもたらしました:
- Qwen2.5-VL-7B は、手書きのErlangen-Prehistoric記録においてCER 5.8%、mAP-F1 90.0%に達しました。
- Phi-3.5-Vision は、Regensburg Scalalogyのベースライン・ファインチューニング結果を牽引し、ゼロショット評価のmAP-F1 27.9%から、CER 6.3%、ANLS* 90.1%、mAP-F1 72.0%へと向上しました。
- Gemma-3-4B は、宝飾品データでmAP-F1 99.4%、先史時代記録で83.1%に達しましたが、ScalalogyでのmAP-F1 46.9%はネストされた構造の抽出が依然として困難であることを示しました。
ファインチューニングによってすべての構造的失敗が解決されたわけではありません。Donutの両バリアントは、3つのデータセットすべてにおいて依然としてmAP-F1が0.0%でした。逆に、PaddleOCR-VLはErlangen-Prehistoricで85.3%のmAP-F1に達し、OCR特化型モデルが一様に失敗したわけではないことを証明しました。
ゼロショット、Few-Shot、ファインチューニングの設定を通じた性能と、安定したJSON生成能力に基づき、著者らは3つの追加検証のために Gemma-3-4B、Phi-3.5-Vision、Qwen2.5-VL-7B を選定しました。
文書AIの「通説」を検証:前処理とHPOは必ずしも勝利をもたらさない
著者らは、標準的なファインチューニングのベースラインに対し、ハイパーパラメータ最適化(HPO)、画像前処理、マルチステージ学習をテストしました。各介入は独立して評価されたため、これらの結果は3つすべてを組み合わせたパイプラインを示すものではありません。
検証1:ハイパーパラメータ最適化(HPO)
Tree-structured Parzen Estimator(TPE)サンプラーを備えたOptunaを使用し、著者らは各5エポックの試行を20回実行して検証CERの最適化を行いました。その後、選定されたハイパーパラメータを用いて、ベースラインのファインチューニングコードによる完全な学習を実行しました。論文では探索空間や選択されたパラメータ値の詳細は明記されていません。
+-------------------------+--------------------------+--------------------------+--------------------------+
| Hyperparameter Tuning   |   Erlangen-Prehistoric   |     Pforzheim Jewelry    |   Regensburg Scalalogy   |
| (Optuna vs Default)     |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |
+-------------------------+--------------------------+--------------------------+--------------------------+
| Gemma-3-4B (Default)    |  10.4     88.6     83.1  |   0.9     99.0     99.4  |  14.6     73.8     46.9  |
| Gemma-3-4B (HPO)        |   9.3     88.8     65.4  |   0.4     99.2     99.5  |   3.4     92.3     77.9  |
| Phi-3.5-Vision (Default)|  17.9     86.5     82.2  |   0.3     99.4     99.5  |   6.3     90.1     72.0  |
| Phi-3.5-Vision (HPO)    |  17.7     84.0     81.2  |   0.3     99.5     99.7  |   3.2     91.8     73.8  |
| Qwen2.5-VL-7B (Default) |   5.8     91.0     90.0  |   0.5     99.2     99.4  |   7.6     87.0     62.8  |
| Qwen2.5-VL-7B (HPO)     |   4.3     93.4     91.2  |   0.5     99.3     99.5  |   3.1     89.4     67.1  |
+-------------------------+--------------------------+--------------------------+--------------------------+
その結果は顕著なものでした:
- Regensburg Scalalogyにおいて、HPOは3モデルすべてで3つのメトリクスをすべて向上させました。Gemma-3-4BのCERは14.6%から3.4%へと低下し、mAP-F1は46.9%から77.9%へと上昇しました。Qwen2.5-VLのCERは7.6%から3.1%へ、PhiのCERは6.3%から3.2%へと低下しました。
- Pforzheim Jewelryでは、ベースラインのスコアがすでに非常に高かったため、絶対的な改善幅は比較的小さいものでした。
- Erlangen-Prehistoricにおいて、HPOはQwenの3つのメトリクスすべてを改善しました。GemmaのCERは10.4%から9.3%へと改善したものの、mAP-F1は83.1%から65.4%へと下落しました。PhiのCERはわずかに改善したものの、ANLS*とmAP-F1は低下しました。
この乖離は重要です。検証CERを基準にハイパーパラメータを選択しても、テストセットにおける構造化抽出の向上は保証されませんでした。この結果は、どのフィールドエラーが原因であったかまでは特定していないものの、メトリクス間の結果における不一致を示しています。
検証2:画像前処理の罠
著者らは、以下の4ステップからなる古典的な前処理パイプラインを構築しました:
- 照度の均一化(Illumination Flattening): グレースケール変換、背景照度を推定するためのモルフォロジー演算のオープニング処理、および不均一な照明を軽減するための正規化。
- ノイズ除去(Denoising): エッジを保持しながらノイズを低減するためのデフォルトのバイラテラルフィルタリング、またはNon-Local Meansデノイジング。
- CLAHE(Contrast Limited Adaptive Histogram Equalization): 輝度チャンネルにおける局所的なコントラストの強調。
- レターボックスリサイズ(Letterbox Resizing): アスペクト比を維持するためのパディングを伴う固定キャンバスへのリサイズ(手法セクションでは例として $1024 \times 1024$ が挙げられています)。
著者らは、ベースラインのファインチューニングの上にこの完全なパイプラインを適用し、生の画像(raw-image)のベースラインと比較評価しました。ここでの「生」とは、この追加のクリーンアップパイプラインを通していないという意味であり、各モデル固有の前処理は依然として適用されています。
+-------------------------+--------------------------+--------------------------+--------------------------+
| Image Preprocessing     |   Erlangen-Prehistoric   |     Pforzheim Jewelry    |   Regensburg Scalalogy   |
| (Raw vs Preprocessed)   |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |
+-------------------------+--------------------------+--------------------------+--------------------------+
| Gemma-3-4B (Raw)        |  10.4     88.6     83.1  |   0.9     99.0     99.4  |  14.6     73.8     46.9  |
| Gemma-3-4B (Preproc ✓)  |  10.4     88.8     85.3  |   1.2     97.6     97.7  |  16.4     69.7     43.6  |
| Phi-3.5-Vision (Raw)    |  17.9     86.5     82.2  |   0.3     99.4     99.5  |   6.3     90.1     72.0  |
| Phi-3.5-Vision (Pre ✓)  |  19.0     80.4     76.5  |   0.3     99.2     99.3  |   5.5     89.5     61.1  |
| Qwen2.5-VL-7B (Raw)     |   5.8     91.0     90.0  |   0.5     99.2     99.4  |   7.6     87.0     62.8  |
| Qwen2.5-VL-7B (Pre ✓)   |   5.2     90.0     87.4  |   0.7     99.1     99.3  |  12.0     81.7     53.6  |
+-------------------------+--------------------------+--------------------------+--------------------------+
テストされた前処理パイプラインは、一部の他のメトリクスが改善した例があったものの、9組のモデル・データセットの組み合わせ中8組においてmAP-F1を低下させました。
Regensburg Scalalogyにおいては:
- Qwen2.5-VLのCERは7.6%から12.0%へと悪化し、mAP-F1は62.8%から53.6%へと下落しました。
- Phi-3.5-VisionのCERは6.3%から5.5%へと改善したものの、mAP-F1は72.0%から61.1%へと下落しました。
- Gemma-3-4BのCERは14.6%から16.4%へと悪化し、ANLS*とmAP-F1も同様に低下しました。
他のデータセットでは例外もありました。GemmaのErlangen-PrehistoricにおけるmAP-F1は83.1%から85.3%に上昇し、同データセットにおけるQwenのCERは構造化スコアの低下にもかかわらず5.8%から5.2%へと改善しました。
本実験は各フィルタを個別に検証したのではなくパイプライン全体をテストしたものです。したがって、デノイジング、コントラスト調整、照度補正、リサイズ、あるいはそれらの組み合わせのどれが特定の変化を引き起こしたのかを特定することはできません。また、性能低下のニューラルなメカニズムを立証するものでもありません。実践的な教訓は、忠実度メトリクスと構造化抽出メトリクスの双方を用いて、前処理を生画像のベースラインと比較・検証すべきだということです。
検証3:マルチステージ・カリキュラム学習
著者らは2ステージのスケジュールをテストしました:基本学習率の3倍($3\times$)で教師強制を用いて教師ありJSONターゲットに対して行う短いウォームアップと、それに続く同一データセット上での基本学習率によるリファインメントです。
検証は各エポックで実行され、最も低い検証CERに基づいてチェックポイントが選定され、改善が見られない忍耐期間の後に早期終了が適用されました。比較には、同一の総エポック数予算とコサイン学習率減衰を用いたシングルステージのベースラインが使用されました。
+-------------------------+--------------------------+--------------------------+--------------------------+
| Multi-Stage Training    |   Erlangen-Prehistoric   |     Pforzheim Jewelry    |   Regensburg Scalalogy   |
| (Single vs Multi-Stage) |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |
+-------------------------+--------------------------+--------------------------+--------------------------+
| Gemma-3-4B (Single)     |  10.4     88.6     83.1  |   0.9     99.0     99.4  |  14.6     73.8     46.9  |
| Gemma-3-4B (Multi-stage)|   8.1     89.9     86.5  |   0.4     99.3     99.5  |  10.3     80.2     63.8  |
| Phi-3.5-Vision (Single) |  17.9     86.5     82.2  |   0.3     99.4     99.5  |   6.3     90.1     72.0  |
| Phi-3.5-Vision (Multi)  |  18.0     86.7     83.0  |   0.3     99.5     99.7  |   4.9     90.5     72.5  |
| Qwen2.5-VL-7B (Single) |   5.8     91.0     90.0  |   0.5     99.2     99.4  |   7.6     87.0     62.8  |
| Qwen2.5-VL-7B (Multi)  |   5.8     91.4     89.1  |   0.7     88.5     90.2  |   7.8     86.0     57.8  |
+-------------------------+--------------------------+--------------------------+--------------------------+
マルチステージ学習はモデルに依存する結果をもたらしました。Gemma-3-4Bに対しては3つのメトリクスおよびコレクションすべてにおいて恩恵をもたらし、先史時代データのCERを10.4%から8.1%へと低下させ、ScalalogyのmAP-F1を46.9%から63.8%へと引き上げました。
PhiはScalalogyにおいて3つのメトリクスすべてで向上を示したものの、他のデータセットでは変化が小さいかまちまちでした。QwenはErlangen-PrehistoricでANLS*のわずかな改善を示したのみで、CERは変化せずmAP-F1は低下しました。JewelryとScalalogyの両方においては、3つのメトリクスすべてで結果が悪化しました。本研究はこれらの結果の差異を明らかにしていますが、それが学習の不安定性によって引き起こされたことまでは証明していません。
マルチデータセットのジレンマ:Gemmaの利得とQwenの負の転移
本番環境において、エンジニアリングチームは文書コレクションごとに個別のモデルを用意するのではなく、単一のチェックポイントで運用したいと考えるかもしれません。著者らは、標準的なファインチューニングレシピを用い、3つのコレクションすべての訓練セットを結合した計743件の文書に対して各選定モデルを1回ファインチューニングすることで、このアプローチをテストしました。
その後、各コレクションのテストセット上でそのチェックポイントを評価し、対応するデータセット固有のチェックポイントと比較しました:
+-------------------------+--------------------------+--------------------------+--------------------------+
| Single-Dataset vs       |   Erlangen-Prehistoric   |     Pforzheim Jewelry    |   Regensburg Scalalogy   |
| Multi-Dataset Checkpoint|  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |  CER↓   ANLS*↑   mAP-F1↑ |
+-------------------------+--------------------------+--------------------------+--------------------------+
| Gemma-3-4B (Single)     |  10.4     88.6     83.1  |   0.9     99.0     99.4  |  14.6     73.8     46.9  |
| Gemma-3-4B (Multi-Joint)|   8.7     90.6     87.9  |   0.3     99.4     99.7  |   9.1     81.5     68.0  |
| Phi-3.5-Vision (Single) |  17.9     86.5     82.2  |   0.3     99.4     99.5  |   6.3     90.1     72.0  |
| Phi-3.5-Vision (Multi)  |  19.7     84.0     45.4  |   0.5     99.2     99.4  |   7.4     84.3     54.1  |
| Qwen2.5-VL-7B (Single)  |   5.8     91.0     90.0  |   0.5     99.2     99.4  |   7.6     87.0     62.8  |
| Qwen2.5-VL-7B (Multi)   |   7.1     89.3     91.9  |   1.6     98.2     99.1  |  24.9     65.2     41.4  |
+-------------------------+--------------------------+--------------------------+--------------------------+
この実験により、3つのモデル間で大きく異なる挙動が明らかになりました:
- Gemma-3-4Bは共同学習から一貫して恩恵を受けました。マルチデータセットによるチェックポイントは、報告されたすべてのメトリクスにおいてデータセット固有のチェックポイントを上回りました。Regensburg Scalalogyでは、CERが14.6%から9.1%へと低下し、mAP-F1は46.9%から68.0%へと上昇しました。これらの結果は、本ベンチマークにおいてGemmaの共同学習を支持するものですが、未知のコレクションでどのように機能するかを立証するものではありません。
- Qwen2.5-VL-7BはScalalogyで顕著な負の転移(negative transfer)を示しました。CERは7.6%から24.9%へと跳ね上がり、mAP-F1は62.8%から41.4%へと下落しました。Erlangen-PrehistoricのmAP-F1が90.0%から91.9%へと向上したのを除き、3つのコレクションすべてでCERとANLS*が悪化しました。
- Phi-3.5-Visionも3つのコレクションすべてで性能が低下しました。特に構造化抽出における損失が顕著で、先史時代のmAP-F1は82.2%から45.4%へ、ScalalogyのmAP-F1は72.0%から54.1%へと下落しました。Jewelryにおける変化ははるかに小規模でした。
著者らは、この性能低下を、異なるスキーマやテキストモダリティを持つコレクション間での負の転移の兆候であると解釈しています。本研究では、勾配の干渉やレイアウトの衝突など、特定の原因を切り分けて特定しているわけではありません。したがって、デプロイの意思決定においてはコレクションごとの評価が必要です。共同学習は、本ベンチマークを通じてあるモデルを助けた一方で、他のモデルでは重要な設定において悪影響を及ぼしました。
モデルが依然として苦戦する領域:定性的な失敗パターン
出力サンプルの精査は、ファインチューニングがもたらす改善と、依然として残るエラーの双方を浮き彫りにします。
Figure 4において、著者らは手書きのErlangen-Prehistoricページに対するGemma-3-4Bのゼロショット予測とファインチューニング後の予測を比較しています。以下の抜粋はその比較を再現したものであり、省略記号や括弧内の注記は完全なモデル出力ではなく例示のためのものです。
ゼロショット予測、サンプルCER: 26.8%:
{
  "Überschrift": "Anthropologisch-prähistorifche ...",
  "Inventarnummer": "J.-Nr. E024",
  "Maße": {"L": "", "B": "", "D": ""},
  "Objektbezeichnung": "Primitiver Kratzer",
  "Fundort": "Spay, Belgien",
  "Fundzeit": "Aumente Helin",
  "Beschreibungstext": "Flacher Stein ... [many OCR errors]"
}
ファインチューニング後の予測、サンプルCER: 13.9%:
{
  "Überschrift": "Anthropologisch=prähistorische ...",
  "Inventarnummer": "Eo 24",
  "Maße": {"L": "6,25", "B": "3,95", "D": "1,7"},
  "Objektbezeichnung": "Primitiver Kratzer ...",
  "Fundort": "Spy, Belgien Ausbeute Helin",
  "Fundzeit": "",
  "Beschreibungstext": "Flacher Stein ... [partially correct]"
}
ファインチューニングにより、予測のいくつかの部分が改善されました:
- ヘッダーが
Anthropologisch-prähistorifcheからAnthropologisch=prähistorischeへと変化しました。 - 目録番号が
J.-Nr. E024からEo 24に変わり、著者らはこれを修正であると確認しています。 - ネストされた寸法が
"L": "6,25", "B": "3,95", "D": "1,7"となり、ゼロショット出力で空欄になっていた測定値が復元されました。
しかし論文では、より長い手書きテキストや、出土地点(Fundort)と発見時期(Fundzeit)の分離における継続的な難しさが明記されています。ファインチューニング後の抜粋では、Fundort に "Spy, Belgien Ausbeute Helin" を配置し、Fundzeit を空のままにしています。この抜粋はすべてのフレーズの正しい割り当てを確定したり、その歴史的意味を解説したりするものではありません。
この例は、より広範な課題を如実に表しています。すなわち、全体的なエラー率の低下とパース可能なJSONオブジェクトの生成は、未解決のフィールド境界エラーと容易に共存し得るということです。
ドキュメントエンジニアリングとGLAMパイプラインにとっての重要性
ソフトウェアアーキテクト、機械学習エンジニア、そしてアーカイブのデジタル化チームにとって、本研究は対象となった3つのコレクションの範囲内において実践的な指針を提供しています。なお、日本語圏の読者にとっては、漢字・かな交じり文や多くのOCR/VLMにとって最大の障壁となる縦書きレイアウトといった極めて難易度の高いケースが本研究のスコープに含まれていない点に留意が必要です。
- 直接的なJSON抽出が必要な場合は指示調整済みVLMを検討する: Gemma-3-4B、Phi-3.5-Vision、Qwen2.5-VL-7Bは、信頼性の高い構造化生成において全体として最も強力な候補でした。ただし、これが特化型OCRエンジンを破棄すべきであることを意味するわけではありません。ベンチマークは特定のモデルとインターフェースをテストしたものであり、個々のコレクションでファインチューニングを行った後には高い性能を発揮した特化型モデルもありました。
- Few-Shotプロンプティングは有効と決めつけず必ずテストする: デモンストレーションはJewelryにおいて評価された4モデルすべてを向上させましたが、手書き文字や入れ子形式の帳票では結果が分かれました。プロンプティング戦略を決定する前に、代表的な文書を用いてゼロショットとFew-Shotの結果を比較してください。
- 画像クリーンアップを検証する際は生画像のベースラインを保持する: 完全な前処理パイプラインは構造化抽出スコアを低下させることが多かったものの、その影響はモデル、データセット、メトリクスに依存していました。これらの結果は実証的な比較を支持するものであり、デノイジングやコントラスト調整を一律に禁止するものではありません。
- 複雑な帳票にはHPOを検討し、同時に複数のメトリクスを追跡する: Optunaによって選択された設定はScalalogyの結果を大幅に改善しました。CERはGemmaで14.6%から3.4%へ、Phiで6.3%から3.2%へ、Qwenで7.6%から3.1%へと低下しました。しかし手書き文字においては、CERの低下に伴ってmAP-F1が悪化する場合がありました。
- マルチデータセットのチェックポイントにおける負の転移を監査する: モデルを統合する前に、各コレクションを個別に評価してください。一部のコレクションではPhiやQwenにおいてデータセット固有のチェックポイントの方が大幅に優れた性能を示した一方、Gemmaは共同学習から一貫して恩恵を受けました。
誠実な限界事項と今後の注目点
本研究の結果は有用なエビデンスを提供していますが、その適用範囲を認識することが重要です:
- 独立した検証と複合的な検証: 著者らはHPO、前処理、マルチステージ学習を独立してテストしました。これらの介入を組み合わせることで追加の利得が得られるかどうかは未検証のままです。
- 制約付きデコーディングは今後の課題: 評価には貪欲法デコーディング(temperature 0として報告)が用いられました。著者らは妥当なJSONを保証するための制約付きデコーディングを今後の方向性として提案していますが、本論文ではその効果を実証していません。構文的な妥当性と、フィールドや値の正確性は依然として区別する必要があります。
- 計算リソースの同等性: より大規模なモデルはQLoRAによって適応された一方、1B未満のモデルはフルファインチューニングを受けました。同一の計算予算の下でこれらのアプローチを対照比較することは今後の課題です。
- コレクションとモデルのカバレッジ: 本ベンチマークは、テストセットがそれぞれ46件、89件、25件の文書からなる3つの専門的なコレクションを対象としています。著者らはモデルの情勢が急速に進化していることに注意を促し、より広範な多言語評価、手書き特化の適応、レイアウトを考慮したフィールドバインディングの必要性を訴えています。
- クラウド代替の直接的なベンチマークは未実施: 本実験はこれらのモデルを商用APIシステムや手作業による転記と直接比較しておらず、コストやエネルギーの削減効果も定量化していません。本研究が示したのは、そうした代替手段に対する実測された優位性ではなく、ローカルモデルによる抽出結果そのものです。
全体としての総括は有望なものです。適切に適応された軽量VLMは、専門的なアーカイブ記録において機関自身が制御可能なOCRからJSONへの抽出を十分に支え得ます。報告された4B〜7BモデルのQLoRAの結果は、特に活字印刷の宝飾品カードにおいて大幅な向上を示した一方で、手書き文字やネストされた帳票では依然として無視できないエラーが残っています。商用APIの代替を検討している機関にとって、本研究は有望な候補モデルと適応戦略を提供するとともに、コンテンツの正確性、フィールドの割り当て、そしてJSONの妥当性を総合的に評価すべき明確な根拠を示しています。