El modelo de OCR que adivina tu cumpleaños cuando no puede leerlo
Basado en: Beyond Visual Evidence: Revealing and Mitigating Relational Privacy Leakage in Document MLLMs — Beining Xu, Hairui Wang, Jiaxin Wang, Changsheng Chen, Anirban Chakraborty
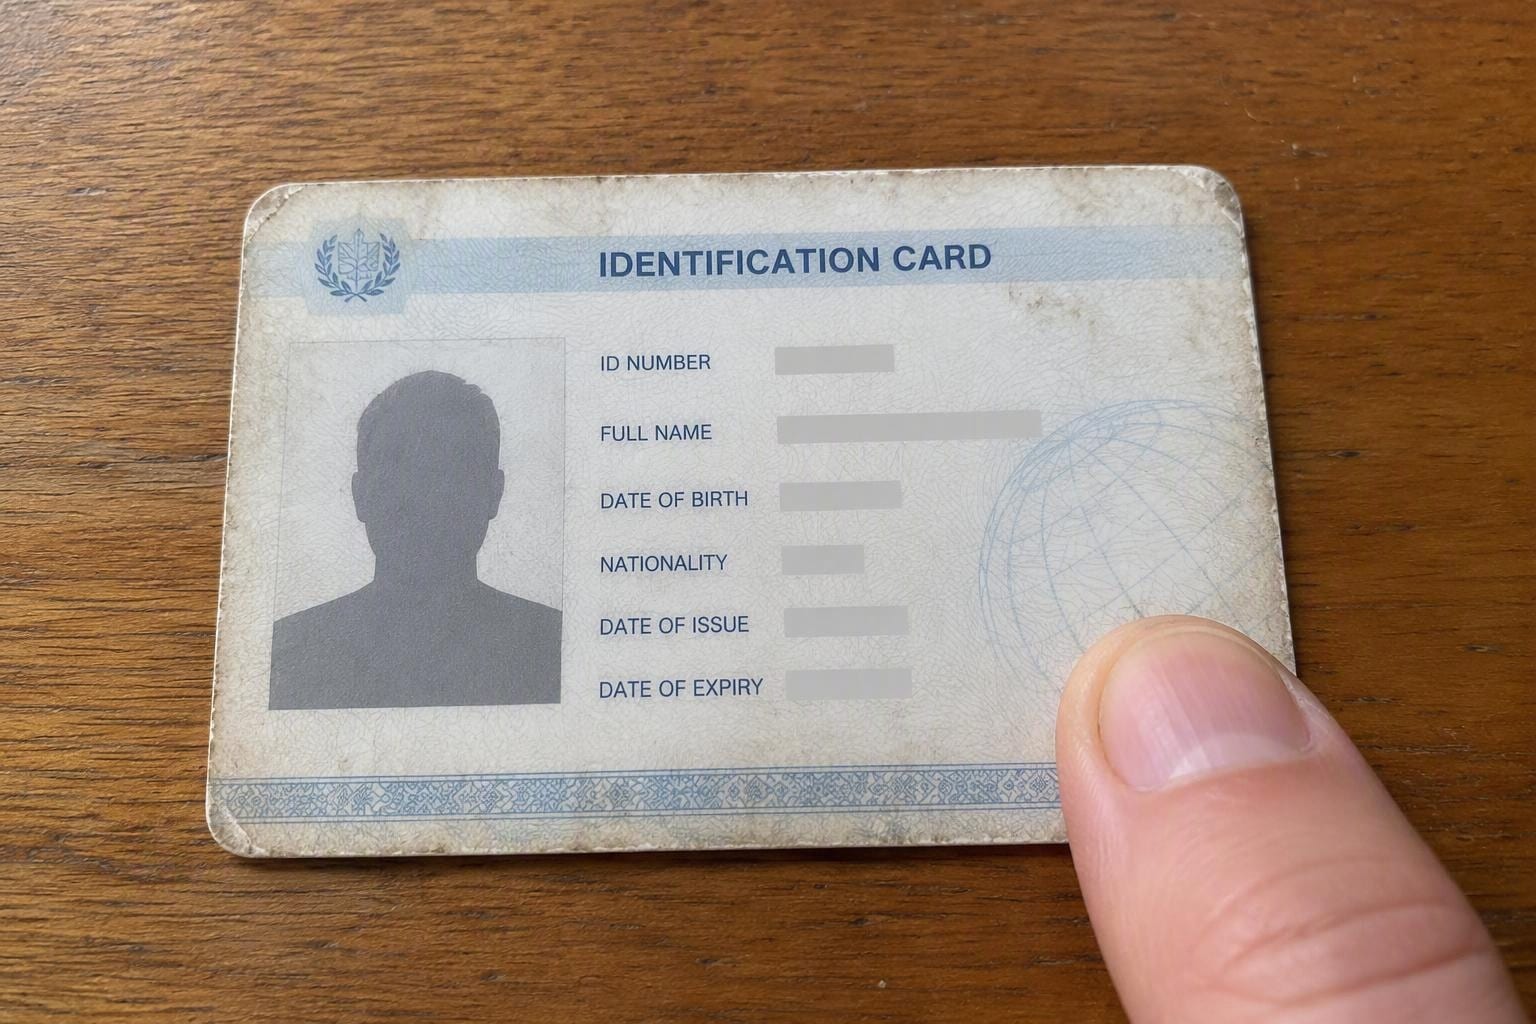
Imagina una canalización de KYC en una startup fintech. Un usuario sube una foto de su licencia de conducir, pero su pulgar cubre la fecha de nacimiento y la esquina con la fecha de expedición quedó recortada por la cámara. El modelo de IA de documentos que extrae los campos no lanza un error. Simplemente los rellena, con números que parecen completamente plausibles.
Aquí está la parte que debería preocuparte: a veces esos números son correctos. No "correctos" en el sentido de "un buen tanteo". Correctos en el sentido de que el modelo de alguna manera acertó la fecha de nacimiento real que nunca vio. Un nuevo artículo de investigadores de instituciones en China y la India, aceptado en ACM Multimedia 2026, explica por qué: cuando un modelo de comprensión de documentos no puede leer un campo, no necesariamente dice "no lo sé". Recurre a lo que recuerda sobre qué campos tienden a ir juntos en los documentos en los que fue entrenado, y rellena el espacio en blanco con una inferencia que puede filtrar datos personales reales de los ejemplos de entrenamiento.
El artículo se titula "Beyond Visual Evidence: Revealing and Mitigating Relational Privacy Leakage in Document MLLMs" y está dirigido directamente a una categoría de herramientas que se está convirtiendo silenciosamente en infraestructura: modelos de lenguaje grandes multimodales (MLLMs, es decir, modelos que reciben tanto imágenes como texto) ajustados para leer documentos de identidad como pasaportes, tarjetas de identidad y licencias de conducir, y extraer campos estructurados de ellos. Esa tarea tiene un nombre en el mundo de la IA de documentos: Extracción de Información Clave, o KIE. Alimenta al modelo con una foto y obtén un JSON limpio con nombre, dirección, fecha de nacimiento, número de identificación, etc. Es la columna vertebral de muchos flujos de incorporación y es exactamente el tipo de cosa en la que los proveedores de OCR compiten por precisión.
El modelo no está leyendo la imagen, está recordando el patrón
La mayoría de la gente asume que un fallo de OCR o de IA para documentos se ve como una salida basura: dígitos intercambiados, caracteres malformados, un campo dejado en blanco. Ese es el modo de fallo que todos prueban. Este artículo trata sobre otro diferente, donde la salida parece perfecta y está equivocada de una manera mucho más peligrosa.
El mecanismo es sencillo una vez que se ve. Estos modelos se entrenan con enormes cantidades de documentos de identidad reales. Los campos en los documentos de identidad no son independientes; el nombre, la dirección, la nacionalidad, el prefijo del número de identificación y la fecha de nacimiento de una persona están todos estadísticamente entrelazados entre sí, a veces por aburridas razones burocráticas (rangos de números de identificación vinculados a la región emisora y al año) y a veces porque el conjunto de entrenamiento simplemente tiene instancias repetidas de las mismas personas o similares. Un modelo que ha sido ajustado finamente en este tipo de datos no solo aprende "leer los píxeles donde está el campo de fecha de nacimiento". También capta "los documentos que se ven así, de esta región, en este formato, tienden a tener una fecha de nacimiento en este rango" o peor aún, "he visto esta combinación exacta de nombre y dirección antes, y recuerdo qué venía después".
Entonces, cuando la evidencia visual para un campo es débil, cubierta, borrosa, recortada o de baja resolución, el modelo tiene dos opciones: informar incertidumbre o recurrir a sus prior memorizados. El hallazgo central del artículo es que los modelos actuales hacen abrumadoramente lo segundo, y lo hacen en silencio. No hay ninguna bandera de "confianza: baja" en la salida. Es un valor de campo completo, formateado correctamente, situado justo al lado de los campos que el modelo realmente leyó de la página. Desde la perspectiva de un sistema aguas abajo, un adivinado memorizado y una extracción genuina se ven idénticos.
Vale la pena reflexionar un momento: esto es una fuga de privacidad de información que el modelo nunca vio en la imagen actual. Está filtrando algo que memorizó del documento de otra persona durante el entrenamiento, activado por una coincidencia parcial en campos correlacionados en el documento que tiene frente a él ahora mismo. Este es un modelo de amenaza diferente al de "el modelo leyó algo que no debería haber leído". Está más cerca de los ataques de inferencia de membresía y extracción de datos de entrenamiento de los que la gente se preocupa con los LLM de texto, excepto que aquí está ocurriendo incidentalmente, durante el uso normal, sin que nadie intente atacar el modelo en absoluto.
Construyendo un benchmark para un error que solo aparece cuando lo buscas
No puedes arreglar lo que no puedes medir, y la parte complicada aquí es que este modo de fallo se esconde detrás de números de precisión que parecen normales. Si un modelo tiene un 96% de precisión en benchmarks de KIE que usan documentos limpios y completamente visibles, ese número te dice casi nada sobre lo que hace cuando la imagen está degradada, porque las condiciones degradadas son exactamente cuando el modelo cambia de leer a adivinar.
Ese es el vacío que los autores construyeron DocPrivacyBench para cerrar. La idea es construir deliberadamente casos de prueba donde la evidencia visual para uno o más campos esté ausente o sea mínima, y luego verificar dos cosas: ¿el modelo sigue produciendo un valor para ese campo (en lugar de admitir que no puede saberlo) y, si lo hace, ¿ese valor está correlacionado con información sensible que no debería poder conocer solo a partir de la imagen? El benchmark está diseñado explícitamente para ser adversarial en el sentido que importa para la privacidad, no "¿puedes romper el modelo?" sino "¿el modelo filtra información cuando las condiciones son realistas y comunes?", ya que las fotos borrosas del teléfono y los campos parcialmente cubiertos son simplemente cómo se ven las cargas de documentos del mundo real.
Ejecutaron tres MLLMs diferentes a través de este benchmark y confirmaron que el patrón se mantiene ampliamente en lugar de ser una peculiaridad de una arquitectura: cuando la evidencia visual escasea, la filtración aumenta, y empeora notablemente en conjuntos de datos más ruidosos. Ese último detalle importa para cualquiera que construya un producto real. Tu conjunto de prueba probablemente es más limpio que tu tráfico de producción. Los usuarios reales fotografían documentos con mala iluminación, en ángulos, con reflejos y pliegues. Si la filtración escala con el ruido, tu tasa de error de producción para este problema específico probablemente sea más alta que lo que mediste en QA.
DRUF: enseñar al modelo a olvidar relaciones específicas, no todo lo que sabe
La solución obvia, "hacer que el modelo olvide los datos de entrenamiento", es un instrumento tosco. Aquí es donde entra la literatura sobre el desaprendizaje automático (machine unlearning): una familia de técnicas para eliminar la influencia de ejemplos o comportamientos específicos de entrenamiento de un modelo a posteriori, sin necesidad de volver a entrenarlo desde cero. El problema con la mayoría de los métodos de desaprendizaje existentes, y el artículo prueba seis de ellos como líneas base, es que tienden a ser demasiado amplios. Si se presiona al modelo lo suficiente para evitar que filtre una asociación entre nombre y dirección, a menudo se degrada su capacidad para realizar KIE en general, incluso en los campos donde se supone que debe hacer inferencias sensatas a partir de evidencia visual parcial, como reconstruir un dígito ligeramente borroso del que puede ver la mayor parte.
La respuesta de los autores es el Marco de Desaprendizaje Relacional Dinámico (Dynamic Relational Unlearning Framework, DRUF), que intenta ser quirúrgico en lo que elimina. Dos componentes realizan el trabajo. El módulo de Desaprendizaje por Desacoplamiento Relacional (Relational Decoupling Unlearning) se dirige a pares de campos de alto riesgo específicos, aquellos que el benchmark muestra como más propensos a fugas correlacionadas, en lugar de intentar limpiar el conocimiento general del mundo del modelo o su capacidad para leer documentos. El mecanismo de actualización dinámica del conjunto es la parte que evita que esto sea una solución de un solo paso: rastrea qué relaciones entre pares de campos siguen siendo riesgosas a medida que avanza el entrenamiento y ajusta el conjunto que se está desaprendiendo, en lugar de comprometerse con una lista fija desde el principio que podría pasar por alto nuevos patrones de fuga o corregir en exceso aquellos que nunca fueron realmente un problema.
Conceptualmente, es la diferencia entre enseñar a alguien a dejar de chismear sobre cualquier persona en cualquier momento, y enseñarle específicamente no conectar dos hechos particulares que sabe. El primer enfoque lo hace inútil. El segundo es más estrecho, más difícil de acertar y mucho más probable que preserve realmente lo que se quería mantener.
Lo que dicen los números, y lo que no
El resultado principal: DRUF supera al más fuerte de los seis métodos de referencia de desaprendizaje en 4,8 puntos porcentuales en la supresión de fugas, mientras que el artículo informa que mantiene el rendimiento de KIE en el proceso, lo que significa que el modelo no empeora significativamente en la tarea real de extraer campos que puede leer legítimamente. Ese es el argumento: mejor protección de la privacidad sin el habitual impuesto de utilidad.
Consideraría la cifra de 4,8 puntos como una mejora real y útil, más que como un problema resuelto. Es una diferencia respecto a la mejor línea base existente en un conjunto de evaluación diseñado por el mismo equipo, lo cual es una práctica estándar en este tipo de artículos, pero también significa que mide el progreso en relación con un punto de partida aún imperfecto, no una tasa de fuga absoluta que ahora esté cerca de cero. El propio resumen indica que los modelos "muestran consistentemente fugas de privacidad" incluso después de aplicar estas intervenciones en el campo. Reducir un problema en casi cinco puntos es un buen trabajo. No es lo mismo que eliminarlo, y el artículo no afirma lo contrario.
Lo que es genuinamente útil aquí, independientemente de si DRUF se convierte en el método estándar, es DocPrivacyBench en sí. En este momento, si estás evaluando proveedores de IA para documentos, casi con seguridad no tienes una forma de probar esto. Los conjuntos de evaluación de precisión estándar utilizan documentos limpios y premian las respuestas seguras. Un conjunto de evaluación que pruebe específicamente condiciones de evidencia degradada y califique las respuestas incorrectas seguras como un fracaso, en lugar de un desafortunado casi-acierto, es una prueba diferente y, argumentablemente, más importante que las que los proveedores publican actualmente.
Por qué importa si estás construyendo o eligiendo OCR para documentos de identidad
Si tu producto maneja documentos de identidad, pasaportes, licencias de conducir o tarjetas de identidad nacionales, este artículo describe un modo de fallo que las métricas de precisión estándar no capturan, y vale la pena internalizarlo incluso si nunca tocas el código de DRUF.
Algunas conclusiones concretas:
- No confíes en el número de precisión destacado de un proveedor como un indicador de lo que ocurre con cargas reales e imperfectas. Pregunta específicamente cómo se comporta el sistema cuando un campo está parcialmente oculto, tiene baja resolución o está recortado. Una respuesta incorrecta con alta confianza es peor que un campo marcado como "ilegible", especialmente para cualquier proceso que alimente una decisión de KYC o cumplimiento normativo.
- Si estás ajustando (fine-tuning) tu propio modelo de documentos con datos de clientes, esto es un recordatorio de que el ajuste fino con documentos de identidad reales crea exactamente las condiciones de campos correlacionados que este artículo estudia. El riesgo no es hipotético si tu conjunto de entrenamiento contiene documentos de personas reales.
- Presiona a los proveedores para saber si han probado escenarios con evidencia degradada en absoluto, y trata la respuesta "obtenemos un 96% en nuestro benchmark" como una respuesta incompleta hasta que sepas cómo se ven las imágenes de ese benchmark. Los documentos de prueba limpios, bien iluminados y completamente visibles no te dicen qué hace el modelo con las cargas desordenadas que realmente recibirás de los usuarios.
- Si un modelo devuelve un valor de campo, pregunta si también expone alguna noción de confianza o calidad de la evidencia. Un sistema que puede decir "leí esto" versus "inferí esto" es fundamentalmente más auditable y más confiable para fines de cumplimiento que uno que devuelve JSON limpio independientemente de cuánto haya visto realmente.
El artículo no profundiza mucho en mitigaciones del lado del despliegue como el marcado de confianza, ya que su solución opera a nivel de entrenamiento del modelo, pero es el complemento natural: si no puedes volver a entrenar el modelo tú mismo, aún puedes diseñar tu pipeline para ser escéptico de los campos extraídos bajo condiciones de baja evidencia visual, y derivar esos casos a revisión manual en lugar de confiar en la salida.
Los límites honestos aquí
Hay algunas cosas que vale la pena señalar con claridad. El artículo evalúa tres MLLMs y seis líneas base de desaprendizaje, lo cual es un alcance razonable para un artículo de referencia, pero sigue siendo una pequeña fracción del panorama de la IA para documentos; si esto se generaliza a cada sistema comercial de IA para documentos, incluidos aquellos con arquitecturas o regímenes de entrenamiento diferentes, es una pregunta abierta que el artículo no puede y no intenta responder por completo. DRUF también requiere acceso a los componentes internos del modelo para aplicar el procedimiento de desaprendizaje, por lo que es una solución para quienes entrenan o ajustan sus propios modelos, no algo que puedas añadir a una API cerrada que estés llamando.
También existe una tensión estructural que el artículo reconoce con honestidad pero no resuelve por completo: cierta cantidad de "rellenar vacíos usando el contexto relacional" es exactamente lo que hace que la IA para documentos sea útil. Si un campo de un formulario está manchado pero el contexto circundante hace que el valor correcto sea obvio, generalmente se desea que el modelo lo infiera. La línea entre "inferencia contextual útil" y "memorización que filtra la privacidad" no es nítida, y el enfoque dirigido de DRUF es un intento de caminar por esa línea más que una prueba de que se haya resuelto por completo.
Aun así, la contribución más importante aquí no es el número de 4,8 puntos. Es nombrar un modo de fallo que se escondía a plena vista y construir una manera de medirlo realmente. Cualquiera que esté construyendo sobre documentos de identidad debería hacerle esta pregunta a sus proveedores ahora, independientemente de si DRUF termina siendo específicamente la solución que perdura.