Por qué fotografiar un documento aún rompe la mayoría de los modelos de OCR
Basado en: NaviDC-OCR: Navigating Document Parsing Across Digital and Camera-Captured Documents — Peng Cai, Zhaofan Zou, Shifa Liu, Yikun Wang, Jiawei Tang, Kaicheng Yang, Meng Tong, MingKun Jiang, Zhongjiang He, Hao Sun
Saca tu móvil ahora mismo y haz una foto a un recibo que tengas sobre el escritorio. No lo escanees, fótalo, como harías para un informe de gastos o una aplicación de impuestos. Mira el resultado: el papel se curva ligeramente en los bordes, una esquina está un poco más cerca del objetivo que la otra, y el texto cerca del pliegue se inclina lo justo para romper una línea recta. Nada de eso parece roto a tus ojos. Para la mayoría de los sistemas de OCR, es un campo minado.
Esa brecha entre "documentos escaneados en un laboratorio" y "documentos fotografiados en la vida real" es el problema que aborda de frente un nuevo artículo llamado NaviDC-OCR. El nombre significa Navigating Document Parsing Across Digital and Camera-Captured Documents, y el equipo (investigadores de una mezcla de laboratorios de IA chinos, según las afiliaciones) construyó un único modelo diseñado para manejar bien ambos casos, en lugar de degradarse silenciosamente en el momento en que un documento deja de ser plano y perfectamente iluminado.
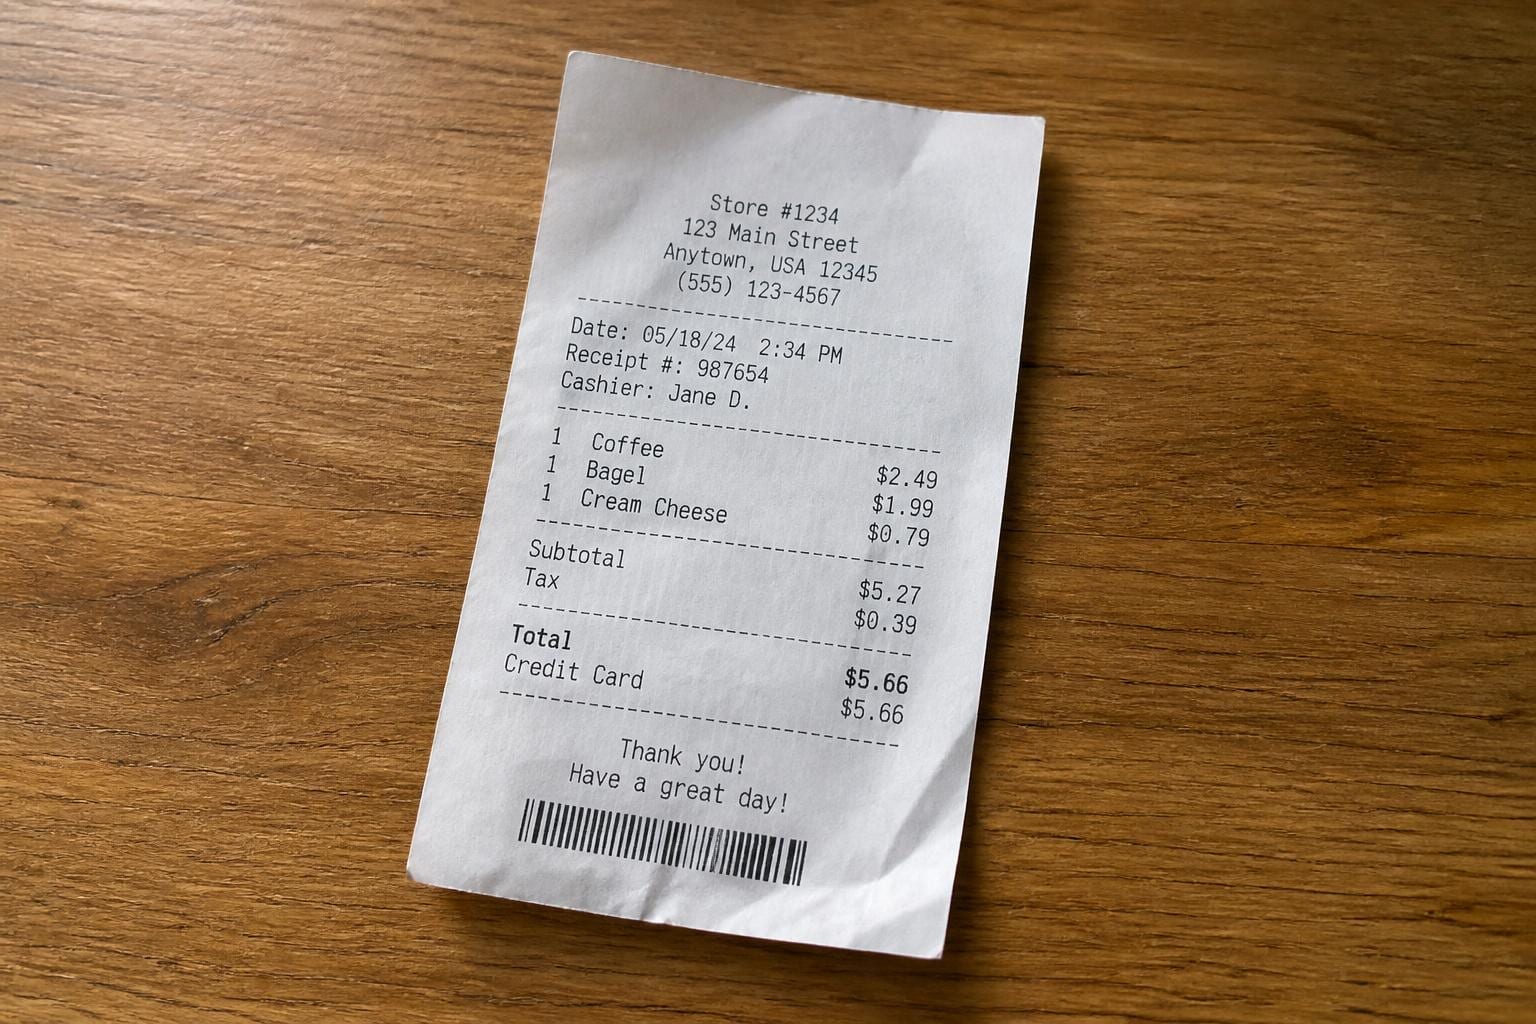
Dos formas de construir un analizador de documentos y por qué ambas tienen un inconveniente
El análisis moderno de documentos, la tarea de convertir una imagen de página en texto estructurado, tablas y fórmulas que un ordenador pueda utilizar realmente, sigue principalmente uno de dos enfoques.
El primero es lo que el artículo denomina el enfoque desacoplado. Primero se ejecuta el análisis de diseño: se encuentran los bloques de texto, las tablas y las figuras, se dibujan recuadros alrededor de ellos y luego cada recuadro se alimenta a un modelo de reconocimiento para extraer el contenido real. Es una división limpia del trabajo y funciona bien cuando la entrada es un escaneo plano. El inconveniente aparece con las fotos de cámara. Si una página está deformada, inclinada o parcialmente en sombra, el detector de diseño dibuja los recuadros incorrectos y cada paso posterior hereda ese error. Una fila de tabla ligeramente curva se recorta en dos recuadros; un párrafo que se curva alrededor de un lomo se divide en el lugar incorrecto. Si la geometría es incorrecta en el primer paso, nada posterior puede recuperarla por completo.
El segundo enfoque es de extremo a extremo: omitir la detección explícita de diseño y permitir que un único modelo de visión-idioma (un VLM, una red neuronal que toma una imagen y produce texto, la misma familia que los modelos detrás de la comprensión de imágenes de los chatbots modernos) lea toda la página y genere salida estructurada directamente. Esto evita el problema de errores en cascada, pero lo intercambia por otro diferente. A alta resolución, estos modelos tienden a divagar: repitiendo líneas, inventando contenido que no está en la página (alucinación) o perdiendo el rastro de dónde están en un diseño denso. Si se alimenta a un modelo una página completa de un artículo de dos columnas con una fórmula en línea y una tabla, no siempre sabe dónde termina una sección y comienza la siguiente.
Ambos modos de fallo provienen de la misma causa raíz: el texto en una página no son solo caracteres, son caracteres situados dentro de una estructura geométrica, y esa estructura se vuelve más difícil de leer en el momento en que la realidad interfiere con ella.
Enseñando al modelo cómo se ve realmente lo "deformado"
La primera corrección de NaviDC-OCR es algo que el artículo denomina aprendizaje consciente de la deformación. La idea es entrenar explícitamente al modelo para que perciba la distorsión geométrica, el curvado, la inclinación y la distorsión de perspectiva, ese tipo de alteraciones que introduce una fotografía tomada con cámara y que un escáner de cama plana nunca produce, en lugar de esperar que el modelo las capture como un efecto secundario de haber visto suficientes fotografías.
Piense en la diferencia entre una persona que solo ha leído páginas impresas colocadas planas bajo cristal, y otra que ha pasado años leyendo libros sostenidos en ángulos extraños dentro de un autobús. La segunda persona ha desarrollado una intuición para reconocer que "esta línea es en realidad recta, solo parece curva debido a cómo se dobla la página". Ese es el tipo de conocimiento previo que NaviDC-OCR intenta incorporar directamente, en lugar de dejarlo al azar.
La segunda pieza es un mecanismo de muestreo adaptativo para diseños complejos. Las imágenes de documentos de alta resolución son costosas de procesar en todo su detalle, por lo que la mayoría de los VLM (Modelos de Lenguaje Visual) reducen la resolución o dividen la imagen en bloques antes de alimentarla al modelo. Una cuadrícula uniforme trata una tabla densa y un margen amplio de la misma manera, lo que desperdicia resolución en espacios en blanco y priva de recursos a las partes que realmente la necesitan. El muestreo adaptativo, en cambio, asigna más atención a las regiones visualmente complejas, como tablas, fórmulas y texto apretado en varias columnas, y menos a las simples. Es el equivalente visual de hojear un informe: no lee el espacio en blanco a la misma velocidad que la hoja de cálculo enterrada en la página 12.
Las fórmulas y las tablas no son solo texto con una forma inusual
La tercera contribución aborda un problema que suele complicar a muchos sistemas de OCR de extremo a extremo: las fórmulas y las tablas no son prosa. Una fórmula tiene gramática, en el sentido de que la disposición de los símbolos codifica significado; una barra de fracción significa algo estructuralmente diferente a un superíndice. Una tabla tiene filas, columnas y celdas fusionadas que definen relaciones entre valores, no solo una secuencia de caracteres.
Los modelos entrenados principalmente con texto continuo tienden a tratar estos elementos como texto de difícil lectura y generan resultados plausibles pero incorrectos cuando se confunden: un exponente equivocado, un decimal desplazado, una celda de tabla que se fusiona silenciosamente con su vecina. La respuesta de NaviDC-OCR es el aprendizaje desacoplado de contenido y estructura: entrenar al modelo para razonar por separado sobre la estructura (esta es una tabla de 4x6, esta es una fracción con este numerador y denominador) y el contenido (cuáles son los caracteres reales), en lugar de mezclar ambos en una sola tarea de generación. Es un poco como separar "qué forma tiene este edificio" de "qué está escrito en el letrero de la entrada", en lugar de pedirle a una sola mirada que responda ambas cosas a la vez.
Qué muestran realmente las cifras de los benchmarks
El artículo informa puntuaciones en tres benchmarks: 96,87 en OmniDocBench v1.6, 88,53 en Wild-OmniDocBench y 78,41 en PureDocBench. También afirma haber obtenido el primer lugar en el ICDAR 2026 Sci-ImageMiner Challenge, una pista de competición internacional para el análisis de documentos e imágenes científicas.
OmniDocBench es un benchmark bien establecido que cubre una amplia mezcla de tipos de documentos, como artículos académicos, libros de texto, exámenes e informes financieros, y evalúa tanto la detección de diseño como el reconocimiento de texto de manera conjunta. Una puntuación en la alta gama de los 90 allí significa que el modelo funciona muy bien con el tipo de documentos que se asemejan a la distribución de entrenamiento para la que están optimizados la mayoría de los analizadores.
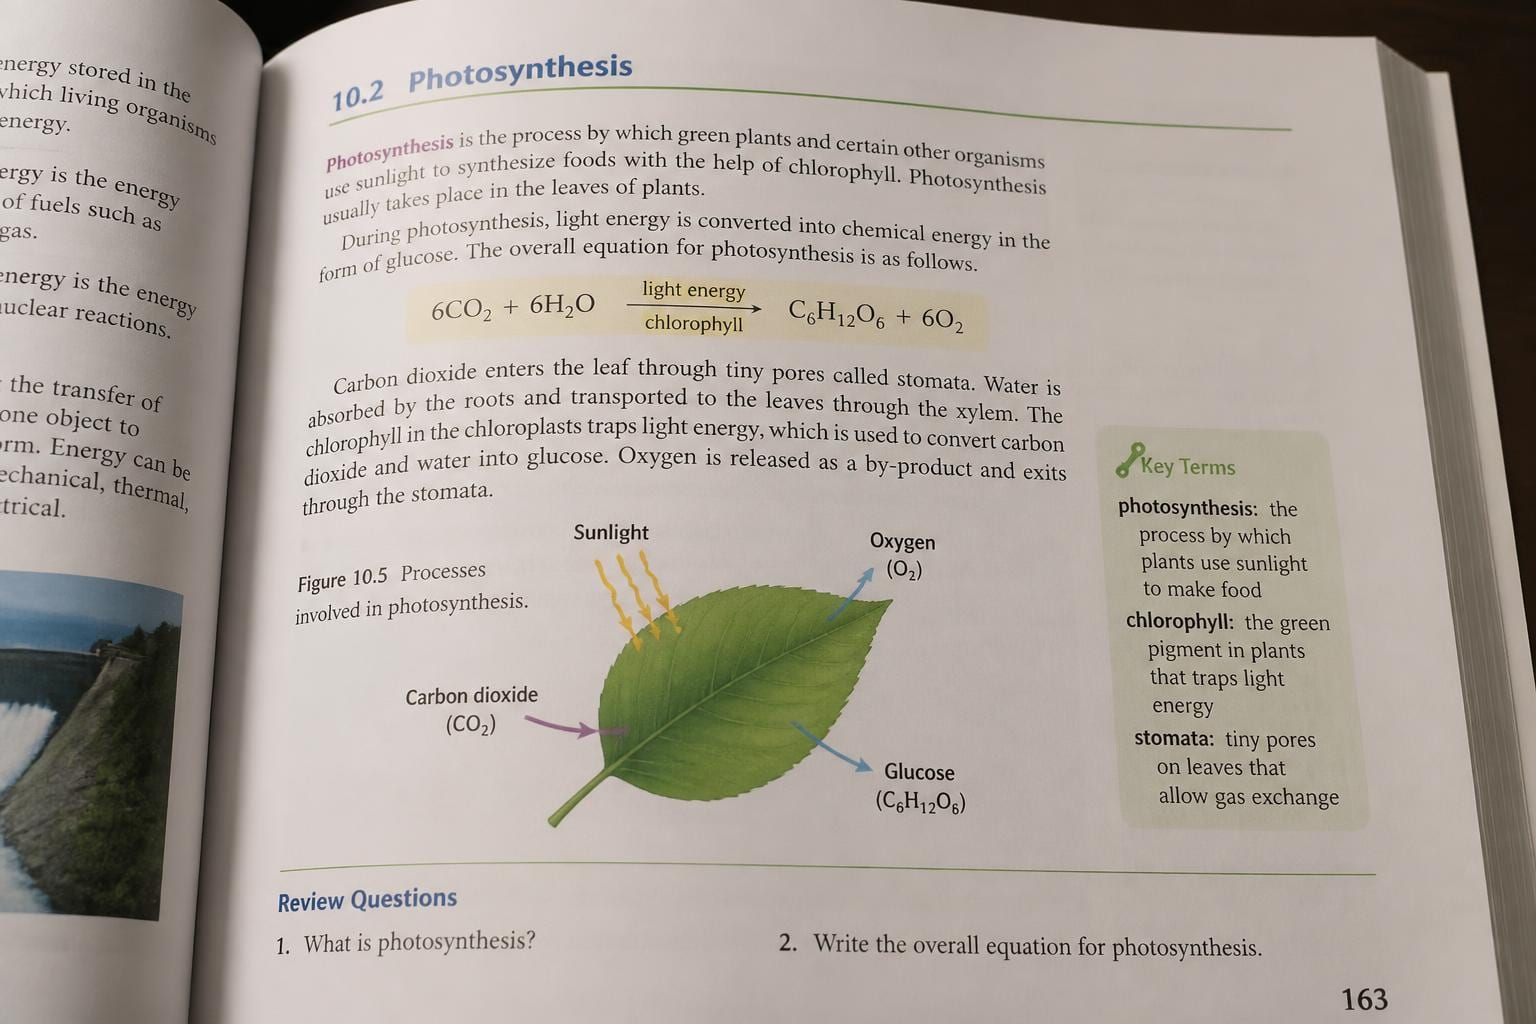
El dato interesante es la caída a 88,53 en Wild-OmniDocBench. Dado el nombre y el enfoque declarado del artículo en documentos capturados por cámara, esto es casi con certeza la variante más difícil de fotos del mundo real: recibos enrollados, páginas de libros tomadas desde ángulos oblicuos e iluminación inconsistente, en los que los pipelines de diseño desacoplados suelen fallar. Una brecha de ocho puntos entre el benchmark limpio y el "salvaje" te dice algo que las cifras destacadas del resumen no reflejan: incluso un modelo diseñado específicamente para este problema pierde terreno cuando la entrada se vuelve desordenada. Eso no es una crítica al artículo, sino una señal honesta sobre lo mucho más difícil que es realmente el caso de captura con cámara, y vale la pena recordarlo la próxima vez que un vendedor afirme un "OCR a nivel humano" basándose únicamente en un benchmark de documentos escaneados.
PureDocBench es el que no puedo explicar completamente a partir del resumen. El nombre sugiere documentos limpios y sin distorsión, lo que hace que la puntuación más baja (78,41, por debajo incluso del benchmark "salvaje") sea genuinamente sorprendente si esa interpretación es correcta. Es posible que PureDocBench apunte a un tipo de dificultad completamente diferente, como diseños científicos más densos, fórmulas y tablas más complejas, en lugar de distorsión. Sin tener a mano las descripciones de los benchmarks del artículo completo, trataría esa cifra como una bandera para investigar más en lugar de un hecho establecido, y querría ver qué tipos de documentos componen realmente ese conjunto antes de sacar conclusiones de él.
Por qué importa para quien construye o elige un pipeline de OCR
Si estás construyendo un producto que ingiere documentos de usuarios, facturas fotografiadas con un móvil, DNI escaneados en ángulo, recibos enviados a través de una app móvil, la distinción entre enfoques desacoplados y end-to-end de este artículo no es académica. Explica un modo de fallo que probablemente ya hayas visto: un parser que funciona de maravilla en tu suite de pruebas con PDFs limpios y se desmorona en el momento en que los usuarios reales comienzan a subir fotos de sus móviles.
Algunas conclusiones prácticas:
- Prueba con fotos de cámara, no solo con escaneos. Si tu conjunto de evaluación son todos escaneos de mesa o exportaciones de PDF limpios, estás midiendo el caso fácil. La brecha entre OmniDocBench y Wild-OmniDocBench en este artículo (96,87 frente a 88,53) es un proxy razonable de cuánto rendimiento deberías esperar perder con entradas del mundo real.
- Vigila los errores en cascada del layout específicamente. Si usas un pipeline desacoplado (detección de layout, luego reconocimiento), una tabla ilegible o un párrafo faltante suele ser un bug de layout disfrazado de error de reconocimiento. Depura las cajas antes de depurar el texto.
- Los documentos con muchas fórmulas y tablas necesitan un escrutinio más allá de la inspección visual. Un modelo puede producir una tabla que parece correcta a primera vista pero tiene un mapeo fila-columna sutilmente incorrecto, exactamente el fallo que el desacoplamiento estructura-contenido pretende reducir. Si tu caso de uso implica tablas financieras o fórmulas científicas, verifica la estructura, no solo la legibilidad.
- Las métricas de benchmark de cualquier artículo único son un punto de partida, no una decisión de compra. Aquí no hay notas de lanzamiento que expliquen la composición de los datos de entrenamiento, el coste de inferencia o el tamaño del modelo, todo lo cual importa mucho si estás eligiendo entre este tipo de modelo y un pipeline más ligero para un sistema en producción con restricciones de latencia.
Qué sigue sin estar claro
El resumen no menciona el tamaño del modelo, la velocidad de inferencia ni si se liberarán los pesos o el código, aspectos que importan enormemente si estás decidiendo si construir sobre esto en lugar de un sistema de OCR más pequeño, más barato y ya disponible. Un VLM (modelo de lenguaje visual) de última generación que tarda varios segundos por página y necesita una GPU potente es una propuesta muy diferente a algo que puedes ejecutar a escala en hardware comercial.
También está la advertencia habitual con cualquier artículo basado en benchmarks: las afirmaciones de estado del arte se miden contra los benchmarks que los autores eligieron, y no siempre está claro cómo se construyeron esos benchmarks o si capturan los tipos de documentos específicos que te interesan. El resultado de PureDocBench en particular merece una mirada más cercana antes de que nadie trate estas cifras como la palabra final sobre qué tan bien generaliza esto.
Aun así, la idea central aquí es sólida y vale la pena prestarle atención independientemente de cómo se mantengan las cifras específicas bajo escrutinio: el análisis de documentos se ha optimizado silenciosamente durante años para entradas limpias, planas y bien iluminadas, mientras que una gran parte de la captura de documentos en el mundo real ocurre a través de la cámara de un teléfono en condiciones de luz imperfectas. Un modelo que trata la distorsión geométrica como algo que aprender en lugar de algo que preprocesar está apuntando al problema correcto. Si es el modelo que realmente se implementa en tu flujo de trabajo es una pregunta separada, una que vale la pena probar tú mismo con tus propios documentos desordenados, reales y fotografiados, en lugar de tomar la palabra de una tabla de benchmarks.