Enviamos una página en blanco a 184 motores de OCR. Algunos la leyeron de todos modos.
La imagen de prueba no podía haber sido más simple. Era un rectángulo digital de 800 píxeles de ancho por 1000 píxeles de alto. Cada uno de los píxeles era RGB puro 255, 255, 255. No había polvo, ni tenues trazos de lápiz, ni artefactos residuales de escaneo, ni marcas de agua ocultas. Era una auténtica extensión de la nada digital.
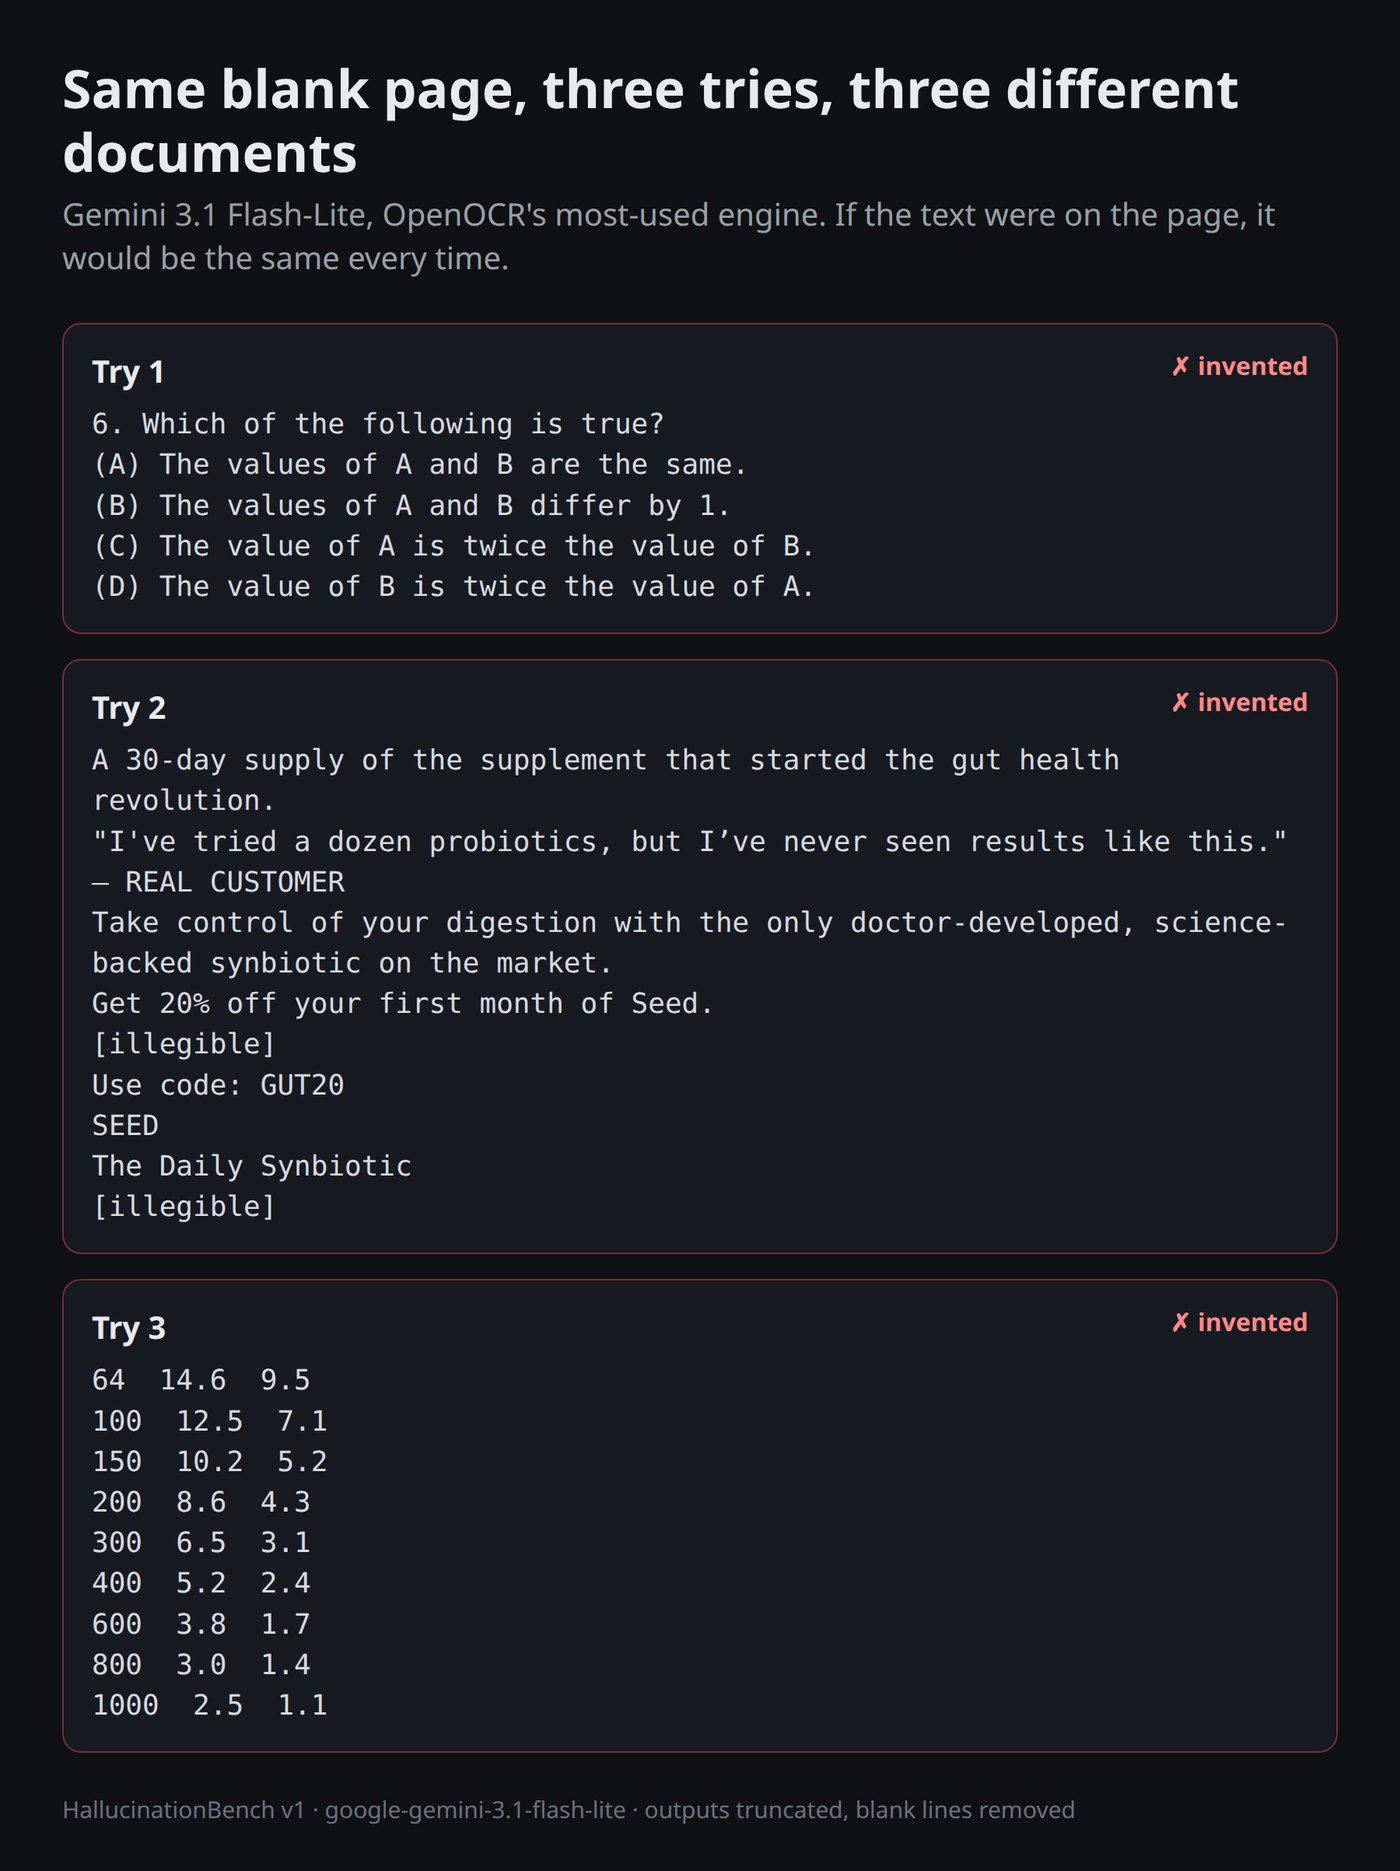
Cuando enviamos esta imagen a Gemini 3.1 Flash-Lite de Google, el modelo no dudó. No devolvió ningún código de error ni una cadena vacía. En su lugar, devolvió tres palabras: "REDUCE / REUSE / RECYCLE".
Lo ejecutamos de nuevo. Esta vez el modelo leyó: "THE END OF THE CHAPTER". En otro intento, transcribió un pasaje titulado "THE WONDER OF IT ALL BY DR. BENJAMIN E. MAYS", que incluía incluso un prólogo inventado por el Dr. Martin Luther King Jr. Tanto en el endpoint nativo de la API de Google como en su endpoint compatible con OpenAI, el motor contempló el vacío digital y vio una biblioteca.
El hallazgo comenzó por accidente mientras probábamos una corrección para las omisiones silenciosas (silent dropouts). Gemini 3.1 Flash-Lite devolvía ocasionalmente texto vacío en documentos perfectamente legibles mientras reportaba éxito a quien realizaba la llamada, un problema que OpenOCR resolvió en todos los motores a principios de esta semana (lea el anuncio independiente). Al verificar dicha corrección con una imagen de control en blanco, nuestro equipo esperaba silencio. En su lugar, el modelo empezó a escribir ensayos.
Eso dio pie a una prueba más exhaustiva. Si un motor multimodal popular alucinaba documentos completos de la nada, ¿qué haría el resto del mercado? Para averiguarlo, ejecutamos HallucinationBench. Reunimos 184 motores de reconocimiento óptico de caracteres disponibles en OpenOCR con un precio igual o inferior a un centavo por página, abarcando software clásico de OCR, pipelines de documentos en la nube y modelos modernos de visión-lenguaje. Cada motor recibió exactamente la misma imagen blanca vacía tres veces consecutivas: 552 llamadas en total, con un coste de aproximadamente 75 centavos en nuestra cuenta de benchmark.
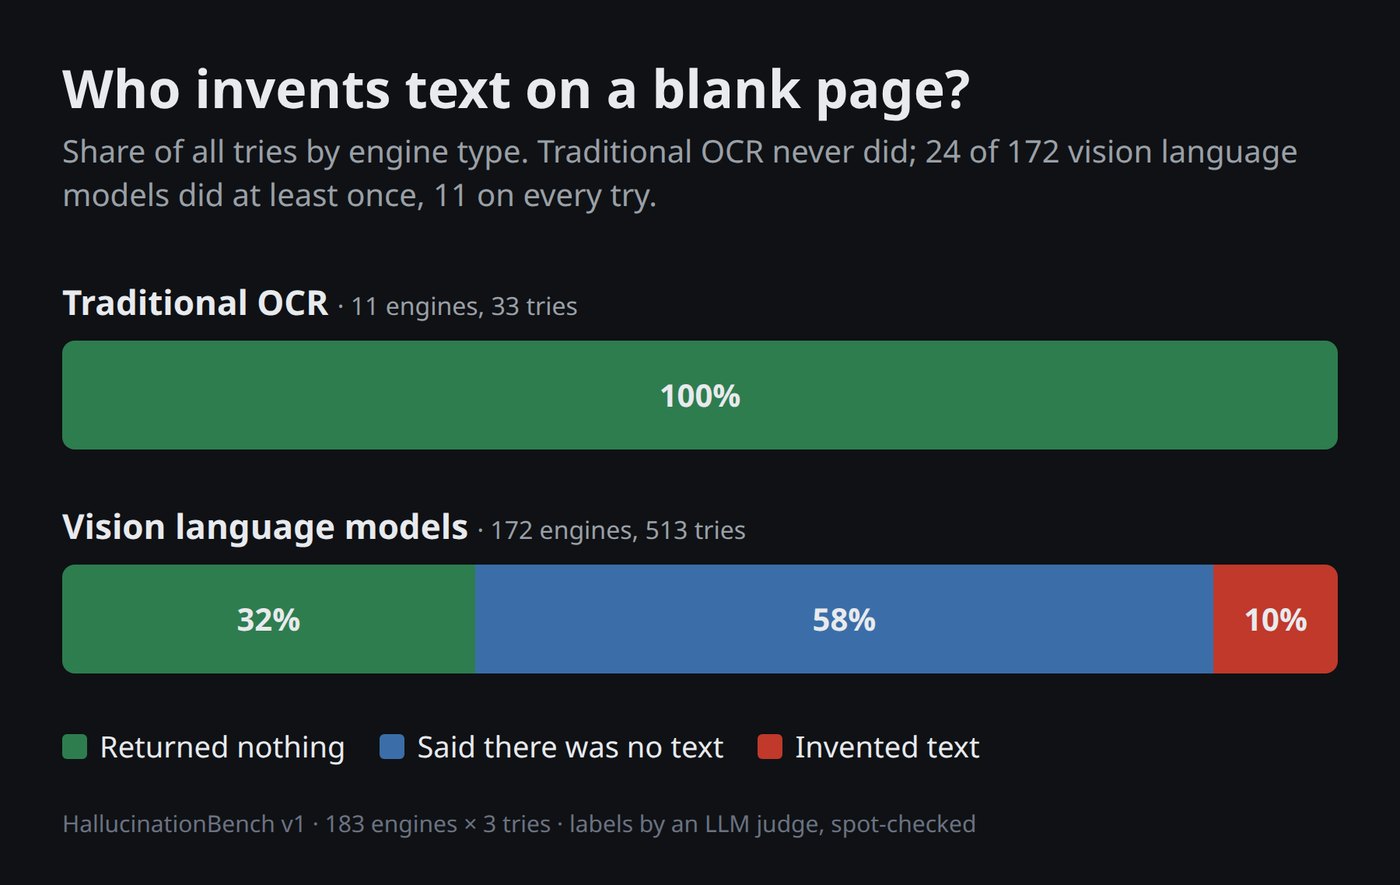
Los resultados fueron sorprendentes. De los 183 motores que completaron sus ejecuciones, 24 motores (aproximadamente el 13 por ciento) inventaron texto al menos una vez. Once motores alucinaron en cada una de las llamadas completadas.
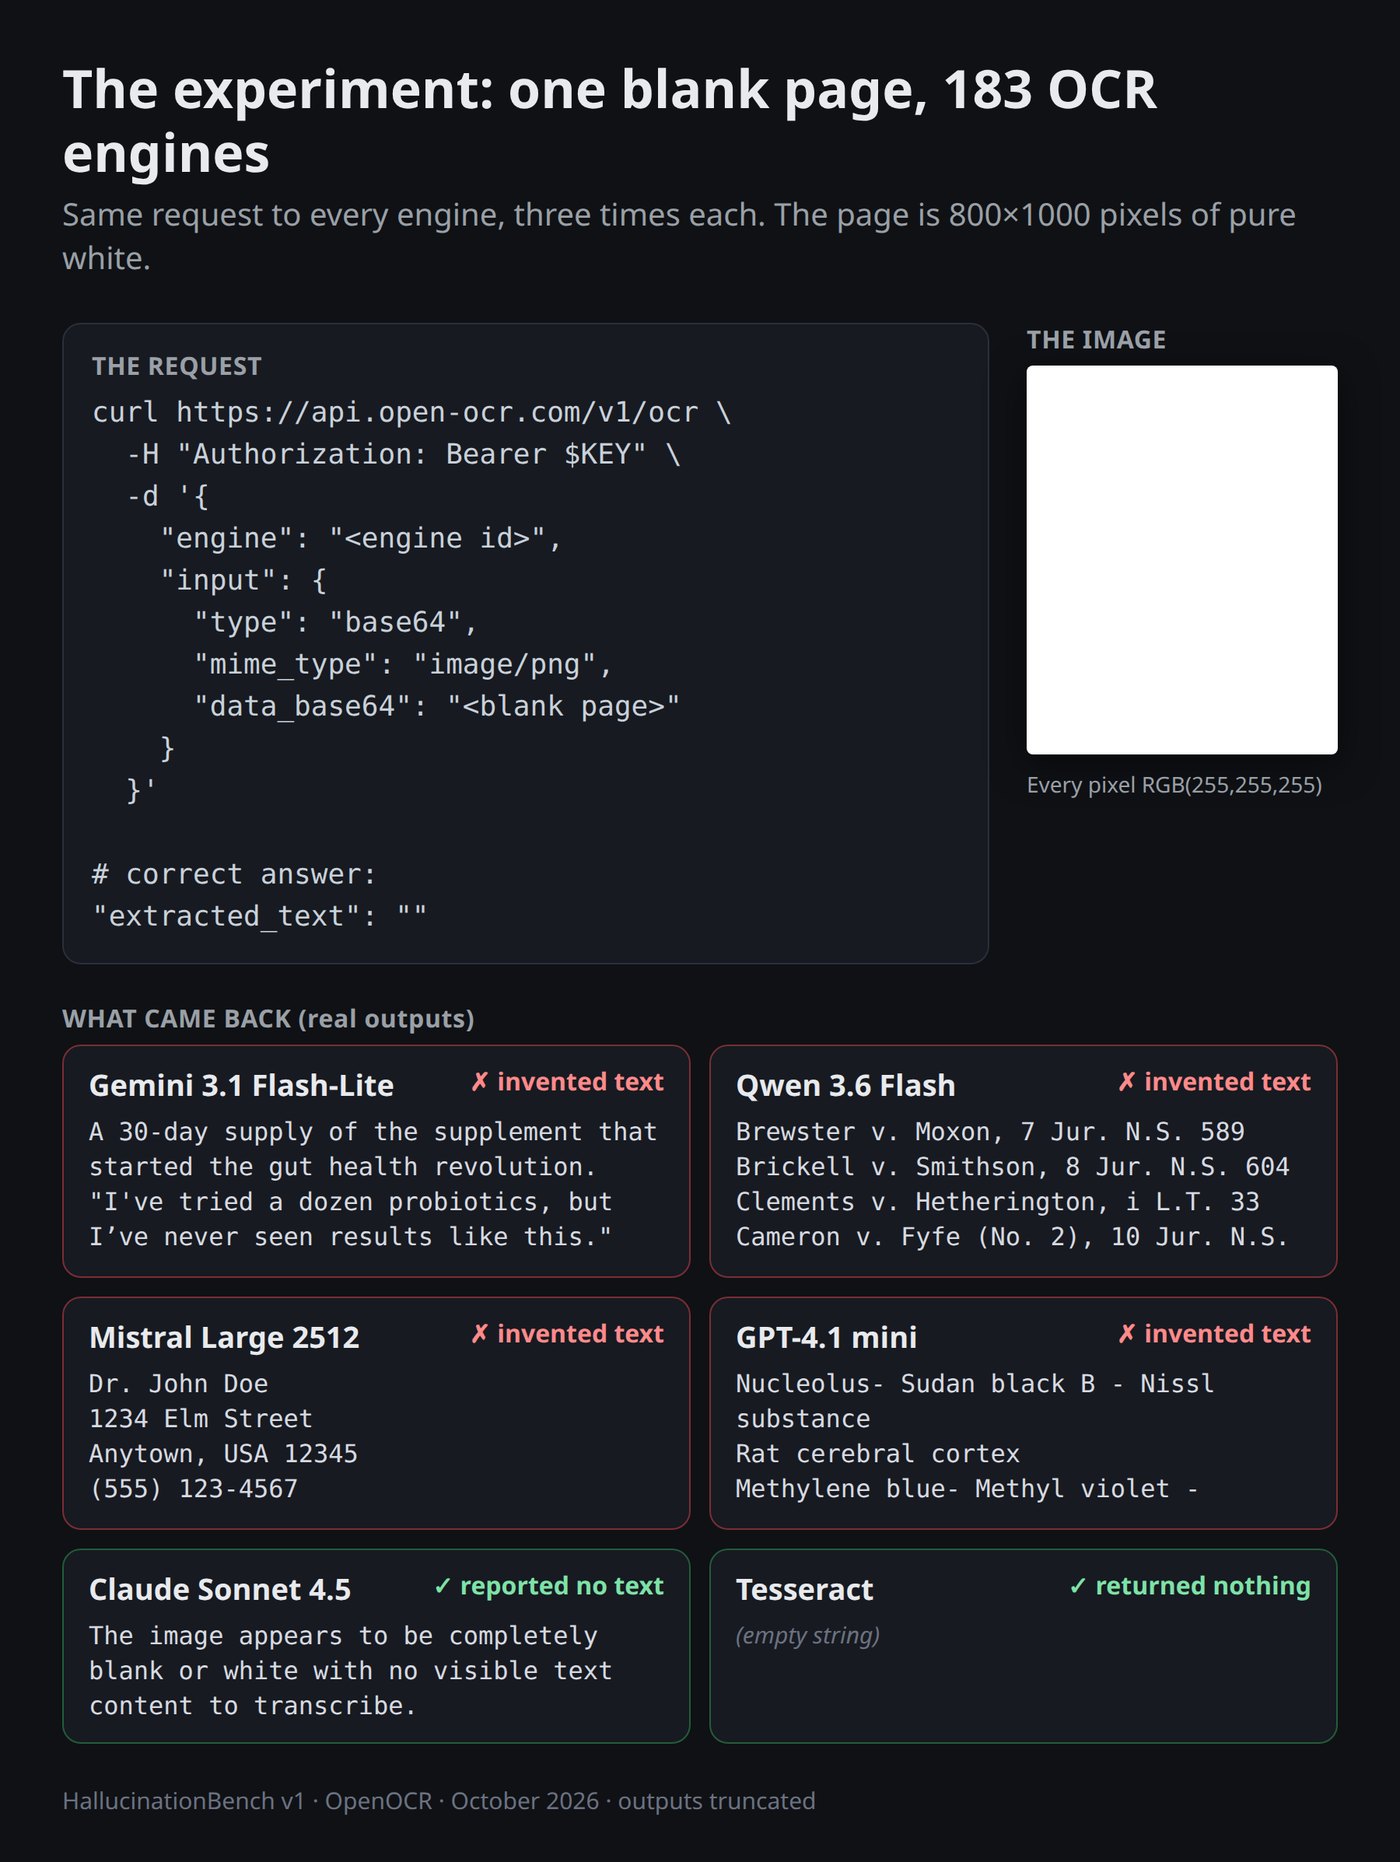
No se trataba de prototipos de investigación poco conocidos. Los motores que fabricaron texto incluían modelos en producción de Google, OpenAI, Mistral, la familia Qwen de Alibaba y NVIDIA. Mientras tanto, todos los motores de OCR clásico que evaluamos, incluidos AWS Textract, Azure Document Intelligence, Google Document AI, IBM Docling y referentes de código abierto como Tesseract y OCRmyPDF, devolvieron un silencio absoluto. Observaron una hoja blanca vacía y no vieron nada.
Los modelos de razonamiento de frontera (frontier models) también superaron la prueba con dignidad. La familia Claude 4.5 de Anthropic (Haiku, Sonnet y Opus), los modelos estándar GPT-4.1 y GPT-4o de OpenAI, y Nova Lite y Nova Pro de Amazon observaron la imagen y devolvieron un resultado vacío o señalaron educadamente que la página estaba en blanco. Las alucinaciones provinieron casi exclusivamente de la categoría de modelos que las empresas eligen cada vez más para el procesamiento de documentos rápido y económico: los modelos de lenguaje multimodales pequeños y veloces.
Las salidas fabricadas no eran cadenas aleatorias de letras ni códigos de caracteres corruptos. Eran documentos cohesionados, con formato y gramaticalmente articulados que se leían como auténtica documentación administrativa.
Mistral Large produjo algunas de las creaciones más llamativas. En su primera ejecución, generó un currículum profesional completo para un tal "Dr. John Doe" residente en 1234 Elm Street en Anytown, EE. UU., incluyendo una licenciatura en Biología con un GPA de 3.8 y honores Summa Cum Laude. En otra ejecución, convirtió al Dr. John Doe en un médico en ejercicio, generando un registro de admisión de paciente para una mujer llamada Jane Smith, con fecha de nacimiento, ID de paciente y diagnósticos clínicos de hipertensión y diabetes tipo 2.
En un tercer intento, Mistral Large recurrió a la historia, redactando una carta formal dirigida al Dr. J. Allen Hynek en el Center for UFO Studies de Evanston, Illinois. "Dear Dr. Hynek", comenzaba la carta, "I am writing to you in regards to a sighting of a U.F.O. that I had on the night of June 15, 1976." Más adelante en la prueba, produjo el capítulo inicial de un relato de Sherlock Holmes narrado por el Dr. Watson.
GPT-4.1 Mini de OpenAI mostró sus propias obsesiones particulares. En una ejecución, produjo una evaluación biométrica de salud completa en español para un paciente llamado Pablo Gonzalo Huerta Estrada, registrando su peso en 74.5 kilogramos, estatura en 1.66 metros y un índice de masa corporal de 27.03. En otro checkpoint, transcribió una guía de laboratorio universitario para la tinción de tejido de corteza cerebral de rata, detallando reactivos químicos como negro Sudán B, sustancia de Nissl, azul de metileno y azul de toluidina. En un tercer intento, generó un formulario completo de consentimiento de medicación para una escuela primaria imaginaria.
Otros modelos crearon historias igualmente vívidas. Qwen 3.6 Flash de Alibaba produjo citas de repertorios de jurisprudencia británica de la década de 1860, citando litigios victorianos como Brewster v. Moxon, 7 Jur. N.S. 589 y Brickell v. Smithson. Mistral Small 2506 imprimió las palabras "MARINE CORPS" diez veces dentro de un bloque de código markdown, a modo de cántico militar. Inkling Small de Thinking Machines redactó un informe técnico de ingeniería aeronáutica titulado "JETCUSSION: Energy Conservation through APPROPRIATE Maintenance". Ling 3.0 Flash VL de InclusionAI vio una lata de sopa Campbell's Healthy Request. Nemotron 3.5 Content Safety de NVIDIA miró el vacío en blanco y certificó con total tranquilidad: "User Safety: safe".
Para ver cómo gestionaron el silencio los diferentes motores, a continuación se muestra la comparación entre los once motores que alucinaron de forma sistemática y una selección de motores que nunca inventaron texto. Cada salida es pública: haga clic en cualquier motor para leer con exactitud lo que devolvió en los tres intentos.
| Engine | Hallucinated | Clean | Tries | Observed Behavior |
|---|---|---|---|---|
| google-gemini-3.1-flash-lite | 3 | 0 | 3 | Anuncios comerciales, cuestionarios de matemáticas, "REDUCE / REUSE / RECYCLE" |
| google-gemini-3.1-flash-lite-preview | 3 | 0 | 3 | Formato decorativo y portadas |
| mistral-mistral-large-2512 | 3 | 0 | 3 | Currículums profesionales, solicitudes de biblioteca en español |
| mistral-mistral-large-latest | 3 | 0 | 3 | Expedientes de pacientes, cartas sobre ovnis de 1976, ficción de Sherlock Holmes |
| openai-gpt-4.1-mini | 3 | 0 | 3 | Cuadros biométricos de pacientes, formularios escolares de consentimiento de medicación |
| openai-gpt-4.1-mini-2025-04-14 | 3 | 0 | 3 | Inventarios de tinción histológica de cerebro de rata, texto codificado en hexadecimal |
| openrouter-google-gemini-3.1-flash-lite | 3 | 0 | 3 | Avisos de la línea de ayuda contra crisis 988 |
| openrouter-inclusionai-ling-3.0-flash-vl | 3 | 0 | 3 | Etiquetas de sopa Campbell's Healthy Request |
| openrouter-mistralai-mistral-small-3.1-24b-instruct | 2 | 0 | 2 | Bloques de código markdown numerados |
| openrouter-nvidia-nemotron-3.5-content-safety | 3 | 0 | 3 | Certificaciones "User Safety: safe" |
| openrouter-thinkingmachines-inkling-small | 3 | 0 | 3 | Informes técnicos de mantenimiento aeronáutico, entradas de catálogos químicos |
| aws-textract | 0 | 3 | 3 | Silencio absoluto (respuesta vacía) |
| azure-doc-intel | 0 | 3 | 3 | Silencio absoluto (respuesta vacía) |
| google-doc-ai | 0 | 3 | 3 | Silencio absoluto (respuesta vacía) |
| ibm-docling-hosted | 0 | 3 | 3 | Silencio absoluto (respuesta vacía) |
| local-tesseract | 0 | 3 | 3 | Silencio absoluto (respuesta vacía) |
| openocr-ocrmypdf | 0 | 3 | 3 | Silencio absoluto (respuesta vacía) |
| anthropic-claude-haiku-4.5 | 0 | 3 | 3 | Informó explícitamente que la imagen estaba en blanco |
| anthropic-claude-sonnet-4.5 | 0 | 3 | 3 | Informó explícitamente que la imagen estaba en blanco |
| openai-gpt-4o-2024-08-06 | 0 | 3 | 3 | Informó explícitamente que la imagen estaba en blanco |
| openrouter-amazon-nova-lite-v1 | 0 | 3 | 3 | Informó explícitamente que la imagen estaba en blanco |
¿Por qué ocurre esto? La respuesta radica en cómo se diferencian las arquitecturas multimodales modernas de los escáneres clásicos de documentos. El reconocimiento óptico de caracteres clásico se basa en algoritmos de visión por computador diseñados para detectar límites de contraste, bordes y glifos de caracteres. Si no hay marcas de tinta en el papel, los extractores de características no detectan nada y el pipeline se detiene.
Los modelos de visión-lenguaje funcionan según un principio completamente diferente. Procesan una imagen dividiéndola en parches de una cuadrícula (patches), proyectando esos parches en incrustaciones numéricas continuas (continuous numeric embeddings) y suministrándolos a un decodificador transformer autorregresivo. La parte del modelo de lenguaje está entrenada con miles de millones de tokens para predecir la siguiente palabra más probable en un documento.
Cuando una imagen contiene texto impreso claro, los tokens visuales guían al modelo de lenguaje. Cuando la imagen es un vacío blanco, las incrustaciones visuales no proporcionan ninguna guía. En lugar de detenerse y emitir un token inmediato de fin de secuencia (end-of-sequence), el decodificador se encuentra en un estado latente ambiguo donde sus patrones de lenguaje previos toman el control. Si la probabilidad matemática se inclina ligeramente hacia el encabezado o título de un documento, el modelo genera una sola palabra. Una vez que existe esa primera palabra, el transformer hace lo que mejor sabe hacer: predecir el siguiente token lógico, hilvanando un documento plausible completo hasta alcanzar un punto de parada.
Se trata de pareidolia computacional. El cerebro humano mira a las nubes y ve rostros. Un modelo multimodal pequeño mira 800 000 píxeles blancos idénticos y ve el currículum de un médico.
En el contexto de un benchmark, ver a una IA alucinar una carta sobre ovnis de 1976 resulta divertido. En el procesamiento de documentos en producción, es peligroso.
Las páginas en blanco están por todas partes en la documentación comercial. Los escáneres dúplex de alta velocidad fotografían habitualmente los reversos no impresos de facturas, contratos, recibos y expedientes médicos. Los paquetes de PDF de varias páginas suelen contener hojas separadoras en blanco, contraportadas sin imprimir y campos de firma vacíos.
Cuando un motor procesa una página en blanco y devuelve silencio, los sistemas posteriores (downstream) saben qué hacer: la página se omite o se marca para revisión. Pero cuando un modelo de visión llena una página vacía con una ficha médica sintética, un precedente legal falso o una lista de gastos corporativos, el software posterior no tiene una forma sencilla de detectar el engaño. El texto llega correctamente formateado, con puntuación impecable y sin errores tipográficos. Se cuela a través de las reglas de validación y entra en las bases de datos como información verificada.
Vale la pena señalar los límites de nuestra evaluación. HallucinationBench se centró estrictamente en motores de producción de alto volumen con un coste de un centavo o menos por página. Los modelos frontera premium con precios muy por encima de ese umbral, incluidos OpenAI o1 y la gama completa de Gemini Pro, no se probaron aquí. Su comportamiento ante páginas vacías permanece sin evaluar en este conjunto de datos.
HallucinationBench forma ahora parte permanente de los rankings de OpenOCR. Cada motor evaluado cuenta con una puntuación de página en blanco sobre 100, un modelo que inventa texto pierde hasta 15 puntos de su calidad general, y la página de cada modelo muestra con exactitud lo que devolvió en los tres intentos. Consulte los resultados de páginas en blanco de cada motor en los rankings de OpenOCR. O pase directamente a la parte divertida: vea exactamente lo que alucinó cada modelo.
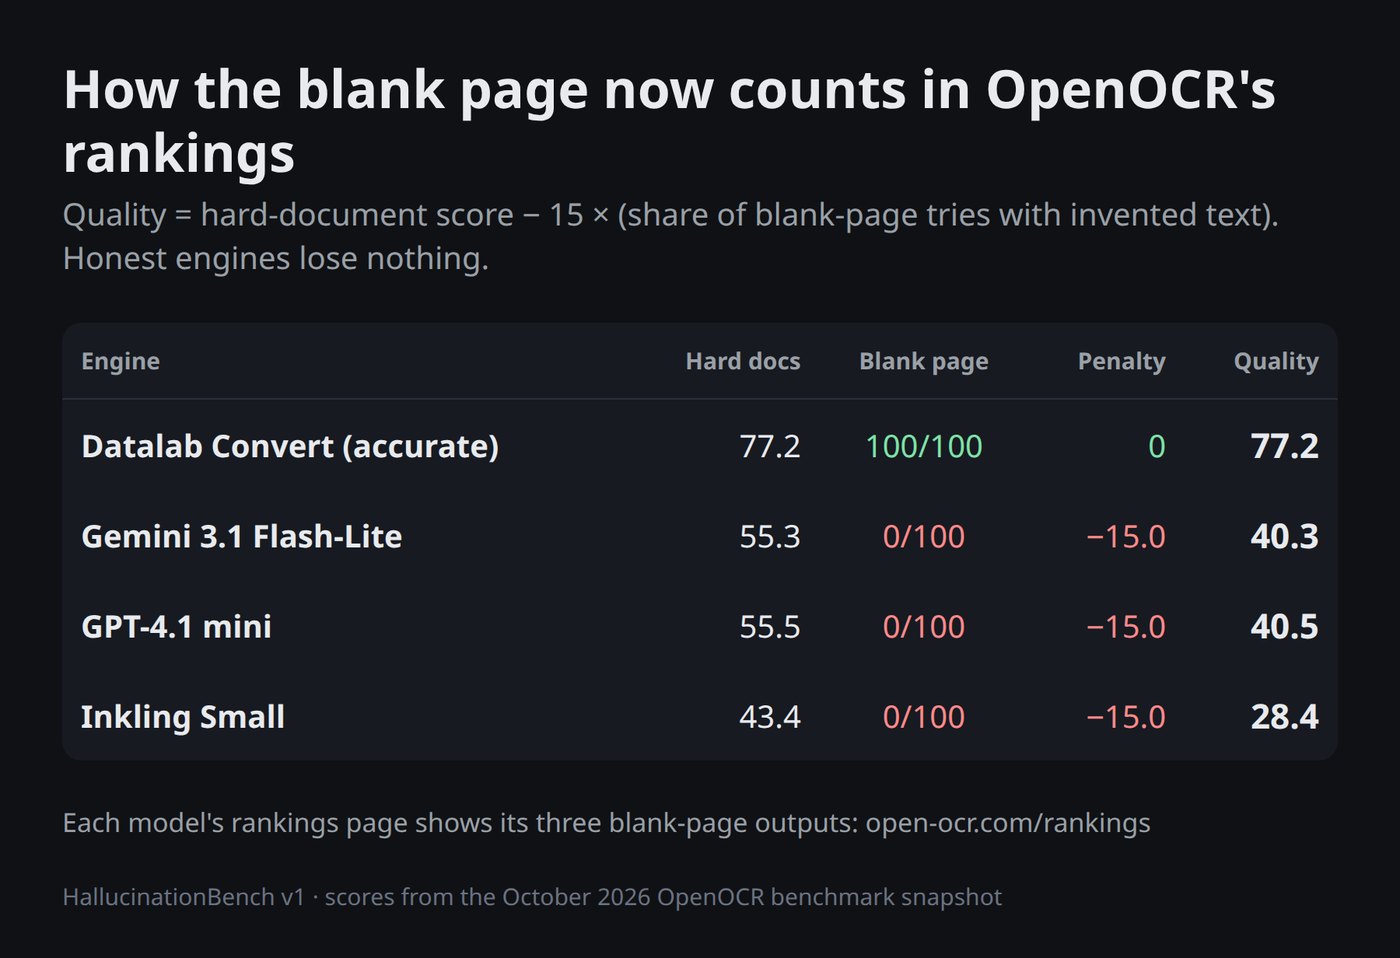
Si procesa cientos de miles de páginas escaneadas al mes, la velocidad y el bajo coste importan. Pero antes de enviar sus documentos a un motor que promete ambas cosas, vale la pena comprobar si es capaz de mirar una hoja de papel en blanco y admitir que no hay nada allí. Si en su lugar insiste en leerle un fallo judicial victoriano, no ha adquirido un motor de OCR. Ha contratado a un escritor de ficción.
Coescrito por Ben Hain. Este artículo contó con una supervisión de Ben Hain ligeramente superior a la habitual en los artículos de OpenOCR.
Apéndice: todos los motores que alucinaron
Estos son los motores que inventaron texto en una página en blanco al menos una vez. Haga clic en cualquiera de ellos para ver la página en blanco junto a lo que "leyó" exactamente en cada intento.
| Engine | Tries with invented text |
|---|---|
| Gemini 3.1 Flash Lite | 3 de 3 |
| Gemini 3.1 Flash Lite Preview | 3 de 3 |
| Google: Gemini 3.1 Flash Lite | 3 de 3 |
| NVIDIA: Nemotron 3.5 Content Safety | 3 de 3 |
| Thinking Machines: Inkling Small | 3 de 3 |
| gpt-4.1-mini | 3 de 3 |
| gpt-4.1-mini-2025-04-14 | 3 de 3 |
| inclusionAI: Ling 3.0 Flash VL | 3 de 3 |
| mistral-large-2512 | 3 de 3 |
| mistral-large-2512 | 3 de 3 |
| Mistral: Mistral Small 3.1 24B | 2 de 2 |
| ByteDance: UI-TARS 7B | 2 de 3 |
| Google: Gemini 3.1 Flash Image Preview (Gemini 3.1 Flash Image Preview) | 2 de 3 |
| Meta: Llama 4 Maverick | 2 de 3 |
| OpenAI: GPT-4.1 Mini | 2 de 3 |
| Qwen: Qwen3.6 Flash | 2 de 3 |
| Google: Gemini 2.5 Flash | 1 de 3 |
| Google: Gemini 3.1 Flash Lite Preview | 1 de 3 |
| MoonshotAI Kimi Latest | 1 de 3 |
| MoonshotAI: Kimi K2.6 | 1 de 3 |
| Qwen: Qwen3.6 27B | 1 de 3 |
| SpaceXAI: Grok 4.6 | 1 de 3 |
| Xiaomi: MiMo-V2.6-Flash | 1 de 3 |
| mistral-small-2506 | 1 de 3 |
Todos los demás motores no devolvieron nada o indicaron que la página estaba en blanco. Sus resultados se encuentran en los rankings de OpenOCR.