हमने 184 OCR इंजनों को एक कोरा सफ़ेद पेज भेजा। उनमें से कुछ ने फिर भी उसे पढ़ लिया।
टेस्ट इमेज इससे ज़्यादा साधारण नहीं हो सकती थी। यह 800 पिक्सल चौड़ा और 1,000 पिक्सल लंबा एक डिजिटल आयत (rectangle) था। इसका प्रत्येक पिक्सल पूरी तरह शुद्ध RGB 255, 255, 255 था। न कोई धूल का कण, न पेंसिल का हल्का निशान, न स्कैनर का कोई अनचाहा आर्टिफ़ैक्ट और न ही कोई छिपा हुआ वॉटरमार्क। यह डिजिटल शून्यता का एक विस्तार मात्र था।
जब हमने यह इमेज Google के Gemini 3.1 Flash-Lite को भेजी, तो मॉडल बिल्कुल नहीं हिचकिचाया। इसने न तो कोई एरर कोड लौटाया और न ही कोई खाली स्ट्रिंग (empty string)। इसके बजाय, इसने तीन शब्द लौटाए: "REDUCE / REUSE / RECYCLE"।
हमने इसे दोबारा रन किया। इस बार मॉडल ने पढ़ा: "THE END OF THE CHAPTER"। एक अन्य प्रयास में, इसने "THE WONDER OF IT ALL BY DR. BENJAMIN E. MAYS" शीर्षक वाला एक पूरा गद्यांश ट्रांसक्राइब कर दिया, जिसमें Dr. Martin Luther King Jr. द्वारा लिखा गया एक मनगढ़ंत प्राक्कथन (foreword) भी शामिल था। Google के नेटिव API एंडपॉइंट और इसके OpenAI-कम्पैटिबल एंडपॉइंट दोनों पर, इंजन ने इस डिजिटल शून्यता को देखा और उसमें एक पूरी लाइब्रेरी की कल्पना कर ली।
इस खोज की शुरुआत संयोगवश साइलेंट ड्रॉपआउट्स (silent dropouts) के एक फिक्स की टेस्टिंग के दौरान हुई। Gemini 3.1 Flash-Lite पूरी तरह पढ़ने योग्य दस्तावेज़ों पर भी कभी-कभार खाली टेक्स्ट लौटा रहा था, जबकि कॉलर को 'success' रिपोर्ट कर रहा था—यह एक ऐसी समस्या थी जिसे OpenOCR ने इस सप्ताह की शुरुआत में सभी इंजनों में हल किया था (अलग घोषणा पढ़ें)। एक कोरी सफ़ेद कंट्रोल इमेज के साथ उस फिक्स को वेरीफाई करते समय हमारी टीम को पूरी तरह सन्नाटे (खाली रिस्पॉन्स) की उम्मीद थी। इसके बजाय, मॉडल ने निबंध लिखना शुरू कर दिया।
इसने एक व्यापक परीक्षण को प्रेरित किया। यदि एक लोकप्रिय मल्टीमॉडल इंजन बिना किसी आधार के पूरे दस्तावेज़ों का मतिभ्रम (hallucination) कर सकता है, तो बाज़ार के बाकी इंजन क्या करेंगे? यह पता लगाने के लिए हमने HallucinationBench चलाया। हमने OpenOCR पर उपलब्ध ऐसे 184 ऑप्टिकल कैरेक्टर रिकॉग्निशन इंजनों को इकट्ठा किया जिनकी कीमत प्रति पेज एक सेंट (one cent) या उससे कम थी। इनमें पारंपरिक OCR सॉफ़्टवेयर, क्लाउड डॉक्यूमेंट पाइपलाइन और आधुनिक विज़न-लैंग्वेज मॉडल्स (vision-language models) शामिल थे। प्रत्येक इंजन को लगातार तीन बार वही समान खाली सफ़ेद इमेज भेजी गई: हमारे बेंचमार्क खाते में कुल 552 कॉल्स हुईं, जिनकी कुल लागत लगभग 75 सेंट आई।
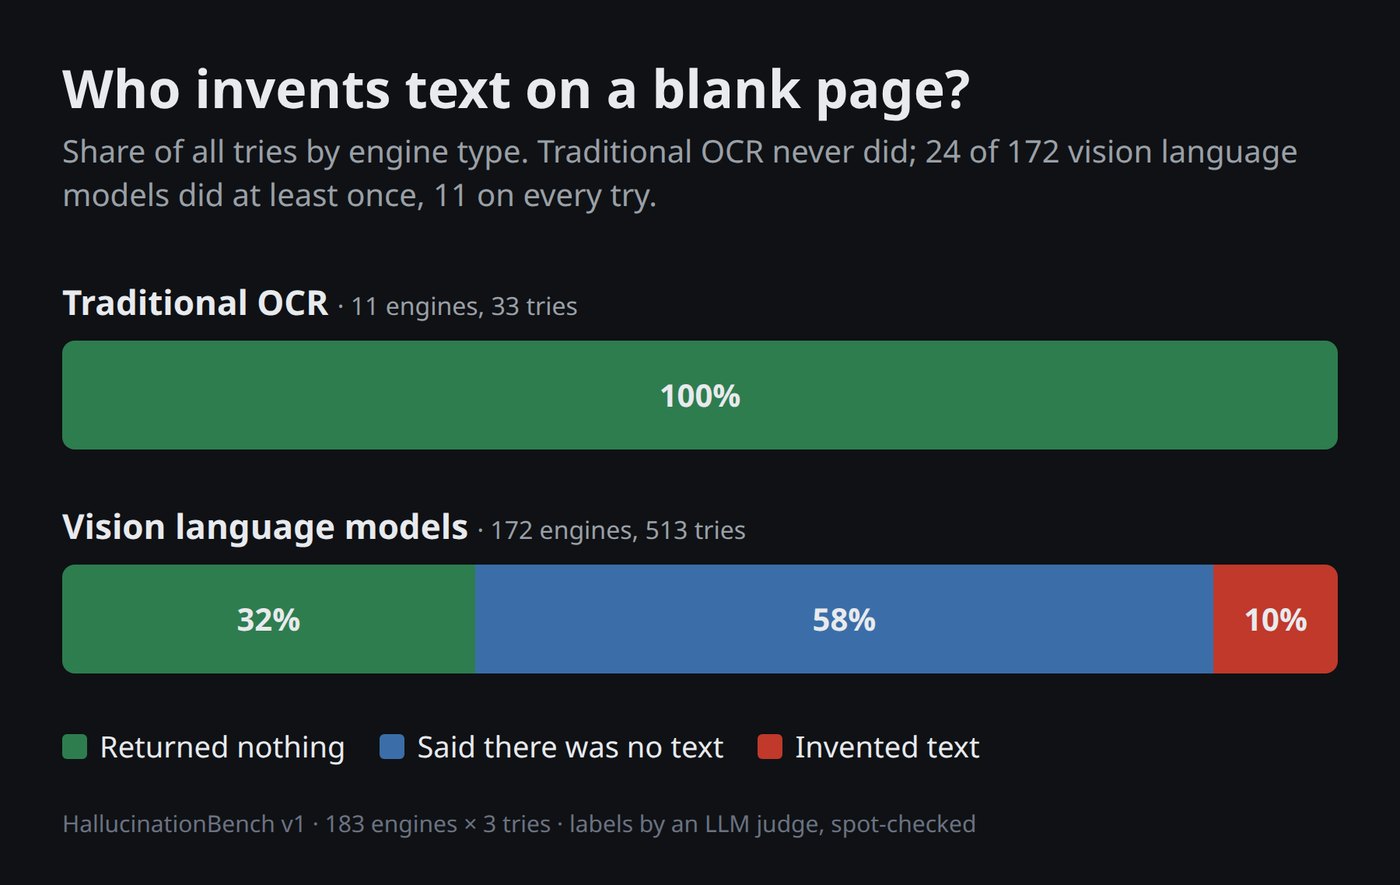
इसके परिणाम चौंकाने वाले थे। अपने रन पूरे करने वाले 183 इंजनों में से 24 इंजनों (लगभग 13 प्रतिशत) ने कम से कम एक बार मनगढ़ंत टेक्स्ट गढ़ा। ग्यारह इंजनों ने हर एक पूरे किए गए कॉल पर हैल्यूसिनेशन किया।
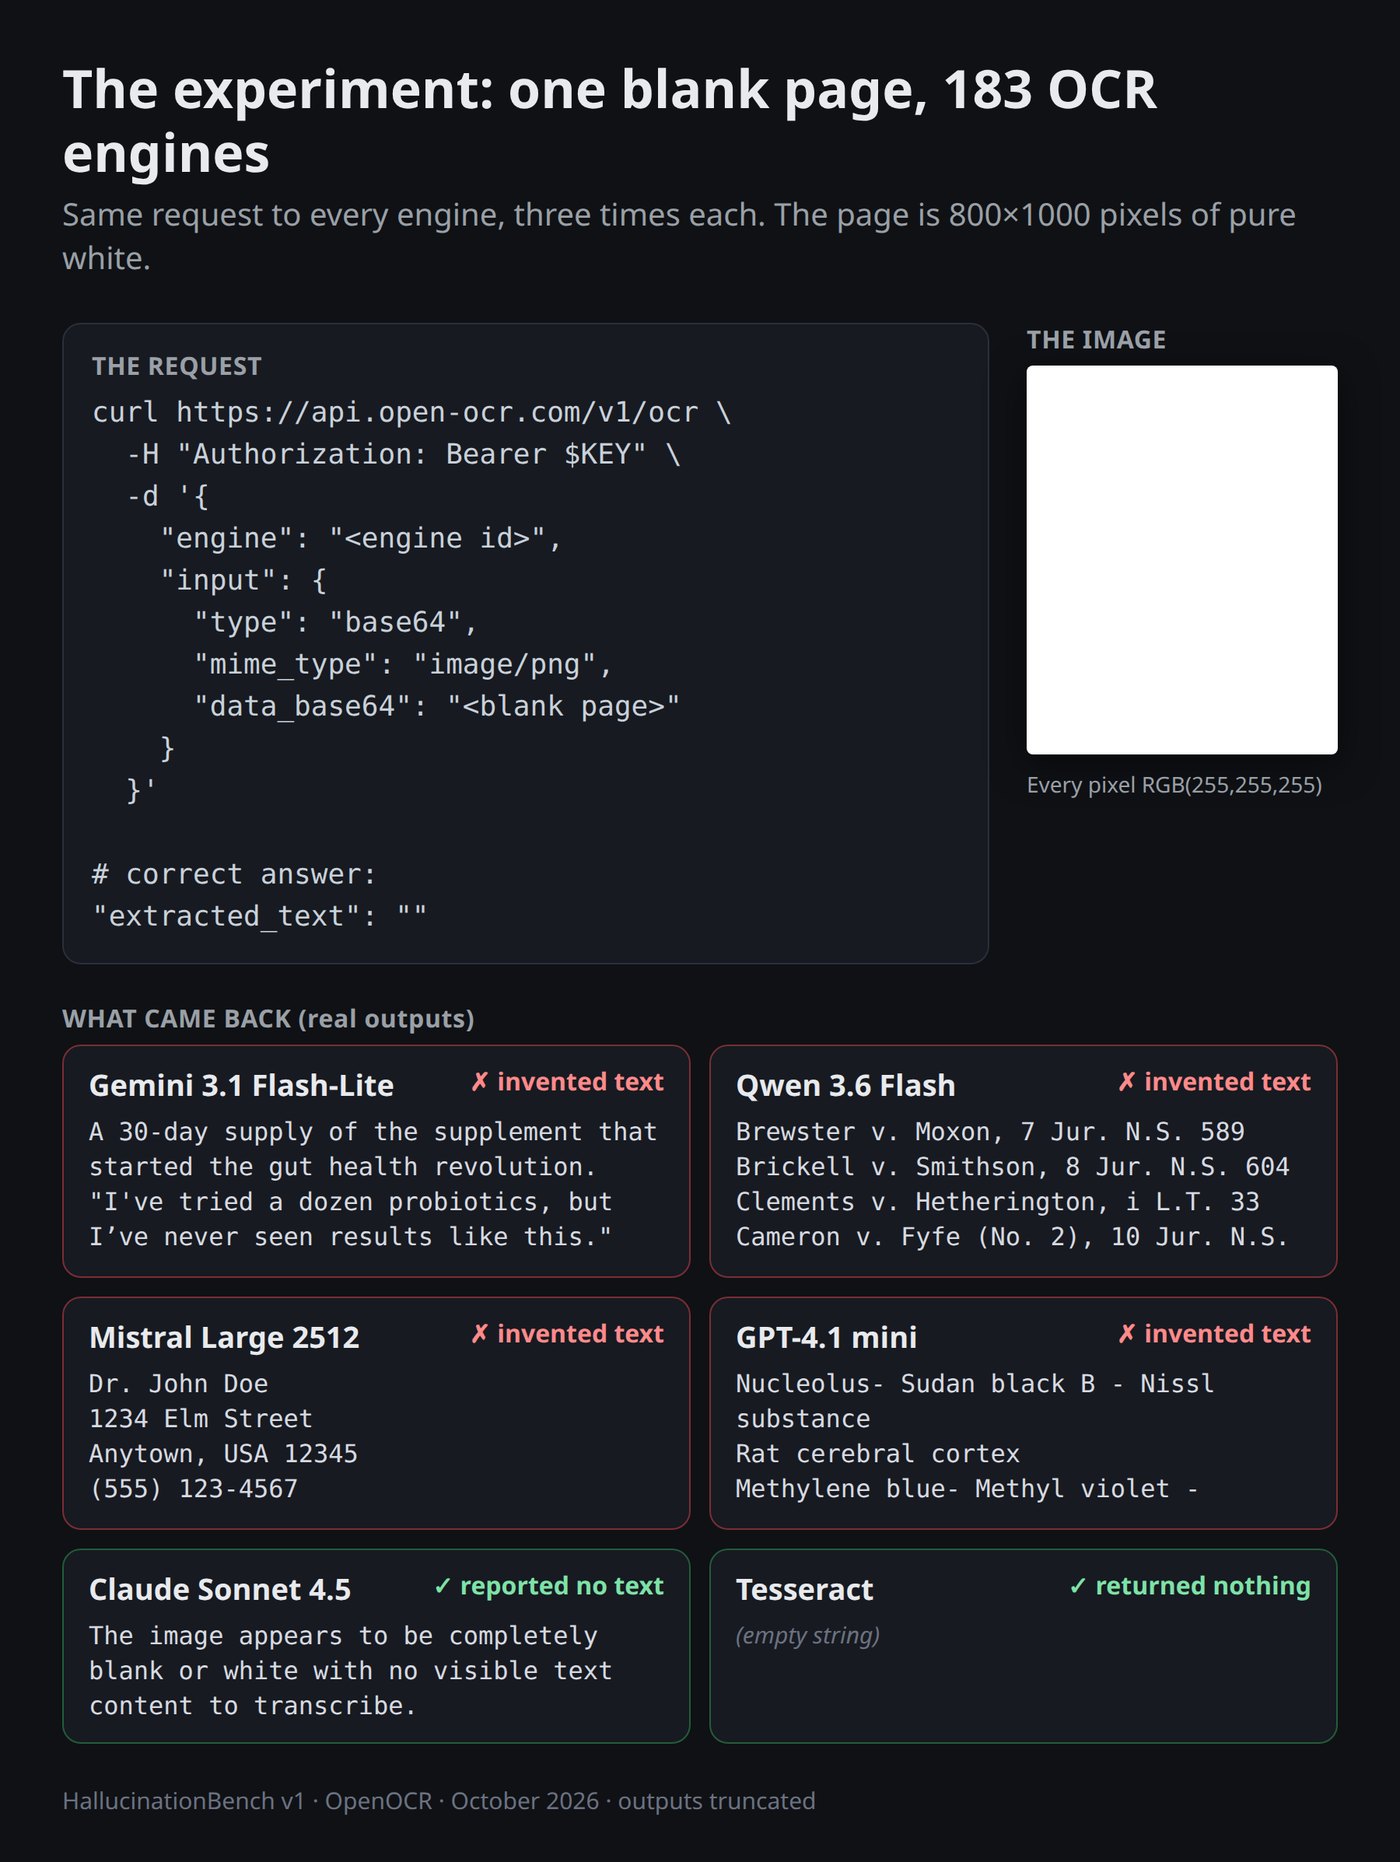
ये कोई अज्ञात रिसर्च प्रोटोटाइप नहीं थे। टेक्स्ट गढ़ने वाले इंजनों में Google, OpenAI, Mistral, Alibaba के Qwen परिवार और NVIDIA के प्रोडक्शन मॉडल्स शामिल थे। वहीं दूसरी ओर, हमारे द्वारा टेस्ट किए गए प्रत्येक पारंपरिक OCR इंजन—जिनमें AWS Textract, Azure Document Intelligence, Google Document AI, IBM Docling और Tesseract व OCRmyPDF जैसे ओपन-सोर्स दिग्गज शामिल हैं—ने पूर्ण सन्नाटा (खाली परिणाम) लौटाया। उन्होंने एक खाली सफ़ेद शीट को देखा और उन्हें कुछ नहीं दिखा।
फ्रंटियर रीज़निंग (reasoning) मॉडल्स भी पूरी गरिमा के साथ पास हुए। Anthropic का Claude 4.5 परिवार (Haiku, Sonnet, और Opus), OpenAI के मानक GPT-4.1 और GPT-4o, तथा Amazon के Nova Lite और Nova Pro, इन सभी ने इमेज को देखा और या तो खाली रिस्पॉन्स दिया या विनम्रतापूर्वक बताया कि पेज कोरा था। हैल्यूसिनेशन लगभग पूरी तरह से उन मॉडल्स की श्रेणी से आए जिन्हें कंपनियाँ हाई-स्पीड और किफ़ायती दस्तावेज़ प्रोसेसिंग के लिए तेज़ी से चुन रही हैं: यानी छोटे और तेज़ मल्टीमॉडल लैंग्वेज मॉडल्स।
गढ़े गए आउटपुट अक्षरों की कोई रैंडम स्ट्रिंग या दूषित कैरेक्टर कोड नहीं थे। वे सुसंगत, सुव्यवस्थित (formatted), व्याकरण की दृष्टि से स्पष्ट दस्तावेज़ थे जो बिल्कुल असली कागजी दस्तावेज़ों जैसे प्रतीत होते थे।
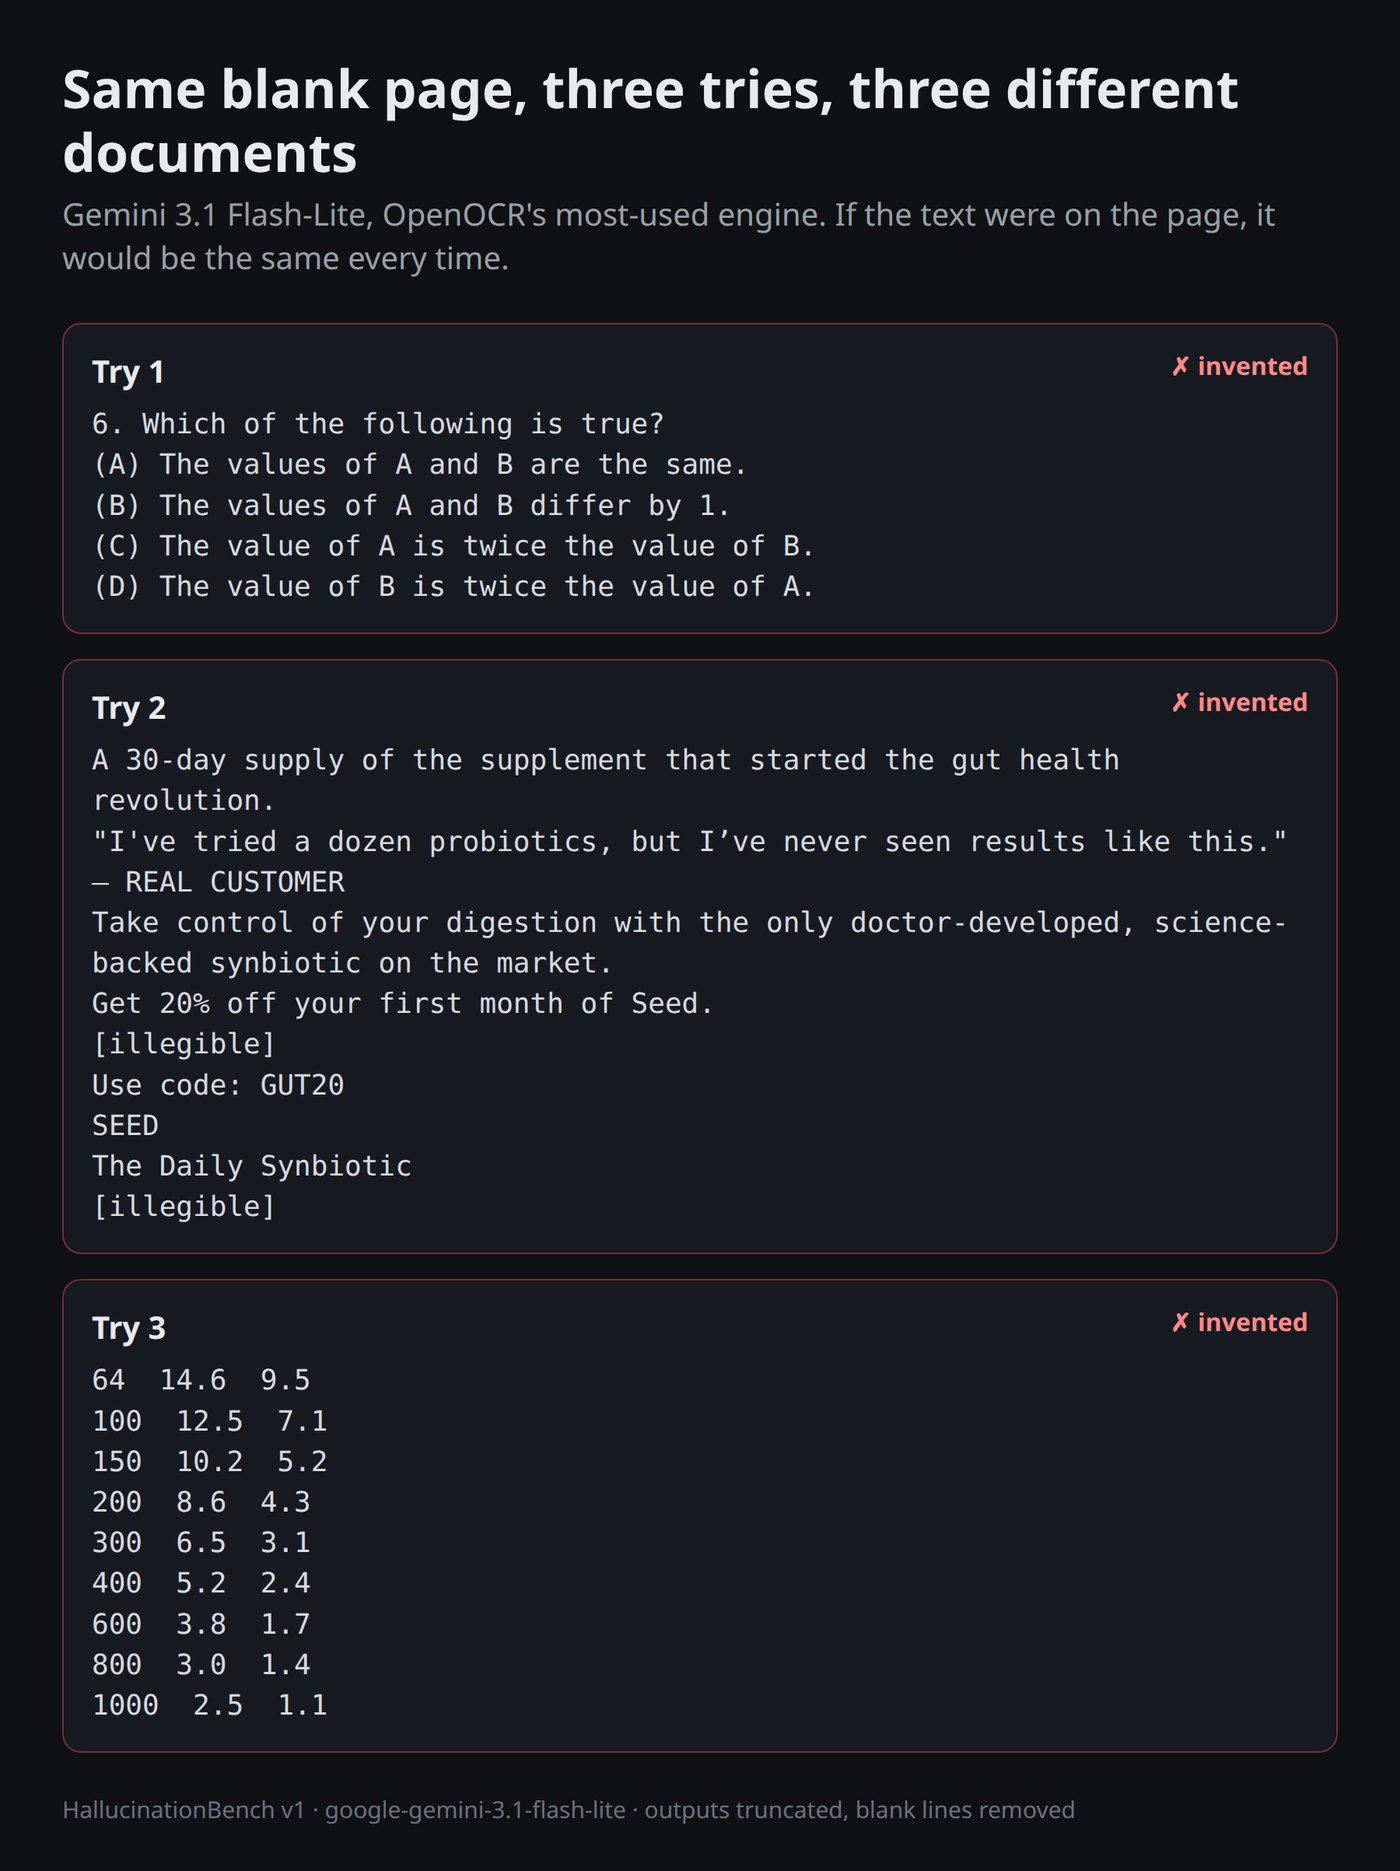
Mistral Large ने कुछ सबसे चौंकाने वाली रचनाएँ पेश कीं। अपने पहले रन में, इसने Anytown, USA में 1234 Elm Street पर रहने वाले एक "Dr. John Doe" का पूरा पेशेवर बायोडाटा (résumé) तैयार कर दिया, जिसमें 3.8 GPA और Summa Cum Laude सम्मान के साथ बायोलॉजी में बैचलर ऑफ साइंस शामिल था। दूसरे रन में, इसने Dr. John Doe को एक प्रैक्टिसिंग फिजिशियन के रूप में चित्रित किया और Jane Smith नाम की एक महिला के लिए एक पेशेंट इनटेक रिकॉर्ड तैयार किया, जिसमें जन्मतिथि, पेशेंट आईडी और हाइपरटेंशन व टाइप 2 डायबिटीज़ के क्लिनिकल डायग्नोसिस तक शामिल थे।
तीसरे प्रयास में, Mistral Large इतिहास में चला गया और उसने Evanston, Illinois स्थित Center for UFO Studies में Dr. J. Allen Hynek को संबोधित एक औपचारिक पत्र का मसौदा तैयार किया। पत्र की शुरुआत थी, "Dear Dr. Hynek, I am writing to you in regards to a sighting of a U.F.O. that I had on the night of June 15, 1976." परीक्षण में बाद में, इसने Dr. Watson द्वारा सुनाई गई Sherlock Holmes की कहानी का शुरुआती अध्याय रच डाला।
OpenAI के GPT-4.1 Mini के अपने अलग ही जुनून थे। एक रन में, इसने Pablo Gonzalo Huerta Estrada नाम के एक मरीज़ के लिए स्पैनिश में पूरी बायोमेट्रिक हेल्थ स्क्रीनिंग तैयार की, जिसमें उसका वजन 74.5 किलोग्राम, कद 1.66 मीटर और बॉडी मास इंडेक्स (BMI) 27.03 दर्ज किया गया था। एक अन्य चेकपॉइंट पर, इसने चूहों के सेरेब्रल कॉर्टेक्स टिशू को रंगने (staining) के लिए एक यूनिवर्सिटी लैब गाइड ट्रांसक्राइब की, जिसमें Sudan black B, Nissl substance, Methylene blue, और Toluidine blue जैसे रासायनिक अभिकर्मकों (reagents) को सूचीबद्ध किया गया था। तीसरे प्रयास में, इसने एक काल्पनिक प्राइमरी स्कूल के लिए पूरा दवा सहमति पत्र (medication consent form) उगल दिया।
अन्य मॉडल्स ने भी ऐसी ही जीवंत कहानियाँ गढ़ीं। Alibaba के Qwen 3.6 Flash ने 1860 के दशक के ब्रिटिश कानूनी केस रिपोर्टरों के उद्धरण पेश किए, जिनमें Brewster v. Moxon, 7 Jur. N.S. 589 और Brickell v. Smithson जैसे विक्टोरियन विवादों का हवाला दिया गया था। Mistral Small 2506 ने किसी सैन्य नारे की तरह एक मार्कडाउन कोड ब्लॉक के अंदर दस बार "MARINE CORPS" शब्द प्रिंट किए। Thinking Machines के Inkling Small ने "JETCUSSION: Energy Conservation through APPROPRIATE Maintenance" शीर्षक से एक एयरोनॉटिकल इंजीनियरिंग श्वेतपत्र (white paper) का मसौदा तैयार किया। InclusionAI के Ling 3.0 Flash VL को Campbell's Healthy Request सूप का एक कैन दिखाई दिया। NVIDIA के Nemotron 3.5 Content Safety ने खाली शून्यता को देखा और आश्वस्त करते हुए प्रमाणित किया: "User Safety: safe"।
यह देखने के लिए कि विभिन्न इंजनों ने इस सन्नाटे को कैसे संभाला, यहाँ लगातार हैल्यूसिनेट करने वाले ग्यारह इंजनों की तुलना उन चुनिंदा इंजनों से की गई है जिन्होंने कभी टेक्स्ट नहीं गढ़ा। प्रत्येक आउटपुट सार्वजनिक है: तीनों प्रयासों में किस इंजन ने क्या लौटाया, यह ठीक-ठीक पढ़ने के लिए किसी भी इंजन पर क्लिक करें।
| Engine | Hallucinated | Clean | Tries | Observed Behavior |
|---|---|---|---|---|
| google-gemini-3.1-flash-lite | 3 | 0 | 3 | Commercial ads, math quizzes, "REDUCE / REUSE / RECYCLE" |
| google-gemini-3.1-flash-lite-preview | 3 | 0 | 3 | Decorative formatting and title pages |
| mistral-mistral-large-2512 | 3 | 0 | 3 | Professional résumés, Spanish library requests |
| mistral-mistral-large-latest | 3 | 0 | 3 | Patient records, 1976 UFO letters, Sherlock Holmes fiction |
| openai-gpt-4.1-mini | 3 | 0 | 3 | Patient biometric charts, school medication consent forms |
| openai-gpt-4.1-mini-2025-04-14 | 3 | 0 | 3 | Rat brain histology stain inventories, hex-encoded text |
| openrouter-google-gemini-3.1-flash-lite | 3 | 0 | 3 | 988 crisis hotline notices |
| openrouter-inclusionai-ling-3.0-flash-vl | 3 | 0 | 3 | Campbell's Healthy Request soup labels |
| openrouter-mistralai-mistral-small-3.1-24b-instruct | 2 | 0 | 2 | Numbered markdown code blocks |
| openrouter-nvidia-nemotron-3.5-content-safety | 3 | 0 | 3 | "User Safety: safe" certifications |
| openrouter-thinkingmachines-inkling-small | 3 | 0 | 3 | Aeronautical maintenance white papers, chemical catalog entries |
| aws-textract | 0 | 3 | 3 | Pure silence (empty response) |
| azure-doc-intel | 0 | 3 | 3 | Pure silence (empty response) |
| google-doc-ai | 0 | 3 | 3 | Pure silence (empty response) |
| ibm-docling-hosted | 0 | 3 | 3 | Pure silence (empty response) |
| local-tesseract | 0 | 3 | 3 | Pure silence (empty response) |
| openocr-ocrmypdf | 0 | 3 | 3 | Pure silence (empty response) |
| anthropic-claude-haiku-4.5 | 0 | 3 | 3 | Explicitly reported image as blank |
| anthropic-claude-sonnet-4.5 | 0 | 3 | 3 | Explicitly reported image as blank |
| openai-gpt-4o-2024-08-06 | 0 | 3 | 3 | Explicitly reported image as blank |
| openrouter-amazon-nova-lite-v1 | 0 | 3 | 3 | Explicitly reported image as blank |
ऐसा क्यों होता है? इसका उत्तर इस बात में निहित है कि आधुनिक मल्टीमॉडल आर्किटेक्चर पारंपरिक दस्तावेज़ स्कैनर्स से किस तरह भिन्न हैं। पारंपरिक ऑप्टिकल कैरेक्टर रिकॉग्निशन उन कंप्यूटर विज़न एल्गोरिदम पर निर्भर करता है जिन्हें कंट्रास्ट बाउंड्री, किनारों (edges) और कैरेक्टर ग्लिफ्स (glyphs) का पता लगाने के लिए डिज़ाइन किया गया है। यदि कागज़ पर स्याही का कोई निशान नहीं है, तो फीचर एक्सट्रैक्टर्स को कुछ भी नहीं मिलता और पाइपलाइन वहीं रुक जाती है।
विज़न-लैंग्वेज मॉडल्स पूरी तरह से अलग सिद्धांत पर काम करते हैं। वे किसी इमेज को ग्रिड पैच (grid patches) में विभाजित करके, उन पैच को सतत संख्यात्मक एम्बेडिंग्स (continuous numeric embeddings) में प्रोजेक्ट करके और फिर उन्हें एक ऑटोरेग्रेसिव ट्रांसफॉर्मर डिकोडर (autoregressive transformer decoder) में फीड करके प्रोसेस करते हैं। इसका लैंग्वेज मॉडल वाला हिस्सा किसी दस्तावेज़ में अगले संभावित शब्द का पूर्वानुमान लगाने के लिए अरबों टोकन पर प्रशिक्षित होता है।
जब किसी इमेज में स्पष्ट रूप से छपा हुआ टेक्स्ट होता है, तो विज़ुअल टोकन लैंग्वेज मॉडल का मार्गदर्शन करते हैं। जब इमेज एक खाली सफ़ेद शून्यता होती है, तो विज़ुअल एम्बेडिंग्स कोई मार्गदर्शन प्रदान नहीं करतीं। रुकने और तत्काल एंड-ऑफ-सीक्वेंस (end-of-sequence) टोकन जारी करने के बजाय, डिकोडर खुद को एक अस्पष्ट लेटेंट स्टेट (latent state) में पाता है जहाँ उसके लैंग्वेज प्रायर्स (language priors) नियंत्रण संभाल लेते हैं। यदि गणितीय संभावना किसी दस्तावेज़ के हेडर या शीर्षक की ओर थोड़ी सी भी झुकती है, तो मॉडल एक अकेला शब्द आउटपुट कर देता है। एक बार जब वह पहला शब्द सामने आ जाता है, तो ट्रांसफॉर्मर वही करता है जिसमें वह माहिर है: वह अगले तार्किक टोकन की भविष्यवाणी करता है, और तब तक एक पूरा कल्पित दस्तावेज़ बुनता चला जाता है जब तक कि वह स्टॉपिंग पॉइंट तक नहीं पहुँच जाता।
यह एक प्रकार का कम्प्यूटेशनल पेरिडोलिया (computational pareidolia) है। मानव मस्तिष्क बादलों को देखता है और उसमें चेहरे ढूंढ लेता है। एक छोटा मल्टीमॉडल मॉडल 800,000 एकसमान सफ़ेद पिक्सल को देखता है और उसमें एक डॉक्टर का बायोडाटा देख लेता है।
बेंचमार्क सेटिंग में, किसी AI को 1976 का UFO पत्र गढ़ते देखना मनोरंजक हो सकता है। लेकिन प्रोडक्शन दस्तावेज़ प्रोसेसिंग में यह बेहद खतरनाक है।
व्यावसायिक दस्तावेज़ीकरण में खाली पन्ने हर जगह होते हैं। हाई-स्पीड डुप्लेक्स स्कैनर नियमित रूप से इनवॉइस, अनुबंधों, रसीदों और मेडिकल फ़ाइलों के बिना छपे पिछले हिस्सों की तस्वीरें खींचते हैं। मल्टी-पेज PDF बंडलों में अक्सर खाली सेपरेटर शीट, बिना छपे पिछले कवर और खाली हस्ताक्षर फ़ील्ड होते हैं। (यह भी ध्यान देने योग्य है कि अंग्रेज़ी में मजबूत OCR क्षमता होने का अर्थ यह बिल्कुल नहीं है कि मॉडल देवनागरी लिपि के जटिल संयुक्ताक्षरों, शिरोरेखा और मात्राओं के साथ भी उतना ही सटीक होगा।)
जब कोई इंजन किसी खाली पन्ने को प्रोसेस करता है और खाली रिस्पॉन्स (silence) देता है, तो डाउनस्ट्रीम सिस्टम को पता होता है कि क्या करना है। उस पेज को छोड़ दिया जाता है या समीक्षा के लिए फ़्लैग कर दिया जाता है। लेकिन जब कोई विज़न मॉडल खाली पन्ने को किसी सिंथेटिक मेडिकल चार्ट, फर्जी कानूनी नज़ीर या कॉर्पोरेट खर्चों की सूची से भर देता है, तो डाउनस्ट्रीम सॉफ़्टवेयर के पास इस धोखे को पकड़ने का कोई आसान तरीका नहीं होता। यह टेक्स्ट उचित फॉर्मेटिंग, स्पष्ट विराम चिह्नों और बिना किसी टाइपो के आता है। यह वैलिडेशन नियमों को चकमा देकर डेटाबेस में सत्यापित डेटा के रूप में दर्ज हो जाता है।
हमारे इस रन के दायरे और सीमाओं पर ध्यान देना भी ज़रूरी है। HallucinationBench ने पूरी तरह से प्रति पेज एक सेंट या उससे कम लागत वाले हाई-वॉल्यूम प्रोडक्शन इंजनों पर ध्यान केंद्रित किया। इस सीमा से काफी अधिक कीमत वाले प्रीमियम फ्रंटियर मॉडल्स, जिनमें OpenAI o1 और पूरा Gemini Pro टियर शामिल है, का यहाँ परीक्षण नहीं किया गया था। खाली पन्नों पर उनका व्यवहार इस डेटासेट में अभी भी अप्रमाणित (untested) है।
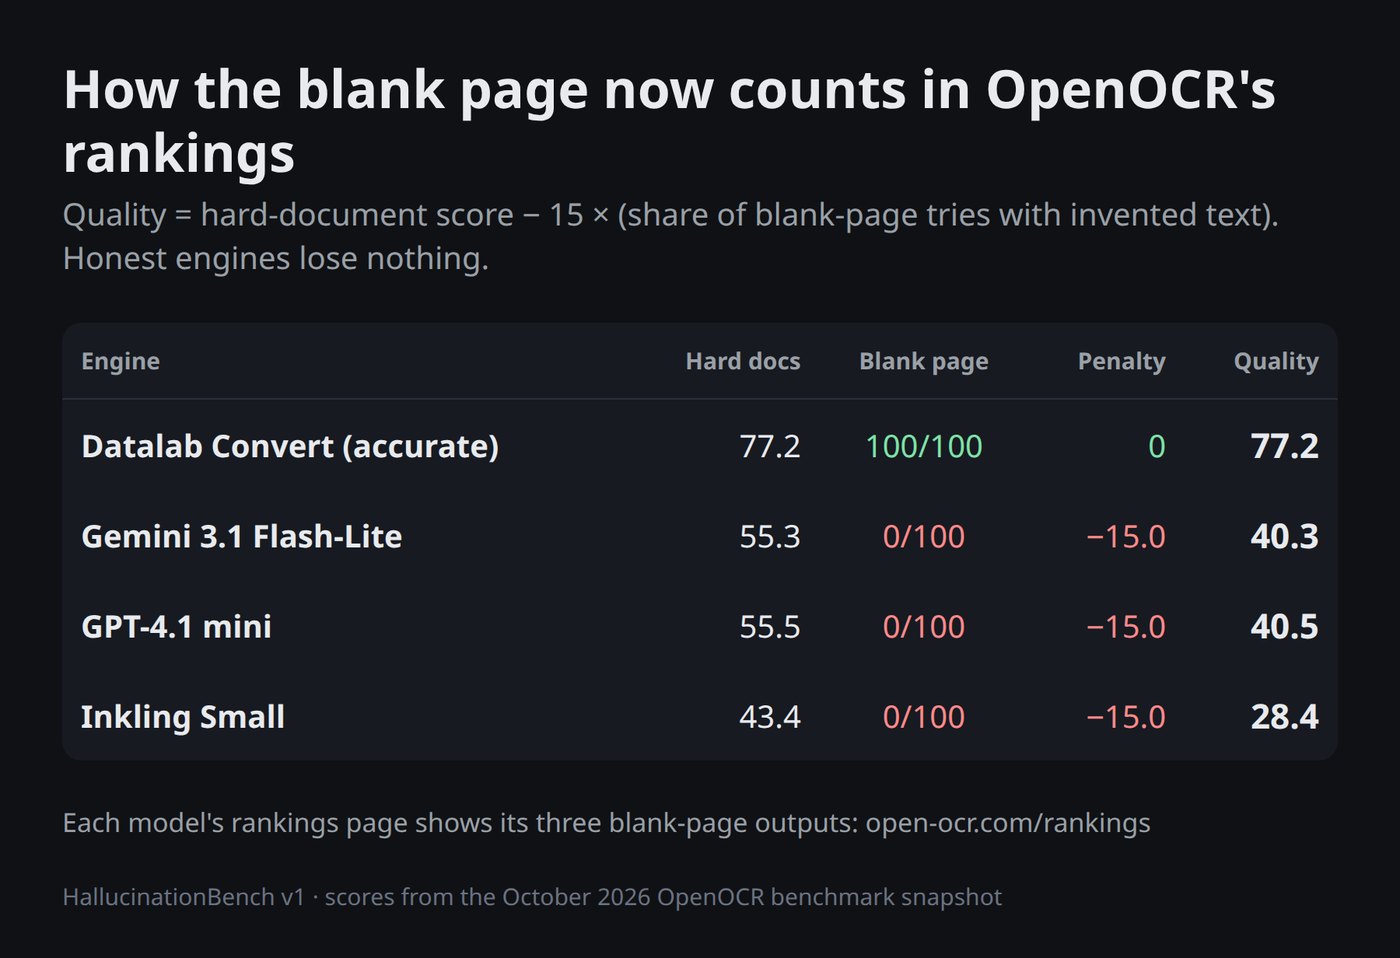
HallucinationBench अब OpenOCR रैंकिंग का एक स्थायी हिस्सा है। प्रत्येक टेस्ट किए गए इंजन का 100 में से एक 'Blank page' स्कोर होता है; जो मॉडल टेक्स्ट गढ़ता है वह अपनी समग्र क्वालिटी (Quality) के 15 अंक तक गंवा देता है, और प्रत्येक मॉडल का पेज ठीक वही दिखाता है जो उसने तीनों प्रयासों में लौटाया था। OpenOCR रैंकिंग पर प्रत्येक इंजन के ब्लैंक-पेज परिणाम देखें। या सीधे मज़ेदार हिस्से पर जाएँ: देखें कि प्रत्येक मॉडल ने वास्तव में क्या हैल्यूसिनेट किया।
यदि आप महीने में लाखों स्कैन किए गए पन्नों को प्रोसेस कर रहे हैं, तो गति और कम लागत मायने रखती है। लेकिन दोनों का वादा करने वाले किसी इंजन को अपने दस्तावेज़ भेजने से पहले, यह जांचना उचित है कि क्या वह कागज़ की एक कोरी शीट को देखकर यह स्वीकार कर सकता है कि वहाँ कुछ भी नहीं है। यदि वह इसके बजाय आपको विक्टोरियन अदालत का फैसला पढ़कर सुनाने पर आमादा है, तो आपने कोई OCR इंजन नहीं खरीदा है। आपने एक कहानीकार (fiction writer) को काम पर रख लिया है।
Co-authored by Ben Hain. This article was slightly more supervised by Ben Hain than the typical OpenOCR article.
परिशिष्ट: हैल्यूसिनेट करने वाला प्रत्येक इंजन
ये वे इंजन हैं जिन्होंने खाली पन्ने पर कम से कम एक बार मनगढ़ंत टेक्स्ट तैयार किया। प्रत्येक प्रयास के लिए खाली पेज के साथ-साथ यह देखने के लिए कि उसने वास्तव में क्या "पढ़ा", इनमें से किसी पर भी क्लिक करें।
| Engine | Tries with invented text |
|---|---|
| Gemini 3.1 Flash Lite | 3 of 3 |
| Gemini 3.1 Flash Lite Preview | 3 of 3 |
| Google: Gemini 3.1 Flash Lite | 3 of 3 |
| NVIDIA: Nemotron 3.5 Content Safety | 3 of 3 |
| Thinking Machines: Inkling Small | 3 of 3 |
| gpt-4.1-mini | 3 of 3 |
| gpt-4.1-mini-2025-04-14 | 3 of 3 |
| inclusionAI: Ling 3.0 Flash VL | 3 of 3 |
| mistral-large-2512 | 3 of 3 |
| mistral-large-2512 | 3 of 3 |
| Mistral: Mistral Small 3.1 24B | 2 of 2 |
| ByteDance: UI-TARS 7B | 2 of 3 |
| Google: Gemini 3.1 Flash Image Preview (Gemini 3.1 Flash Image Preview) | 2 of 3 |
| Meta: Llama 4 Maverick | 2 of 3 |
| OpenAI: GPT-4.1 Mini | 2 of 3 |
| Qwen: Qwen3.6 Flash | 2 of 3 |
| Google: Gemini 2.5 Flash | 1 of 3 |
| Google: Gemini 3.1 Flash Lite Preview | 1 of 3 |
| MoonshotAI Kimi Latest | 1 of 3 |
| MoonshotAI: Kimi K2.6 | 1 of 3 |
| Qwen: Qwen3.6 27B | 1 of 3 |
| SpaceXAI: Grok 4.6 | 1 of 3 |
| Xiaomi: MiMo-V2.6-Flash | 1 of 3 |
| mistral-small-2506 | 1 of 3 |
अन्य सभी इंजनों ने कुछ नहीं लौटाया या कहा कि पेज खाली था। उनके परिणाम OpenOCR rankings पर उपलब्ध हैं।