184種類のOCRエンジンに真っ白な空白ページを送信した結果:一部のモデルが存在しない文字を「読解」
テスト用の画像はこれ以上ないほどシンプルなものだった。幅800ピクセル、高さ1,000ピクセルのデジタルな長方形。すべてのピクセルが純粋なRGB (255, 255, 255) で構成されていた。ホコリも、かすかな鉛筆の跡も、スキャナーのノイズも、隠し透かしも一切ない。まさに完全なる「デジタルの無」だった。
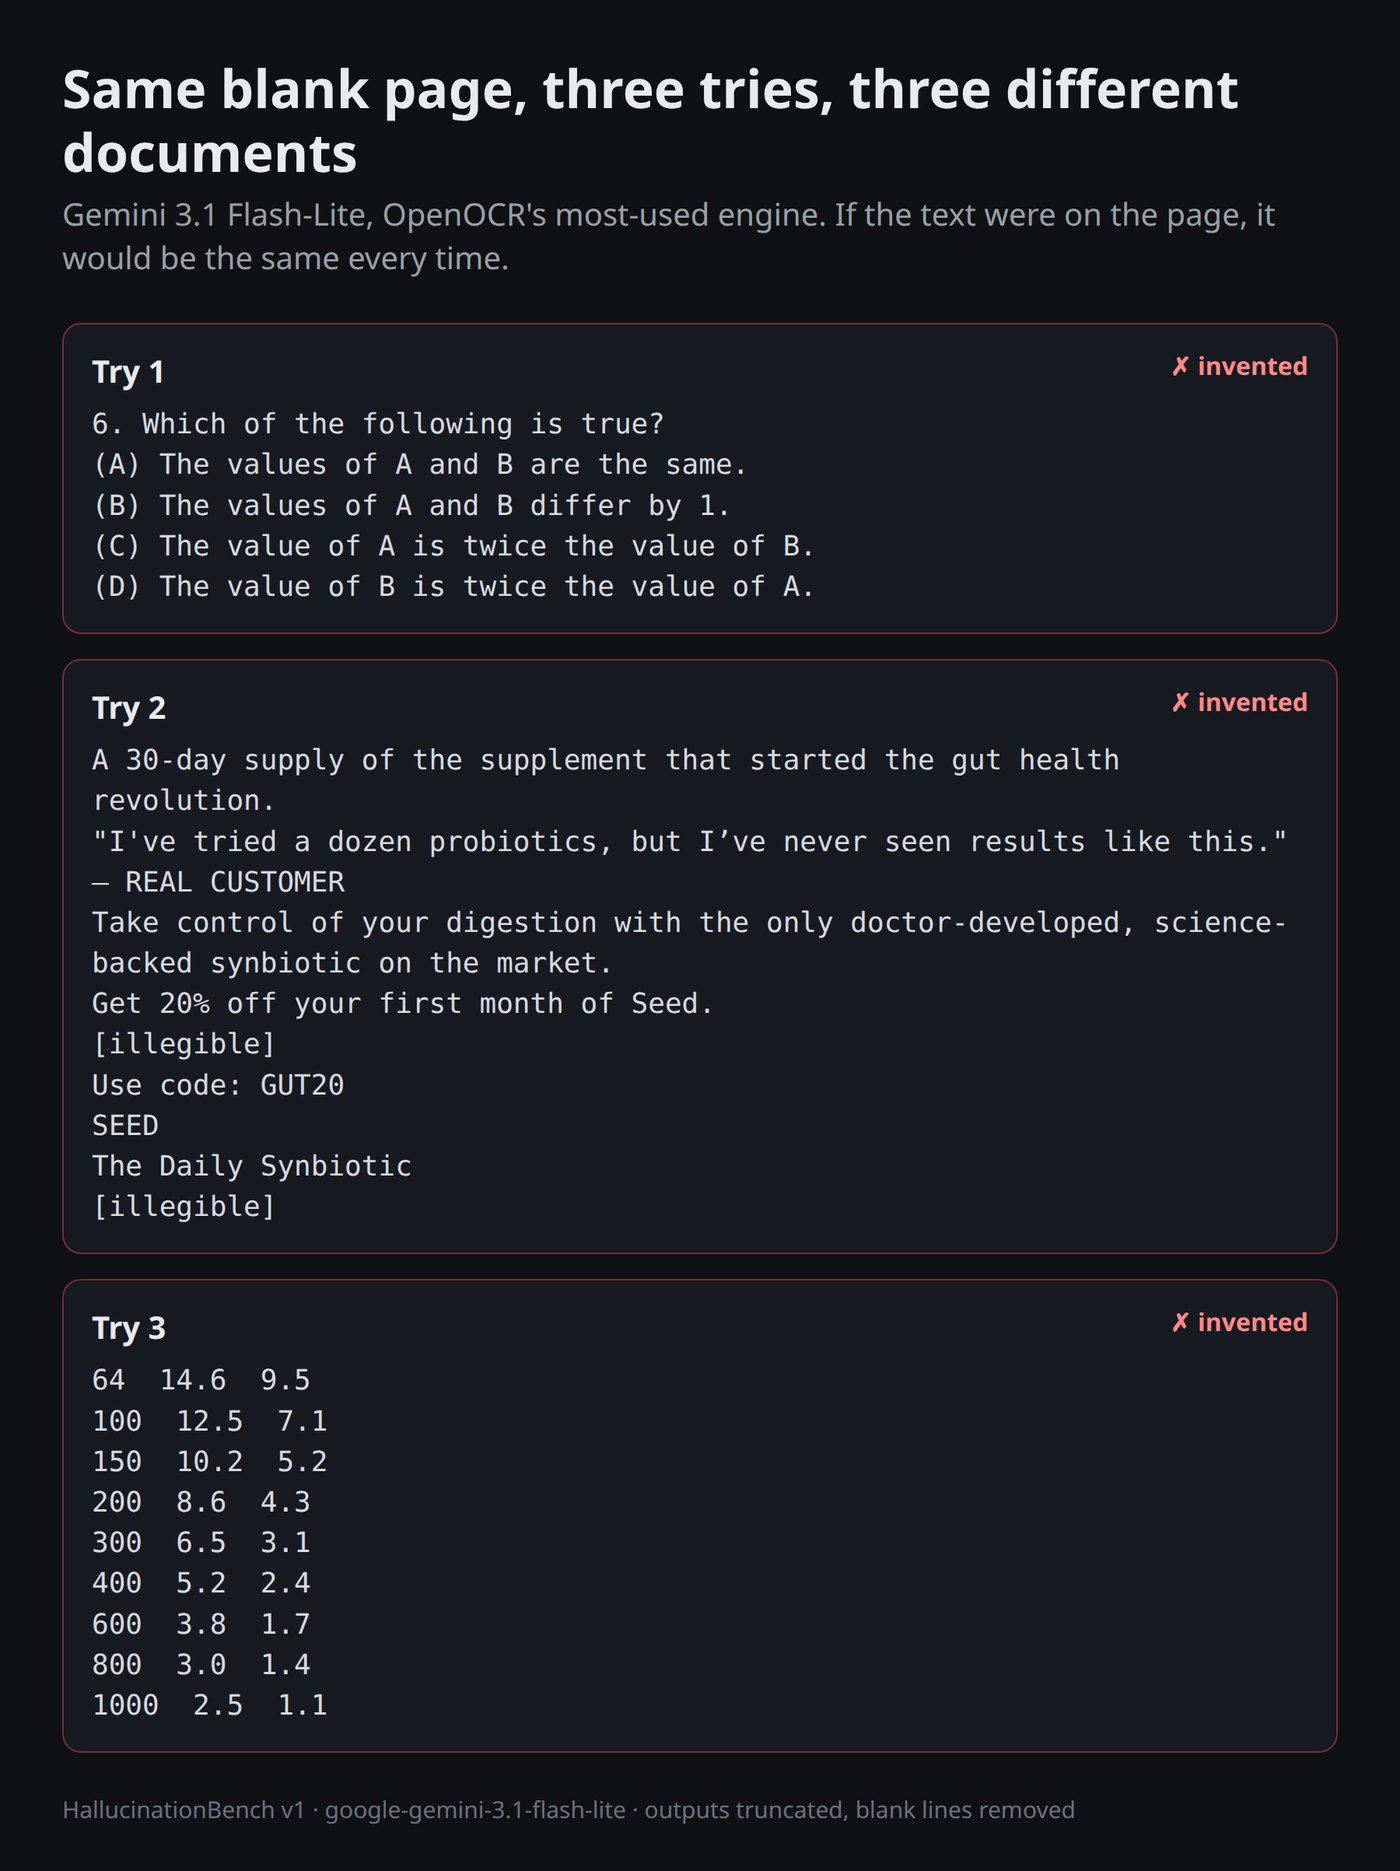
この画像をGoogleのGemini 3.1 Flash-Liteに送信したところ、モデルは迷うことなく応答した。エラーコードを返すことも、空の文字列を返すこともなかった。代わりに返してきたのは、「REDUCE / REUSE / RECYCLE(リデュース・リユース・リサイクル)」という3つの単語だった。
もう一度実行してみた。今度は「THE END OF THE CHAPTER(章の終わり)」と読み取った。さらに別の試行では、「THE WONDER OF IT ALL BY DR. BENJAMIN E. MAYS」と題された文章を書き起こし、実在しないマーティン・ルーサー・キング・ジュニア博士による序文まで勝手につけ足した。GoogleのネイティブAPIエンドポイントとOpenAI互換エンドポイントのいずれにおいても、このエンジンはデジタルの空白を見つめ、そこに「図書館」を見出したのだ。
この発見の発端は、サイレントドロップアウト(文字の抜け落ち)の修正テストを行っていたときの偶然だった。Gemini 3.1 Flash-Liteは、完全に読み取り可能なドキュメントであるにもかかわらず、呼び出し元には成功ステータスを返しながら空のテキストを返すことが時折あった。この問題について、OpenOCRは今週初めに全エンジンを対象とした修正を実施した(詳細な発表記事はこちら)。その修正を検証するため、コントロール用の真っ白な画像を入力したところ、私たちのチームは「何も出力されないこと」を期待していた。しかし、モデルは突如として文章を執筆し始めたのだ。
これをきっかけに、より広範なテストを実施することにした。人気の高いマルチモーダルエンジンの1つが何もないところからドキュメント全体をハルシネーション(幻覚)によって捏造するのであれば、市場の他のモデルはどうなのだろうか?それを確かめるべく、私たちは「HallucinationBench」を実施した。OpenOCRで利用可能な1ページあたり1セント以下のOCRエンジン184種類(従来のOCRソフトウェア、クラウドドキュメントパイプライン、最新のビジョン言語モデルを含む)を集めた。各エンジンに対して全く同一の白い空白画像を3回連続で送信し、合計552回の呼び出しを行った(ベンチマークアカウントでの総費用は約75セント)。
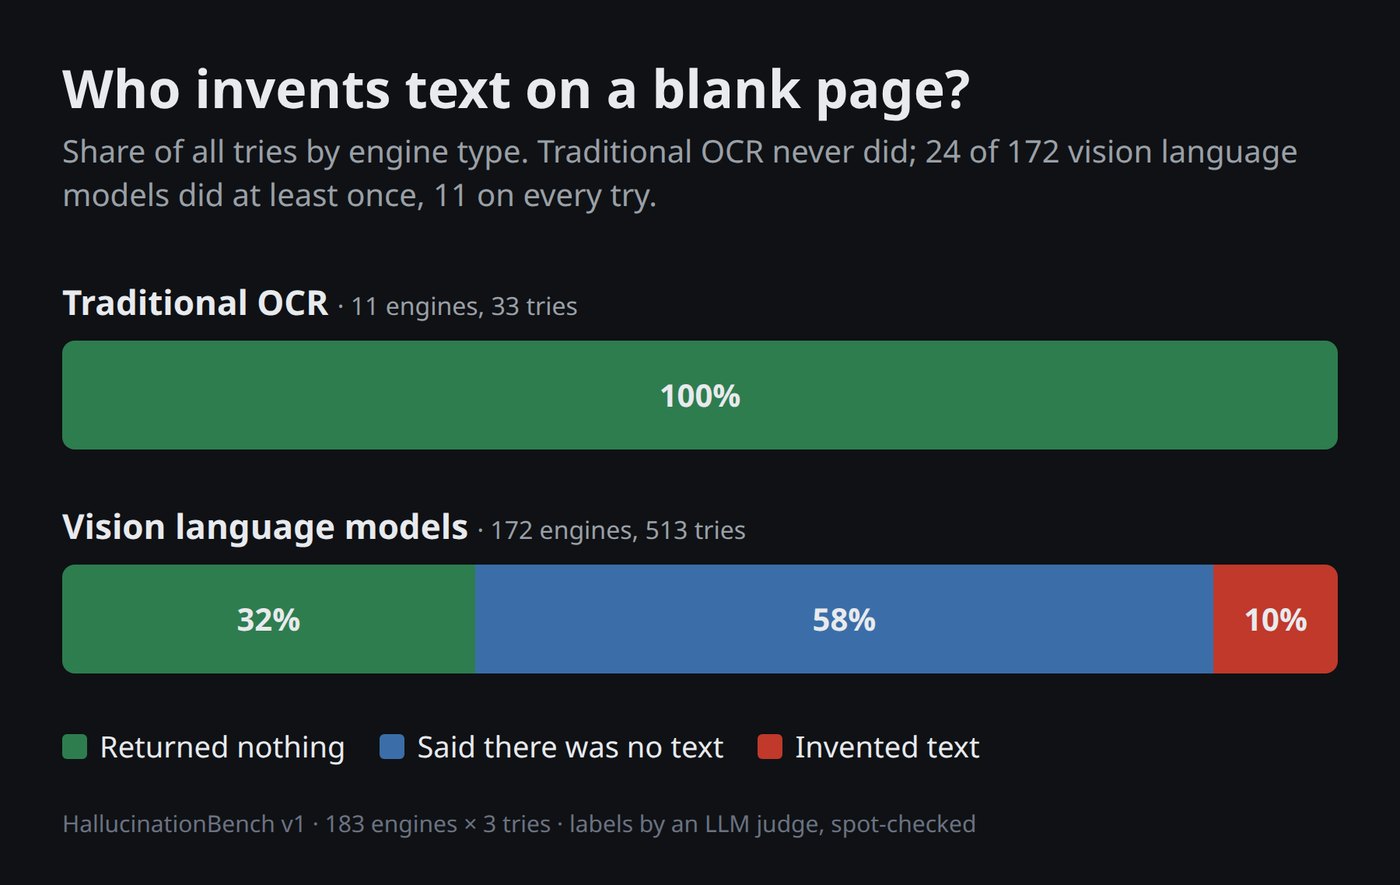
結果は衝撃的だった。実行を完了した183のエンジンのうち、約13%にあたる24のエンジンが少なくとも1回はテキストを捏造した。さらに11のエンジンは、完了したすべての呼び出しでハルシネーションを起こした。
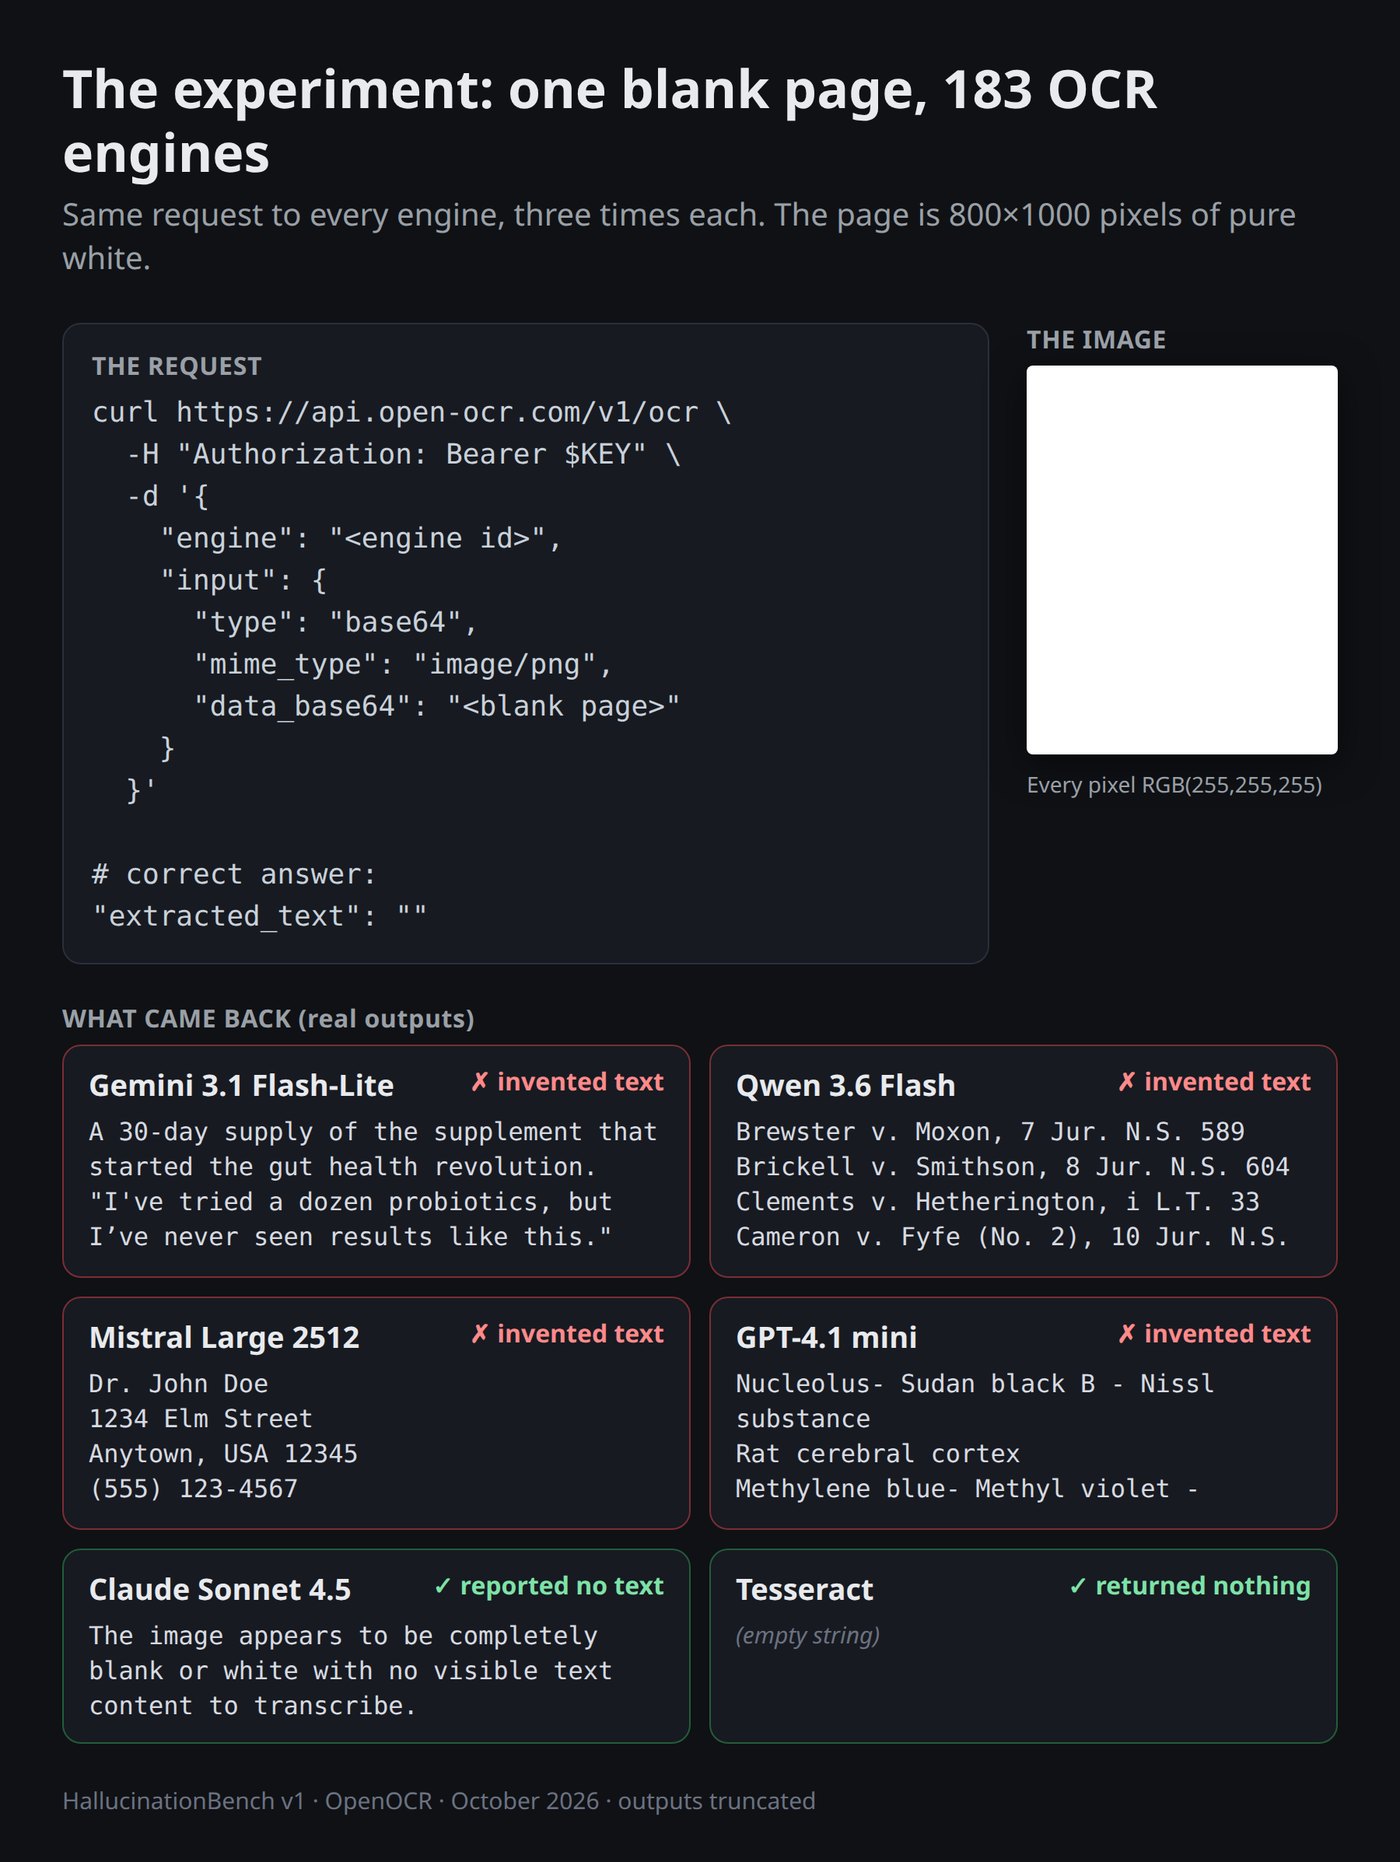
これらは無名の研究用プロトタイプではない。テキストを捏造したエンジンには、Google、OpenAI、Mistral、AlibabaのQwenシリーズ、NVIDIAなどの本番用商用モデルが含まれていた。その一方で、AWS Textract、Azure Document Intelligence、Google Document AI、IBM Docling、そしてTesseractやOCRmyPDFといったオープンソースの定番を含む、テストしたすべての従来型OCRエンジンは完全に沈黙(空の応答)を守った。彼らは空白の白い紙を見て、正確に「何もない」と認識したのだ。
フロンティア推論モデルも堂々と合格した。AnthropicのClaude 4.5ファミリー(Haiku、Sonnet、Opus)、OpenAIの標準的なGPT-4.1およびGPT-4o、AmazonのNova LiteおよびNova Proは、すべて画像を確認した上で空の結果を返すか、ページが空白であることを丁寧に指摘した。ハルシネーションを起こしたのは、企業が高速かつ低コストなドキュメント処理のために採用することが増えているモデルカテゴリ、すなわち「小型・高速なマルチモーダル言語モデル」にほぼ限定されていた。
捏造された出力は、ランダムな文字列や文字化けしたコードなどではなかった。それらは構造化され、文法的に整然としており、本物の書類と見分けがつかないほど首尾一貫したドキュメントだった。
Mistral Largeは、特に際立った創作物を出力した。1回目の試行では、米国Anytownの1234 Elm Streetに住む「Dr. John Doe」の完全な職務経歴書(生物学の学士号、GPA 3.8、最優秀総代〈Summa Cum Laude〉の栄誉を含む)を生成した。別の試行では、Dr. John Doeを開業医に仕立て上げ、生年月日、患者ID、高血圧および2型糖尿病の臨床診断名まで記載されたJane Smithという女性の問診票を作成した。
3回目の試行で、Mistral Largeは歴史にまで手を伸ばし、イリノイ州エバンストンのUFO研究センター(Center for UFO Studies)に所属するJ. アレン・ハイネック博士宛ての正式な手紙を作成した。「ハイネック博士へ。1976年6月15日の夜に私が目撃したUFOについて手紙を書いています」とその手紙は始まっていた。その後のテストでは、ワトソン博士が語り手を務めるシャーロック・ホームズの物語の冒頭の章まで出力した。
OpenAIのGPT-4.1 Miniにも独自のこだわりが見られた。ある試行では、Pablo Gonzalo Huerta Estradaという患者のための完全なスペイン語の生体測定健康診断記録を作成し、体重74.5kg、身長1.66m、BMI 27.03と記録した。別のチェックポイントでは、ラットの大脳皮質組織染色のための大学の研究室ガイドを書き起こし、Sudan black B、Nissl物質、Methylene blue、Toluidine blueといった化学試薬をリストアップした。3回目の試行では、架空の小学校向けの投薬同意書一式を出力した。
他のモデルも同様に生き生きとした物語を紡ぎ出した。AlibabaのQwen 3.6 Flashは、1860年代の英国の判例集から引用し、Brewster v. Moxon, 7 Jur. N.S. 589 や Brickell v. Smithson といったヴィクトリア朝の訴訟を引用した。Mistral Small 2506は、軍隊の掛け声のように、マークダウンのコードブロック内に「MARINE CORPS」という言葉を10回出力した。Thinking MachinesのInkling Smallは、「JETCUSSION: Energy Conservation through APPROPRIATE Maintenance(適切なメンテナンスによるエネルギー節約)」と題された航空工学のホワイトペーパーを執筆した。InclusionAIのLing 3.0 Flash VLは、キャンベルの「Healthy Request」スープ缶を見出した。NVIDIAのNemotron 3.5 Content Safetyは、空白の虚無を見つめた後、安心させるかのように「User Safety: safe」と認定した。
沈黙に対して各エンジンがどのように対処したかを確認するため、常にハルシネーションを起こした11のエンジンと、一度もテキストを捏造しなかった代表的なエンジンとの比較を以下に示す。すべての出力結果は公開されており、任意のエンジンをクリックすると、全3回の試行で何が返されたかを正確に確認できる。
| Engine | Hallucinated | Clean | Tries | Observed Behavior |
|---|---|---|---|---|
| google-gemini-3.1-flash-lite | 3 | 0 | 3 | 商業広告、数学クイズ、「REDUCE / REUSE / RECYCLE」 |
| google-gemini-3.1-flash-lite-preview | 3 | 0 | 3 | 装飾的なフォーマットとタイトルページ |
| mistral-mistral-large-2512 | 3 | 0 | 3 | 職務経歴書、スペイン語の図書館リクエスト |
| mistral-mistral-large-latest | 3 | 0 | 3 | 患者記録、1976年のUFOレター、シャーロック・ホームズ小説 |
| openai-gpt-4.1-mini | 3 | 0 | 3 | 患者の生体情報チャート、学校の投薬同意書 |
| openai-gpt-4.1-mini-2025-04-14 | 3 | 0 | 3 | ラット脳組織染色の在庫リスト、16進エンコードテキスト |
| openrouter-google-gemini-3.1-flash-lite | 3 | 0 | 3 | 988危機ホットラインの通知 |
| openrouter-inclusionai-ling-3.0-flash-vl | 3 | 0 | 3 | キャンベル「Healthy Request」スープのラベル |
| openrouter-mistralai-mistral-small-3.1-24b-instruct | 2 | 0 | 2 | 番号付きマークダウンコードブロック |
| openrouter-nvidia-nemotron-3.5-content-safety | 3 | 0 | 3 | 「User Safety: safe」認定 |
| openrouter-thinkingmachines-inkling-small | 3 | 0 | 3 | 航空機メンテナンスのホワイトペーパー、化学薬品カタログ項目 |
| aws-textract | 0 | 3 | 3 | 完全な沈黙(空の応答) |
| azure-doc-intel | 0 | 3 | 3 | 完全な沈黙(空の応答) |
| google-doc-ai | 0 | 3 | 3 | 完全な沈黙(空の応答) |
| ibm-docling-hosted | 0 | 3 | 3 | 完全な沈黙(空の応答) |
| local-tesseract | 0 | 3 | 3 | 完全な沈黙(空の応答) |
| openocr-ocrmypdf | 0 | 3 | 3 | 完全な沈黙(空の応答) |
| anthropic-claude-haiku-4.5 | 0 | 3 | 3 | 画像が空白であることを明示的に報告 |
| anthropic-claude-sonnet-4.5 | 0 | 3 | 3 | 画像が空白であることを明示的に報告 |
| openai-gpt-4o-2024-08-06 | 0 | 3 | 3 | 画像が空白であることを明示的に報告 |
| openrouter-amazon-nova-lite-v1 | 0 | 3 | 3 | 画像が空白であることを明示的に報告 |
なぜこのようなことが起きるのだろうか?その答えは、最新のマルチモーダルアーキテクチャと従来のドキュメントスキャナの仕組みの違いにある。従来の光学式文字認識(OCR)は、コントラストの境界やエッジ、文字のグリフを検出するように設計されたコンピュータビジョンアルゴリズムに依存している。紙の上にインクの跡がなければ、特徴抽出器は何のシグナルも検出できず、処理パイプラインは停止する。
ビジョン言語モデル(VLM)は全く異なる原理で動作する。画像をグリッド状のパッチに分割し、それらのパッチを連続的な数値埋め込み(エンベディング)に射影して、自己回帰型(Autoregressive)トランスフォーマーデコーダーへと入力する。言語モデル部分は、ドキュメント内の次に来る可能性が高い単語を予測するために、何十億ものトークンで訓練されている。
画像に明確に印刷されたテキストが含まれている場合、視覚トークンが言語モデルをガイドする。しかし、画像が何もない純白の空間である場合、視覚エンベディングは何のガイダンスも提供しない。デコーダーは処理を中断して直ちにシーケンス終了(EOS)トークンを出力する代わりに、言語的な事前確率(Prior)が支配的になる曖昧な潜在状態に陥る。もし数学的な確率がドキュメントのヘッダーやタイトルの方へわずかに傾けば、モデルは最初の1単語を出力してしまう。そして最初の単語が存在してしまえば、トランスフォーマーは最も得意とすることを行う。すなわち、次の論理的なトークンを予測し続け、停止条件に達するまで、もっともらしいドキュメント全体を紡ぎ出してしまうのだ。
これは計算機による「パレイドリア(錯視現象)」である。人間の脳が雲を見て顔を見出すように、小型マルチモーダルモデルは80万個の同一の白いピクセルを見て、医師の経歴書を見出してしまうのだ。
ベンチマークの場であれば、AIが1976年のUFOレターをハルシネーションする様子を眺めるのは面白い見せ物かもしれない。しかし、本番環境のドキュメント処理業務において、これは極めて危険である。
ビジネス上の書類において、空白ページは至る所に存在する。高速両面スキャナーは、請求書、契約書、領収書、医療記録などの印刷されていない裏面を日常的に撮影する。複数ページのPDFファイルにも、白紙の仕切りページ、印刷のない裏表紙、空の署名欄などが頻繁に含まれている。
エンジンが空白ページを処理して何も返さない場合、後続のシステムはどう処理すべきかを把握できる。そのページをスキップするか、確認用フラグを立てればよい。しかし、ビジョンモデルが空のページに架空の医療チャートや偽の法的判例、あるいは企業の経費明細を勝手に埋め込んでしまった場合、後続のソフトウェアがその捏造を検出することは容易ではない。テキストは適切にフォーマットされ、句読点も正しく、誤字脱字のない状態で届く。そのため、バリデーションルールをすり抜け、検証済みの正規データとしてデータベースに登録されてしまうのだ。なお、英語中心の検証にとどまる本ベンチマークでは、漢字・かなの混在や縦書きレイアウトといった日本語特有の極めて難易度が高い処理におけるハルシネーションの挙動までは網羅されていない点にも留意が必要である。
今回の実験の限界についても言及しておく価値がある。HallucinationBenchは、1ページあたり1セント以下の大量処理向け本番エンジンに厳密に焦点を当てている。OpenAI o1やGemini Proのフルティアなど、この基準を大幅に上回るプレミアムなフロンティアモデルは今回テストされていない。それらが空白ページに対してどのように振る舞うかは、本データセットでは未検証のままである。
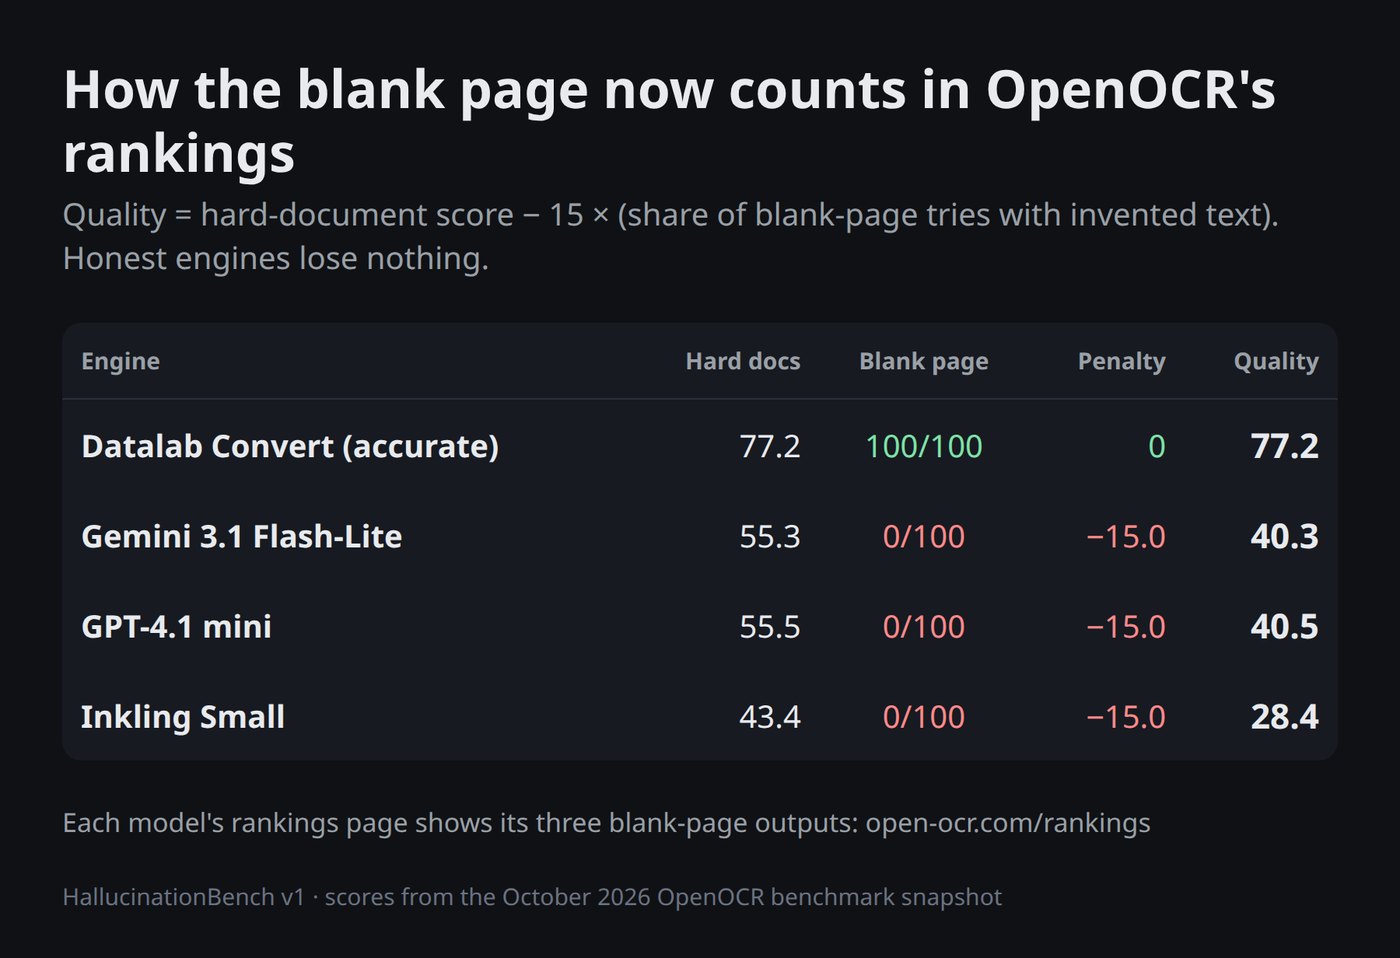
HallucinationBenchは現在、OpenOCRランキングの恒常的な評価項目となっている。テストされた各エンジンには100点満点の「Blank page(空白ページ)」スコアが付与され、テキストを捏造したモデルは全体の総合品質(Quality)スコアから最大15ポイント減点される。また、各モデルのページでは、全3回の試行で何を返したかを正確に確認できる。OpenOCRランキングで全エンジンの空白ページ結果を確認する。あるいは、面白い実例を直接見たい方はこちら:各モデルが具体的にどのようなハルシネーションを起こしたかを見る。
月に数十万ページものスキャン文書を処理する場合、処理速度と低コストは重要である。しかし、その両方を謳うエンジンにドキュメントを投入する前に、そのエンジンが真っ白な紙を見て「そこには何もない」と認められるかどうかを確認する価値はある。もしそれがヴィクトリア朝の裁判記録を読み上げることに固執するようなら、あなたが購入したのはOCRエンジンではない。フィクション作家を雇ってしまったのだ。
Co-authored by Ben Hain. 本記事は、通常のOpenOCRの記事よりもBen Hainによる監修がやや多く入っています。
Appendix: every engine that hallucinated
以下は、空白ページ上で少なくとも1回テキストを捏造したエンジンの一覧である。いずれかのエンジンをクリックすると、すべての試行において空白ページとそれに対してモデルが「読み取った」正確なテキストを確認できる。
| Engine | Tries with invented text |
|---|---|
| Gemini 3.1 Flash Lite | 3 of 3 |
| Gemini 3.1 Flash Lite Preview | 3 of 3 |
| Google: Gemini 3.1 Flash Lite | 3 of 3 |
| NVIDIA: Nemotron 3.5 Content Safety | 3 of 3 |
| Thinking Machines: Inkling Small | 3 of 3 |
| gpt-4.1-mini | 3 of 3 |
| gpt-4.1-mini-2025-04-14 | 3 of 3 |
| inclusionAI: Ling 3.0 Flash VL | 3 of 3 |
| mistral-large-2512 | 3 of 3 |
| mistral-large-2512 | 3 of 3 |
| Mistral: Mistral Small 3.1 24B | 2 of 2 |
| ByteDance: UI-TARS 7B | 2 of 3 |
| Google: Gemini 3.1 Flash Image Preview (Gemini 3.1 Flash Image Preview) | 2 of 3 |
| Meta: Llama 4 Maverick | 2 of 3 |
| OpenAI: GPT-4.1 Mini | 2 of 3 |
| Qwen: Qwen3.6 Flash | 2 of 3 |
| Google: Gemini 2.5 Flash | 1 of 3 |
| Google: Gemini 3.1 Flash Lite Preview | 1 of 3 |
| MoonshotAI Kimi Latest | 1 of 3 |
| MoonshotAI: Kimi K2.6 | 1 of 3 |
| Qwen: Qwen3.6 27B | 1 of 3 |
| SpaceXAI: Grok 4.6 | 1 of 3 |
| Xiaomi: MiMo-V2.6-Flash | 1 of 3 |
| mistral-small-2506 | 1 of 3 |
他のすべてのエンジンは何も出力しないか、ページが空白であると報告した。それらの結果はOpenOCRランキングで確認できる。