Tres modelos de IA entraron y diseñaron sus propias redes OCR desde cero
Basado en: LLM-Driven AutoML for Cross-Lingual Handwritten OCR: Closed-Loop Neural Architecture Search with GPT-5, GPT-4o, and Claude Sonnet 4 — Mobina Kashaniyan, Amirhossein Ghassemi, Nasser Mozayani
Imagina la forma habitual en que un equipo de investigación construye un reconocedor de escritura a mano. Alguien lee veinte artículos, elige un tronco convolucional, discute con un compañero de laboratorio sobre si añadir una capa de atención, ejecuta una búsqueda de hiperparámetros durante la noche y repite ese ciclo durante semanas. Ahora imagina saltarte todo eso: le entregas a GPT-5 un montón de muestras de escritura a mano en árabe, persa e inglés, junto con un script de entrenamiento, y él mismo diseña la red, la entrena, analiza la puntuación y la rediseña, una y otra vez, sin que ningún humano toque la arquitectura en ningún momento.
Esto es exactamente lo que hizo un nuevo artículo de investigadores de la Universidad Iraní de Ciencia y Tecnología. No como un experimento mental, sino como 270 ejecuciones separadas en tres modelos: GPT-5, GPT-4o y Claude Sonnet 4. Cada uno actuó como su propio "arquitecto" independiente, proponiendo una red neuronal, observando su entrenamiento, leyendo los resultados y ajustando el rumbo para el siguiente intento. Ningún humano seleccionó el número de capas. Ningún humano ajustó la tasa de aprendizaje. Ningún humano escribió un preprocesamiento específico del idioma para las letras conectadas del árabe o los diacríticos adicionales del persa.
El mejor modelo que produjeron alcanzó una precisión del 98,1 %. El promedio de las 270 ejecuciones se mantuvo por encima del 93 %. Y las redes resultantes ejecutaban la inferencia en 41 a 44 milisegundos, lo suficientemente rápido para un producto real, no solo para una tabla de referencia. Si esto es una capacidad genuinamente nueva o una forma sofisticada de hacer lo que las herramientas de AutoML ya hacían, merece la pena profundizar, porque la respuesta cambia lo que debes extraer de ello.
Por qué la escritura árabe, persa e inglesa no siguen las mismas reglas
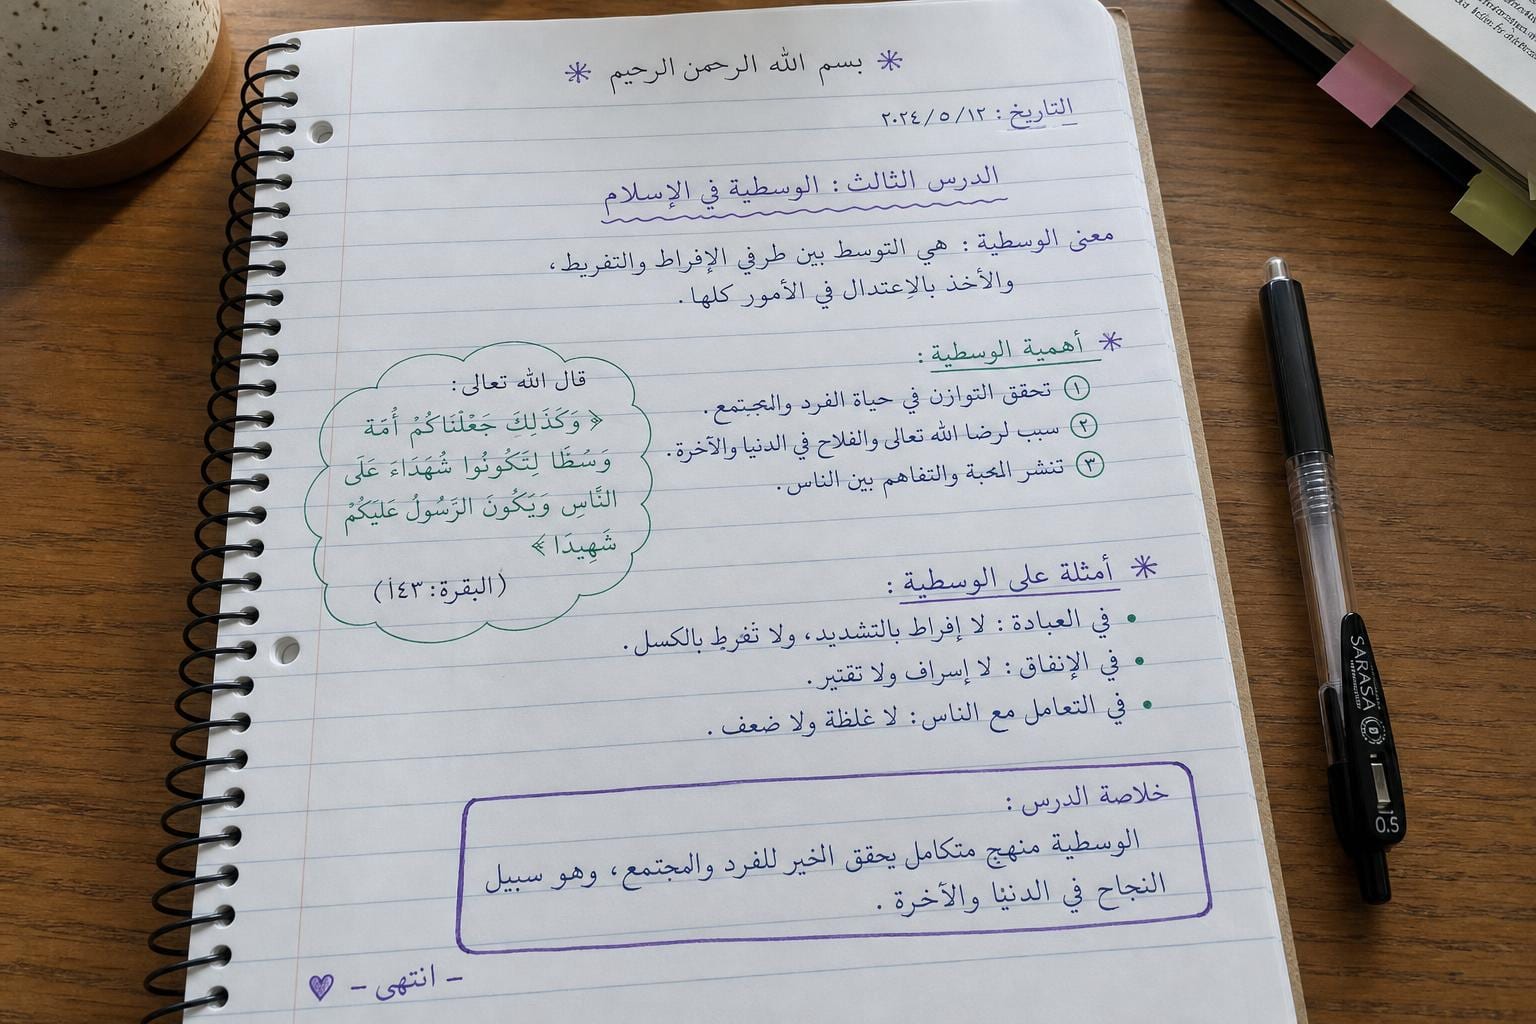
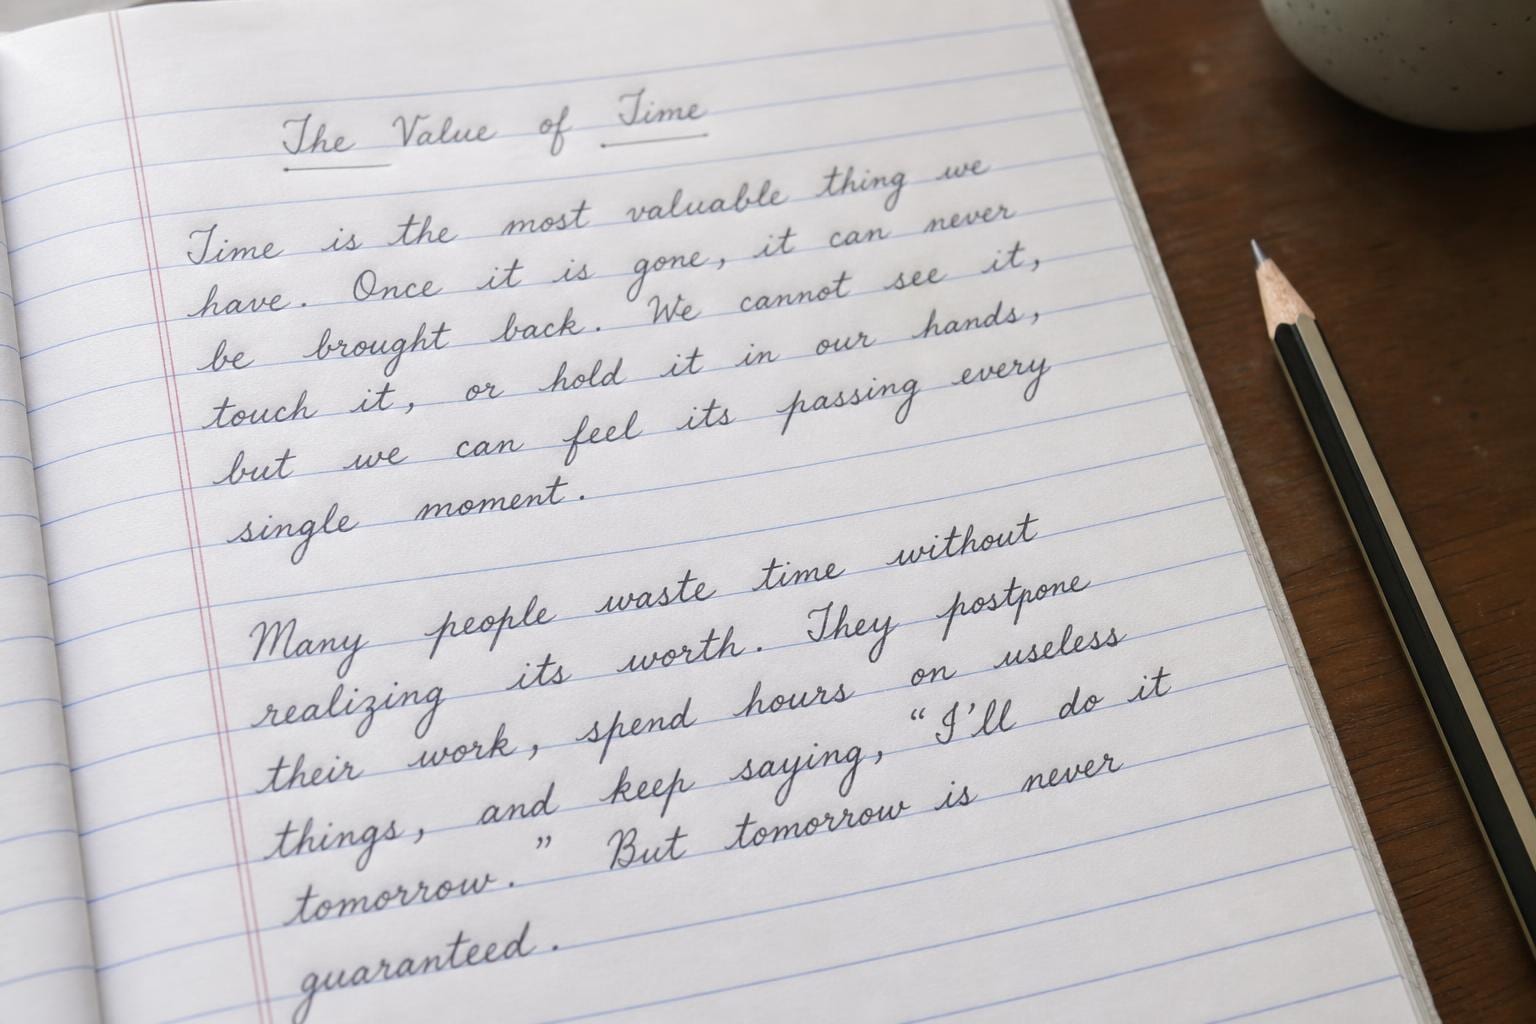
El reconocimiento de escritura a mano ya es más difícil que la lectura de texto impreso, y el reconocimiento de escritura a mano multilingüe multiplica la dificultad. La cursiva inglesa varía enormemente según el escritor, pero al menos las letras son formas separadas, relativamente verticales, con formas fijas. El árabe y el persa rompen la mayoría de los supuestos en los que se basaría un modelo entrenado con escritura inglesa.
Ambos sistemas de escritura se escriben de derecha a izquierda, y la mayoría de las letras cambian de forma dependiendo de si se encuentran al inicio, en medio o al final de una palabra, ya que se conectan con sus vecinas como un trazo fluido continuo en lugar de bloques discretos. Los pequeños puntos sobre o debajo de una letra suelen ser lo único que distingue un carácter de otro, por lo que una pequeña mancha o un trazo apresurado puede convertir una «b» en una «t». El persa añade sus propias letras adicionales y convenciones diacríticas sobre el alfabeto base árabe, lo que significa que un modelo ajustado para el árabe no se transfiere directamente.
Tradicionalmente, manejar tres scripts tan diferentes implica tres pipelines separados: preprocesamiento distinto, lógica de segmentación diferente y, a veces, familias de modelos completamente distintas. Eso es mucha infraestructura que mantener, y es exactamente por lo que «un modelo, tres scripts, sin ajuste manual» es la afirmación interesante en este artículo, no el número de precisión por sí solo.
Cómo hacer que una IA diseñe su propia red neuronal
La configuración que describen los investigadores es un bucle cerrado, lo que significa que la salida de cada paso se alimenta directamente en la entrada del siguiente sin intervención humana. Así es como funciona:
- Se le da a un LLM una descripción de la tarea (reconocer texto manuscrito en un idioma objetivo) y se le pide que proponga una arquitectura de red neuronal en forma de código.
- Esa arquitectura se entrena en el conjunto de datos de escritura manuscrita.
- Los resultados del entrenamiento (precisión, pérdida, quizás latencia) se retroalimentan al mismo LLM.
- El LLM lee esos resultados y propone una arquitectura revisada, intentando corregir lo que falló o aumentar la precisión.
- Repetir.
Esta es una técnica conocida llamada búsqueda de arquitectura neuronal (NAS), que normalmente funciona haciendo que un algoritmo pruebe mecánicamente miles de pequeñas variaciones en una red y conserve las que obtengan mejores puntuaciones. Lo diferente aquí es que el "algoritmo" que hace las propuestas es un modelo de lenguaje de propósito general que razona en algo más cercano al lenguaje natural sobre qué probar a continuación, en lugar de un procedimiento de búsqueda diseñado específicamente para ello. Piense en la diferencia entre un algoritmo genético que muta arquitecturas al azar y un colega que observa sus últimos tres experimentos y dice: "la precisión disminuyó cuando añadiste esa capa de pooling extra, probemos ensanchar las convoluciones en su lugar". Uno es prueba y error a ciegas a gran escala. El otro se aproxima más al razonamiento, o al menos a la generación de texto con forma de razonamiento.
Ejecutar esto 270 veces en tres modelos diferentes es lo que hace que el artículo sea más que una anécdota. Es evidencia de que el bucle funciona de manera bastante consistente, en lugar de acertarlo una vez y escribir un artículo sobre la ejecución afortunada.
Lo que el resumen no detalla, y esto es importante, es exactamente cómo se distribuyeron esas 270 ejecuciones entre los tres modelos y tres idiomas, cómo se ven las arquitecturas descubiertas realmente, qué tamaño tenían los conjuntos de datos o cómo se compararon directamente las propuestas de GPT-5 con las de Claude Sonnet 4 en la misma tarea. Esos son los detalles que le dirían si un modelo es un "arquitecto" notablemente mejor que los demás, y por ahora esa comparación no es pública.
Las cifras: 93 % de media, 98,1 % en el mejor caso y una comprobación en 44 milisegundos
Quitando el proceso de en medio y mirando lo que sale al otro lado, una precisión media en las pruebas superior al 93 % en 270 experimentos independientes es un suelo sólido, no un techo seleccionado a dedo. Sugiere que el ciclo cerrado converge de forma fiable en algo funcional, en lugar de encontrar la solución correcta solo de vez en cuando.
La cifra del 98,1 % en el mejor caso es la que se citará, y es genuinamente fuerte para el texto manuscrito multilingüe, una categoría en la que los sistemas de OCR de texto impreso (que ya están maduros y son muy precisos) ni siquiera intentan competir, porque la escritura a mano es un problema completamente distinto. Para ponerlo en contexto, los transcritores humanos también cometen errores al leer una caligrafía desordenada en un alfabeto que no conocen. Lograr que una canalización totalmente automatizada alcance ese rango sin que un humano toque la arquitectura es un resultado real.
La cifra de latencia podría ser el detalle más importante en la práctica de todo el resumen. Un modelo que obtiene un 98 % pero tarda dos segundos por imagen es una curiosidad de investigación. Uno que se ejecuta en 41 a 44 milisegundos es lo suficientemente rápido como para colocarse detrás de una API y procesar un formulario escaneado mientras alguien espera la respuesta. Esa es la diferencia entre una "demo impresionante" y "algo que podrías lanzar realmente".
Lo que falta, y es una laguna real, es un desglose por idioma y por modelo. Una media superior al 93 % podría significar que los tres idiomas se agrupan estrechamente alrededor de ese número, o podría significar que el inglés eleva la media mientras el árabe o el persa se quedan atrás. Sin esa división, no se puede saber si la afirmación de "multilingüe" se mantiene uniformemente o si un solo alfabeto está haciendo todo el trabajo pesado.
Por qué importa para quien construye o elige OCR
Si estás evaluando motores OCR para un producto, la conclusión principal aquí no es realmente "la IA puede alcanzar el 98 por ciento en escritura a mano". Es que el proceso de construir un reconocedor especializado para un nuevo script o dominio podría estar volviéndose más barato de iniciar. Hoy, si necesitas un reconocedor de escritura a mano para un idioma para el cual nadie ha construido aún buenas herramientas, te enfrentas a un proyecto de investigación: recopilar datos, contratar a alguien que conozca el script, iterar sobre la arquitectura durante meses. Un ciclo cerrado como este apunta hacia un futuro en el que ese primer paso tome días en lugar de meses, con un modelo de propósito general realizando la búsqueda de arquitectura inicial antes de que un humano tome el control para el refinamiento.
Dicho esto, hay algunas cosas que vale la pena tener en perspectiva antes de emocionarse con "la IA diseña su propio modelo OCR" como una característica del producto:
- Esto es búsqueda de arquitectura, no un producto lanzado. El artículo demuestra que los LLM pueden proponer y refinar diseños de redes. No dice nada sobre cómo estos modelos manejan escaneos ruidosos del mundo real, manchas de café, fotos de teléfono de baja resolución o la gran variedad de calidad de escritura a mano que verías de usuarios reales en lugar de un benchmark curado.
- El AutoML de ciclo cerrado ha existido durante años sin LLMs. La búsqueda de arquitectura neuronal no es nueva. Lo nuevo es intercambiar el algoritmo de búsqueda por un modelo de lenguaje. Si ese intercambio produce arquitecturas significativamente mejores que los métodos NAS existentes, o simplemente arquitecturas que un humano encuentra más fáciles de leer y razonar, tampoco es algo que el abstract resuelva de ninguna manera.
- Tres idiomas no es "multilingüe" de la manera en que un sistema de producción necesita. Los pipelines de documentos reales ven decenas de scripts, páginas de idiomas mixtos y escritura a mano superpuesta con texto impreso o sellos. El árabe, el persa y el inglés son un conjunto de pruebas significativo y genuinamente difícil, pero no son un sustituto para toda la gama que un producto OCR general tiene que manejar.
Para una plataforma como la nuestra, construida alrededor de comparar motores OCR cara a cara, la conclusión práctica es vigilar este espacio en lugar de esperar que esté en producción mañana. Si la búsqueda de arquitectura impulsada por LLM de ciclo cerrado resulta generalizarse más allá de estos tres idiomas y más allá de datos de benchmark limpios, podría reducir el tiempo que tarda en que los nuevos motores alcancen una precisión competitiva en scripts desatendidos. Ese es el tipo de desarrollo que eventualmente aparece como una nueva opción en una tabla de comparación, no como un abstract de investigación.
Lo que el artículo aún no nos dice
Si se lee con generosidad, esta es una demostración genuinamente ingeniosa de que un LLM de propósito general puede sustituir a un algoritmo NAS construido a mano y obtener resultados respetables sin un arquitecto humano. Si se lee con escepticismo, es un resumen escaso en detalles que permitirían a cualquiera verificar o reproducir las afirmaciones.
No conocemos los tamaños ni las fuentes de los conjuntos de datos, lo cual es crucial para el reconocimiento de escritura manuscrita, ya que las cifras de precisión varían enormemente dependiendo de si un benchmark utiliza muestras limpias de un solo escritor o conjuntos desordenados de múltiples escritores que se asemejan a lo que vería un producto real. No sabemos cómo se distribuyeron los 270 experimentos entre los tres modelos y los tres idiomas, por lo que no hay manera de saber si GPT-5 superó a Claude Sonnet 4 como diseñador de arquitecturas, o si un idioma arrastró el promedio hacia abajo mientras los otros lo sostenían. No hay comparación con métodos NAS existentes ni con reconocedores de escritura manuscrita diseñados a mano, por lo que "esto es mejor que lo anterior" no es algo que el resumen afirme realmente, aunque sea la interpretación natural. Y no hay discusión sobre el costo computacional: ejecutar 270 ciclos de entrenamiento completos, cada uno precedido por una llamada a un LLM, no es gratis, y saber si este enfoque es lo suficientemente eficiente como para importar comercialmente depende enteramente de números que no tenemos a la vista.
Nada de eso borra la parte interesante. Utilizar un LLM de propósito general como diseñador de arquitecturas iterativo, en lugar de construir un algoritmo de búsqueda a medida para cada nueva tarea, es un cambio real en cómo podría funcionar el NAS en el futuro. Simplemente vale la pena recordar que una precisión promedio sólida y un número de inferencia rápido son el comienzo de una evaluación, no el final. El artículo que realmente convencería a un equipo de producción para adoptar este enfoque sería el que incluya los detalles del conjunto de datos, el desglose por idioma y una comparación cara a cara con los métodos NAS ya en uso. Hasta que aparezca esa versión, esto es una prueba de concepto prometedora, no un resultado definitivo.