Três modelos de IA entraram e projetaram suas próprias redes de OCR do zero
Baseado em: LLM-Driven AutoML for Cross-Lingual Handwritten OCR: Closed-Loop Neural Architecture Search with GPT-5, GPT-4o, and Claude Sonnet 4 — Mobina Kashaniyan, Amirhossein Ghassemi, Nasser Mozayani
Imagine a IA projetando redes neurais sozinha
Imagine a maneira usual como uma equipe de pesquisa constrói um reconhecedor de escrita à mão. Alguém lê vinte artigos, escolhe uma arquitetura convolucional, discute com um colega de laboratório sobre se deve adicionar uma camada de atenção, executa uma busca de hiperparâmetros durante a noite e repete esse ciclo por semanas. Agora, imagine pular tudo isso: você entrega ao GPT-5 uma pilha de amostras de escrita à mão em árabe, persa e inglês, junto com um script de treinamento, e ele projeta a rede neural sozinho, treina-a, analisa o resultado e a redesenha, repetidamente, sem que nenhum humano toque na arquitetura em nenhum momento.
Isso é o que um novo artigo de pesquisadores da Universidade Iraniana de Ciência e Tecnologia realmente fez. Não como um experimento mental, mas como 270 execuções separadas em três modelos: GPT-5, GPT-4o e Claude Sonnet 4. Cada um atuou como seu próprio "arquiteto" independente, propondo uma rede neural, observando seu treinamento, lendo os resultados e ajustando a rota para a próxima tentativa. Nenhum humano escolheu o número de camadas. Nenhum humano ajustou a taxa de aprendizado. Nenhum humano escreveu pré-processamento específico para o idioma, como as letras conectadas do árabe ou os diacríticos extras do persa.
O melhor modelo que produziram atingiu 98,1% de precisão. A média de todas as 270 execuções permaneceu acima de 93%. E as redes resultantes executaram a inferência em 41 a 44 milissegundos, rápido o suficiente para um produto real, não apenas para uma tabela de benchmarks. Se isso é uma capacidade genuinamente nova ou apenas uma maneira sofisticada de fazer o que as ferramentas de AutoML já faziam, vale a pena investigar, porque a resposta muda o que você deve extrair disso.
Por que a caligrafia árabe, persa e inglesa não segue as mesmas regras
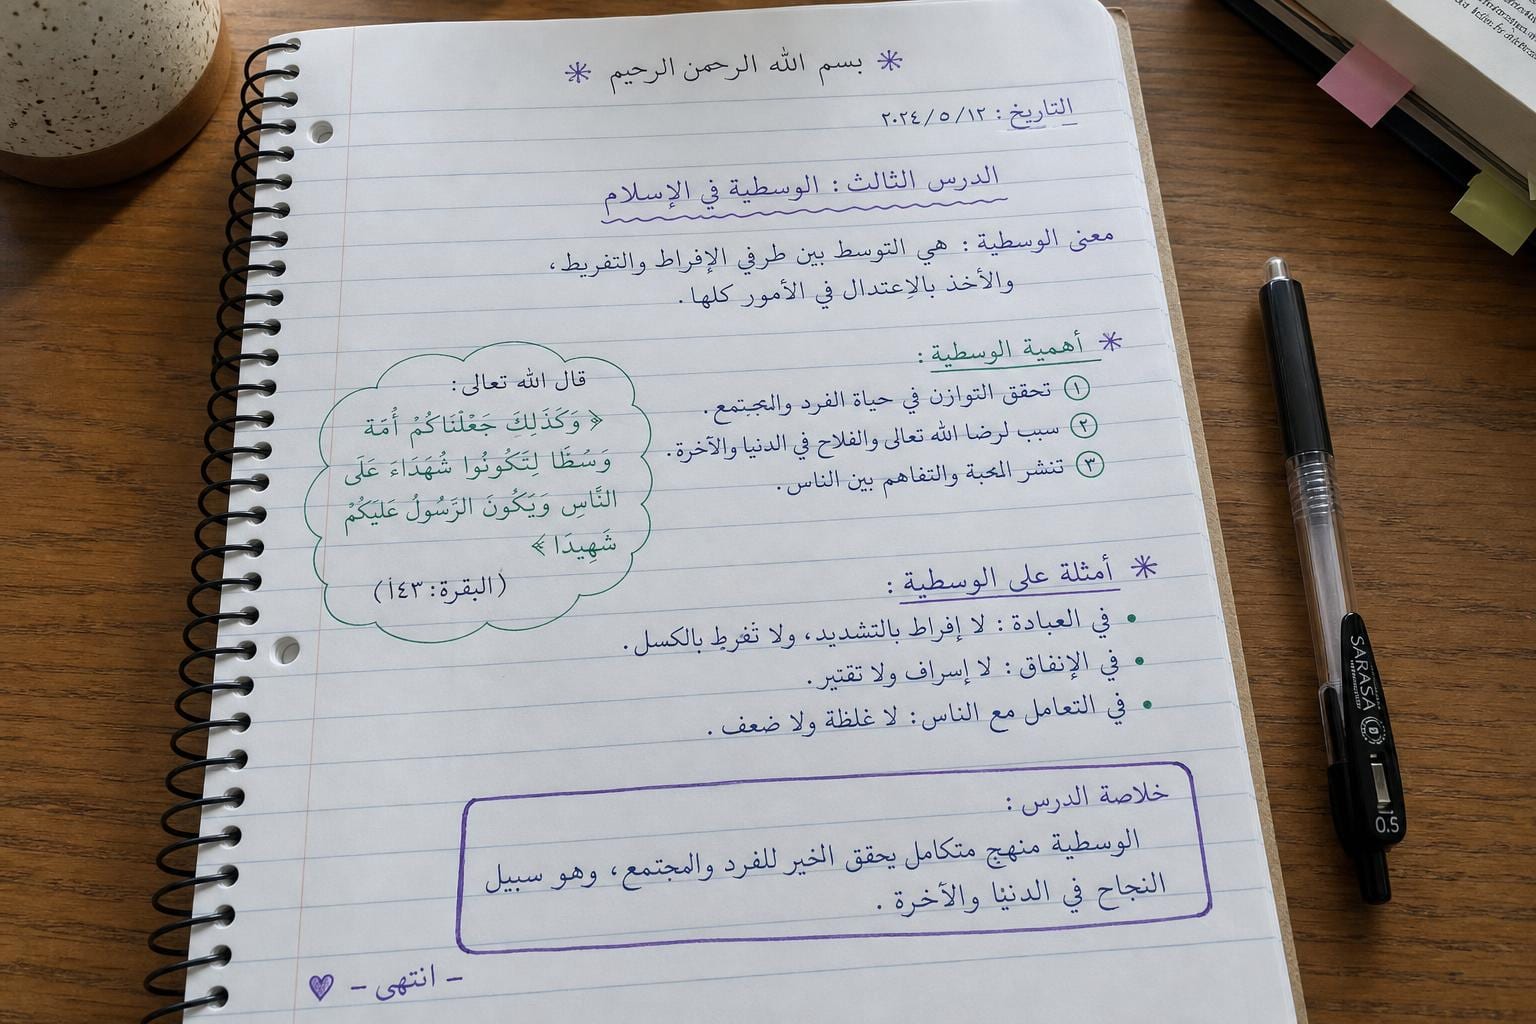
O reconhecimento de caligrafia já é mais difícil do que a leitura de texto impresso, e o reconhecimento de caligrafia multilíngue multiplica essa dificuldade. A caligrafia cursiva em inglês varia enormemente de escritor para escritor, mas pelo menos as letras são formas separadas, relativamente verticais e com formatos fixos. O árabe e o persa quebram a maioria das suposições nas quais um modelo treinado em caligrafia inglesa se basearia.
Ambos os sistemas de escrita são escritos da direita para a esquerda, e a maioria das letras muda de forma dependendo se estão no início, meio ou fim de uma palavra, já que se conectam aos vizinhos como um único traço fluido em vez de blocos discretos. Pequenos pontos acima ou abaixo de uma letra são frequentemente a única coisa que distingue um caractere de outro, de modo que uma pequena mancha ou um traço de caneta apressado pode transformar um "b" em um "t". O persa adiciona suas próprias letras extras e convenções de diacríticos sobre o alfabeto base árabe, o que significa que um modelo ajustado para o árabe não se transfere diretamente.
Tradicionalmente, lidar com três scripts tão diferentes significa três pipelines separados: pré-processamento diferente, lógica de segmentação diferente e, às vezes, famílias de modelos inteiramente distintas. Isso representa uma quantidade considerável de infraestrutura para manter, e é exatamente por isso que a afirmação interessante deste artigo é "um modelo, três scripts, sem ajuste manual", e não apenas o número de precisão por si só.
Como fazer uma IA realmente projetar sua própria rede neural
A configuração descrita pelos pesquisadores é um ciclo fechado, o que significa que a saída de cada etapa alimenta diretamente a entrada da próxima, sem intervenção humana. Eis como funciona:
- O LLM recebe uma descrição da tarefa (reconhecer texto manuscrito em um idioma alvo) e é solicitado a propor uma arquitetura de rede neural em forma de código.
- Essa arquitetura é treinada no conjunto de dados de escrita manuscrita.
- Os resultados do treinamento (precisão, perda, talvez latência) são enviados de volta ao mesmo LLM.
- O LLM lê esses resultados e propõe uma arquitetura revisada, tentando corrigir o que deu errado ou aumentar a precisão.
- Repetir.
Esta é uma técnica conhecida chamada busca de arquitetura neural (NAS), que normalmente funciona fazendo um algoritmo testar mecanicamente milhares de pequenas variações em uma rede e manter o que obtiver a melhor pontuação. O que é diferente aqui é que o "algoritmo" responsável por propor as arquiteturas é um modelo de linguagem de propósito geral, que raciocina em algo mais próximo da linguagem natural sobre o que tentar a seguir, em vez de um procedimento de busca feito sob medida. Pense na diferença entre um algoritmo genético que muta arquiteturas aleatoriamente e um colega que analisa seus últimos três experimentos e diz: "a precisão caiu quando você adicionou aquela camada de pooling extra, vamos tentar alargar as convoluções". Um é tentativa e erro cega em escala. O outro é mais próximo do raciocínio, ou pelo menos da geração de texto com formato de raciocínio.
Executar isso 270 vezes em três modelos diferentes é o que torna o artigo mais do que uma anedota. É evidência de que o ciclo funciona de forma razoavelmente consistente, em vez de acertar uma única vez e escrever um artigo sobre a execução sortuda.
O que o resumo não detalha, e isso é importante, é exatamente como essas 270 execuções foram divididas entre os três modelos e os três idiomas, como são as arquiteturas descobertas, qual era o tamanho dos conjuntos de dados ou como as propostas do GPT-5 se compararam diretamente às do Claude Sonnet 4 na mesma tarefa. Esses são os detalhes que indicariam se um modelo é um "arquiteto" notavelmente melhor que os outros, e no momento essa comparação não é pública.
Os números: média de 93%, melhor resultado de 98,1% e uma verificação rápida de 44 milissegundos
Ignore o processo e observe o que saiu do outro lado. Uma precisão média nos testes superior a 93% em 270 experimentos independentes representa um piso sólido, não um teto selecionado a dedo. Isso sugere que o ciclo fechado converge de forma confiável para algo funcional, em vez de ocasionalmente acertar em cheio.
O número de 98,1% no melhor caso é aquele que será citado, e é genuinamente forte para texto manuscrito multilíngue, uma categoria em que os sistemas de OCR de texto impresso (que já são maduros e altamente precisos) nem sequer tentam competir, pois a caligrafia é um problema completamente diferente. Para contextualizar, transcritores humanos também cometem erros ao ler caligrafia confusa em um alfabeto desconhecido. Colocar um pipeline totalmente automatizado nessa faixa sem que um humano toque na arquitetura é um resultado real.
O número de latência pode ser o detalhe mais importante na prática de todo o resumo. Um modelo que pontua 98%, mas leva dois segundos por imagem, é uma curiosidade de pesquisa. Um que roda em 41 a 44 milissegundos é rápido o suficiente para ficar atrás de uma API e processar um formulário escaneado enquanto alguém aguarda a resposta. Essa é a diferença entre "demonstração impressionante" e "algo que você realmente poderia lançar".
O que está faltando, e é uma lacuna real, é uma divisão por idioma e por modelo. Uma média acima de 93% pode significar que os três idiomas se agrupam firmemente em torno desse número, ou pode significar que o inglês eleva a média enquanto o árabe ou o persa ficam para trás. Sem essa divisão, não é possível saber se a alegação de "multilíngue" se mantém uniformemente ou se um alfabeto está fazendo o trabalho pesado.
Por que isso importa para quem está construindo ou escolhendo OCR
Se você está avaliando motores de OCR para um produto, a conclusão principal aqui não é realmente "a IA pode atingir 98% de precisão em manuscritos". É que o processo de construir um reconhecedor especializado para um novo script ou domínio pode estar ficando mais barato para iniciar. Hoje, se você precisa de um reconhecedor de manuscritos para um idioma para o qual ninguém ainda construiu boas ferramentas, você está olhando para um projeto de pesquisa: reunir dados, contratar alguém que conheça o script, iterar na arquitetura por meses. Um ciclo fechado como esse aponta para um futuro em que essa primeira passagem levará dias em vez de meses, com um modelo de propósito geral fazendo a busca inicial de arquitetura antes que um humano assuma para o refinamento.
Dito isso, algumas coisas valem a pena manter em perspectiva antes de se entusiasmar com "a IA projeta seu próprio modelo de OCR" como um recurso de produto:
- Esta é uma busca de arquitetura, não um produto lançado. O artigo demonstra que LLMs podem propor e refinar designs de rede. Ele não diz nada sobre como esses modelos lidam com escaneamentos reais e ruidosos, manchas de café, fotos de celular de baixa resolução ou a enorme variedade de qualidade de manuscrito que você veria de usuários reais, em vez de um benchmark curado.
- AutoML de ciclo fechado existe há anos sem LLMs. A busca por arquitetura neural não é nova. O que é novo é substituir o algoritmo de busca por um modelo de linguagem. Se essa substituição produz arquiteturas significativamente melhores do que os métodos existentes de NAS, ou apenas arquiteturas que um humano acha mais fáceis de ler e raciocinar, não é algo que o resumo resolva de qualquer maneira.
- Três idiomas não é "multilíngue" da maneira que um sistema de produção precisa. Pipelines reais de documentos veem dezenas de scripts, páginas de idiomas mistos e manuscritos sobrepostos com texto impresso ou carimbos. Árabe, persa e inglês são um conjunto de teste significativo e genuinamente difícil, mas eles não são um substituto para toda a gama que um produto OCR geral tem que lidar.
Para uma plataforma como a nossa, construída em torno da comparação de motores de OCR cara a cara, a conclusão prática é observar este espaço em vez de esperar que ele esteja em produção amanhã. Se a busca de arquitetura de ciclo fechado, impulsionada por LLMs, acabar se generalizando além desses três idiomas e além de dados de benchmark limpos, ela poderia reduzir o tempo que os novos motores levam para atingir precisão competitiva em scripts subatendidos. Esse é o tipo de desenvolvimento que eventualmente aparece como uma nova opção em uma tabela de comparação, não como um resumo de pesquisa.
O que o artigo ainda não nos diz
Lido de forma generosa, este é um demonstração genuinamente inteligente de que um LLM de propósito geral pode substituir um algoritmo de NAS construído manualmente e obter resultados respeitáveis sem um arquiteto humano. Lido com ceticismo, é um artigo abstrato, leve em detalhes que permitiriam a qualquer pessoa verificar ou reproduzir as alegações.
Não sabemos os tamanhos ou as fontes dos conjuntos de dados, o que é extremamente importante para o reconhecimento de escrita à mão, uma vez que as métricas de precisão variam drasticamente dependendo se um benchmark usa amostras limpas de um único escritor ou conjuntos desordenados de múltiplos escritores que se assemelham ao que um produto real enfrentaria. Não sabemos como os 270 experimentos foram divididos entre os três modelos e os três idiomas, portanto, não há como saber se o GPT-5 superou o Claude Sonnet 4 como projetista de arquitetura, ou se um idioma arrastou a média para baixo enquanto os outros a sustentaram. Não há comparação com métodos de NAS existentes ou com reconhecedores de escrita à mão projetados manualmente, portanto, "isto é melhor do que o que veio antes" não é algo que o resumo realmente alegue, embora seja a interpretação natural. E não há discussão sobre o custo computacional: executar 270 ciclos de treinamento completos, cada um precedido por uma chamada de LLM, não é gratuito, e saber se essa abordagem é eficiente o suficiente para importar comercialmente depende inteiramente de números que não estão à nossa frente.
Nada disso apaga a parte interessante. Usar um LLM de propósito geral como um projetista de arquitetura iterativo, em vez de construir um algoritmo de busca personalizado para cada nova tarefa, é uma mudança real em como o NAS pode funcionar no futuro. Basta lembrar que uma alta precisão média e um número rápido de inferência são o início de uma avaliação, não o fim. O artigo que realmente convenceria uma equipe de produção a adotar essa abordagem seria aquele com os detalhes do conjunto de dados, a divisão por idioma e uma comparação direta com os métodos de NAS já em uso. Até que essa versão apareça, este é uma prova de conceito promissora, não um resultado consolidado.