دخل ثلاثة نماذج للذكاء الاصطناعي وصممت شبكات OCR الخاصة بها من الصفر
استنادًا إلى: LLM-Driven AutoML for Cross-Lingual Handwritten OCR: Closed-Loop Neural Architecture Search with GPT-5, GPT-4o, and Claude Sonnet 4 — Mobina Kashaniyan, Amirhossein Ghassemi, Nasser Mozayani
تخيل الطريقة المعتادة التي يبني بها فريق بحثي نظامًا للتعرف على الخط اليدوي. يقرأ شخص ما عشرين ورقة بحثية، ويختار عمودًا فقريًا تلافيفيًا (convolutional backbone)، ويخوض جدلاً مع زميل في المختبر حول ما إذا كان يجب إضافة طبقة انتباه (attention layer)، ويقوم بمسح للمعاملات الفائقة (hyperparameter sweep) طوال الليل، ثم يكرر هذه الحلقة لأسابيع. الآن، تخيل تخطي كل ذلك: تقدم لـ GPT-5 مجموعة من عينات الخط اليدوي بالعربية والفارسية والإنجليزية ونص برمجي للتدريب، فيقوم هو بتصميم الشبكة ذاتيًا، وتدريبها، ومراجعة النتيجة، وإعادة تصميمها، مرارًا وتكرارًا، دون أن يلمس أي إنسان البنية في أي مرحلة.
هذا ما فعلته بالفعل ورقة بحثية جديدة من باحثين في جامعة إيران للعلوم والتكنولوجيا. ليس كتجربة فكرية، بل كـ 270 تشغيلًا منفصلًا عبر ثلاثة نماذج: GPT-5، وGPT-4o، وClaude Sonnet 4. عمل كل نموذج كمهندس مستقل، مقترحًا شبكة عصبية، ومشاهدًا تدريبها، وقارئًا للنتائج، ومعدّلًا للمسار في المحاولة التالية. لم يختر أي إنسان عدد الطبقات. لم يضبط أي إنسان معدل التعلم. ولم يكتب أي إنسان معالجة مسبقة خاصة باللغة للتعامل مع الحروف المتصلة في العربية أو علامات التشكيل الإضافية في الفارسية.
حقق أفضل نموذج أنتجوه دقة بنسبة 98.1 في المئة. وبقي متوسط الأداء عبر جميع عمليات التشغيل الـ 270 فوق 93 في المئة. وشغلت الشبكات الناتجة الاستدلال (inference) في 41 إلى 44 ميلي ثانية، بسرعة كافية لتكون منتجًا حقيقيًا، وليس مجرد جدول مقارنة للمعايير. سواء كان ذلك قدرة جديدة حقيقية أو مجرد طريقة متقنة لفعل ما كانت أدوات AutoML تفعله بالفعل، فهذا الأمر يستحق التعمق فيه، لأن الإجابة تغير ما يجب أن تستخلصه منه.
لماذا لا تلتزم الخطوط اليدوية العربية والفارسية والإنجليزية بنفس القواعد
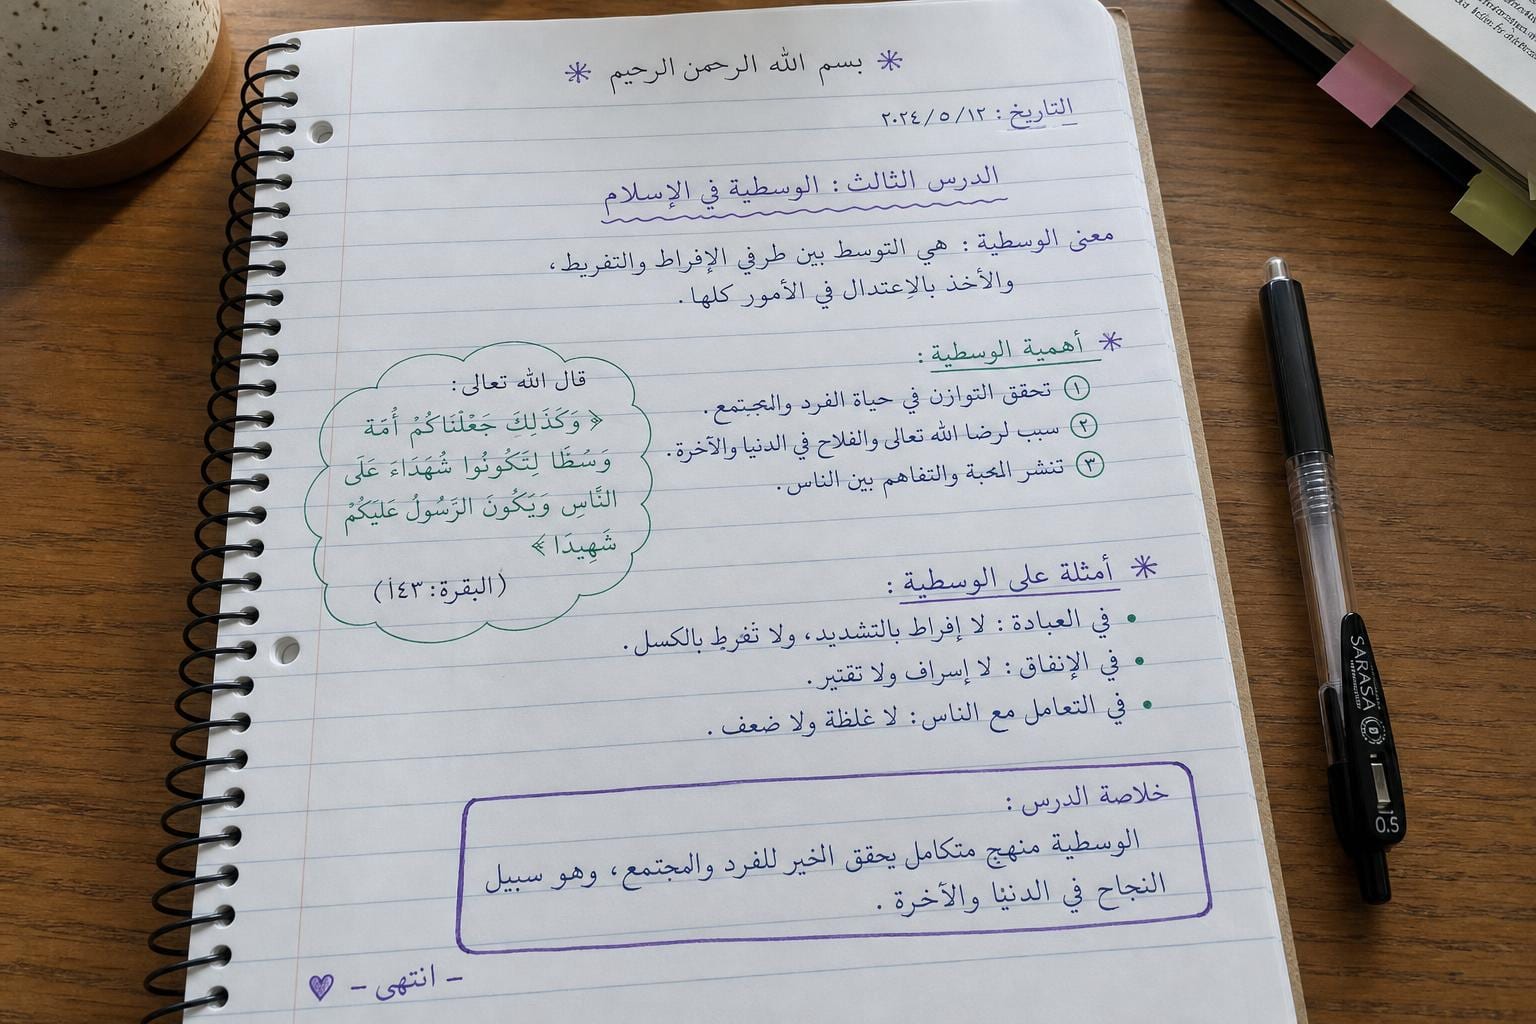
تُعدّ عملية التعرف على الخط اليدوي أصعب من قراءة النص المطبوع، وتضاعف عملية التعرف على الخطوط اليدوية عبر اللغات من هذه الصعوبة. يختلف الخط الإنجليزي المتصل بشكل كبير من كاتب لآخر، لكن الحروف على الأقل تكون منفصلة، وأشكالها شبه منتصبة وثابتة. أما العربية والفارسية فتخرق معظم الافتراضات التي يعتمد عليها نموذج مُدرَّب على الخط الإنجليزي اليدوي.
تُكتب كلتا الخطّين من اليمين إلى اليسار، وتتغير أشكال معظم الحروف اعتمادًا على موقعها في بداية أو وسط أو نهاية الكلمة، لأنها تتصل بجيرانها كسطر متدفق واحد بدلاً من كتل منفصلة. غالبًا ما تكون النقاط الصغيرة فوق أو تحت الحرف هي الشيء الوحيد الذي يميز حرفًا عن آخر، لذا يمكن لبقعة صغيرة أو سطر قلم مكتوب بسرعة أن يحول حرف "ب" إلى حرف "ت". تضيف الفارسية حروفها الإضافية وقواعد التشكيل الخاصة بها فوق الأبجدية العربية الأساسية، مما يعني أن النموذج المُعدّل للعربية لا ينقل تلقائيًا إلى الفارسية.
تقليديًا، يعني التعامل مع ثلاثة خطّات مختلفة بهذا القدر وجود ثلاث خطوط معالجة منفصلة: معالجة مسبقة مختلفة، ومنطق تجزئة مختلف، وأحيانًا عائلات نماذج مختلفة تمامًا. هذا يتطلب الكثير من البنية التحتية القائمة للصيانة، وهو بالضبط السبب في أن الادعاء المثير للاهتمام في هذه الورقة هو "نموذج واحد، ثلاثة خطّات، بدون ضبط يدوي"، وليس رقم الدقة بحد ذاته.
كيف تجعل الذكاء الاصطناعي يصمم شبكته العصبية بنفسه
الإعداد الذي يصفه الباحثون هو حلقة مغلقة، مما يعني أن مخرجات كل خطوة تُغذي مباشرة مدخلات الخطوة التالية دون وجود إنسان في الوسط. إليك شكل هذه العملية:
- يتم تزويد نموذج اللغة الكبير (LLM) بوصف للمهمة (التعرف على النص المكتوب بخط اليد بلغة مستهدفة) ويُطلب منه اقتراح بنية للشبكة العصبية على شكل كود.
- يتم تدريب هذه البنية على مجموعة بيانات الخطوط اليدوية.
- تُعاد نتائج التدريب (الدقة، الخسارة، وربما زمن الاستجابة) إلى نفس نموذج اللغة الكبير.
- يقرأ نموذج اللغة الكبير هذه النتائج ويقترح بنية معدلة، محاولاً إصلاح أي مشكلة حدثت أو رفع الدقة أكثر.
- كرر العملية.
هذه تقنية معروفة تسمى البحث عن البنية العصبية (NAS)، والتي تعمل عادةً عن طريق خوارزمية تجريبية ميكانيكية لتجربة آلاف التغيرات الصغيرة على الشبكة والاحتفاظ بأفضل النتائج. ما هو مختلف هنا هو أن "الخوارزمية" التي تقوم بالاقتراح هي نموذج لغوي متعدد الأغراض يقوم بالاستدلال بلغة أقرب إلى اللغة العادية حول ما يجب تجربته تالياً، بدلاً من إجراء بحث مخصص. فكر في الفرق بين الخوارزمية الجينية التي تقوم بتغيير البنى بشكل عشوائي وزميلك الذي ينظر إلى آخر ثلاث تجارب لك ويقول "انخفضت الدقة عند إضافة طبقة التجميع الإضافية تلك، دعنا نجرب توسيع الالتفافات بدلاً من ذلك". أحدهما هو تجربة وخطأ عمياء على نطاق واسع. والآخر أقرب إلى الاستدلال، أو على الأقل توليد نص على شكل استدلال.
تشغيل هذه العملية 270 مرة عبر ثلاثة نماذج مختلفة هو ما يجعل الورقة البحثية أكثر من مجرد قصة عابرة. إنها دليل على أن الحلقة تعمل بشكل متسق إلى حد ما بدلاً من النجاح مرة واحدة وكتابة ورقة بحثية عن التجربة المحظوظة.
ما لا توضحه الملخص، وهذا أمر مهم، هو بالضبط كيف تم توزيع هذه الـ 270 تجربة عبر النماذج الثلاثة واللغات الثلاث، وما تبدو عليه البنى المكتشفة فعلياً، وما حجم مجموعات البيانات، وكيف قارنت مقترحات GPT-5 مباشرة مع مقترحات Claude Sonnet 4 في نفس المهمة. هذه هي التفاصيل التي ستخبرك ما إذا كان أحد النماذج "معماراً" أفضل بشكل ملحوظ من الآخرين، وحالياً هذا المقارنة ليست متاحة للعامة.
الأرقام: متوسط 93 في المئة، وأفضل نتيجة 98.1 في المئة، وفحص سريع يستغرق 44 مللي ثانية
تجاهل العملية وانظر إلى ما خرج من الطرف الآخر. دقة الاختبار المتوسطة التي تتجاوز 93 في المئة عبر 270 تجربة مستقلة تمثل أرضية متينة، وليست سقفًا انتقائيًا. وهذا يشير إلى أن الحلقة المغلقة تتقارب بشكل موثوق على حل عملي، بدلاً من الاعتماد على الحظ في الحصول على نتائج ممتازة بين الحين والآخر.
رقم 98.1 في المئة كأفضل حالة هو الرقم الذي سيتم الاستشهاد به، وهو رقم قوي حقًا للنص المكتوب بخط اليد متعدد اللغات، وهي فئة لا تحاول أنظمة التعرف الضوئي على الحروف المطبوعة (التي نضجت بالفعل ودقتها عالية) المنافسة فيها، لأن الكتابة بخط اليد تمثل مشكلة مختلفة تمامًا. وللتوضيح، يرتكب البشر أيضًا أخطاء عند قراءة خط يدوي غير مرتب بلغة غير مألوفة. الوصول إلى نطاق دقة كهذا عبر خط أنابيب مؤتمت بالكامل دون أن يلمس أي بشر البنية التحتية هو إنجاز حقيقي.
قد يكون رقم زمن الاستجابة (Latency) هو التفصيل الأكثر أهمية عمليًا في الملخص بأكمله. نموذج يحقق دقة 98 في المئة لكنه يستغرق ثانيتين لكل صورة يبقى مجرد فضول بحثي. أما النموذج الذي يعمل في غضون 41 إلى 44 مللي ثانية فهو سريع بما يكفي ليعمل خلف واجهة برمجة التطبيقات (API) لمعالجة نموذج مسح ضوئي بينما ينتظر المستخدم الرد. هذا هو الفرق بين "عرض تجريبي مبهر" و"منتج يمكنك فعليًا إطلاقه".
ما ينقص، وهو فجوة حقيقية، هو تفصيل النتائج لغةً بلغة ونموذجًا بنموذج. متوسط يتجاوز 93 في المئة قد يعني أن اللغات الثلاث الثلاث تتجمع بإحكام حول هذا الرقم، أو قد يعني أن اللغة الإنجليزية ترفع المتوسط بينما تتخلف العربية أو الفارسية. وبدون هذا التقسيم، لا يمكنك معرفة ما إذا كانت ادعاءات "التعدد اللغوي" تنطبق بالتساوي، أم أن لغة واحدة تقوم بجهد أكبر من غيرها.
لماذا يهم ذلك لكل من يبني أو يختار أنظمة التعرف الضوئي على الحروف (OCR)
إذا كنت تقارن محركات التعرف الضوئي على الحروف (OCR) لمنتج ما، فإن النتيجة الرئيسية هنا ليست حقاً أن "الذكاء الاصطناعي يمكنه تحقيق دقة 98 في المئة في التعرف على الكتابة اليدوية". بل إن الأمر يتعلق بأن عملية بناء مُعرِّف متخصص لنص جديد أو مجال معين قد أصبحت أرخص تكلفة من حيث التمهيد الأولي. اليوم، إذا كنت بحاجة إلى مُعرِّف للكتابة اليدوية بلغة لم يتم تطوير أدوات جيدة لها بعد، فأنت تنظر إلى مشروع بحثي: جمع البيانات، توظيف شخص يعرف النص، والتكرار على الهيكلية لشهور. يشير حلقة مغلقة مثل هذه إلى مستقبل حيث تستغرق هذه الخطوة الأولى أياماً بدلاً من أشهر، مع قيام نموذج عام بالبحث الأولي في الهيكلية قبل أن يتولى الإنسان مهمة التحسين.
ومع ذلك، هناك بعض الأشياء التي تستحق وضعها في منظورها الصحيح قبل أن تتحمس لفكرة "الذكاء الاصطناعي يصمم نموذج التعرف الضوئي على الحروف الخاص به" كميزة منتج:
- هذا بحث في الهيكلية، وليس منتجاً مُصدَّراً. يوضح الورق البحثي أن نماذج اللغة الكبيرة (LLMs) يمكنها اقتراح وتحسين تصاميم الشبكات العصبية. ولا يقول شيئاً عن كيفية تعامل هذه النماذج مع المسوحات الضوضائية في العالم الحقيقي، أو بقع القهوة، أو صور الهواتف منخفضة الدقة، أو التنوع الهائل في جودة الكتابة اليدوية التي ستراها من المستخدمين الفعليين بدلاً من مجموعة بيانات مرجعية مُنتقاة.
- تعلم الآلة التلقائي ذو الحلقة المغلقة موجود منذ سنوات دون نماذج اللغة. البحث في الهيكلية العصبية ليس جديداً. الجديد هو استبدال خوارزمية البحث بنموذج لغة. سواء كان هذا الاستبدال ينتج هياكل أفضل بشكل ملحوظ من طرق البحث في الهيكلية العصبية (NAS) الحالية، أم مجرد هياكل يسهل على الإنسان قراءتها والتفكير فيها، فإن الملخص لا يحسم الأمر في أي من الاتجاهين.
- ثلاث لغات لا تعني "عبر اللغات" بالطريقة التي يحتاجها نظام الإنتاج. ترى خطوط إنتاج المستندات الحقيقية عشرات النصوص، وصفحات متعددة اللغات، وكتابة يدوية متداخلة مع نصوص مطبوعة أو ختم. العربية والفارسية والإنجليزية تشكل مجموعة اختبار ذات معنى وصعبة حقاً، لكنها لا تمثل البديل الكامل عن النطاق الواسع الذي يتعين على منتج التعرف الضوئي على الحروف العام التعامل معه.
من أجل منصة مثل منصتنا، المبنية حول مقارنة محركات التعرف الضوئي على الحروف وجهاً لوجه، فإن الاستنتاج العملي هو مراقبة هذا المجال بدلاً من توقعه في الإنتاج غداً. إذا تبين أن البحث في الهيكلية المدعوم بنماذج اللغة وذو الحلقة المغلقة يتعمم ليشمل أكثر من هذه اللغات الثلاث ويتجاوز بيانات الاختبار النظيفة، فقد يقلل من الوقت الذي يستغرقه المحركات الجديدة للوصول إلى دقة تنافسية على النصوص غير المخدومة بشكل كافٍ. وهذا النوع من التطورات يظهر في النهاية كخيار جديد في جدول مقارنة، وليس كمجرد ملخص بحثي. تجدر الإشارة إلى أن طبيعة النص العربي، مع خطه المتصل واتجاهه من اليمين إلى اليسار وأشكال الحروف الحساسة للسياق، تجعل التعرف الضوئي على الحروف فيه تحدياً فريداً يتطلب هياكل متخصصة.
ما لم يخبرنا به البحث بعد
إذا قرأنا النص بتسامح، فهو عرض ذكي حقًا يثبت أن نموذج لغوي كبير متعدد الأغراض يمكنه أن يحل محل خوارزمية البحث المعماري العصبي (NAS) المصممة يدويًا ويحقق نتائج محترمة دون الحاجة إلى مهندس بشري. أما إذا قرأناه بشك، فهو ملخص يفتقر إلى التفاصيل التي تتيح لأي شخص التحقق من الادعاءات أو إعادة إنتاجها.
لا نعرف أحجام البيانات أو مصادرها، وهو أمر بالغ الأهمية في التعرف على الكتابة اليدوية، حيث تتأرجح أرقام الدقة بشكل كبير اعتمادًا على ما إذا كانت المعيار يستخدم عينات نظيفة من كاتب واحد، أم مجموعات فوضوية من عدة كتاب تحاكي ما قد تراه المنتجات الحقيقية. كما لا نعرف كيف تم توزيع التجارب الـ 270 عبر النماذج الثلاثة واللغات الثلاث، لذا لا يمكننا معرفة ما إذا كان GPT-5 قد تفوق على Claude Sonnet 4 كمصمم معماري، أو ما إذا كانت لغة معينة قد سحبت المتوسط للأسفل بينما حملت اللغات الأخرى العبء. ولا توجد مقارنة مع طرق NAS الحالية أو مع محركات التعرف على الكتابة اليدوية المصممة يدويًا، لذا فإن عبارة "هذا أفضل مما سبق" ليست ادعاءً موجودًا فعليًا في الملخص، رغم أنها القراءة الطبيعية للنص. كما لا توجد مناقشة لتكلفة الحوسبة: تشغيل 270 حلقة تدريب كاملة، يسبق كل منها استدعاء لنموذج لغوي كبير، ليس أمرًا مجانيًا، ويعتمد تحديد ما إذا كانت هذه الطريقة فعالة بما يكفي لتكون ذات أهمية تجارية بالكامل على أرقام غير متاحة أمامنا.
لا يمحو أي من ذلك الجزء المثير للاهتمام. استخدام نموذج لغوي كبير متعدد الأغراض كمصمم معماري تفاعلي، بدلاً من بناء خوارزمية بحث مخصصة لكل مهمة جديدة، يمثل تحولًا حقيقيًا في طريقة عمل NAS مستقبلاً. ومن الجدير بالذكر أن دقة متوسطة قوية ومعدل استنتاج سريع هما بداية التقييم، وليس نهايته. البحث الذي سيقنع فريق الإنتاج فعليًا لاعتماد هذه الطريقة هو ذلك الذي يتضمن تفاصيل البيانات، والتحليل التفصيلي لكل لغة، ومقارنة مباشرة مع طرق NAS المستخدمة حاليًا. وحتى ظهور تلك النسخة، يظل هذا إثباتًا واعدًا للمفهوم، وليس نتيجة حاسمة.