वह वीडियो एआई जो आपके लोगो को सही ढंग से पकड़ना चाहिए
आधारित शोध-पत्र: HOMIE: Human-object Centric Video Personalization via Multimodal Intelligent Enchancement — Yiyang Cai, Nan Chen, Rongchang Xie, Junwen Pan, Chunyang Jiang, Cheng Chen, Wen Zhou, Zhenbang Sun, Wei Xue, Wenhan Luo, Yike Guo
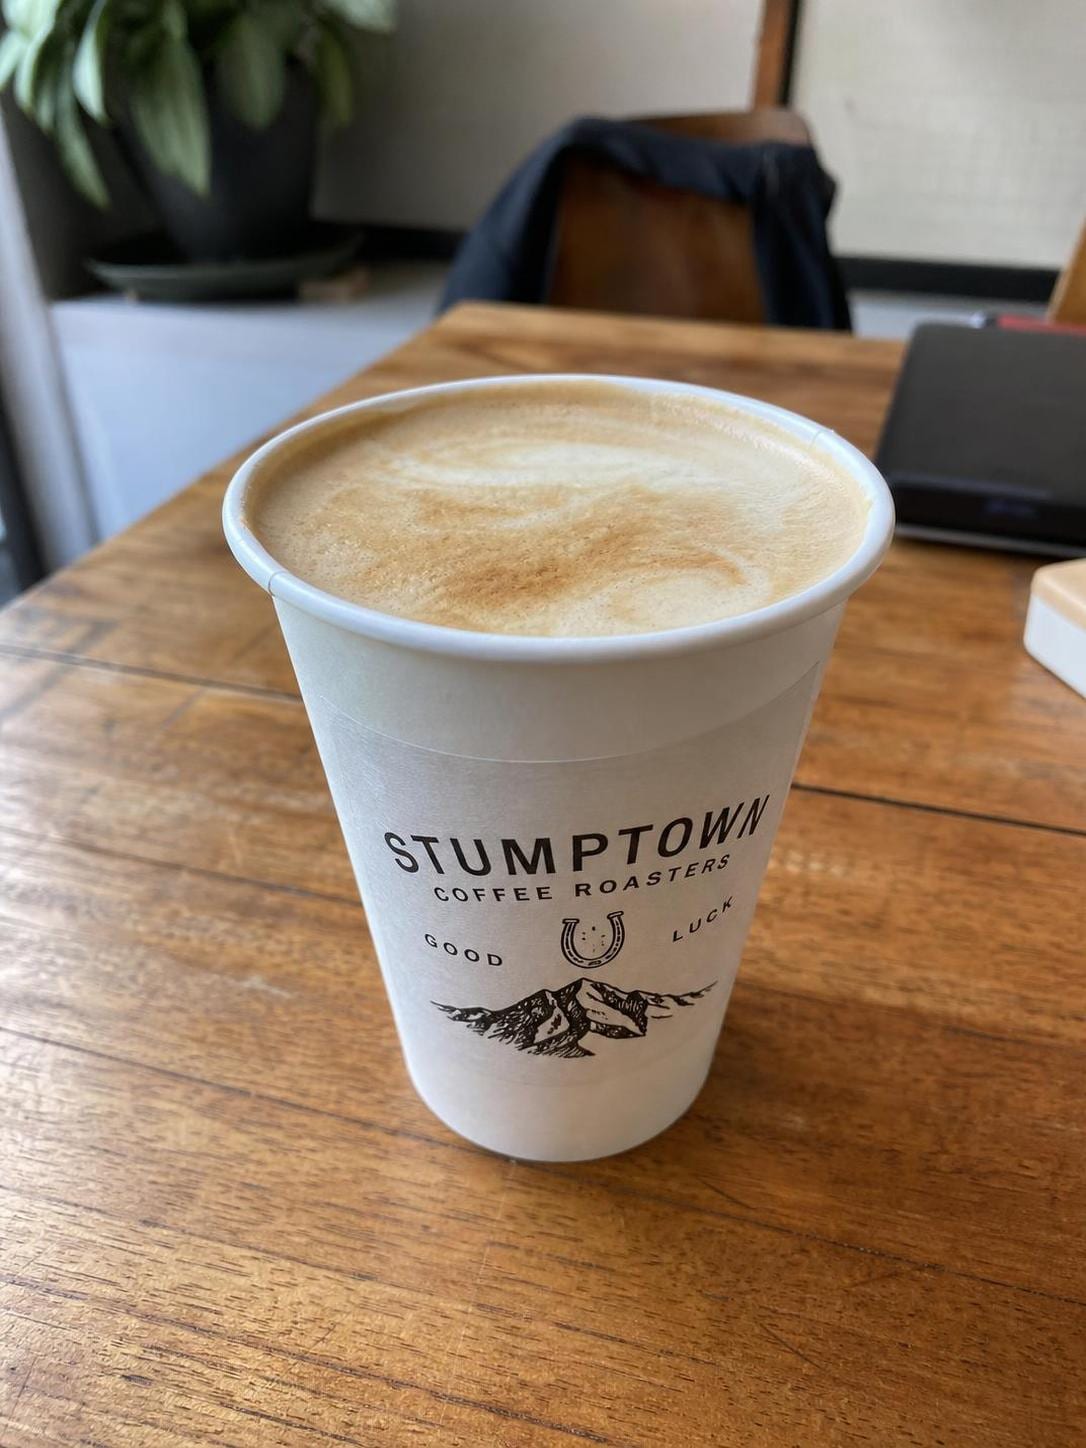
एक छोटी कॉफी ब्रांड की कल्पना करें जो एक तेज़ प्रोडक्ट वीडियो चाहती है: कोई व्यक्ति बीन्स के बैग को अनबॉक्स कर रहा है, लोगो स्पष्ट रूप से दिखाई दे रहा है, और लेबल पर रॉस्ट का नाम पढ़ा जा सकता है। उनके पास शूट के लिए बजट नहीं है, इसलिए वे एक AI वीडियो जनरेटर की ओर मुड़ते हैं, बैग की एक तस्वीर और एक मॉडल की तस्वीर फ़ीड करते हैं, और 10 सेकंड का क्लिप मांगते हैं।
वापस जो आता है, वह एक नज़र में बहुत अच्छा लगता है। हाथ सही हैं, रोशनी सही है, और व्यक्ति संदर्भ तस्वीर जैसा दिखता है। फिर आप लेबल पर ज़ूम इन करते हैं। ब्रांड नाम में एक अतिरिक्त अक्षर है। रॉस्ट की तारीख़ टेक्स्ट होने का नाटक करने वाले पिक्सेल्स का एक धब्बा है। लोगो पहचानने योग्य होने के लिए काफी करीब है, लेकिन गलत है — एक ऐसी गलती जो कोई भी ग्राहक तुरंत नोटिस कर लेगा।
"फोटोरियलिस्टिक लगना" और "टेक्स्ट वास्तव में सही होना" के बीच यह अंतर, बिल्कुल वही है जो HOMIE (मल्टीमोडल इंटेलिजेंट एन्हांसमेंट के माध्यम से ह्यूमन-ऑब्जेक्ट सेंट्रिक वीडियो पर्सनलाइज़ेशन) नामक एक नई पेपर बंद करने की कोशिश कर रही है। यह पारंपरिक अर्थ में एक OCR पेपर नहीं है। यह एक वीडियो-जनरेशन पेपर है। लेकिन इसके आर्किटेक्चर में दबा एक वास्तव में दिलचस्प कदम है: OCR आउटपुट को अंतिम उत्पाद के बजाय, एक जनरेटिव मॉडल के लिए स्टीयरिंग व्हील के रूप में उपयोग करना। अगर आप OCR के साथ काम करते हैं, तो यह उलटा होना समझने योग्य है।
"मानव-वस्तु केंद्रित वीडियो व्यक्तिगतकरण" वास्तव में क्या मांग रहा है
इस पेपर के कार्य का पूरा नाम HOCVP है: मानव-वस्तु केंद्रित वीडियो व्यक्तिगतकरण (human-object centric video personalization)। यदि हम इसकी तकनीकी भाषा को हटा दें, तो इसका अर्थ यह है: किसी विशिष्ट व्यक्ति की एक तस्वीर और किसी विशिष्ट वस्तु की एक तस्वीर को देखकर, एक वीडियो उत्पन्न करें जहाँ वह व्यक्ति उस वस्तु के साथ प्रभावशाली ढंग से अंतर्क्रिया (interact) कर रहा हो, चाहे प्रॉम्प्ट में कुछ भी वर्णित हो।
यह उस वीडियो-जनरेशन डेमो से एक स्तर ऊपर है जिसे आपने शायद पहले ही देखा होगा। उनमें से अधिकांश एकल संदर्भ छवि (जैसे एक व्यक्ति) लेते हैं और उसे एनिमेट करते हैं। HOCVP को एक साथ दो अलग-अलग संदर्भों (एक मानव और एक वस्तु) को संभालना होता है, और दोनों की उपस्थिति (appearance) और अंतर्क्रिया को सही करना होता है। मॉडल को यह जानना होता है कि कॉफी का बैग किस तरह से पकड़ा जाता है, गिटार को सही हाथ की स्थिति के साथ कैसे बजाया जाता है, और किसी के हाथ में पकड़ी गई वस्तु हर फ्रेम में उसी वस्तु के रूप में पहचान योग्य बनी रहे, न कि किसी सामान्य चीज़ में बदल जाए।
पेपर अपने संदर्भ इनपुट को दो श्रेणियों में विभाजित करता है, और यह भेद बाकी डिज़ाइन को समझने के लिए महत्वपूर्ण है:
- अंतर-विषय संदर्भ (Inter-subject references): मानव और वस्तु की अलग-अलग तस्वीरें जो पहली बार संयोजित की जा रही हैं, जैसे एक मॉडल की तस्वीर और एक उत्पाद की तस्वीर।
- अंतः-विषय संदर्भ (Intra-subject references): एक ही विषय की कई तस्वीरें, जैसे किसी उत्पाद की तीन कोणों से ली गई तस्वीरें, या किसी उत्पाद की तस्वीर जो उसकी लेबल के OCR रीडिंग के साथ जोड़ी गई हो।
अधिकांश पूर्व कार्य पहले मामले को उचित ढंग से संभालते हैं और दूसरे मामले को ज्यादातर नजरअंदाज करते हैं। यही वह अंतराल है जिस पर HOMIE का ध्यान केंद्रित है।
वस्तुओं की समस्या जो वास्तव में वस्तुएं नहीं हैं
यही वह हिस्सा था जिसने मुझे चौंका दिया: पेपर ने लोगो को एक कठिन केस के रूप में अलग किया है, और यह इसलिए कठिन है क्योंकि जब तक आप इसे ज़ोर से न कहें, तब तक इसका कारण स्पष्ट नहीं होता। लोगो कोई ऐसी वस्तु नहीं है जिसे आप उठा सकें। यह एक निशान है जिसे किसी अन्य चीज़ पर सही तरीके से स्थानित होना होता है।
यदि आप किसी वीडियो मॉडल से कहते हैं कि दृश्य में "नाइकी लोगो" डाल दे, तो आप उससे एक मेज़ पर रखी भौतिक वस्तु को रेंडर करने के लिए नहीं कह रहे हैं। आप उससे तर्क करने के लिए कह रहे हैं कि लोगो किस सतह पर होना चाहिए: एक जूते पर, एक शर्ट पर, एक कप पर, या एक टोपी पर, और फिर कैमरे के चलने के साथ उसे सही पैमाने, कोण और पठनीयता के साथ वहां रखने के लिए कह रहे हैं। यह अमूर्त तर्क का एक चरण है जिसे अधिकांश वीडियो डिफ्यूज़न मॉडल्स बनाने के लिए कभी डिज़ाइन नहीं किया गया था, क्योंकि उनका प्रशिक्षण उन्हें पिक्सल पुनर्निर्माण करना सिखाता था, यह नहीं कि कंपनी की पहचान के लिए एक निशान कहाँ जाना चाहिए।
पेपर का उत्तर एक मल्टीमोडल लार्ज लैंग्वेज मॉडल, या MLLM, पर भरोसा करना है, जो एक ऐसा मॉडल है जो छवियों और पाठ को एक साथ ले सकता है और यह तर्क कर सकता है कि वह क्या देख रहा है, ठीक उसी श्रेणी का मॉडल जो GPT-4V या जेमिनी (Gemini) की विज़न सुविधाओं जैसे उपकरणों के पीछे है। इसे एक लोगो की तस्वीर और "इसे उस चीज़ पर जोड़ो जिस पर यह तार्किक रूप से हो सकता है" वाक्यांश दें, और यह एक शुद्ध इमेज-टू-वीडियो पाइपलाइन की तुलना में इस अनुमान को उसी तरह कर सकता है।
यह पेपर की चतुर आधी बात है। दूसरी आधी बात OCR के प्रति किसी भी व्यक्ति के लिए अधिक करीबी है: जब मॉडल को एक संदर्भ छवि से इसे पुनः उत्पन्न करना होता है, तो छोटे पाठ को पठनीय रखना।
जहाँ OCR वापस चित्र में आता है
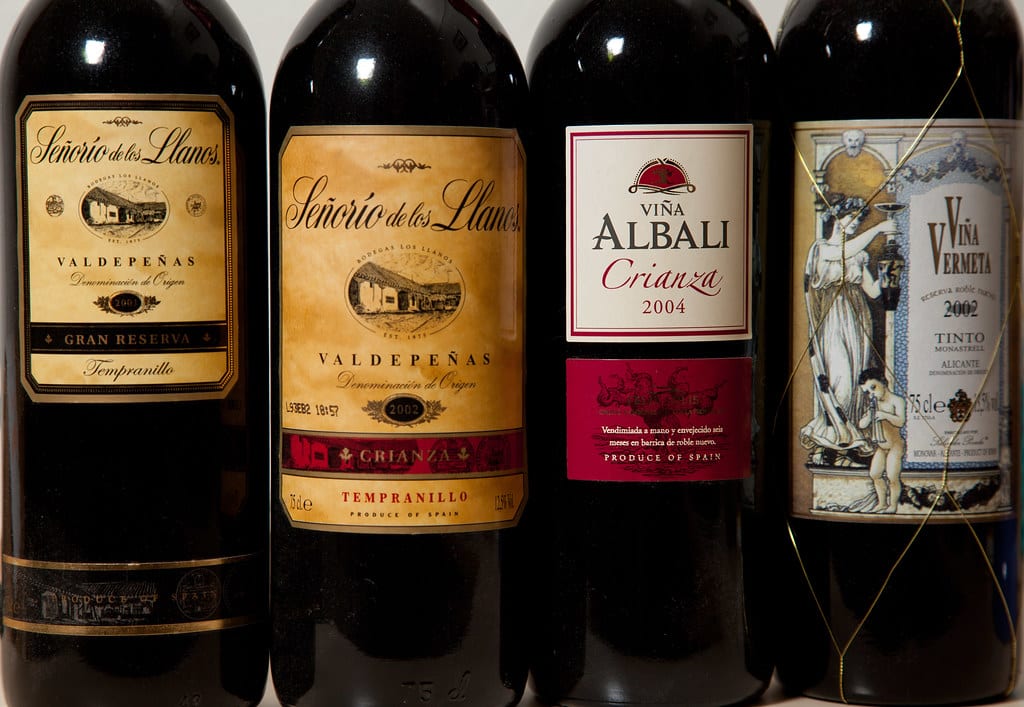
डिफ्यूजन मॉडल, जो अधिकांश आधुनिक छवि और वीडियो जनरेशन के पीछे के मॉडल परिवार हैं, छोटे टेक्स्ट के मामले में प्रसिद्ध रूप से खराब हैं। यदि आप किसी से स्ट्रीट साइन या बुक कवर बनाने के लिए कहें, तो आपको आमतौर पर एक संभावनापूर्ण दिखने वाला धुंधलापन मिलेगा, जिसमें अक्षर ठीक से नहीं बनते हैं। मॉडल को एक रेफरेंस फोटो देना मदद करता है, लेकिन यह समस्या को पूरी तरह से हल नहीं करता, क्योंकि मॉडल को अभी भी फ्रेम-दर-फ्रेम अनुमान लगाना होता है कि ठीक-ठीक कौन से पिक्सेल कौन से अक्षर बनाते हैं।
HOMIE का समाधान मॉडल को रेफरेंस छवि के साथ-साथ एक OCR मैप देना है: लेबल पर क्या टेक्स्ट है और वह लगभग कहाँ स्थित है, इसका एक संरचित निष्कर्ष, जो वीडियो जनरेशन शुरू होने से पहले ही एक OCR सिस्टम द्वारा तैयार किया जाता है। मॉडल से टेक्स्ट को केवल पिक्सेल से रिवर्स-इंजीनियर करने के लिए कहने के बजाय, उसे उत्तर पत्र पहले ही मिल जाता है और उसे केवल सही स्टाइल में, सही कोण पर, और सही रोशनी में इसे रेंडर करने की चिंता करनी होती है।
यह पेपर के समग्र फ्रेमिंग में एक छोटी सी बात है, लेकिन यह वह बात है जो OCR-केंद्रित पाठक का ध्यान खींचनी चाहिए। यह OCR आउटपुट के किसी अन्य मॉडल द्वारा उपभोग का एक साफ उदाहरण है, न कि किसी इंसान द्वारा स्क्रीन पढ़ने का। उस अपस्ट्रीम OCR चरण की सटीकता अंतिम वीडियो के लेबल टेक्स्ट कितना अच्छा हो सकता है, इसकी एक कठोर सीमा बन जाती है। कचरा अंदर, कचरा रेंडर।
प्रोजेक्ट 365(2) दिन 290 — कीथ विलियमसन द्वारा flickr के माध्यम से, BY 2.0।
अंतिम रूप से सब कुछ कैसे जुड़ता है
यहाँ का इंजीनियरिंग चुनौती "क्या हमें MLLM का उपयोग करना चाहिए" नहीं, बल्कि यह है कि बिना किसी को तोड़े वीडियो डिफ्यूजन मॉडल में इसे कैसे जोड़ा जाए। दो विकल्प मौजूद हैं, और दोनों के वास्तविक खर्च हैं।
आप MLLM की समझ को टेक्स्ट एन्कोडर के माध्यम से रूट कर सकते हैं, वह घटक जो आपके प्रॉम्प्ट को डिफ्यूजन मॉडल द्वारा क्रियान्वित करने योग्य कुछ में बदल देता है। लेकिन टेक्स्ट एन्कोडर भाषा के लिए बनाए गए हैं, इमेज-लेवल सेमैंटिक रीजनिंग के लिए नहीं, इसलिए उस पाइप के जरिए रेफरेंस-इमेज समझ को जबरन डालने से मॉडल की टेक्स्ट प्रॉम्प्ट को वास्तव में फॉलो करने की क्षमता कमजोर हो जाती है।
या आप एक एडेप्टर को पुनः प्रशिक्षित कर सकते हैं जो MLLM की आंतरिक फीचर्स को डिफ्यूजन मॉडल के अपने टोकन स्पेस में प्रोजेक्ट करता है, एक प्रक्रिया जिसे पेपर "लागतपूर्ण पुनः-संरेखण" (costly re-alignment) कहता है। यह काम करता है, लेकिन इसका प्रशिक्षण महंगा है और गलत करना आसान है, और पिछले HOCVP तरीके जो इसे करने की कोशिश करते थे, वे पेपर के उस हिस्से का हिस्सा हैं जिसके खिलाफ पेपर खुद को स्थापित कर रहा है।
HOMIE तीसरा रास्ता चुनता है: यह MLLM की फीचर्स को सीधे वीडियो मॉडल के सेल्फ-एटेंशन लेयर्स में इंजेक्ट करता है, वह तंत्र जिसका उपयोग ट्रांसफॉर्मर हर टोकन को हर दूसरे टोकन को देखने और यह तय करने के लिए करता है कि क्या प्रासंगिक है। MLLM की रेफरेंस इमेजेस की सेमैंटिक समझ डिफ्यूजन मॉडल की अपनी विजुअल टोकन (जिन्हें VAE टोकन कहा जाता है, क्योंकि वे वेरिएशनल ऑटोएन्कोडर से आती हैं जो इमेजेस को डिफ्यूजन मॉडल की वर्किंग रिप्रेजेंटेशन में कंप्रेस करती हैं) के बिल्कुल बगल में होती है, और एटेंशन तंत्र उन्हें सीधे एक-दूसरे को प्रभावित करने की अनुमति देता है। दो अलग-अलग फीचर स्पेस के बीच एक पुल को पुनः प्रशिक्षित करने की कोई आवश्यकता नहीं है, न ही किसी टेक्स्ट एन्कोडर के माध्यम से रूटिंग करने की जो इसके लिए बनाया गया नहीं था।
कैच: एक बार जब आप MLLM फीचर्स और VAE टोकन को एक ही एटेंशन लेयर में डंप कर देते हैं, तो मॉडल को उन्हें अलग करने का कोई तरीका चाहिए। यह पेपर द्वारा मॉडैलिटी-रेफरेंस एम्बेडिंग (modality-reference embedding) कहा जाने वाले काम का हिस्सा है, एक टैग जो हर टोकन को जोड़ा जाता है यह मार्क करने के लिए कि यह कहाँ से आया है, चाहे वह कच्चा विजुअल कंटेंट हो, MLLM-डेरिव्ड सेमैंटिक समझ हो, या एक रेफरेंस इमेज जो उसी विषय का एक अलग कोण दिखा रही हो। इसे इस तरह सोचें जैसे एक मीटिंग में हर टोकन पर एक नाम टैग हो जहाँ तीन बहुत अलग विभाग उपस्थित हुए थे। टैग के बिना, एटेंशन के पास "यह उस मॉडल से आया है जो समझता है कि लोगो क्या है" को "यह असली प्रोडक्ट फोटो का एक पिक्सेल है" से अलग तरीके से वेट करने का कोई तरीका नहीं है।
डेमो वास्तव में क्या दिखाते हैं
गवेषणा पत्र सामान्यतः HOCVP (Human-Object Co-Viewpoint Prediction) कार्यों पर अत्याधुनिक (state-of-the-art) परिणामों की रिपोर्ट करता है, हालांकि मैंने जो सामग्री इकट्ठा की थी, उसमें एक स्पष्ट संख्यात्मक बेंचमार्क तालिका शामिल नहीं थी, बल्कि केवल SkyReels-A2, BindWeave, UniVideo और VINO जैसे चार मौजूदा प्रणालियों के विरुद्ध गुणात्मक वीडियो तुलनाएं थीं। डेमो चार परिदृश्यों में विभाजित हैं जो सीधे तौर पर पत्र के अपने फ्रेमवर्क पर खड़े हैं: सामान्य मानव-वस्तु अंतर्क्रिया, संभाव्य सतहों पर लोगो व्यक्तिगतकरण, एक ही उत्पाद के कई संदर्भ कोणों में बहु-दृश्य सुसंगति, और उत्पाद पैकेजिंग पर OCR-मैप-संचालित पाठ विश्वसनीयता।
उदाहरण व्यावसायिक झुकाव रखते हैं: कॉफी के कप, चॉकलेट बार, पोटैटो चिप्स के पैकेट, दूध के कार्टन, कोई गिटार बजा रहा है या ब्रांडेड उत्पाद पकड़े हुए बिल्ली को सहला रहा है, सभी को अधिकतम 1280x720 रिज़ॉल्यूशन और लाइवस्ट्रीम-शैली सामग्री के लिए उपयुक्त ऊर्ध्वाधर प्रारूपों में रेंडर किया गया है। यह गैर-आकस्मिक नहीं है। पत्र स्पष्ट रूप से AI-जनित उत्पाद विपणन की दुनिया की ओर निर्देशित है, जहाँ किसी ब्रांड को फोटो शूट के बिना "हमारे उत्पाद का उपयोग करते हुए किसी व्यक्ति" का विश्वसनीय वीडियो चाहिए होता है, और जहाँ लेबल को गलत करना उपयोगी और शर्मनाक के बीच का अंतर है।
यह क्यों मायने रखता है जो लोग OCR बना रहे हैं या चुन रहे हैं
यह पेपर एक याद दिलाता है कि OCR का काम का विवरण लगातार बढ़ रहा है। यह पहले "स्कैन की गई पेज को उस टेक्स्ट में बदलना" था जिसकी खोज इंसान कर सके। अब यह ज्यादातर "एक मशीन-रीडेबल जवाब तैयार करना" है जिसे दूसरा मॉडल कंट्रोल सिग्नल के रूप में इस्तेमाल करता है, और इस दूसरे उपयोग के मामले में पहले वाले की तुलना में अलग जरूरतें हैं।
इंसानी पढ़ने वाले को अगर सार स्पष्ट हो तो एक-दो गड़बड़ अक्षरों को सहन करने में दिक्कत नहीं होती। लेकिन एक डाउनस्ट्रीम जनरेटिव मॉडल जो उस OCR आउटपुट को ग्राउंड ट्रुथ मानकर कुछ रेंडर करने वाला है, वह ऐसा नहीं कर सकता। अगर OCR मैप कहता है कि लेबल "ORGANIC" पढ़ रहा है और असली टेक्स्ट "ORIGINAL" है, तो यह गलती सीमित नहीं रहती, यह पिक्सेल-दर-पिक्सेल उस वीडियो में बक जाती है जिसे कोई शायद असल में पब्लिश कर दे। जैसे-जैसे ज्यादा प्रोडक्ट्स इस तरह के जनरेशन पाइपलाइन्स में OCR को चेन कर रहे हैं, "इंसानी स्किम के लिए काफी अच्छा" अब स्टैंडर्ड नहीं रह गया। OCR स्टेप सही होना चाहिए, लगभग सही नहीं, क्योंकि डाउनस्ट्रीम में कोई भी उसकी गलती को पकड़ने वाला नहीं है।
यह OCR की आर्थिक मूल्य की दिशा के बारे में भी एक उपयोगी डेटा पॉइंट है। एक बुककीपर के लिए रसीद पढ़ना एक मार्केट है। एक वीडियो मॉडल में स्ट्रक्चर्ड, पोजीशनली-अवेयर टेक्स्ट एक्सट्रैक्शन फीड करना जो स्केल पर प्रोडक्ट लेबल रेंडर करने वाला है, संभवतः हज़ारों जनरेटेड ऐड्स के लिए, एक अलग मार्केट है, जिसमें गलती के लिए अलग सहनशीलता है और सटीकता के लिए भुगतान करने की अलग तैयारी है। अगर आप उस पाइपलाइन के OCR साइड पर हैं न कि वीडियो साइड पर, तो इसे देखने लायक है।
ईमानदार कैवेट: यह पेपर 20 जुलाई, 2026 को arXiv पर आया था, इस पोस्ट से एक दिन पहले, इसलिए स्वतंत्र प्रतिकृति या थर्ड-पार्टी बेंचमार्किंग के लिए कोई समय नहीं रहा है। प्रस्तुत तुलनाएं चार नामित बेसलाइन्स के खिलाफ क्वालिटेटिव डेमो वीडियो हैं, स्कोर्ड लीडरबोर्ड नहीं। HOMIE का दृष्टिकोण अपने क्यूरेटेड उदाहरणों के बाहर, खासकर घने फाइन प्रिंट वाले असली दुनिया के गंदे लेबल्स पर साफ ब्रांड नाम के बजाय, कैसे खड़ा रहता है, यह अभी भी एक खुला सवाल है। लेकिन अंतर्निहित विचार, कि OCR जनरेशन के लिए इनपुट के रूप में उपयोगी है और केवल इंसानों के लिए आउटपुट नहीं, वह अगली बार जब कोई पूछे कि OCR अब के लिए क्या है, तो याद रखने लायक है। मजबूत इंग्लिश OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा होगा; इस पेपर की दायरा में यह अंतर ध्यान में रखना जरूरी है।