Por que fotografar um documento ainda quebra a maioria dos modelos de OCR
Baseado em: NaviDC-OCR: Navigating Document Parsing Across Digital and Camera-Captured Documents — Peng Cai, Zhaofan Zou, Shifa Liu, Yikun Wang, Jiawei Tang, Kaicheng Yang, Meng Tong, MingKun Jiang, Zhongjiang He, Hao Sun
Pegue seu celular agora e tire uma foto de um recibo que esteja sobre sua mesa. Não faça uma digitalização, tire uma foto, como você faria para um relatório de despesas ou um aplicativo de impostos. Olhe o resultado: o papel se curva ligeiramente nas bordas, um canto está um pouco mais próximo da lente do que o outro, e o texto perto da dobra se curva o suficiente para desalinhar uma linha reta. Nada disso parece quebrado para seus olhos. Para a maioria dos sistemas de OCR, é um campo minado.
Essa lacuna entre "documentos digitalizados em um laboratório" e "documentos fotografados na vida real" é o problema que um novo artigo chamado NaviDC-OCR aborda de frente. O nome significa Navegando na Análise de Documentos em Documentos Digitais e Capturados por Câmera, e a equipe (pesquisadores de uma mistura de laboratórios de IA chineses, com base nas afiliações) construiu um único modelo projetado para lidar bem com ambos os casos, em vez de degradar silenciosamente no momento em que um documento deixa de ser plano e perfeitamente iluminado.
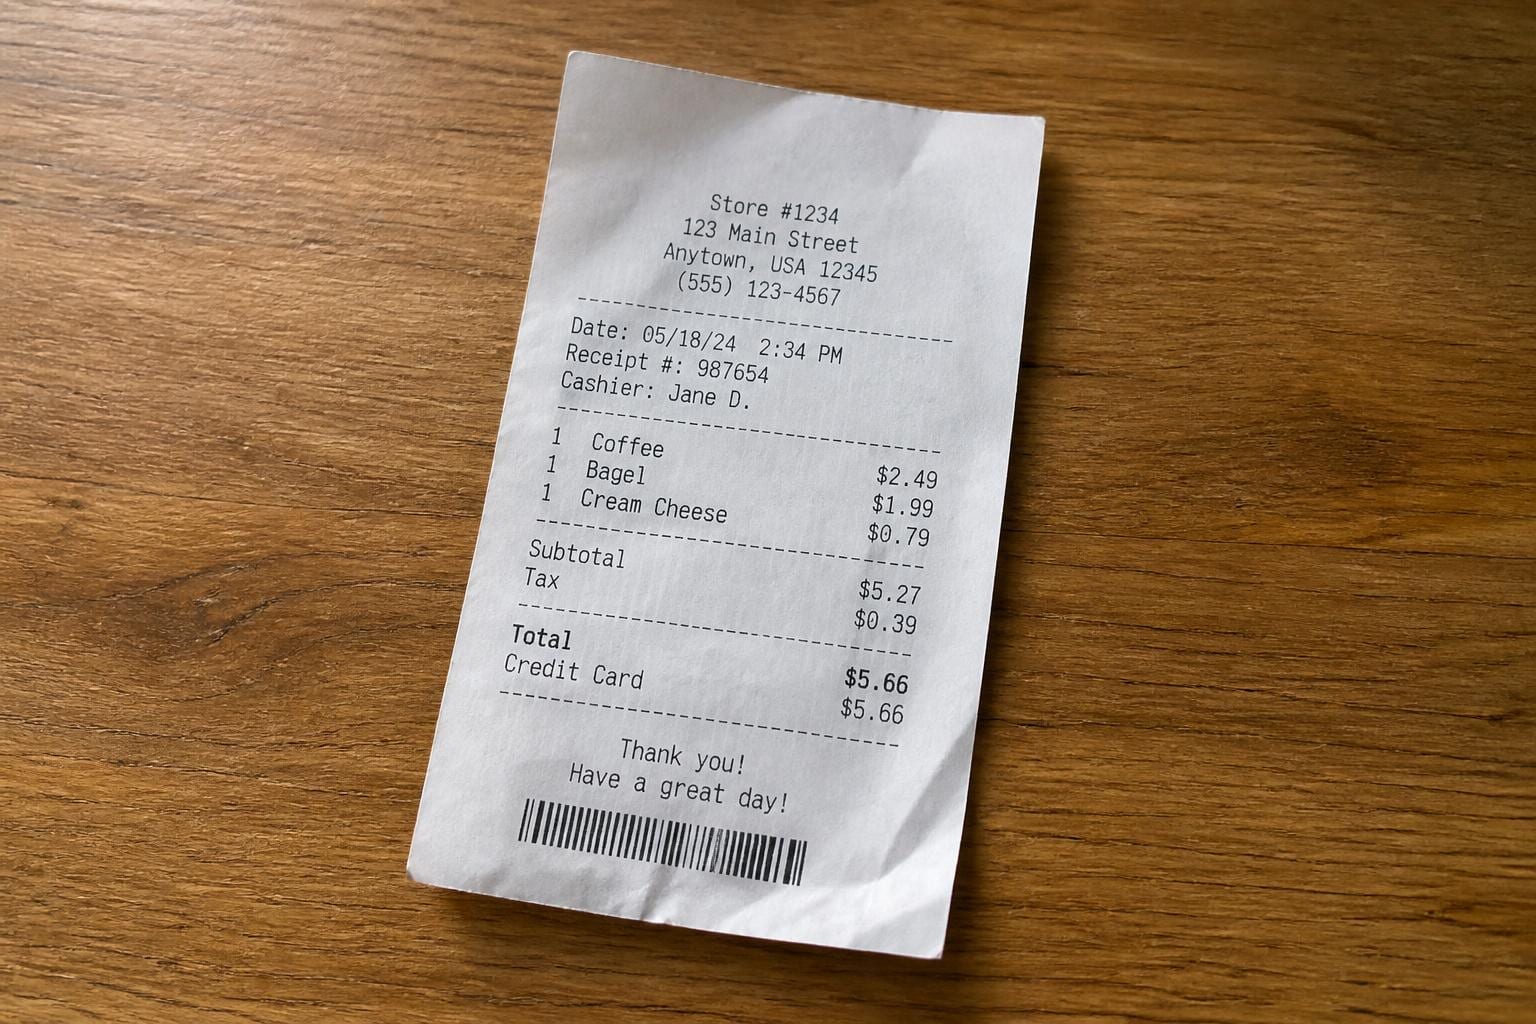
Duas formas de construir um analisador de documentos, e por que ambas têm uma pegadinha
A análise moderna de documentos, a tarefa de transformar uma imagem de página em texto estruturado, tabelas e fórmulas que um computador possa realmente usar, segue principalmente um de dois roteiros.
O primeiro é o que o artigo chama de abordagem desacoplada. Você executa a análise de layout primeiro: encontra os blocos de texto, tabelas e figuras, desenha caixas ao redor deles e então alimenta cada caixa em um modelo de reconhecimento para extrair o conteúdo real. É uma divisão clara de trabalho e funciona bem quando a entrada é uma digitalização plana. A pegadinha aparece com fotos de câmera. Se uma página estiver distorcida, inclinada ou parcialmente sombreada, o detector de layout desenha as caixas erradas, e cada etapa subsequente herda esse erro. Uma linha de tabela ligeiramente curva é cortada em duas caixas; um parágrafo que contorna a lombada é dividido no lugar errado. Se a geometria estiver errada na primeira etapa, nada depois disso pode se recuperar totalmente.
O segundo roteiro é de ponta a ponta: pule a detecção explícita de layout e tenha um único modelo de visão-linguagem (um VLM, uma rede neural que recebe uma imagem e produz texto, da mesma família dos modelos por trás da compreensão de imagens dos chatbots modernos) ler a página inteira e gerar saída estruturada diretamente. Isso contorna o problema de erros em cascata, mas o troca por outro diferente. Em alta resolução, esses modelos tendem a divagar: repetindo linhas, inventando conteúdo que não está na página (alucinação) ou perdendo o controle de onde estão em um layout denso. Alimente um modelo com uma página inteira de um artigo de duas colunas com uma fórmula inline e uma tabela, e ele nem sempre sabe onde uma seção termina e a próxima começa.
Ambos os modos de falha vêm da mesma causa raiz: o texto em uma página não é apenas caracteres, são caracteres sentados dentro de uma estrutura geométrica, e essa estrutura fica mais difícil de ler no momento em que a realidade interfere nela.
Ensinando ao modelo como realmente é a aparência de "deformado"
A primeira correção do NaviDC-OCR é algo que o artigo chama de aprendizado consciente de deformação. A ideia é treinar explicitamente o modelo para perceber distorção geométrica, curvatura, inclinação e distorção de perspectiva, o tipo de coisa que uma foto de câmera introduz e que um scanner de mesa plana nunca faz, em vez de esperar que o modelo perceba isso como um efeito colateral de ver fotos suficientes.
Pense na diferença entre uma pessoa que só leu páginas impressas mantidas planas sob vidro e outra que passou anos lendo livros mantidos em ângulos estranhos em um ônibus. A segunda pessoa desenvolveu uma intuição para "esta linha é realmente reta, apenas parece curva devido à curvatura da página". Esse é o tipo de conhecimento prévio que o NaviDC-OCR está tentando incorporar diretamente, em vez de deixar ao acaso.
A segunda parte é um mecanismo de amostragem adaptativa para layouts complexos. Imagens de documentos de alta resolução são caras para processar em todos os detalhes, então a maioria dos VLMs faz downsampling ou divide a imagem em blocos antes de alimentá-la ao modelo. Uma grade uniforme trata uma tabela densa e uma margem larga da mesma maneira, o que desperdiça resolução em espaço em branco e priva as partes que realmente precisam dela. A amostragem adaptativa, em vez disso, aloca mais atenção para regiões visualmente complexas, tabelas, fórmulas, texto apertado em várias colunas e menos para regiões simples. É o equivalente visual de folhear um relatório: você não lê o espaço em branco na mesma velocidade que a planilha escondida na página 12.
Fórmulas e tabelas não são apenas texto com formato incomum
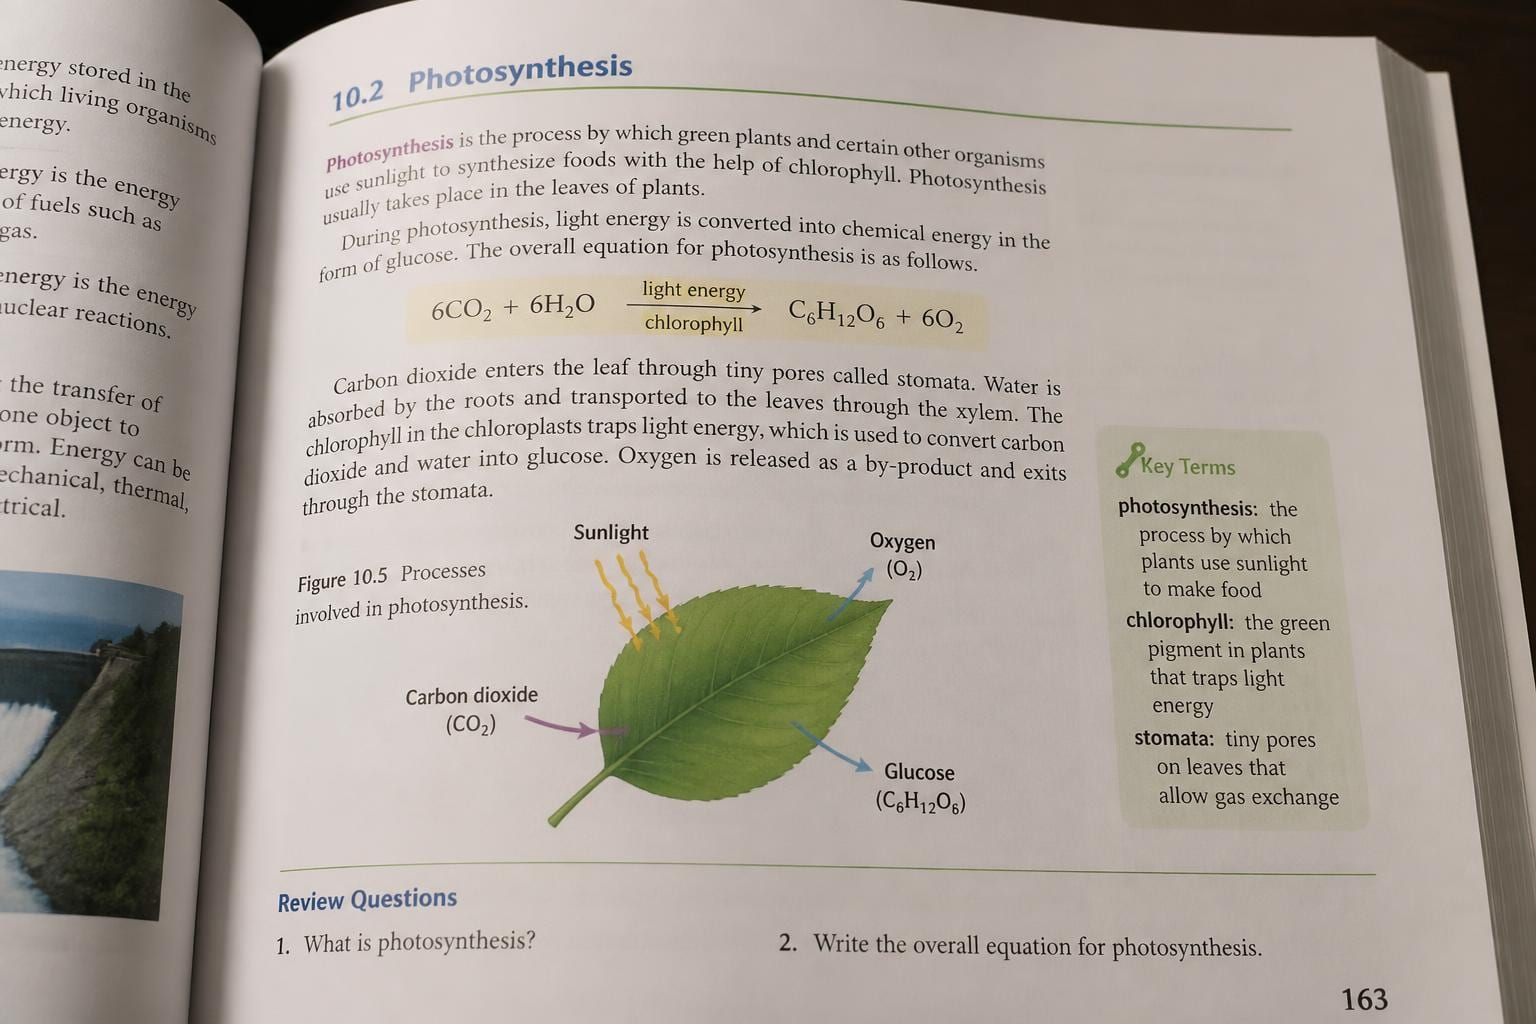
A terceira contribuição aborda um problema que frequentemente prejudica os sistemas de OCR de ponta a ponta: fórmulas e tabelas não são prosa. Uma fórmula possui gramática, no sentido de que o arranjo dos símbolos codifica significado; uma barra de fração tem um significado estruturalmente diferente de um sobrescrito. Uma tabela possui linhas, colunas e células mescladas que definem relações entre valores, e não apenas uma sequência de caracteres.
Modelos treinados principalmente em texto corrido tendem a tratar esses elementos como texto de difícil leitura e geram resultados aparentemente plausíveis, mas sem sentido, quando se confundem: um expoente errado, uma vírgula decimal deslocada ou uma célula de tabela que se mescla silenciosamente à vizinha. A solução do NaviDC-OCR é o aprendizado desacoplado de conteúdo e estrutura: treinar o modelo para raciocinar separadamente sobre a estrutura (isto é uma tabela 4x6, isto é uma fração com este numerador e denominador) e o conteúdo (quais são os caracteres reais), em vez de misturar ambos em uma única tarefa de geração. É um pouco como separar "qual é a forma deste prédio" de "o que está escrito no letreiro da frente", em vez de pedir que um único olhar responda a ambas as questões de uma vez.
O que os números dos benchmarks realmente mostram
O artigo relata pontuações em três benchmarks: 96,87 no OmniDocBench v1.6, 88,53 no Wild-OmniDocBench e 78,41 no PureDocBench. Ele também afirma ter ficado em primeiro lugar no Desafio Sci-ImageMiner da ICDAR 2026, uma trilha de competição internacional para análise de documentos e imagens científicas.
O OmniDocBench é um benchmark bem estabelecido que abrange uma ampla mistura de tipos de documentos, como artigos acadêmicos, livros didáticos, folhas de exame e relatórios financeiros, e avalia tanto a detecção de layout quanto o reconhecimento de texto em conjunto. Uma pontuação na casa dos 90 altos lá significa que o modelo está se saindo muito bem com o tipo de documentos que se assemelham à distribuição de treinamento para a qual a maioria dos parsers é otimizada.
O número interessante é a queda para 88,53 no Wild-OmniDocBench. Dado o nome e o foco declarado do artigo em documentos capturados por câmera, esta é quase certamente a variante mais difícil, de fotos do mundo real: recibos enrolados, páginas de livros em ângulo e iluminação inconsistente, nos quais os pipelines de layout desacoplados têm dificuldade. Uma diferença de oito pontos entre o benchmark limpo e o "selvagem" revela algo que os números de destaque do resumo não mostram: mesmo um modelo construído especificamente para esse problema ainda perde desempenho quando a entrada fica bagunçada. Isso não é uma crítica ao artigo, é um sinal honesto de quão mais difícil é realmente o caso de captura por câmera, e vale a pena lembrar da próxima vez que um fornecedor alega "OCR em nível humano" com base apenas em um benchmark de documentos digitalizados.
O PureDocBench é aquele que não consigo explicar totalmente a partir do resumo. O nome sugere documentos limpos e não distorcidos, o que torna a pontuação mais baixa (78,41, abaixo até do benchmark "selvagem") genuinamente surpreendente, se essa interpretação estiver correta. É possível que o PureDocBench vise um tipo de dificuldade totalmente diferente, layouts científicos mais densos, fórmulas e conteúdos de tabelas mais difíceis, em vez de distorção. Sem as descrições completas dos benchmarks do artigo à minha frente, eu trataria esse número como um alerta para investigar, em vez de um fato consolidado, e gostaria de ver que tipos de documentos realmente compõem esse conjunto antes de tirar conclusões a partir dele.
Por que isso importa para quem está construindo ou escolhendo um pipeline de OCR
Se você está construindo um produto que ingere documentos de usuários, faturas fotografadas com o celular, documentos de identidade escaneados em ângulo, recibos enviados por meio de um aplicativo móvel, a distinção entre modelos desacoplados e end-to-end neste artigo não é apenas acadêmica. Ela explica um modo de falha que você provavelmente já viu: um parser que funciona perfeitamente no seu conjunto de testes de PDFs limpos e desmorona no momento em que os usuários reais começam a enviar fotos tiradas com seus celulares.
Algumas conclusões práticas:
- Teste com fotos de câmera, não apenas com digitalizações. Se seu conjunto de avaliação for composto apenas por digitalizações de mesa ou exportações de PDF limpas, você está medindo o caso fácil. A diferença entre OmniDocBench e Wild-OmniDocBench neste artigo (96,87 versus 88,53) é um proxy razoável para a quantidade de desempenho que você deve esperar perder em entradas do mundo real.
- Fique atento a erros de layout em cascata especificamente. Se você está usando um pipeline desacoplado (detecção de layout, depois reconhecimento), uma tabela confusa ou um parágrafo ausente é frequentemente um bug de layout vestindo a roupa de erro de reconhecimento. Depure as caixas antes de depurar o texto.
- Documentos com muitas fórmulas e tabelas precisam de verificação além da inspeção visual. Um modelo pode produzir uma tabela que parece correta à primeira vista, mas que tem um mapeamento sutilmente incorreto de linhas e colunas, exatamente o tipo de falha que o desacoplamento entre conteúdo e estrutura visa reduzir. Se seu caso de uso envolve tabelas financeiras ou fórmulas científicas, verifique a estrutura, não apenas a legibilidade.
- Números de benchmark de qualquer artigo único são um ponto de partida, não uma decisão de compra. Nenhuma nota de lançamento aqui explica a composição dos dados de treinamento, o custo de inferência ou o tamanho do modelo, todos os quais são muito importantes se você estiver escolhendo entre esse tipo de modelo e um pipeline mais leve para um sistema de produção com restrições de latência.
O que ainda está obscuro
O resumo não menciona o tamanho do modelo, a velocidade de inferência ou se os pesos ou o código serão liberados, todos fatores que importam enormemente se você está decidindo se deve construir sobre isso versus um sistema OCR menor, mais barato e já disponível. Um VLM (Modelo de Linguagem Visual) de última geração que leva vários segundos por página e precisa de uma GPU robusta é uma proposta muito diferente de algo que você pode executar em escala em hardware commodity.
Há também a ressalva habitual com qualquer artigo orientado por benchmarks: as alegações de estado da arte são medidas contra os benchmarks que os autores escolheram, e nem sempre está claro como esses benchmarks foram construídos ou se eles capturam os tipos específicos de documentos que lhe interessam. O resultado do PureDocBench, em particular, merece uma análise mais próxima antes que alguém trate esses números como a palavra final sobre o quão bem isso se generaliza.
Ainda assim, a ideia central aqui é sólida e vale a pena prestar atenção, independentemente de como os números específicos se sustentam sob escrutínio: a análise de documentos tem sido otimizada silenciosamente para entradas limpas, planas e bem iluminadas há anos, enquanto uma grande parcela da captura de documentos do mundo real acontece através de uma câmera de celular em condições de iluminação imperfeitas. Um modelo que trata a distorção geométrica como algo a ser aprendido, em vez de algo a ser removido no pré-processamento, está focado no problema certo. Se é o modelo que realmente será implantado no seu pipeline é uma questão separada, algo que vale a pena testar você mesmo com seus próprios documentos fotográficos, bagunçados e reais, em vez de confiar cegamente em uma tabela de benchmarks.