AI能否在不歪曲数据的情况下为你绘制漂亮的图表?
参考论文: ArtChart: A Benchmark for Faithful Artistic Chart Generation with Integrated Text Rendering — Meijia Huang, Yingjie Yin, Shihao Wang, Chenguang Ma
想象这样一个提示词:“绘制世界地标高度的条形图,但将每个条形画成实际的地标建筑。”模型欣然照办。比萨斜塔、东京塔、大本钟、自由女神像和天坛排成一列,每个都以小巧的插图形式呈现,而非简单的矩形。它在演示文稿中看起来效果极佳。
现在我们来核对数据:比萨斜塔高 56,东京塔高 133,大本钟高 96,自由女神像高 93,天坛高 58。这张图片是否真正编码了这些数值,还是模型只是随意绘制了五座大致呈地标形状的塔楼,高度仅凭视觉平衡感而定?对于大多数当前的图像生成模型而言,诚实的答案是后者。蚂蚁集团团队发表的一篇名为 ArtChart 的新论文,旨在解决这一确切的失败模式。这主要不是一篇关于 OCR 的论文,但它所解决的问题与 OCR 引擎每天处理的问题互为镜像:页面上的像素是否可信,即它们是否真正表达了其所声称的含义。
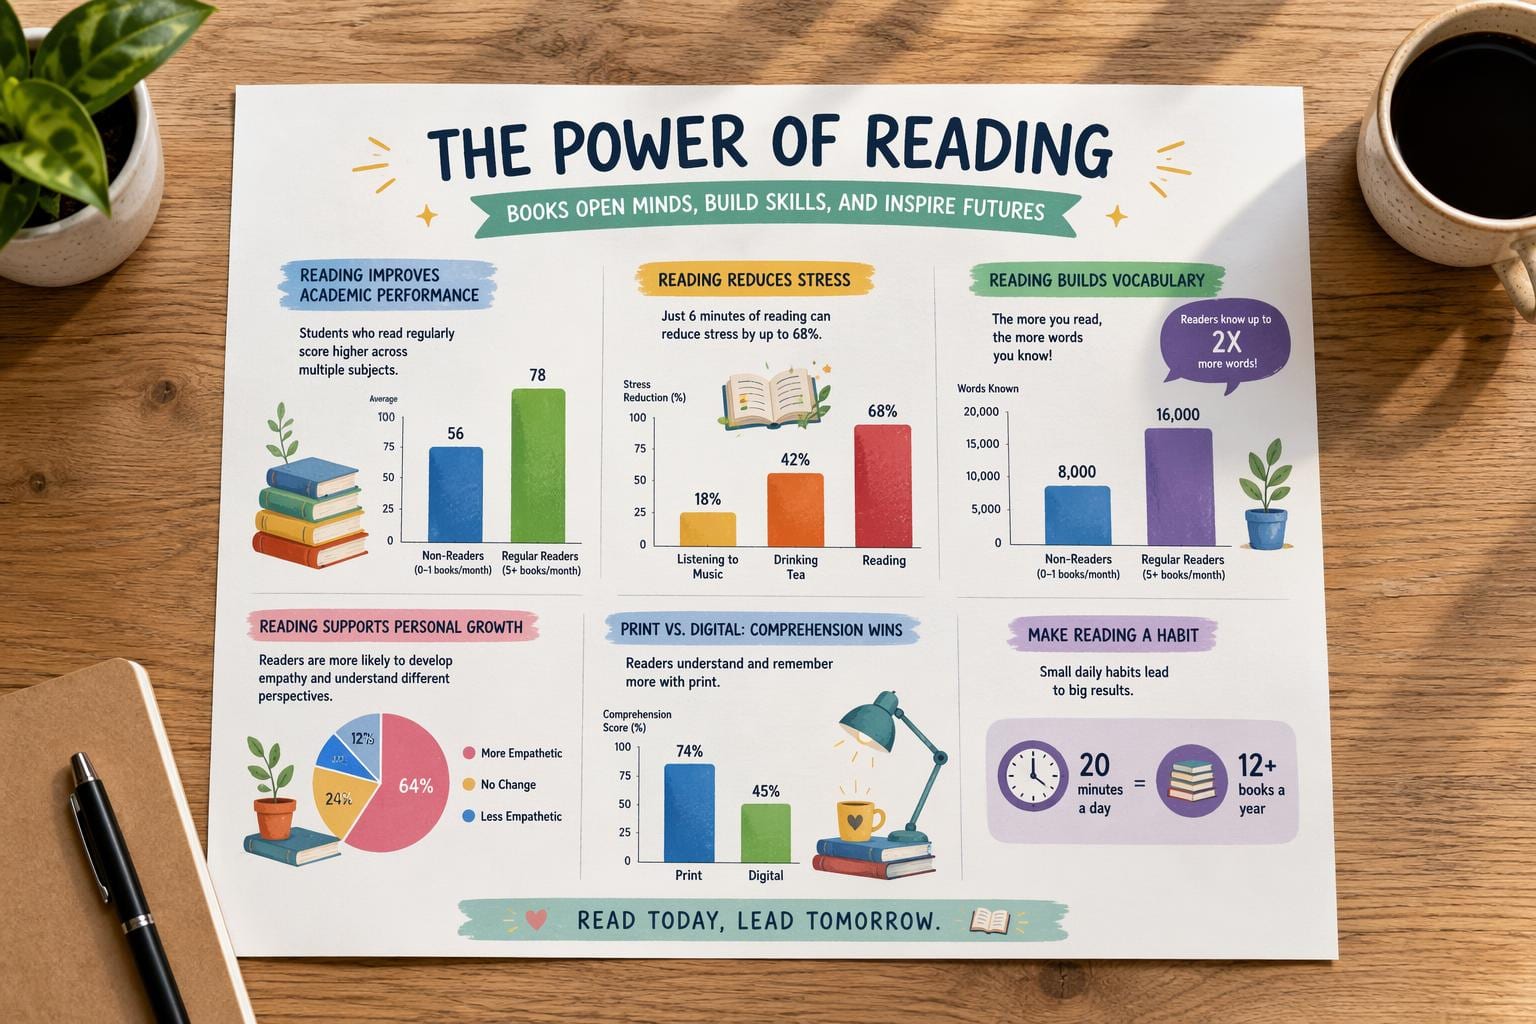
为什么“好看的图表”其实是两项艰巨任务拼凑而成的
用于幻灯片、年度报告或营销页面的图表必须同时完成两项任务。首先,它必须是一张合格的图表:条形图的高度需与数值成比例,饼图的扇区角度要准确,类别数量要正确,标签要对应到正确的标记上。其次,它必须具有设计感:需要合适的配色方案、主题,甚至某种隐喻(例如将条形图变成摩天大楼,或将饼图变成一盘食物)。如果让人类设计师来做,他们通常能兼顾两者,因为他们在开始绘制之前就已经理解了数据。
但如果让文本生成图像模型来做,结果往往只能做到其中一项,很少能两者兼得。ArtChart 的作者进行了初步实验,并将失败案例归纳为四类:
- 数学逻辑失真:条形图高度错误、饼图角度错误,或者条形/扇区的数量完全不对。
- 文本内容错误:标签和标题中的字符缺失、重复、乱码或完全错误。
- 文本布局不匹配:数值或类别标签出现在错误的标记旁边,或者偏离了其对应的条形。
- 视觉风格失败:风格化处理过于激进导致标记无法辨认,或者过于保守导致图表看起来毫无“艺术感”。
他们的观点很直接:如果条形图高度错误、饼图扇区角度错误、数字被幻觉生成,或者正确的数值被放置在了错误的类别上方,那么无论图像的其他部分看起来多么美观,这张图表都是无效的。
艺术家无权重绘的蓝图
ArtChart 的修复方案始于完全禁止模型对数字进行即兴发挥。在任何艺术生成发生之前,系统会使用确定性图表代码渲染一个枯燥、无文本的灰度图表,其像素级精确的柱状图高度和饼图角度与绘图库生成的结果相同。没有标题,没有标签,没有颜色。只有几何形状。
这个灰度骨架随后通过一个特定的 ControlNet(一种利用结构输入图像引导扩散模型的成熟技术)来条件化实际生成过程,该 ControlNet 是在名为 Qwen-Image-2512 的冻结文本到图像主干网络上训练的。其理念在于架构设计:给艺术家一个线框,让他们添加窗户和立面,但不要改动平面图。
使这一方案奏效的关键细节在于,通用的 ControlNet(例如在带有边缘图或深度图的照片上训练的 ControlNet)并不知道在这个特定的灰度图像中,矩形的高度代表一个数字。它会将图表视为任何其他需要风格化的图片。专门在图表布局上训练 ControlNet 使模型能够理解几何形状并非装饰,而是数据。
用三个意见不一的评判者训练模型
锁定几何结构并不能解决文本问题。一旦骨架稳固,团队发现剩余的主要错误是标签混乱或不匹配。因此,他们冻结了 ControlNet 和基础模型,在模型的扩散变压器上附加了一个小型可训练适配器,并使用基于 GRPO(组相对策略优化)的方法通过强化学习对其进行训练。
这一阶段由两个奖励驱动。一个对生成的图像运行 OCR,并使用编辑距离将检测到的文本与预期标签进行匹配,评估渲染文本与正确文本的接近程度。另一个要求视觉语言模型检查每个标签是否位于正确的标记上、处于正确的位置,而不仅仅是字符串拼写是否正确。
随后,他们基于 PickScore(一个在人类偏好数据上训练的模型)添加了第三个美学奖励,并遇到了一个可预见的问题。如果过度强调 OCR 准确性,模型会变得保守:使用普通字体、僵硬的布局和乏味的构图。如果过度强调美学,文本又开始漂移和混乱。将这三个奖励平均为一个训练信号,得到的结果是在各方面都平庸的妥协,他们的实验直接证实了这一点:一个简单混合的模型在文本上得分为 9.49,在布局上得分为 7.51,在美学上得分为 7.61,均低于仅针对其中一项奖励训练的模型所能达到的水平。
他们的解决方案是一种称为 OPD 的蒸馏方案。训练三个独立的专业模型,一个只追求 OCR 准确性,一个只追求布局正确性,一个只追求美学,每个模型都训练到达到平台期。然后训练一个最终的单一模型,模仿最适合给定训练示例的专业模型,该模型由路由器实时选择。这不再是“平均三种意见”,而是“向真正了解这种情况的专家学习”。
回报在他们的数据中清晰可见。OCR 专业模型在文本上得分为 9.55。布局专业模型在布局上得分为 7.71。美学专业模型在美学上得分为 7.69。最终的蒸馏模型在文本上得分为 9.54,布局上得分为 7.67,美学上得分为 7.61,在所有三个轴上都接近每个专业模型自身的上限,而不是像简单混合那样停留在中间地带。
在不让阅卷者看到答案的情况下进行数学评分
为了测试所有这些,团队构建了 ArtChart-Bench:包含 2000 个提示词,中英文各占一半,涵盖四种图表类型(垂直条形图、水平条形图、饼图和面积图),以及 15 种风格家族,从极简主义到繁复装饰风格不等。这些提示词经过刻意设计的压力测试:类别数量从 2 到 10 不等,数值序列大多无序,但有时故意设置为递增、递减或全部相等,数值幅度从容易区分的大差距到故意设计的近乎相同或接近零的数字,旨在让粗心的渲染器出错。
评分在六个维度上进行,每个维度满分 10 分:数学逻辑、文本准确性、文本布局、美观性、指令遵循度和可读性。
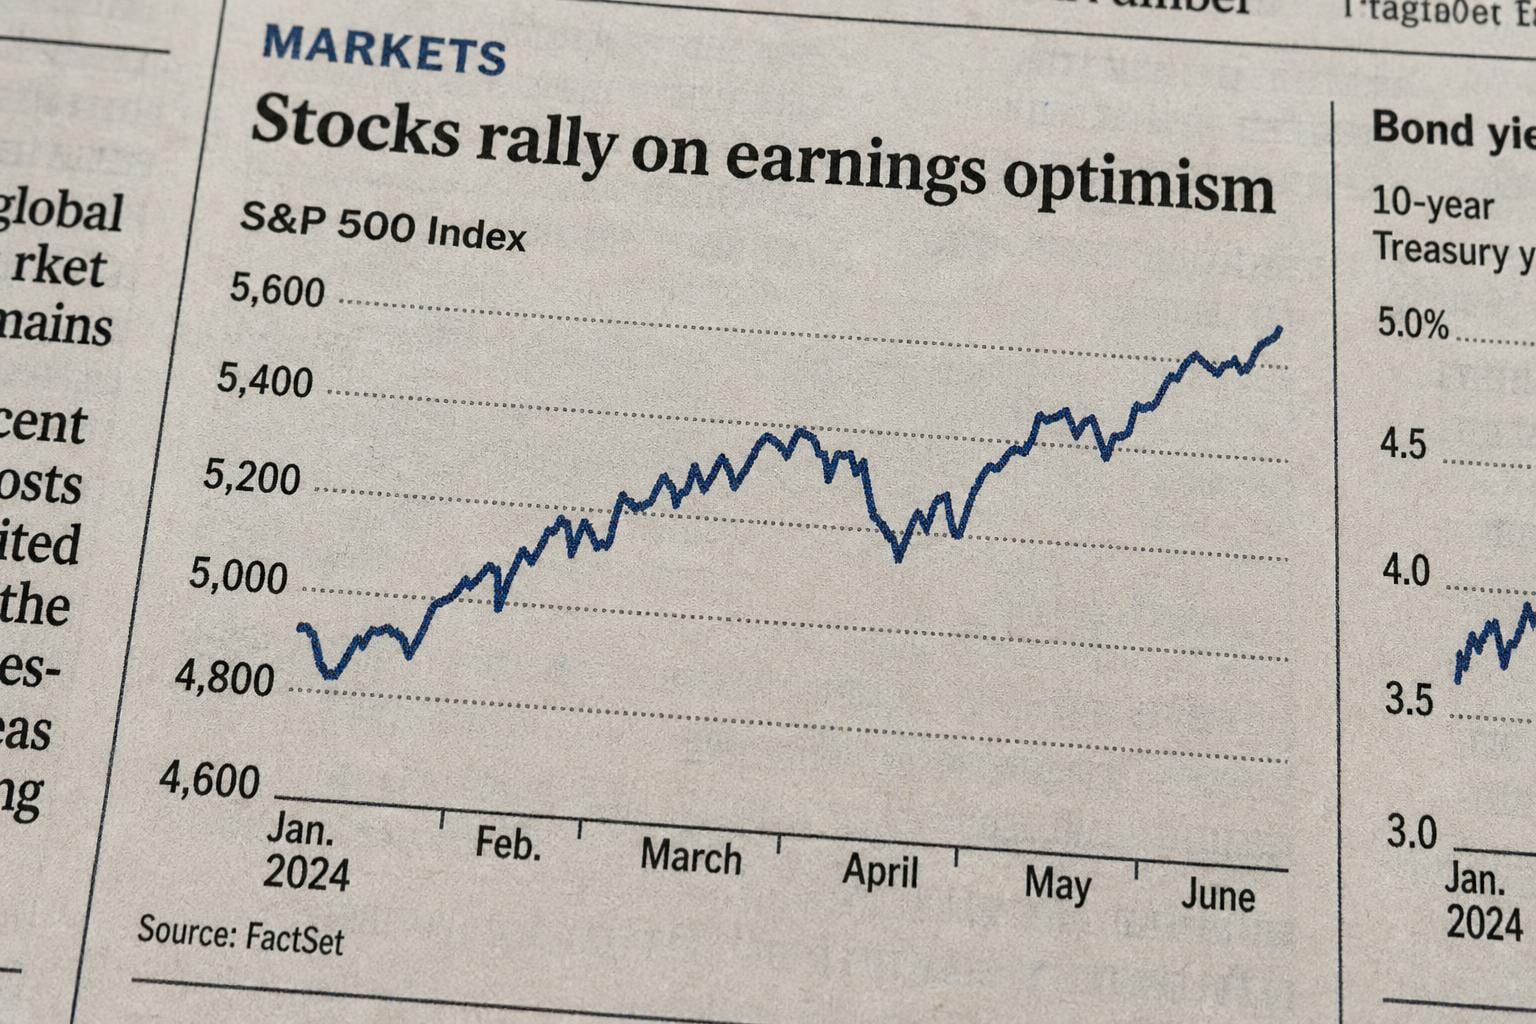
最巧妙的设计在于如何对数学逻辑进行评分。直接问视觉语言模型“这张图表看起来是否正确?”很容易被钻空子,因为模型只需读取打印的标签,并假设图片与标签相符。因此,他们首先运行 OCR,在每个检测到的字符上覆盖白色方框,然后将现在无文本的图像交给评判模型,要求它仅根据标记估算几何比例。如果一个条形图标记为“42”,但绘制的高度只有一半,这种方法仍然能捕捉到错误,因为评判模型从未看到标签。文本准确性作为匹配文本单元的 F1 分数单独评分,布局作为正确绑定到正确标记和位置的标签比例评分,可读性则检查过度风格化导致的不可读性和风格不足导致的单调性。
数据实际揭示了什么
运行一个没有任何图表特定辅助的纯文本到图像模型,其数学逻辑得分仅为 10 分中的 2.87 分。添加一个通用的现成 ControlNet 后,得分跃升至 7.48 分,这仅仅是因为给模型提供了任何可遵循的结构框架。换用经过灰度图表布局训练的图表专用 ControlNet 后,得分进一步攀升至 9.06 分,这是整个流程中最大的单次提升,且完全来自于教导条件模块理解灰色矩形代表数字。
文本和布局的情况也类似。基于编辑的基线方法(即向模型提供渲染好的图表及指令)在一定程度上改善了几何形状,但几乎未触及文本质量。完整的 ArtChart 流程最终在数学逻辑上达到 9.05 分,文本准确率 9.54 分,布局 7.67 分,美观度 7.61 分,指令遵循度 9.25 分,可读性 7.54 分,在所有测试维度上均优于他们测试过的所有基线方法。
按图表类型细分的数据则更为诚实。条形图和水平条形图属于简单案例:可读性得分分别为 9.27 和 8.21。面积图保持了较强的数学和文本得分,但可读性降至 6.64 分,将填充区域转化为插图形状似乎使其更难阅读,即使底层数据是正确的。饼图在所有方面都是最具挑战性的类别,数学逻辑得分为 8.65 分,可读性仅为 6.05 分,因为围绕圆形排列的扇区角度和标签比网格上的条形图更不容忍误差。
为什么这对构建或选择 OCR 的人很重要
这篇论文侧重于图像生成而非图像读取,因此它不像大多数 OpenOCR 报道中的那样是一个直接的竞争基准。但其底层问题与 OCR 是逆向对应的。OCR 引擎必须验证一串像素确实代表其所声称的含义,而 ArtChart 则必须在这些像素生成之前就确保这一点。两者的成败都取决于同一个核心问题:你是否能信任图像中的文本。鉴于汉字/中文属于表意文字系统,拥有数千个字符且排版密集,若该论文仅针对英文/拉丁文本,其结论在应用于中文场景时需格外谨慎,因为中文 OCR 面临的字形复杂度和布局挑战远高于拉丁字母。
对于处理文档或图表图像的工作者而言,这里有两个直接有用的启示。首先,四部分故障分类法(几何错误、文本错误、标签绑定错误、不可读的样式)是一个真正优秀的检查清单,可用于评估任何 OCR 或文档 AI 流水线,特别是当处理来自年度报告或营销演示文稿中的风格化信息图时。其次,“在评估几何结构前屏蔽文本”这一技巧值得在评估工作中借鉴:每当检查系统是否从图表中提取了正确的值时,不要让检查器看到可能本身就有误的标签。
此外,还有一个长期的视角。一个能够生成具有已知正确底层数据且经过验证标签文本的图表的流水线,可以廉价且大规模地为图表理解和图表 OCR 模型生成带标签的训练和评估数据。即使艺术信息图生成本身仍是一个小众用例,这仍然是一个极具价值的副产品。
诚实的免责声明
作者坦诚地指出了当前研究的局限性。ArtChart 仍然依赖于显式的灰度骨架,因此论文并未展示纯文本到图像模型仅凭文本提示就能推断出正确的图表几何结构。基准测试仅涵盖四种图表类型中的一维分类数据;而分组、堆叠、多序列、散点图、雷达图以及仪表盘布局——即实际商业报告中常见的绝大多数图表类型——都留待未来工作解决。此外,由于评分依赖于 OCR 和视觉语言模型作为评判者,这些评判者可能会将自身的偏见带入评分中。
值得补充的是:摘要中承诺与“闭源 API 模型”进行比较,但论文中的结果表格仅将 ArtChart 与开源的 Qwen 和 FLUX 系列基线模型进行对比。GPT-Image 和一个名为 Nano 的模型出现在管道的早期阶段,用于生成训练目标,而非作为最终排行榜中的条目。此外,双语基准测试仅涵盖英语和中文,因此目前尚无法说明该方法在其他书写系统中的表现。这些局限性并未削弱论文实际证明的内容,即特定的图表结构约束加上用于调和相互冲突奖励的蒸馏方案,大幅优于朴素的文本到图像方法和通用的 ControlNet 方法。这仅仅意味着“艺术图表生成,已解决”这一结论距离通过扩展基准测试得到验证还有几步之遥。