الفارسية لديها 110 مليون متحدث وبيانات OCR شبه معدومة. هذه الورقة تزيف 343,000 صفحة لإصلاح ذلك
استنادًا إلى: Persian Pixel: A large-scale synthetic OCR dataset for Persian language — Pouria Mahdi, Haq Nawaz Malik
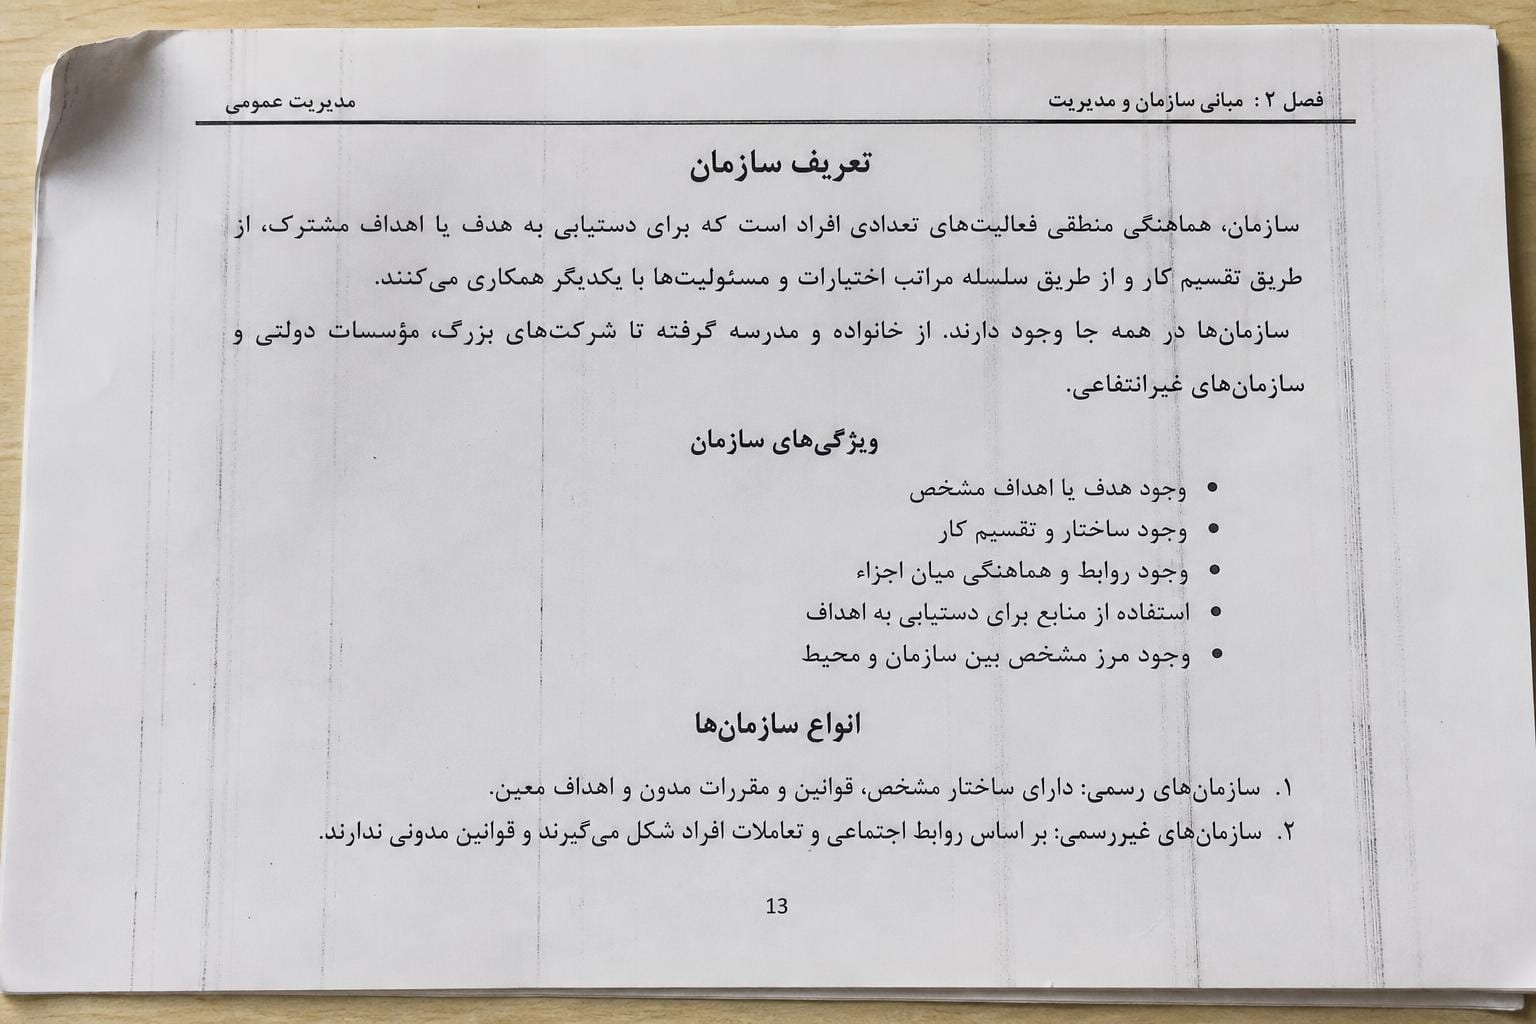
جرّب هذا: خذ حرف "ب" الفارسي (المقابل لـ "b") وتخيل أنه يظهر بأربع طرق مختلفة اعتمادًا على ما إذا كان في بداية الكلمة، أو في وسطها، أو في نهايتها، أو منعزلًا. الآن افعل ذلك لمعظم الحروف الأبجدية. الآن أضف علامات التشكيل الاختيارية التي تغير النطق ولكن ليست مطلوبة في الكتابة العادية، بحيث يجب على النموذج أن يخمن ما إذا كان غيابها يعني "غير مطلوب" أم "أن الماسح الضوئي فاتته". الآن اعرض كل هذا بخط النستعليق، وهو أسلوب خطي تتشابك فيه الحروف بشكل قطري وتتراكب فوق بعضها البعض، وحظًا موفقًا في رسم مربع تحديد نظيف حول أي شيء.
هذا هو التعرف الضوئي على الحروف (OCR) الفارسي في فقرة واحدة، وهذا هو السبب في أن لغة يتحدث بها أكثر من 110 مليون شخص لا تزال تتخلف بشكل كبير عن اللغات اللاتينية من حيث جودة التعرف على النص. لا تقترح ورقة بحثية جديدة بعنوان "Persian Pixel" بنية نموذج جديدة لإصلاح هذه المشكلة. بل تقوم بشيء أكثر رتابة، وأعتقد أنه أكثر فائدة: وهي تصنيع 343,000 صورة وهمية لوثائق بحيث يكون لدى البنى المعمارية الحالية شيء لائق للتعلم منه.
المشكلة لم تكن في النماذج أبداً، بل في البيانات
أنظمة التعرف الضوئي على الحروف (OCR) الحديثة، تلك المعتمدة على معمارية المحولات (Transformers) مثل TrOCR وDonut التي يذكرها البحث، جائعة. فهي تحتاج إلى أحجام ضخمة من البيانات المزدوجة: صورة للنص من جهة، والنسخ النصي الصحيح له من الجهة الأخرى. الإنجليزية تمتلك هذا بوفرة، حيث تم جمعها من عقود من الكتب الممسوحة ضوئياً، والنماذج، والمواقع الإلكترونية، ثم تصحيحها يدوياً بواسطة جيوش من المعلقين. أما الفارسية فلا تملك ذلك.
جزء من هذه الفجوة يعود ببساطة إلى الاقتصاد. تعليق بيانات OCR يعني أن شخصاً ما (أو خط أنابيب معين) يجب أن ينظر إلى صورة ويكتب بالضبط ما تقوله، حرفاً حرفاً، بما في ذلك مكان وضع الحركات. هذه العملية بطيئة، ومكلفة، ولا يمكن توسيع نطاقها بالطريقة التي يتم بها توسيع نطاق مجموعة بيانات الإنجليزية المجمعة. لكن جزءاً آخر من الفجوة يعود إلى الخط نفسه. الفارسية، مثل العربية والأردية، تكتب بخط متصل كقاعدة وليس كخيار أسلوبى، وكل حرف يعيد تشكيل نفسه بشكل دقيق بناءً على ما يجاوره. مجموعة بيانات مبنية على عدد قليل من الخطوط الحديثة والنظيفة لن تعد نموذجاً للتعامل مع الحروف المركبة ومتغيرات الرموز التي ستواجهها في الواقع، ناهيك عن تقليدي الكتابة السائدتين، النسخ (أكثر استقامة ويشبه الطباعة) والنستعليق (الشكل الخطي المتدفق الشائع في الأدب الفارسي واللوحات الإعلانية)، والتي تبدو وكأنها خطوط غير مرتبطة تقريباً إذا كان النموذج قد رأى أحدهما فقط.
لذلك تجد نفسك عالقاً: البيانات الحقيقية المعلومة مكلفة جداً لإنتاجها على نطاق واسع، والمجموعات البياناتية الصغيرة لا تغطي ما يكفي من تنوع الخط لتدريب نموذج قوي. إجابة Persian Pixel هي التوقف عن انتظار البيانات الحقيقية وتوليد بيانات اصطناعية بدلاً من ذلك، ثم العمل بجد لجعل البيانات الاصطناعية تتصرف مثل البيانات الحقيقية بمجرد أن يراها النموذج.
كيف بنوا 343,000 مستند مزيف يتصرف (في الغالب) مثل المستندات الحقيقية
تبدأ الأنابيب بمجمع نصوص فارسي يتكون من سبعة ملايين كلمة، تم اختياره بعناية بدلاً من جمعه بشكل عشوائي، والذي يصبح المادة الخام لكل ما يليه. ثم يقوم إطار عمل يسمى SynthOCR-Gen بتحويل هذا النص إلى صور، وهنا يحدث الهندسة الخاصة بالخطوط. يجب على النظام أن يربط الحروف بشكل صحيح (أي شكل الحرف الذي يجب رسمه بناءً على جيرانه)، ووضع متغيرات الرموز الموضعية بشكل صحيح، والتعامل مع وضع التشكيل، وجميع ذلك عبر عدة خطوط فارسية تمثيلية تشمل كلًا من أنماط النسخ والنستعليق.
الإخراج ليس مجرد مقاطع على مستوى الكلمات. يمتد مجموعة البيانات عبر ثلاثة مستويات تخطيطية: الجمل، الفقرات، والمستندات الكاملة. هذا النطاق مهم أكثر مما يبدو. النموذج المدرب فقط على الكلمات المعزولة لا يعرف كيفية التعامل مع كسور الأسطر، أو مبررات الفقرات، أو ضوضاء التخطيط في صفحة ممسوحة ضوئيًا حقيقية، حيث لا يجلس النص في سطر واحد مرتب ينتظر القراءة.
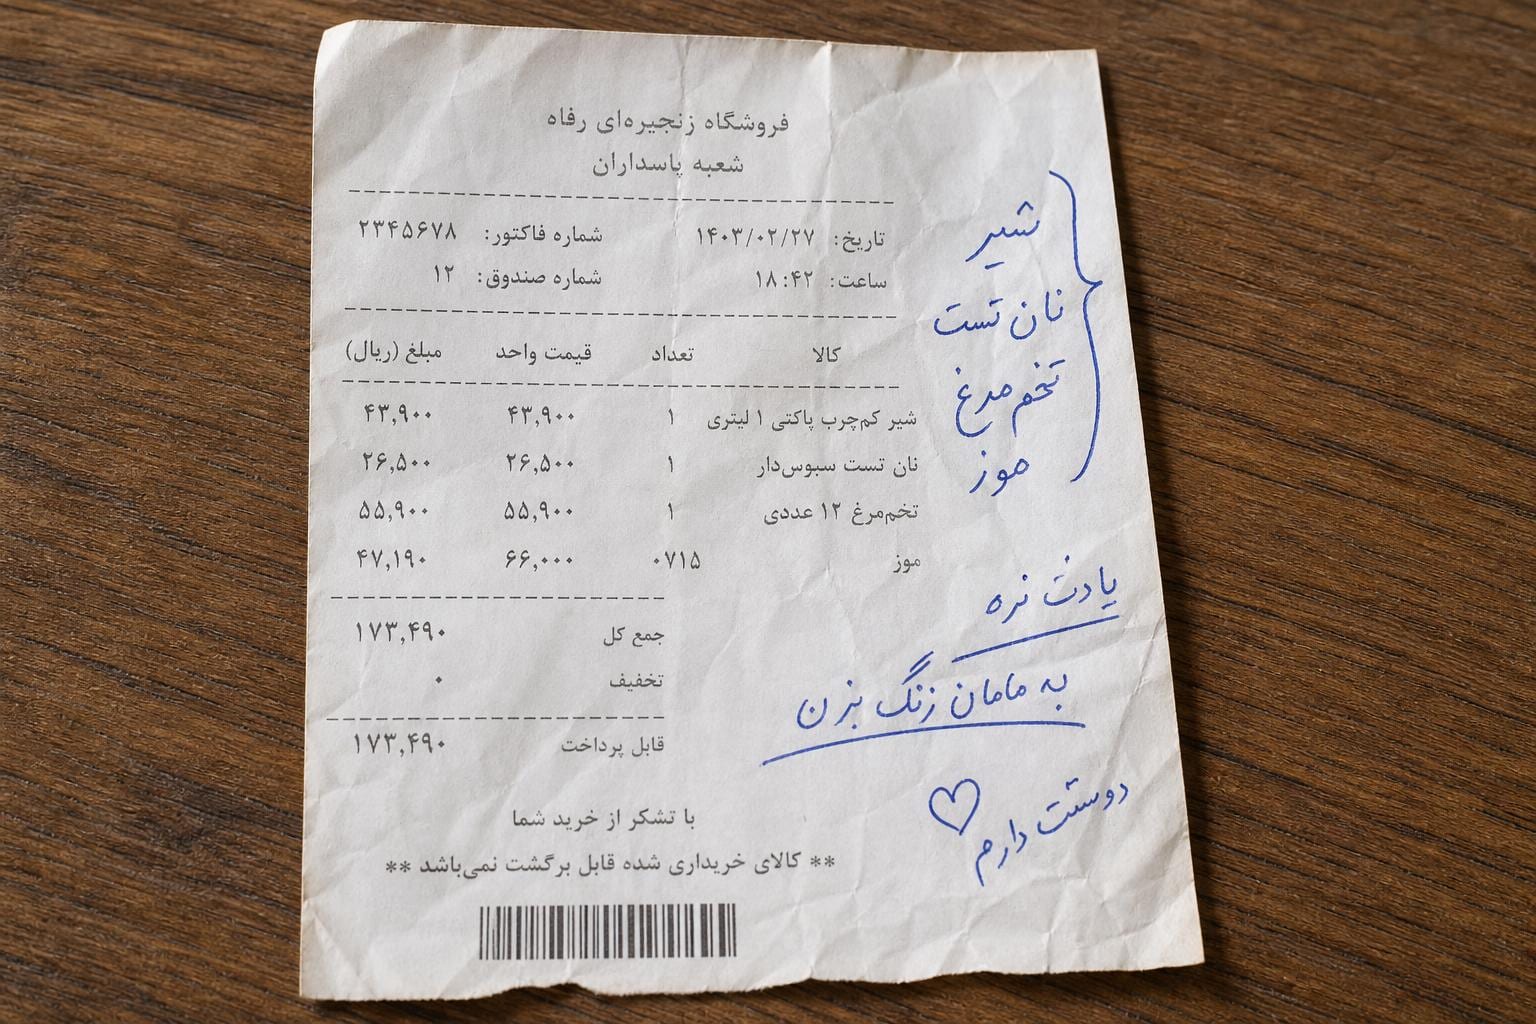
إنشاء نص نظيف هو الجزء السهل. المشكلة الأصعب، والتي تحدد فعليًا ما إذا كان أي من هذا مفيدًا، هي الفجوة بين المجال الاصطناعي والحقيقي: النموذج المدرب على نص نظيف تم إنشاؤه بواسطة الكمبيوتر يميل إلى التفكك بمجرد مواجهته لمستند ممسوح ضوئيًا أو مصور فعليًا، لأن المستندات الحقيقية مليئة بالعيوب المادية التي لا ينتجها محرك العرض بشكل افتراضي. تهاجم Persian Pixel هذه المشكلة بأكثر من خمسة وعشرين نموذج تدهور عشوائي يتم تطبيقه على الصور المرسومة: تسرب الحبر، شيخوخة الورق، الضبابية، الإضاءة غير المتساوية، آثار المسح الضوئي، ضوضاء الضغط، وعدة عمليات ضوضاء أخرى، يتم تطبيقها بشكل احتمالي بحيث لا تتدهور أي صورتين بنفس الطريقة. إنه ما يعادل تدريب نظام قيادة ذاتية في محاكي، ثم عشوائية الطقس والمضاءة والأوساخ على الطريق في المحاكاة حتى يتوقف النموذج عن القدرة على التمييز بين المحاكاة والواقع.
ما هو المحتوى الفعلي داخل الصندوق
إذا أزلنا وصف خط الأنابيب، فإن وصف مجموعة البيانات نفسها يكون مباشرًا: يتكون من أكثر من 343,000 زوج من الصور والنصوص، تم إنشاؤها من مجموعة نصية تتكون من سبعة ملايين كلمة، وموزعة عبر تخطيطات على مستوى الجملة والفقرة والصفحة، ومُصيَّغة بعدة خطوط فارسية تغطي كلا الأسلوبين الرئيسيين للخط، ومُتدهورة باستخدام أكثر من 25 نموذجًا للأعطال لمحاكاة ظروف الالتقاط في العالم الحقيقي. تم بناؤها لتكون موردًا للتدريب أو الضبط الدقيق لهياكل OCR المعتمدة على المحولات مثل TrOCR وDonut تحديدًا، بدلاً من أن تكون معيارًا عامًا.
ما لا يتضمنه ملخص الورقة البحثية هو الجزء الذي أردت رؤيته أكثر من أي شيء آخر: أرقام فعلية حول أداء نموذج تم تدريبه على Persian Pixel مقارنةً بالمستندات الفارسية الحقيقية وغير الاصطناعية. لا توجد نسبة خطأ في الأحرف، ولا نسبة خطأ في الكلمات، ولا مقارنة مع أي معايير فارسية لـ OCR موجودة بالفعل. هذا ليس انتقادًا لفائدة مجموعة البيانات بقدر ما هو إشارة لكيفية قراءة الادعاء. "لقد بنينا مجموعة بيانات اصطناعية كبيرة ومهندسة بعناية" و"لقد أثبتنا أن هذه المجموعة تغلق فجوة الدقة في العالم الحقيقي" هما ادعاءان مختلفان، ولا يدعم ما ورد هنا إلا الأول بشكل كامل.
لماذا يهم ذلك أي شخص يبني أو يختار نظام OCR
إذا كنت تختار محرك OCR وتظهر اللغة الفارسية في أي مكان ضمن مستنداتك، سواء كانت فواتير، أو نماذج حكومية، أو مخطوطات تاريخية، أو أي شيء آخر، فإن الاستنتاج العملي ليس "اذهب واستخدم Persian Pixel مباشرة". بل إن المجال يمتلك الآن مورد تدريب موثوق ومصمم خصيصًا لنظام كتابة كان محرومًا بشدة من الدعم، وأي مورد أو نموذج مفتوح المصدر يدعي دعمًا لائقًا للغة الفارسية في العام أو العامين المقبلين على الأرجح تم تدريبه على بيانات مماثلة، نظرًا لأن البيانات الفارسية المُعلَّمة يدويًا بهذا الحجم لا تكاد توجد في أي مكان آخر.
الدروس الأوسع تعمم ما هو أبعد من الفارسية. تواجه حصة ضخمة من أنظمة الكتابة في العالم، مثل العربية والأوردية والتايلاندية والأمهرية والعشرات غيرها، نفس الاختناق تمامًا: أنظمة كتابة معقدة، وبيانات مُعلَّمة رقيقة، وجودة OCR تتخلف عن أنظمة الكتابة اللاتينية نتيجة لذلك. يُعد Persian Pixel مثالًا عمليًا على تطبيق الحل على نطاق واسع: بدلاً من الانتظار حتى تلحق التسمية اليدوية، قم بنمذجة قواعد عرض الخط بدقة كافية بحيث يمكن للبيانات الاصطناعية أن تحل محلها، ثم انفق جهدًا هندسيًا حقيقيًا على سد الفجوة بين "يبدو كنص" و"يبدو كمستند مر عبر ماسح ضوئي، وعقد من الزمن، وآلة نسخ سيئة". تجدر الإشارة إلى أن طبيعة الخط العربي نفسه، مع كونه خطًا متصلًا ومن اليمين إلى اليسار مع أشكال حروف حساسة للسياق وعلامات تنوين اختيارية وروابط خطية، تجعل مهمة التعرف الضوئي على الحروف أكثر صعوبة بشكل ملحوظ.
إذا كنت تقارن ادعاءات مورد نظام OCR بشأن الفارسية (أو العربية، أو التايلاندية)، فإن السؤال الصادق الذي يجب طرحه هو ما إذا كانت الدقة المبلغ عنها جاءت من معيار مثل هذا المعيار الاصطناعي، أم من مستندات حقيقية مستخرجة من نوع خط الأنابيب الذي ستشغله فعليًا. يمكن أن تكون النماذج المدربة اصطناعيًا قوية حقًا، لكن عبارة "تم التدريب على 343,000 صفحة اصطناعية" و"تم الاختبار على 343,000 صفحة اصطناعية" هي ادعاء أضعف بكثير من "تم الاختبار على فواتير حقيقية لم يُصمم المُصيِّغ للتنبؤ بها". اطلب الرقم الواقعي، وليس فقط حجم مجموعة البيانات.
ما لا يزال مفقوداً
هناك بعض الفجوات يستحق ذكرها بوضوح. أولاً، والأكثر وضوحاً: لا توجد نتائج معيارية (benchmark results) في المواد المتاحة لهذه المقالة. نحن لا نعرف معدلات الخطأ الفعلية التي يحققها نموذج TrOCR أو Donut بعد ضبطه الدقيق (fine-tuning) على Persian Pixel، سواء على بيانات اصطناعية محجوزة للاختبار أو، والأهم من ذلك، على مستندات فارسية ممسوحة ضوئياً حقيقية. هذا هو الرقم الذي سيخبرك ما إذا كان هذا المجموعة البيانات تحرك الأمور فعلياً أم أنها تبدو فقط مبهرة على الورق.
ثانياً، التدهور الاصطناعي، مهما كان متطوراً، لا يزال محاكاة للاستهلاك الواقعي وليس الشيء نفسه. خمسة وعشرون نموذجاً عشوائياً للتدهور يمثلون جهداً هندسياً كبيراً، وربما يكون كافياً لتضييق الفجوة بين المجالات بشكل ذي معنى، لكن "التضييق" لا يعني "القرب". المخطوطات التاريخية على وجه الخصوص، وهي أحد حالات الاستخدام التي يذكرها الورقة صراحةً، تتضمن أنماط تدهور (تلاشي الحبر على مدى قرون، أضرار مادية، خطوط وحروف يدوية تاريخية غير قياسية) التي قد لا تلتقطها بالكامل خط أنابيب العرض الحديث المعاير على خطوط النسخ والنستعليق المعاصرة.
ثالثاً، لم يتم ذكر الكتابة اليدوية على الإطلاق. كل ما ورد هنا هو نص مُعْرَض ومُحَدَّد الخطوط. التعرف على الكتابة اليدوية الفارسية، وهو مشكلة أصعب بلا شك نظراً لأن خط الأساس المتصل في النص الفارسي يصبح أكثر تطرفاً في الشكل المكتوب بخط اليد، لم يتم معالجته بواسطة هذه المجموعة البيانات.
لا يمحو أي من ذلك المساهمة. لقد عانت رقمنة المستندات الفارسية من حاجز البيانات لفترة طويلة، ومجموعة بيانات اصطناعية مُهندسة بعناية تحاكي القواعد الطباعية الفعلية للنص الفارسي، بدلاً من معاملة الفارسية كـ "نص لاتيني ولكن من اليمين إلى اليسار"، هي خطوة حقيقية. فقط تعامل الرقم الرئيسي، 343,000 زوج من الصور والنصوص، كمقياس للحجم والجهد الهندسي، وليس كبديل عن مدى جودة قراءة النماذج الناتجة لمستنداتك الفعلية. لا تزال هذه المسألة الثانية بحاجة إلى إجابة، وهي السؤال الجدير بطرحه قبل أن تبني فوق هذا الأساس.