لماذا النموذج المتميز في الصور سيء في قراءة فاتورتك
استنادًا إلى: MonkeyOCRv2: A Visual-Text Foundation Model for Document AI — Yuliang Liu, Zhang Li, Ziyang Zhang, Shuo Zhang, Qiang Liu, Jiajun Song, Zidun Guo, Xinhan Wang, Handong Zheng, Yang Liu, Dongliang Luo, Zhiyin Ma, Jiarui Zhang, Xiang Bai
ضبابية الصورة مقابل دقة النص
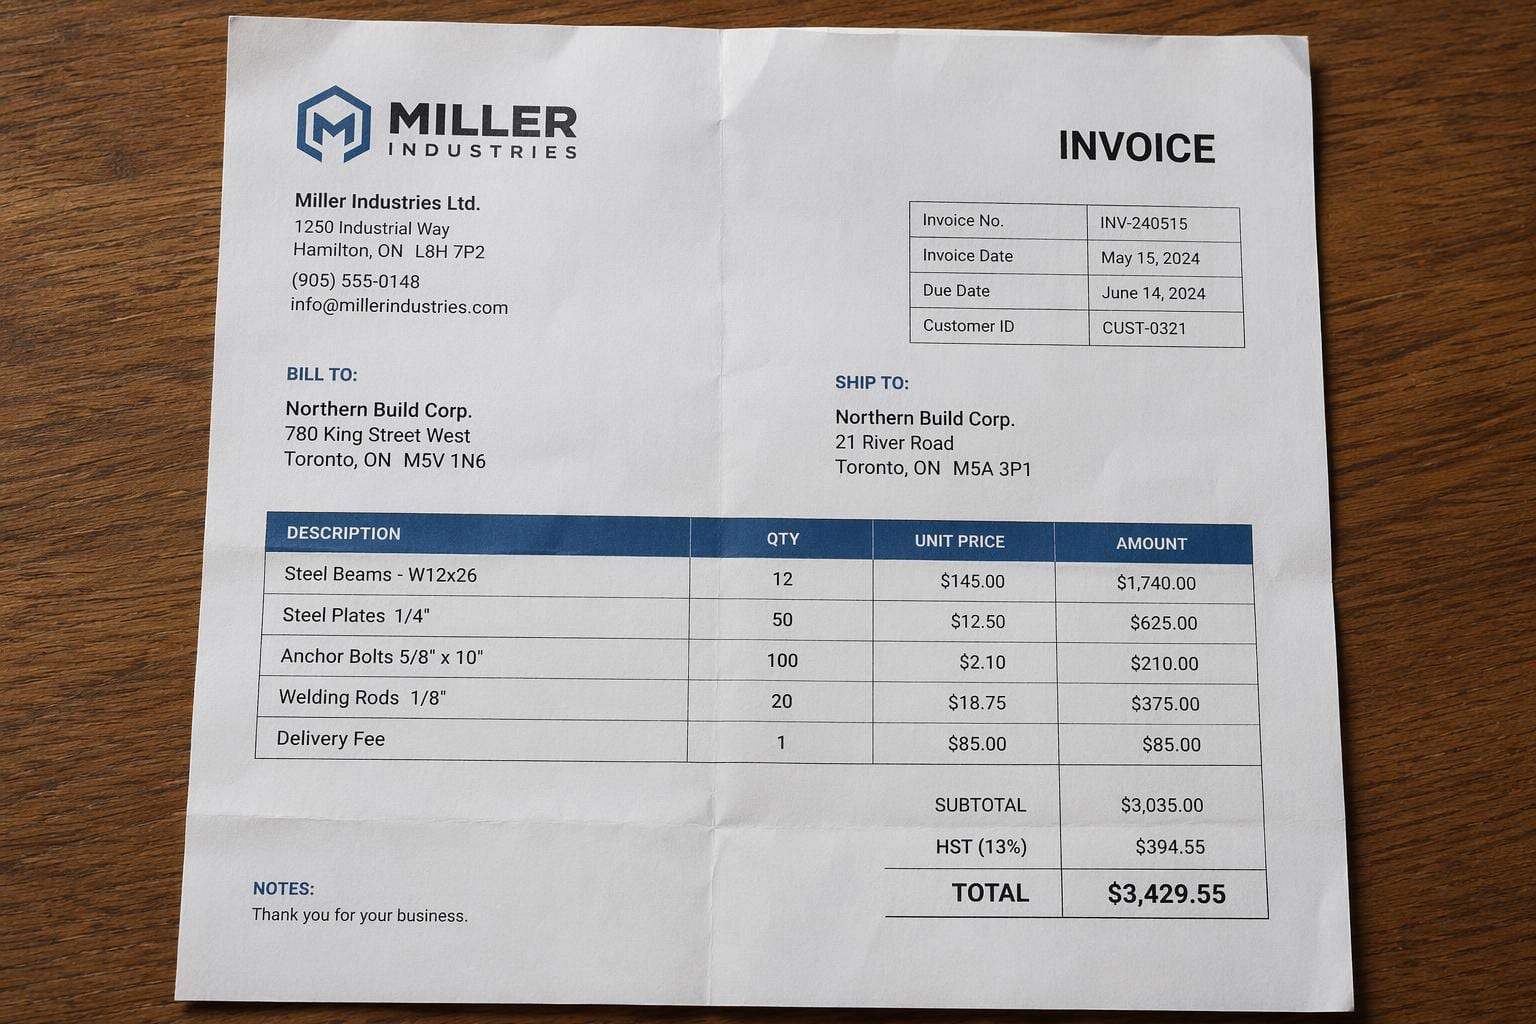
إذا قمت بتغبيش صورة لكلب من سلالة "الريترفر الذهبي" بعدد قليل من البكسلات، فستظل تسميه كلبًا. أما إذا قمت بتغبيش فاتورة مسح ضوئي بنفس المقدار، فقد يتحول الرقم "$1,987.00" إلى "$1,387.00" دون أن يلاحظ أحد ذلك حتى تتوقف الأرقام عن التطابق. هذه هي المشكلة بأكملها في جملة واحدة: صور العالم تتسامح مع الغموض، بينما صفحات النص لا تتسامح معه. يأخذ ورقة بحثية جديدة بعنوان MonkeyOCRv2 هذا التباين على محمل الجد، والحل أكثر إثارة للاهتمام من مجرد "التدريب على المزيد من المستندات."
تم تدريب العيون على الصور الخاطئة
تبدأ كل أنظمة الذكاء الاصطناعي الحديثة المستندة إلى المستندات، سواء كانت تقوم بتحليل ملف PDF أو الإجابة عن أسئلة حول نموذج ممسور ضوئياً، بمشفر بصري (vision encoder): وهو شبكة عصبية تحول الصورة إلى تمثيل مضغوط يمكن لباقي النموذج الاستدلال عليه. والمشكلة التي يشير إليها فريق MonkeyOCRv2 هي أن معظم هذه المشفرات، بما في ذلك تلك المدمجة في نماذج متعددة الوسائط الشائعة اليوم، تم تدريبها مسبقاً على صور طبيعية. فكروا في ImageNet وLAION، والنظام الغذائي القياسي المكون من قطط وسيارات وصور إجازة.
هذا التدريب المسبق يعلم الشبكة التعرف على الكائنات والمناظر على مستوى عام. فالكلب يبقى كلباً سواء كان مشوشاً قليلاً، أو مدوَّراً، أو مصوراً من مسافة أقرب بثلاثة أقدام. لكن صفحة من النص هي نوع مختلف تماماً من الصور. الفرق بين "cl" و"d" هو بضعة بكسلات. والفارق بين فاصلة ونقطة قد يغير معنى الرقم. ووضع الرمز السفلي في الصيغة الكيميائية بكسل واحد أعلى أو أدنى مما ينبغي يغير الصيغة. يسمي الورق البحثي هذه الظاهرة "الإدراك البصري على مستوى الأحرف"، وهي فجوة حقيقية: فمشفر ممتاز في التمييز بين كلب البودل واللابرادور ليس لديه سبب خاص ليكون جيداً في التمييز بين الرقم 3 والرقم 8 بخط حجم 8 نقطة، لأن شيئاً في تدريبه لم يطلب ذلك المستوى من الدقة.
لهذا السبب، فإن تركيب مشفر بصري عام الأغراض على نموذج لغوي وسمّه نظام ذكاء اصطناعي للمستندات ينتج عادةً شيئاً يتسم بالطلاقة ولكنه أحياناً يكون خاطئاً بطرق يصعب اكتشافها. إنه يقرأ شكل الصفحة أكثر مما يقرأ الصفحة نفسها.
بناء أكبر مجموعة من المستندات تم تدريبها مسبقاً عليها على الإطلاق
تبدأ إجابة فريق MonkeyOCRv2 بالبيانات: مجموعة بيانات تسمى MonkeyDoc v2، والتي يُزعم أنها أكبر مجموعة تدريب مسبق على صور المستندات تم إنشاؤها حتى الآن، حيث تضم 113 مليون صورة تغطي 17 لغة. هذا ليس مجرد 113 مليون مستند تم جمعها مرة واحدة وتركها جانباً. بل هي المادة الخام لنوع محدد من التدريب الذي لم تكن مجموعات بيانات الصور الطبيعية مصممة لدعمه، لأن مجموعة صور القطط لا تحتاج إلى محاذاة على مستوى الأحرف بين البكسلات والنص.
ومع ذلك، لن يحل الحجم وحده المشكلة الأساسية. يمكنك تدريب مشفر على غرار الصور الطبيعية على 113 مليون صورة مستند ولا تزال تحصل على شيء يعامل الصفحة كجسم ضبابي واحد كبير، ما لم يجبر هدف التدريب النموذج على الاهتمام بالسكتات الفردية.
وظيفتان لمُشفِّر واحد
تكمن الحيلة الحقيقية في آلية عمل ما قبل التدريب (pretraining)، وهي تصميم ذكي بامتياز. يتعلم النموذج مهمتين في وقت واحد، باستخدام العمود الفقري البصري (visual backbone) نفسه:
- توليد النص من الصورة. بناءً على صورة المستند، يُنتج النص الموجود فيه. هذه هي مهمة التعرف الضوئي على الحروف (OCR) المألوفة، وهي تعلّم المُشفِّر محاذاة ما يراه مع معنى الكلمات.
- إعادة بناء المستند على مستوى البكسل. بناءً على صورة المستند، يعيد بناء الصورة نفسها على مستوى البكسل، مع الحفاظ على سrokes الأحرف وتخطيط الصفحة.
فكّر في الأمر على أنه الفرق بين طالب يقرأ صفحة ويلخصها، وطالب آخر عليه إعادة رسم الصفحة من الذاكرة، سطرًا بسطر. المهمة الأولى وحدها قد تنتج نموذجًا يلمّ بجوهر المستند بينما يتغاضى عن التفاصيل الدقيقة تمامًا، مثل الزخرفة الصغيرة (serif) أو ذيل حرف "g" الصغير، وهي التفاصيل التي تفرّق بين نسخ صحيح ونسخ يبدو معقولاً لكنه خاطئ. إجبار نفس المُشفِّر على إعادة بناء البكسلات يعني أنه لا يمكنه التهرب من تمثيل داخلي غامض. عليه الاحتفاظ بتفاصيل كافية لإعادة رسم السطر، وليس مجرد تخمين الكلمة.
يُعد الجمع بين المهمتين أمرًا أكثر أهمية من أي منهما بمفرده. إعادة البناء دون هدف توليد النص ستنتج فقط مضغط صور ممتازًا دون فهم خاص لما تعنيه العلامات. وتوليد النص دون إعادة البناء هو الوضع الراهن، والوضع الراهن هو ما يفشل عند التعامل مع النصوص الكثيفة، أو الصغيرة، أو المتدهورة.
اختباره حيث يهم الأمر حقاً
بدلاً من ابتكار عرض توضيحي واحد لافت للنظر، قام الفريق باستبدال مشفر MonkeyOCRv2 في أنظمة موجودة عبر خمس مهام وثائقية متميزة، وفحصوا ما إذا كانت الأداء قد تحسن: التعرف على النص، التعرف على الصيغ، كشف النص، كشف التلاعب بالوثائق، وتجزئة النص المتداخل.
تلك المجموعة الأخيرة تستحق التوقف عندها، لأنها ليست المهام التي يتحدث عنها معظم التسويق الخاص بتقنية التعرف الضوئي على الحروف. كشف التلاعب يعني اكتشاف عندما يتم تعديل وثيقة رقمياً، فاتورة مع تغيير في المجموع، شهادة مع تغيير في الاسم. تجزئة النص المتداخل تعني فصل النص بشكل صحيح عندما يكون مختوماً، أو مائيًا، أو مكتوباً بخط اليد فوق نص مطبوع، وهو ما يحدث باستمرار مع النماذج الممسوحة ضوئياً، مطالبات التأمين، والسجلات الأرشيفية القديمة. تعتمد كلتا المهمتين على الدقة على مستوى البكسل التي صُمم هدف إعادة البناء للحفاظ عليها: لا يمكنك اكتشاف أن رقماً قد تم تعديله إذا كان مشفرك قد تخلص بالفعل من التفاصيل الدقيقة التي كانت ستكشف ذلك.
عبر جميع المهام الخمس، استبدل المشفر الأصلي بمشفر MonkeyOCRv2 المحسن النتائج. هذا الاتساق هو الاكتشاف الأكثر أهمية هنا. نموذج يفوز في التعرف على النص لكنه يخسر في التعرف على الصيغ قد يشير إلى أن المكاسب تأتي من الإفراط في التخصيص لخصائص معينة في معيار واحد. الفوز عبر خمس مهام مختلفة حقاً هو دليل أفضل على أن المشفر تعلم شيئاً عاماً عن الوثائق بدلاً من شيء ضيق حول مجموعة بيانات واحدة.
الرقم الذي ينبغي أن يثير قلق المنافسين
إليك النتيجة التي سأبرزها لو كان بامكاني اختيار واحدة فقط. أخذ الفريق مشفره (encoder) المدرب مسبقاً، وقام بتجميده تماماً (بدون أي تدريب إضافي عليه)، وقترنه بنموذج لغوي صغير، لبناء نموذج لتحليل المستندات بحجم 0.7 مليار معامل.
حقق هذا النموذج حالة فنية جديدة مفتوحة المصدر في MDPBench، وهو معيار حديث يغطي المستندات الرقمية الأصلية (ملفات PDF تم تصديرها بشكل نظيف من البرامج) والمستندات المصورة (لقطات هاتفية من أوراق، مع جميع مشاكل الإضاءة والزوايا المرتبطة بذلك) عبر 17 لغة. تجاوز النموذج السابق الأفضل مفتوح المصدر، وهو نظام بحجم 3 مليار معامل يُدعى dots.mocr، بنسبة 2.8 نقطة مئوية، بينما استخدم مشفر بصري أصغر بحوالي 11 مرة.
لا يُعدّ فوز نموذج أصغر بنموذج أكبر إنجازاً مبهرًا بحد ذاته؛ فالكثير من الهياكل المعمارية الفعالة تحقق ذلك على معايير ضيقة. ما يجعل هذه النتيجة تستحق أخذها على محمل الجد هو مصدر هذا التقليل في الحجم. الأمر لا يعود إلى نموذج لغوي أذكى يقوم بحصة أكبر من العمل. بل يعود إلى مشفر بصري يحتاج إلى عدد أقل من المعاملات لأنه تم تدريبه على النوع الصحيح من البيانات منذ البداية، بدلاً من محاولة تعويض نقاط العمى في مشفر الصور الطبيعية باستخدام نموذج لاحق أكبر حجماً. هذه دروس مختلفة بشكل جوهري عن مجرد "تصغير الترانسفورمر". إنها تشير إلى أن المجال كان يدفع ثمنًا مبالغًا فيه لقدرات بصرية كانت موجهة نحو المشكلة الخطأ.
الأمر لا يقتصر على التحليل فقط
اختبر البحث أيضاً المشفر (encoder) المجمّد كجزء من نماذج فهم المستندات، وهي أنظمة لا تقتصر على نسخ المستند فحسب، بل تجيب أيضاً عن الأسئلة المتعلقة به، أو تلخصه، أو تستنتج استناداً إلى تخطيطه. هنا قارنوا المشفر ضد مشفرات مبنية على CLIP وDINO وSAM: وهي ثلاثة من أكثر الهياكل البصرية (vision backbones) استخداماً في الذكاء الاصطناعي متعدد الوسائط، وقد تم تدريبها جميعاً بشكل أساسي على الصور الطبيعية أو مهام التقسيم العام بدلاً من المستندات تحديداً.
في ظل ظروف تدريب متطابقة، تفوق مشفر MonkeyOCRv2 على الثلاثة عبر ثمانية معايير تقييم. وهذا يمثل ضابطة مفيدة: نفس البنية النهائية، ونفس وصفة التدريب، مع تغيير المشفر فقط. وهذا يعزل الادعاء إلى ما يجب عزله إليه، وهو أن التدريب المسبق البصري الخاص بالمستندات ينتج أساساً أفضل من التدريب المسبق العام، بدلاً من أن يكون نتيجة ثانوية لأنبوب تدريب أفضل في مكان آخر من النظام.
ما لا تخبرك به الورقة البحثية
هناك بعض النقاط الجديرة بالذكر قبل أن يعامل أي شخص هذا الأمر على أنه موضوع مُسَلَّم به.
أولاً، الملخص لا يورد تفاصيل حول قدرة الحوسبة المستخدمة في التدريب أو التكلفة، ولا يفعل ذلك الملخص المتوفر هنا أيضاً. إن بناء مجموعة بيانات للتدريب المسبق تتكون من 113 مليون صورة وتشغيل الدالة الهدف المشتركة على هذا النطاق ليس أمراً رخيصاً، ومن غير الواضح ما إذا كانت المختبرات الأصغر أو المطورون المستقلون قادرون على إعادة إنتاج نتائج قريبة من هذه دون موارد مماثلة. الكفاءة في وقت الاستدلال (استخدام نموذج بحجم 0.7 مليار معلمة) لا تخبرك بالكثير عن الكفاءة في وقت التدريب.
ثانياً، كشف التلاعب والتجزئة النصية المتداخلة هما قدرات مفيدة، لكنها أيضاً معايير تقييم متخصصة نسبياً، والأداء القوي فيها لا يتنبأ بالضرورة بكيفية تعامل النموذج مع أوثق المستندات في العالم الحقيقي: فواتير مجعدة، ومسح ضوئي لفاكس منخفض التباين، وكتابة يدوية مختلطة مع مطبوعات، ومستندات تم تصويرها بزاوية تحت إضاءة سيئة. تتضمن مجموعة MDPBench مستندات مصورة، وهو أمر إيجابي، لكن "التصوير تحت ظروف المعيار القياسي" و"التصوير من قبل شخص في مستودع بيد واحدة ومصباح هاتف" ليسا الاختبار نفسه.
ثالثاً، لا توجد أي إشارة إلى تراخيص الاستخدام، أو توفر الأوزان، أو ما إذا كان سيتم إصدار MonkeyDoc v2 نفسه. يعتمد الكثير من القيمة العملية لورقة بحثية كهذه، بالنسبة للأشخاص الذين يبنيون منتجات OCR فعلياً، على ما إذا كان مشفر التدريب المسبق سيظهر في مكان قابل للاستخدام، وليس فقط في جدول للمعايير القياسية.
لماذا يهم ذلك أي شخص يبني أو يشتري أنظمة التعرف الضوئي على الحروف
إذا كنت تقارن محركات التعرف الضوئي على الحروف، أو تبني خط أنابيب يجب أن يصمد أمام التعامل مع وثائق العملاء الحقيقية، فإن الدرس المستفاد ليس "استخدم MonkeyOCRv2 تحديداً". بل إن مشفر الرؤية (vision encoder) الموجود تحت نظام التعرف الضوئي على الحروف أو تحليل المستندات ليس سلعة قابلة للتبديل، وأن بيانات التدريب المسبق الخاصة به مهمة بقدر أهمية نموذج اللغة المضاف فوقه. النظام المبنى حول عمود فقري بصري متعدد الأغراض يحمل عيباً هيكلياً في التعامل مع النصوص الكثيفة، والصيغ الرياضية الصغيرة، والمحتوى المعدل أو المتداخل، بغض النظر عن مدى كفاءة نموذج لغته في تنقية المخرجات لاحقاً.
عملياً، هذا يعني أن هناك عدة نقاط تستحق التحقق منها عند مقارنة المحركات: كيف تؤدي في المستندات الغنية بالصيغ الرياضية أو ذات الخطوط الصغيرة تحديداً، وليس فقط الصفحات المطبوعة النظيفة؛ وكيف تتعامل مع الوثائق التي تم تعديلها أو ختمها فوقها؛ وما إذا كانت أرقام الدقة المعلنة مستمدة من ملفات PDF الرقمية الأصلية، أو الوثائق المصورة، أو كليهما. الفجوة بين هذه الفئات هي بالضبط حيث تميل مشفرات الرؤية متعددة الأغراض إلى الفشل، وهي بالضبط حيث يحاول هذا الورق تقريب المسافة.
الإشارة الأوسع، إذا ثبتت النتائج خارج معايير هذا الورق الواحد، هي أن الذكاء الاصطناعي للمستندات يبدأ في نمو نماذج أساسية خاصة به بدلاً من استعارة تلك المبنية لوظيفة مختلفة. هذا اتجاه صحي. مجال يستمر في إعادة استخدام مشفرات رؤية القطط والسيارات للفواتير والعقود كان سيصل دائماً إلى سقف في مكان ما، وهذا الورق هو حجة جيدة أننا نجد ذلك. علاوة على ذلك، فإن طبيعة الكتابة العربية المتصلة، واتجاهها من اليمين إلى اليسار، والأشكال الحرفية الحساسة للسياق، والروابط الاختيارية، تجعل التعرف الضوئي على الحروف أكثر صعوبة بكثير.