फोटो में बेहतरीन मॉडल इनवॉइस पढ़ने में क्यों खराब है
आधारित शोध-पत्र: MonkeyOCRv2: A Visual-Text Foundation Model for Document AI — Yuliang Liu, Zhang Li, Ziyang Zhang, Shuo Zhang, Qiang Liu, Jiajun Song, Zidun Guo, Xinhan Wang, Handong Zheng, Yang Liu, Dongliang Luo, Zhiyin Ma, Jiarui Zhang, Xiang Bai
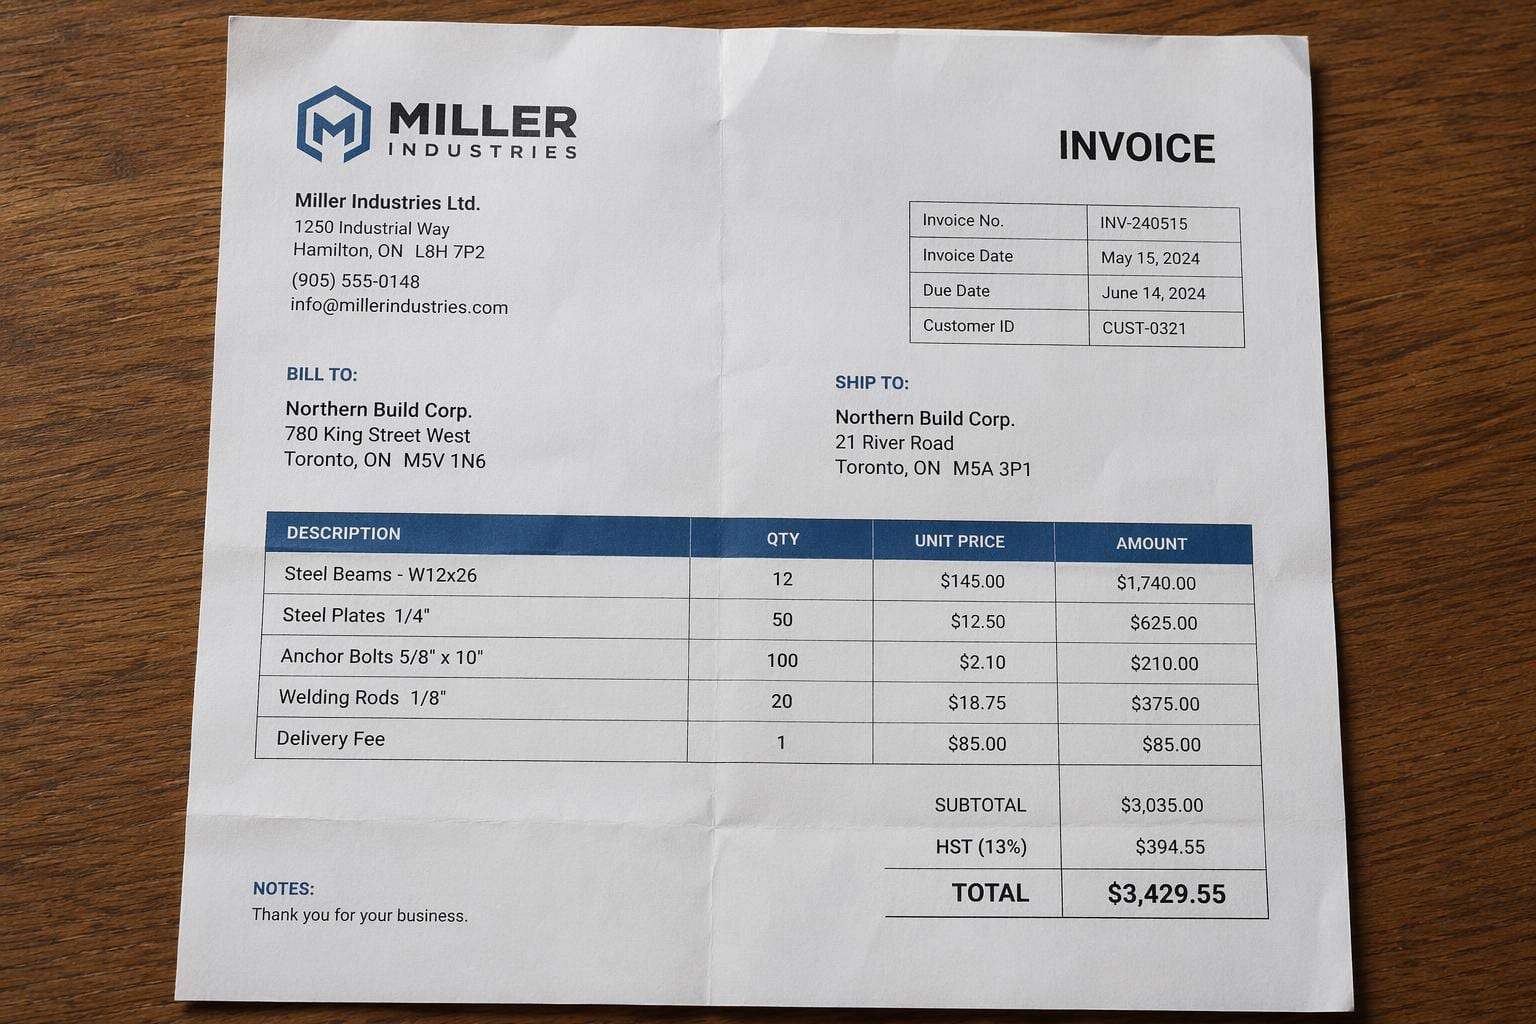
एक गोल्डन रेट्रीवर की तस्वीर को कुछ पिक्सेल धुंधला (blur) कर दें और आप फिर भी उसे कुत्ता कहेंगे। एक स्कैन की गई इनवॉइस को उतना ही धुंधला कर दें और "$1,987.00" बिना किसी को पता चले "$1,387.00" बन सकता है, जब तक कि संख्याएं जुड़ना बंद न कर दें। एक वाक्य में पूरा समस्या यही है: दुनिया की तस्वीरें धुंधलापन सहन कर लेती हैं, और टेक्स्ट के पृष्ठ नहीं। MonkeyOCRv2 नामक एक नई पेपर इस असंगति को गंभीरता से लेती है, और समाधान "अधिक दस्तावेजों पर प्रशिक्षण" से अधिक दिलचस्प है।
आँखें गलत तस्वीरों पर प्रशिक्षित थीं
हर आधुनिक डॉक्यूमेंट एआई सिस्टम, चाहे वह पीडीएफ को पार्स कर रहा हो या स्कैन किए गए फॉर्म के बारे में सवालों के जवाब दे रहा हो, एक विजन एन्कोडर से शुरू होता है: एक न्यूरल नेटवर्क जो छवि को एक संकुचित प्रतिनिधित्व में बदल देता है जिसके बारे में मॉडल का बाकी हिस्सा तर्क लगा सकता है। मंकीओसीआरवी2 (MonkeyOCRv2) टीम द्वारा उठाया गया मुद्दा यह है कि इनमें से लगभग सभी एन्कोडर, जिनमें आज के लोकप्रिय मल्टीमोडल मॉडल्स में बने एन्कोडर भी शामिल हैं, प्राकृतिक छवियों पर प्री-ट्रेन किए गए थे। इमेजनेट (ImageNet), लायन (LAION) की कल्पना करें, बिल्लियों, कारों और छुट्टियों की तस्वीरों का मानक आहार।
वह प्री-ट्रेनिंग नेटवर्क को एक मोटे स्तर पर वस्तुओं और दृश्यों को पहचानना सिखाती है। एक कुत्ता चाहे थोड़ा धुंधला हो, घुमाया गया हो, या तीन फीट करीब से फोटो खींची गई हो, वही कुत्ता रहता है। लेकिन टेक्स्ट की एक पेज पूरी तरह से अलग तरह की छवि है। "cl" और "d" के बीच का अंतर कुछ पिक्सेल का है। एक कॉमा बनाम एक फुल-स्टॉप संख्या के अर्थ को बदल सकता है। रासायनिक सूत्र में एक सबस्क्रिप्ट जो एक पिक्सेल ऊपर या नीचे हो, वह सूत्र को बदल देता है। पेपर इसे "कैरेक्टर-लेवल विजुअल परसेप्शन" कहता है, और यह एक असली खाई है: एक एन्कोडर जो पुडल और लैब्राडोर के बीच अंतर करने में उत्कृष्ट है, उसके लिए 8-पॉइंट फॉन्ट में 3 और 8 के बीच अंतर करना अच्छा नहीं हो सकता, क्योंकि उसके प्रशिक्षण में कभी भी उस स्तर की सटीकता की मांग नहीं की गई थी।
यही कारण है कि एक सामान्य विजन एन्कोडर को एक भाषा मॉडल पर चिपकाकर उसे डॉक्यूमेंट एआई सिस्टम कहना अक्सर कुछ ऐसे उत्पादन करता है जो प्रवाहमय होता है लेकिन कभी-कभी ऐसे तरीकों से गलत होता है जिन्हें पकड़ना मुश्किल होता है। यह पेज के आकार को पढ़ता है, पेज को नहीं।
किसी भी ने जो सबसे बड़ा दस्तावेज़ों का स्टैक प्री-ट्रेन किया हो, उसे बनाना
MonkeyOCRv2 टीम का जवाब डेटा से शुरू होता है: MonkeyDoc v2 नामक एक कॉर्पस, जो उनके अनुसार अब तक बनाया गया सबसे बड़ा दस्तावेज़-इमेज प्री-ट्रेनिंग सेट है, जिसमें 17 भाषाओं में फैले 113 मिलियन इमेज हैं। यह 113 मिलियन दस्तावेज़ों को एक बार स्क्रैप करके छोड़ देने जैसा नहीं है। यह एक विशिष्ट प्रकार की ट्रेनिंग के लिए कच्चा माल है, जिसका समर्थन नेचुरल-इमेज डेटासेट्स कभी बनाए नहीं गए थे, क्योंकि बिल्लियों की फोटो वाला कॉर्पस पिक्सेल्स और टेक्स्ट के बीच कैरेक्टर-लेवल एलाइनमेंट की मांग नहीं करता।
हालाँकि, केवल स्केल अंतर्निहित समस्या को ठीक नहीं कर सकता। आप 113 मिलियन दस्तावेज़ इमेज पर नेचुरल-इमेज-स्टाइल एन्कोडर को प्री-ट्रेन कर सकते हैं और फिर भी कुछ ऐसा प्राप्त कर सकते हैं जो एक पेज को एक बड़ा धुंधला ऑब्जेक्ट मानता है, जब तक कि ट्रेनिंग ऑब्जेक्टिव मॉडल को व्यक्तिगत स्ट्रोक्स के बारे में परवाह करने के लिए मजबूर न करे।
एक एन्कोडर के लिए दो कार्य
वास्तविक चाल प्रीट्रेनिंग (pretraining) के तरीके में है, और यह डिज़ाइन का एक वास्तव में चतुर पहलू है। मॉडल एक ही विज़ुअल बैकबोन (visual backbone) का उपयोग करके एक साथ दो कार्य सीखता है:
- इमेज-टू-टेक्सट जनरेशन (Image-to-text generation)। एक दस्तावेज़ छवि को देखकर, उसमें मौजूद टेक्स्ट उत्पन्न करना। यह परिचित OCR कार्य है, और यह एन्कोडर को यह सीखने में मदद करता है कि वह जो देखता है उसे शब्दों के अर्थ के साथ कैसे मिलाया जाए।
- पिक्सेल-लेवल दस्तावेज़ पुनर्निर्माण (Pixel-level document reconstruction)। एक दस्तावेज़ छवि को देखकर, पिक्सेल स्तर पर छवि को स्वयं पुनर्निर्माण करना, जिससे अक्षरों के स्ट्रोक (strokes) और लेआउट संरक्षित रहें।
इसे इस तरह सोचें जैसे एक छात्र जो एक पृष्ठ को पढ़कर उसका सार देता है, और दूसरा छात्र जो याददाश्त से पृष्ठ को स्ट्रोक-दर-स्ट्रोक फिर से बनाता है। केवल पहला कार्य एक ऐसा मॉडल बना सकता है जो दस्तावेज़ का सार समझ लेता है, लेकिन ठीक उन सूक्ष्म विवरणों को नज़रअंदाज़ कर देता है, जैसे कि एक छोटा सीरिफ (serif) या छोटे अक्षर "g" की पूंछ, जो एक सही ट्रांसक्रिप्शन और एक समझदार दिखने वाली गलत ट्रांसक्रिप्शन के बीच अंतर करते हैं। उसी एन्कोडर को पिक्सेल को भी पुनर्निर्माण करने के लिए मजबूर करने का मतलब है कि वह धुंधली आंतरिक निरूपण (fuzzy internal representation) से बच नहीं सकता। उसे स्ट्रोक को फिर से बनाने के लिए पर्याप्त विवरण बनाए रखना होगा, न कि बस शब्द का अनुमान लगाना।
दोनों को मिलाकर चलाना अकेले किसी एक से अधिक महत्वपूर्ण है। टेक्स्ट-जनरेशन ऑब्जेक्टिव के बिना पुनर्निर्माण केवल एक बहुत अच्छा इमेज कंप्रेसर बनाएगा जिसमें निशानों के अर्थ की कोई विशेष समझ नहीं होगी। पुनर्निर्माण के बिना टेक्स्ट जनरेशन वर्तमान स्थिति (status quo) है, और वर्तमान स्थिति ही घने, छोटे, या खराब टेक्स्ट पर टूट जाती है।
जहाँ असली परीक्षा होती है
बजाय इसके कि कोई एक चमकदार डेमो बनाया जाए, टीम ने MonkeyOCRv2 के एन्कोडर को पाँच अलग-अलग दस्तावेज़ कार्यों में मौजूद सिस्टमों में बदल दिया और यह जाँचा कि क्या प्रदर्शन में सुधार हुआ: पाठ पहचान (text recognition), सूत्र पहचान (formula recognition), पाठ का पता लगाना (text detection), दस्तावेज़ हेरफेर का पता लगाना (document tampering detection), और ओवरलैपिंग टेक्स्ट सेगमेंटेशन।
इनमें से आखिरी दो कार्यों पर थोड़ा रुककर विचार करना उचित है, क्योंकि ये वे कार्य नहीं हैं जिनके बारे में अधिकांश OCR मार्केटिंग बात करती है। हेरफेर का पता लगाना इसका मतलब है यह पहचानना कि जब कोई दस्तावेज़ डिजिटल रूप से संशोधित किया गया हो, जैसे कि कुल राशि बदले हुए रसीद या नाम बदले हुए प्रमाण पत्र। ओवरलैपिंग टेक्स्ट सेगमेंटेशन का मतलब है सही ढंग से अलग करना पाठ को जब वह स्टैम्प, वॉटरमार्क, या मुद्रित पाठ पर हाथ से लिखा हुआ हो, जो स्कैन किए गए फॉर्मों, बीमा दावों और पुराने अभिलेखों में लगातार होता है। दोनों कार्यों की सफलता या असफलता ठीक उस पिक्सेल-स्तर की सटीकता पर निर्भर करती है जिसे पुनर्निर्माण उद्देश्य (reconstruction objective) बनाए रखने के लिए बनाया गया है: आप यह पता नहीं लगा सकते कि एक अंक को संशोधित किया गया है यदि आपका एन्कोडर पहले ही उस बारीक विवरण को त्याग चुका है जो इसे उजागर करता।
पाँचों कार्यों में, मूल एन्कोडर को MonkeyOCRv2 के साथ बदलने से बेहतर परिणाम मिले। यहाँ यह स्थिरता ही अधिक महत्वपूर्ण खोज है। एक ऐसा मॉडल जो पाठ पहचान में जीतता है लेकिन सूत्र पहचान में हारता है, यह संकेत देगा कि लाभ किसी एक बेनचमार्क की विशेषताओं के लिए ओवरफिटिंग से आए हैं। पाँच वास्तव में अलग-अलग कार्यों में जीतना यह बेहतर सबूत है कि एन्कोडर ने दस्तावेज़ों के बारे में कुछ सामान्य सीखा है, न कि किसी एक डेटासेट के बारे में कुछ संकीर्ण।
प्रतिस्पर्धियों के लिए चिंता का विषय बनने वाला एक आंकड़ा
यदि मुझे केवल एक परिणाम को उजागर करना होता, तो यह वही होता। टीम ने अपने पूर्व-प्रशिक्षित एन्कोडर को लिया, उसे पूरी तरह से फ्रीज कर दिया (इस पर कोई आगे का प्रशिक्षण नहीं किया), इसे एक छोटे भाषा मॉडल के साथ जोड़ा, और 0.7 बिलियन पैरामीटर वाला एक दस्तावेज़ पार्सिंग मॉडल बनाया।
उस मॉडल ने MDPBench पर नया ओपन-सोर्स स्टेट-ऑफ-द-आर्ट स्थापित किया, जो एक हालिया बेचमार्क है जो 17 भाषाओं में डिजिटल-बॉर्न दस्तावेज़ों (सॉफ्टवेयर से साफ़ निर्यात किए गए PDF) और फोटोग्राफ़ किए गए दस्तावेज़ों (कागज़ के फ़ोन स्नैपशॉट, जिनमें रोशनी और कोण की समस्याएं होती हैं) दोनों को कवर करता है। इसने पिछले सर्वश्रेष्ठ ओपन-सोर्स मॉडल, dots.mocr नामक 3 बिलियन पैरामीटर वाले सिस्टम को 2.8 प्रतिशत अंकों से हराया, जबकि लगभग 11 गुना छोटा विज़न एन्कोडर का उपयोग किया।
एक छोटा मॉडल एक बड़े मॉडल को हाराना अपने आप में स्वचालित रूप से प्रभावशाली नहीं है; कई कुशल आर्किटेक्चर संकीर्ण बेचमार्क पर ऐसा करते हैं। इस परिणाम को गंभीरता से लेने योग्य बनाने वाली बात यह है कि आकार में कमी कहाँ से आ रही है। यह एक स्मार्ट भाषा मॉडल नहीं है जो अधिक काम कर रहा है। यह एक विज़न एन्कोडर है जिसे कम पैरामीटरों की आवश्यकता होती है क्योंकि इसे पहले से ही सही प्रकार के डेटा पर प्रशिक्षित किया गया था, बजाय इसके कि एक बड़े डाउनस्ट्रीम मॉडल के साथ एक नेचुरल-इमेज एन्कोडर के अंधेरे बिंदुओं की भरपाई करने की कोशिश की जाए। यह "ट्रांसफ़ॉर्मर को छोटा बनाएं" से अलग एक अर्थपूर्ण पाठ है। यह कहता है कि क्षेत्र ने गलत समस्या की ओर इशारा करने वाले विज़न क्षमता के लिए अधिक भुगतान किया है।
यह केवल पार्सिंग के लिए नहीं है
गवेषणा-लेख में फ्रोजन एन्कोडर का परीक्षण दस्तावेज़ समझने वाले मॉडलों के एक घटक के रूप में भी किया गया है, ऐसे सिस्टम जो केवल दस्तावेज़ को ट्रांसक्राइब नहीं करते बल्कि उससे संबंधित प्रश्नों के उत्तर देते हैं, उसका सारांश प्रस्तुत करते हैं, या उसके लेआउट पर तर्क लगाते हैं। यहाँ वे CLIP, DINO और SAM पर आधारित एन्कोडर्स के साथ तुलना करते हैं: मल्टीमोडल एआई में सबसे अधिक उपयोग किए जाने वाले तीन दृश्य बैकबोन, जिनकी प्रशिक्षण मुख्य रूप से प्राकृतिक छवियों या सामान्य विभाजन कार्यों पर की गई थी, न कि विशेष रूप से दस्तावेज़ों पर।
समान प्रशिक्षण परिस्थितियों में, MonkeyOCRv2 एन्कोडर ने आठ बेंचमार्कों में तीनों को पीछे छोड़ दिया। यह एक उपयोगी नियंत्रण है: समान डाउनस्ट्रीम आर्किटेक्चर, समान प्रशिक्षण विधि, केवल एन्कोडर बदलता है। यह दावे को उसी स्तर पर सीमित करता है जहाँ उसे सीमित होना चाहिए, यानी दस्तावेज़-विशिष्ट दृश्य पूर्व-प्रशिक्षण सामान्य-उद्देश्य पूर्व-प्रशिक्षण की तुलना में बेहतर नींव प्रदान करता है, न कि सिस्टम के अन्य भागों में बेहतर प्रशिक्षण पाइपलाइन का कोई उपज हो।
पेपर आपको क्या नहीं बताता
इसे एक निश्चित मामला मानने से पहले कुछ बातों पर ध्यान देना जरूरी है।
पहला, सारांश (abstract) में ट्रेनिंग कंप्यूट या लागत की रिपोर्ट नहीं है, और यहाँ उपलब्ध सारांश में भी नहीं है। 113-मिलियन-इमेज प्रीट्रेनिंग कॉर्पस बनाना और उस पैमाने पर जॉइंट ऑब्जेक्टिव चलाना सस्ता नहीं है, और यह स्पष्ट नहीं है कि क्या छोटे लैब्स या स्वतंत्र डेवलपर्स समान संसाधनों के बिना इसके करीब कुछ दोहरा सकते हैं। इनफेरेंस टाइम पर दक्षता (एक 0.7B मॉडल) आपको ट्रेनिंग टाइम पर दक्षता के बारे में ज्यादा नहीं बताती।
दूसरा, टैम्परिंग डिटेक्शन और ओवरलैपिंग टेक्स्ट सेगमेंटेशन उपयोगी क्षमताएं हैं, लेकिन वे तुलनात्मक रूप से निच (niche) बेंचमार्क भी हैं, और वहां मजबूत स्कोर जरूरी नहीं कि यह भविष्यवाणी करें कि मॉडल असली दुनिया के सबसे गंदे दस्तावेजों को कैसे संभालता है: चिपके हुए रसीदें, कम-कंट्रास्ट फैक्स स्कैन, प्रिंट के साथ मिश्रित हाथ से लिखा हुआ, बुरी रोशनी में कोण से फोटो खींचे गए दस्तावेज। MDPBench में फोटो खींचे गए दस्तावेज शामिल हैं, जो एक अच्छा संकेत है, लेकिन "बेंचमार्क स्थितियों में फोटो खींचा गया" और "किसी ने गोदाम में एक हाथ और फोन की टॉर्च से फोटो खींचा गया" एक ही परीक्षण नहीं हैं।
तीसरा, लाइसेंसिंग, वेट उपलब्धता, या क्या MonkeyDoc v2 खुद जारी किया जाएगा, इसके बारे में कोई उल्लेख नहीं है। ऐसे पेपर की व्यावहारिक मूल्य, जो लोग वास्तव में OCR उत्पाद बना रहे हैं, उन पर बहुत कुछ इस बात पर निर्भर करता है कि क्या प्रीट्रेन एन्कोडर कहीं उपयोगी जगह दिखाई देता है, न कि सिर्फ एक बेंचमार्क तालिका में।
OCR बनाने या खरीदने वाले किसी भी व्यक्ति के लिए यह क्यों मायने रखता है
यदि आप OCR इंजनों का मूल्यांकन कर रहे हैं, या एक पाइपलाइन बना रहे हैं जो असली ग्राहक दस्तावेजों के संपर्क में आने के बाद भी टिके रह सके, तो मुख्य संदेश "विशेष रूप से MonkeyOCRv2 का उपयोग करें" नहीं है। बल्कि यह है कि OCR या दस्तावेज-पार्सिंग सिस्टम के नीचे मौजूद विजन एन्कोडर कोई अदला-बदली योग्य सामान्य वस्तु नहीं है, और उसकी प्री-ट्रेनिंग डेटा उस लैंग्वेज मॉडल के बराबर महत्वपूर्ण है जो ऊपर जोड़ा गया है। एक ऐसे सिस्टम में जो जनरल-पर्पोज़ विजुअल बैकबोन के चारों ओर बना है, डेंस टेक्स्ट, छोटे फॉर्मूले, और बदले हुए या ओवरलैपिंग कंटेंट पर संरचनात्मक नुकसान होता है, चाहे आउटपुट को बाद में साफ करने में उसका लैंग्वेज मॉडल कितना भी अच्छा क्यों न हो।
व्यावहारिक रूप से, इसका मतलब है कि इंजनों की तुलना करते समय कुछ चीजें जांचने लायक हैं: वे विशेष रूप से फॉर्मूले-भरे या छोटे फॉन्ट वाले दस्तावेजों पर, न कि केवल साफ छपी हुई पृष्ठों पर, कैसे प्रदर्शन करते हैं; वे उन दस्तावेजों को कैसे हैंडल करते हैं जिनमें कुछ बदला गया हो या स्टैम्प लगाया गया हो; और क्या दावा की गई सटीकता की संख्या डिजिटल-बॉर्न PDFs, फोटोग्राफ किए गए दस्तावेजों, या दोनों से आती है। इन श्रेणियों के बीच का अंतर बिल्कुल वही जगह है जहाँ जनरल-पर्पोज़ विजन एन्कोडर्स अक्सर टूट जाते हैं, और यही वह जगह है जहाँ यह पेपर दूरी कम करने की कोशिश कर रहा है। यहाँ यह ध्यान रखना ज़रूरी है कि मजबूत इंग्लिश OCR की क्षमता का मतलब यह नहीं है कि देवनागरी लिपि के जटिल संयुक्त अक्षरों और मात्राओं को सही ढंग से पहचानने में भी उतनी ही सटीकता होगी।
यदि परिणाम इस एक पेपर के बेंचमार्क से बाहर भी टिकते हैं, तो व्यापक संकेत यह है कि डॉक्यूमेंट AI अब दूसरे काम के लिए बनाए गए मॉडलों को उधार लेने के बजाय अपने खुद के फाउंडेशन मॉडल्स विकसित करना शुरू कर रहा है। यह एक स्वस्थ दिशा है। एक ऐसा क्षेत्र जो इनवॉइस और कॉन्ट्रैक्ट्स के लिए बिल्ली और कार के विजन एन्कोडर्स को बार-बार पुन: उपयोग करता रहा, वह कहीं न कहीं छत (सीलिंग) से टकरा ही जाता, और यह पेपर एक अच्छा तर्क है कि हम उसे ढूंढ रहे हैं।