Por qué un modelo que es bueno con fotos es malo leyendo tu factura
Basado en: MonkeyOCRv2: A Visual-Text Foundation Model for Document AI — Yuliang Liu, Zhang Li, Ziyang Zhang, Shuo Zhang, Qiang Liu, Jiajun Song, Zidun Guo, Xinhan Wang, Handong Zheng, Yang Liu, Dongliang Luo, Zhiyin Ma, Jiarui Zhang, Xiang Bai
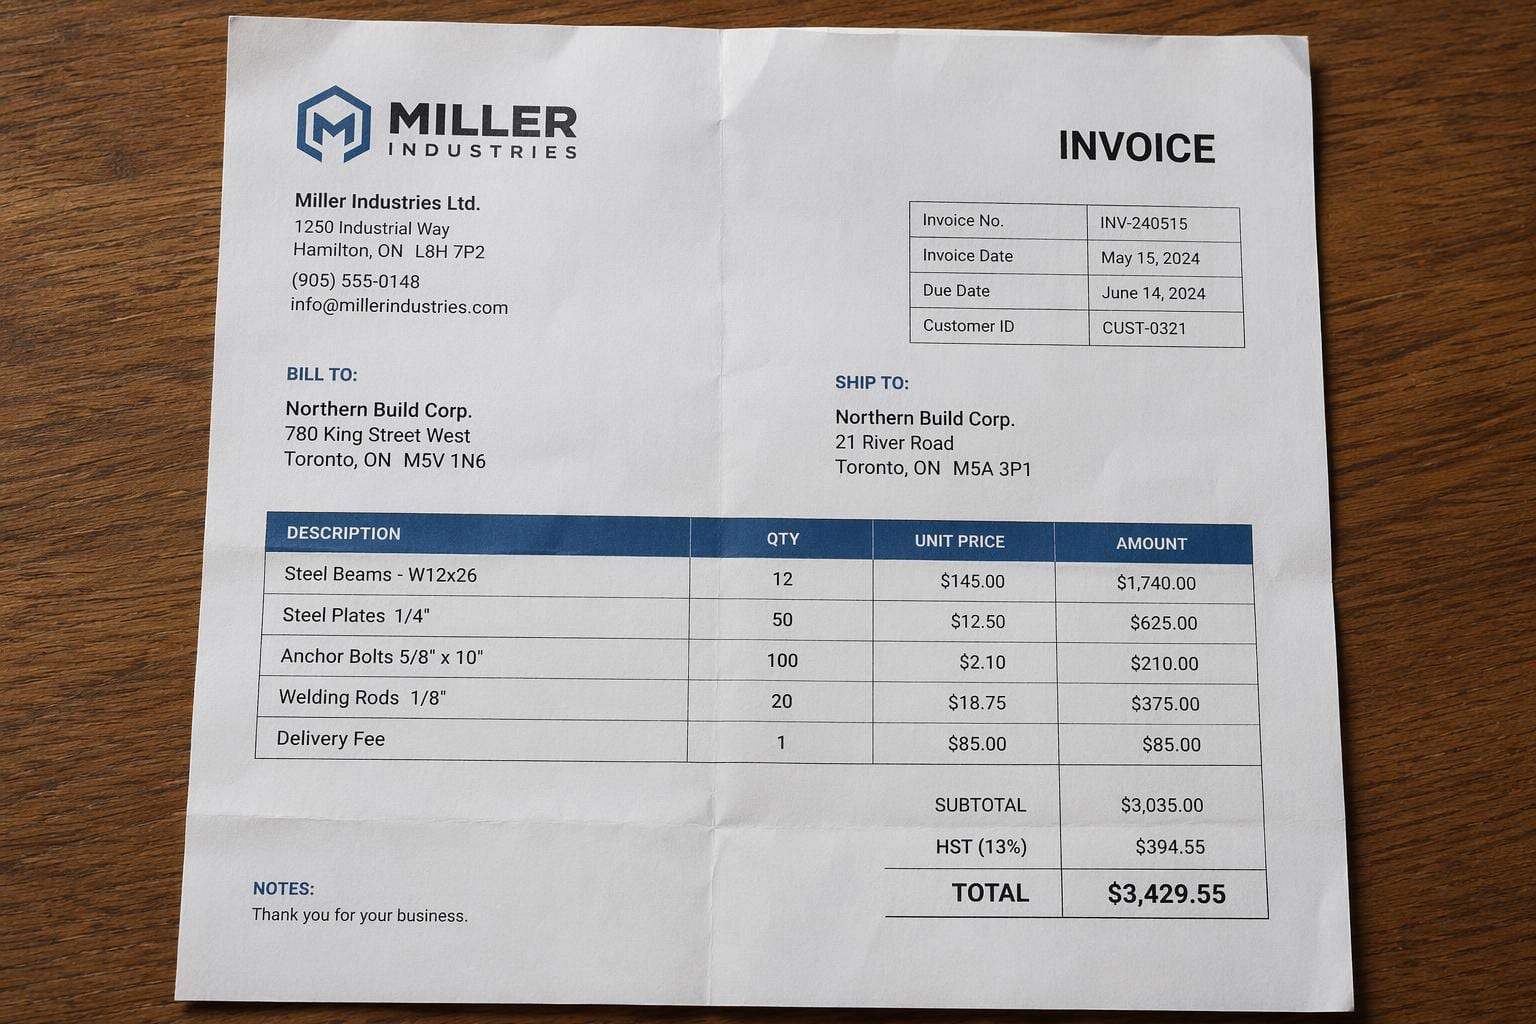
Difumina una foto de un golden retriever unos pocos píxeles y seguirás llamándolo perro. Difumina una factura escaneada la misma cantidad y "$1,987.00" puede convertirse en "$1,387.00" sin que nadie se dé cuenta hasta que las cifras dejen de cuadrarse. Ese es todo el problema en una sola frase: las fotos del mundo toleran la imprecisión, y las páginas de texto no. Un nuevo artículo titulado MonkeyOCRv2 toma esa discrepancia en serio, y la solución es más interesante que "entrenar con más documentos".
Los ojos se entrenaron con las imágenes equivocadas
Cada sistema moderno de IA para documentos, ya sea que analice un PDF o responda preguntas sobre un formulario escaneado, comienza con un codificador visual: una red neuronal que convierte una imagen en una representación comprimida sobre la cual el resto del modelo puede razonar. El problema que señala el equipo de MonkeyOCRv2 es que casi todos estos codificadores, incluidos los integrados en los modelos multimodales populares de hoy, fueron preentrenados con imágenes naturales. Piense en ImageNet, LAION, la dieta estándar de gatos, coches y fotos de vacaciones.
Ese preentrenamiento enseña a una red a reconocer objetos y escenas a un nivel grueso. Un perro sigue siendo un perro aunque esté ligeramente desenfocado, rotado o fotografiado desde tres pies más cerca. Pero una página de texto es un tipo de imagen completamente diferente. La diferencia entre "cl" y "d" son unos pocos píxeles. Una coma frente a un punto pueden cambiar el significado de un número. Un subíndice en una fórmula química colocado un píxel demasiado alto o bajo cambia la fórmula. El artículo denomina a esto "percepción visual a nivel de carácter", y es una brecha real: un codificador que es excelente para distinguir un caniche de un labrador no tiene ninguna razón particular para ser bueno distinguiendo un 3 de un 8 en una fuente de 8 puntos, porque nada en su entrenamiento demandó ese nivel de precisión.
Esta es la razón por la que acoplar un codificador visual de propósito general a un modelo de lenguaje y llamarlo sistema de IA para documentos tiende a producir algo que es fluido pero ocasionalmente incorrecto de maneras difíciles de detectar. Lee la forma de una página más que lee la página en sí.
Construyendo la mayor pila de documentos sobre la que se haya realizado preentrenamiento
La respuesta del equipo de MonkeyOCRv2 comienza con los datos: un corpus llamado MonkeyDoc v2, que según ellos es el conjunto de preentrenamiento de imágenes de documentos más grande construido hasta la fecha, con 113 millones de imágenes que abarcan 17 idiomas. Esto no significa simplemente 113 millones de documentos raspados una vez y dejados de lado. Es la materia prima para un tipo específico de entrenamiento que los conjuntos de datos de imágenes naturales nunca fueron diseñados para soportar, ya que un corpus de fotos de gatos no necesita una alineación a nivel de carácter entre píxeles y texto.
Sin embargo, la escala por sí sola no resolvería el problema subyacente. Podría preentrenar un codificador de estilo de imagen natural con 113 millones de imágenes de documentos y aún así terminar con algo que trate una página como un gran objeto borroso, a menos que el objetivo de entrenamiento obligue al modelo a prestar atención a trazos individuales.
Dos tareas para un solo codificador
El verdadero truco reside en cómo funciona la preentrenamiento, y es un diseño genuinamente ingenioso. El modelo aprende dos tareas a la vez, utilizando el mismo tronco visual:
- Generación de texto a partir de imágenes. Dada una imagen de un documento, produce el texto que contiene. Esta es la tarea de OCR familiar, y enseña al codificador a alinear lo que ve con el significado de las palabras.
- Reconstrucción de documentos a nivel de píxeles. Dada una imagen de un documento, reconstruye la imagen misma a nivel de píxeles, preservando los trazos de los caracteres y la disposición.
Piénselo como la diferencia entre un estudiante que lee una página y la resume, frente a uno que tiene que redibujar la página de memoria, trazo por trazo. La primera tarea por sí sola puede producir un modelo que capta la esencia de un documento mientras suaviza exactamente los detalles finos, como una pequeña serif o la cola de una "g" minúscula, que separan una transcripción correcta de una incorrecta pero plausible. Obligar al mismo codificador a reconstruir también píxeles significa que no puede salirse con la suya con una representación interna borrosa. Debe conservar suficientes detalles para redibujar el trazo, no solo adivinar la palabra.
Combinar las dos es más importante que cualquiera de ellas por separado. La reconstrucción sin el objetivo de generación de texto produciría simplemente un muy buen compresor de imágenes sin ninguna comprensión particular de lo que significan las marcas. La generación de texto sin reconstrucción es el estado actual, y el estado actual es lo que falla con texto denso, pequeño o degradado.
Probándolo donde realmente importa
En lugar de crear una única demostración llamativa, el equipo reemplazó el codificador de MonkeyOCRv2 en sistemas existentes para cinco tareas distintas de documentos y verificó si el rendimiento mejoraba: reconocimiento de texto, reconocimiento de fórmulas, detección de texto, detección de alteraciones de documentos y segmentación de texto superpuesto.
Este último par merece una pausa, porque no son las tareas de las que más se habla en el marketing de OCR. La detección de alteraciones significa detectar cuándo un documento ha sido modificado digitalmente, un recibo con un total cambiado, un certificado con un nombre intercambiado. La segmentación de texto superpuesto significa separar correctamente el texto cuando está sellado, con marca de agua o escrito a mano sobre texto impreso, lo cual ocurre constantemente con formularios escaneados, reclamaciones de seguros y registros archivísticos antiguos. Ambas tareas viven o mueren según la fidelidad a nivel de píxel que el objetivo de reconstrucción está diseñado para preservar: no puedes detectar que un dígito fue alterado si tu codificador ya descartó el detalle fino que lo delataría.
En las cinco tareas, reemplazar el codificador original con MonkeyOCRv2 mejora los resultados. Esa consistencia es el hallazgo más significativo aquí. Un modelo que gana en reconocimiento de texto pero pierde en reconocimiento de fórmulas sugeriría que las ganancias provienen de sobreajuste a las peculiaridades de un solo benchmark. Ganar en cinco tareas genuinamente diferentes es una mejor evidencia de que el codificador aprendió algo general sobre documentos en lugar de algo estrecho sobre un solo conjunto de datos.
El número que debería inquietar a la competencia
Este es el resultado que destacaría si solo pudiera elegir uno. El equipo tomó su codificador preentrenado, lo congeló por completo (sin realizar más entrenamiento sobre él), lo combinó con un pequeño modelo de lenguaje y construyó un modelo de análisis de documentos de 0.7 mil millones de parámetros.
Ese modelo estableció un nuevo estado del arte de código abierto en MDPBench, un benchmark reciente que cubre tanto documentos nativos digitales (PDFs exportados limpiamente desde software) como documentos fotografiados (capturas de papel tomadas con teléfonos, con todos los problemas de iluminación y ángulo que esto implica) en 17 idiomas. Superó al mejor modelo anterior de código abierto, un sistema de 3 mil millones de parámetros llamado dots.mocr, por 2.8 puntos porcentuales, mientras utilizaba un codificador visual aproximadamente 11 veces más pequeño.
Que un modelo más pequeño supere a uno más grande no es automáticamente impresionante por sí solo; muchas arquitecturas eficientes logran eso en benchmarks estrechos. Lo que hace que este resultado valga la pena tomarlo en serio es de dónde proviene la reducción de tamaño. No se trata de un modelo de lenguaje más inteligente que haga más trabajo. Se trata de un codificador visual que necesita menos parámetros porque fue entrenado con el tipo correcto de datos desde el principio, en lugar de intentar compensar los puntos ciegos de un codificador de imágenes naturales con un modelo posterior más grande. Esa es una lección significativamente diferente a "hacer el transformer más pequeño". Indica que el campo ha estado pagando de más por capacidad visual que estaba enfocada en el problema equivocado.
No es solo para análisis sintáctico
El artículo también prueba el codificador congelado como un componente en modelos de comprensión de documentos, sistemas que no solo transcriben un documento, sino que responden preguntas sobre él, lo resumen o razonan sobre su diseño. Aquí comparan contra codificadores construidos sobre CLIP, DINO y SAM: tres de los backbones de visión más utilizados en IA multimodal, todos entrenados principalmente en imágenes naturales o tareas de segmentación general en lugar de documentos específicamente.
Bajo condiciones de entrenamiento idénticas, el codificador MonkeyOCRv2 superó a los tres en ocho benchmarks. Eso es un control útil: misma arquitectura downstream, misma receta de entrenamiento, solo cambia el codificador. Aísla la afirmación a lo que debería ser aislada, que el preentrenamiento visual específico de documentos produce una base mejor que el preentrenamiento de propósito general, en lugar de ser un artefacto de un pipeline de entrenamiento mejor en otro lugar del sistema.
Lo que el artículo no te cuenta
Hay algunas cosas que vale la pena señalar antes de que nadie trate esto como un asunto zanjado.
En primer lugar, el resumen ejecutivo no informa sobre el cómputo de entrenamiento ni el coste, y lo mismo ocurre con el resumen disponible aquí. Construir un corpus de preentrenamiento de 113 millones de imágenes y ejecutar el objetivo conjunto a esa escala no es barato, y no está claro si laboratorios más pequeños o desarrolladores independientes podrían reproducir algo parecido sin recursos similares. La eficiencia en el momento de la inferencia (un modelo de 0.7B) no dice mucho sobre la eficiencia en el momento del entrenamiento.
En segundo lugar, la detección de manipulaciones y la segmentación de texto superpuesto son capacidades útiles, pero también son benchmarks comparativamente nicho, y las puntuaciones altas allí no predicen necesariamente cómo manejará el modelo los documentos del mundo real más desordenados: recibos arrugados, escaneos de fax de bajo contraste, escritura a mano mezclada con texto impreso, documentos fotografiados de lado con mala iluminación. MDPBench sí incluye documentos fotografiados, lo cual es una buena señal, pero "fotografiados bajo condiciones de benchmark" y "fotografiados por alguien en un almacén con una mano y la linterna del móvil" no son la misma prueba.
En tercer lugar, no se menciona nada sobre licencias, disponibilidad de pesos o si MonkeyDoc v2 se liberará. Gran parte del valor práctico de un artículo como este, para las personas que realmente están construyendo productos de OCR, depende de si el codificador preentrenado aparece en algún lugar utilizable, no solo en una tabla de benchmarks.
Por qué importa para quien construye o compra OCR
Si estás evaluando motores OCR o construyendo un pipeline que debe sobrevivir al contacto con documentos reales de clientes, la conclusión no es "usa MonkeyOCRv2 específicamente". Es que el codificador visual subyacente a un sistema OCR o de análisis de documentos no es una mercancía intercambiable, y los datos de preentrenamiento detrás de él importan tanto como el modelo de lenguaje acoplado encima. Un sistema construido alrededor de un backbone visual de propósito general lleva una desventaja estructural en texto denso, fórmulas pequeñas y contenido alterado o superpuesto, independientemente de qué tan bueno sea su modelo de lenguaje limpiando la salida después.
Prácticamente, eso significa algunas cosas que vale la pena verificar cuando comparas motores: cómo se desempeñan en documentos con muchas fórmulas o fuentes pequeñas específicamente, no solo páginas impresas limpias; cómo manejan documentos donde algo ha sido alterado o sellado encima; y si los números de precisión reclamados provienen de PDFs nacidos digitales, documentos fotografiados, o ambos. La brecha entre esas categorías es exactamente donde los codificadores visuales de propósito general tienden a fallar, y es exactamente donde un paper como este intenta cerrar la distancia.
La señal más amplia, si los resultados se mantienen fuera de los benchmarks de este único paper, es que la IA de documentos está comenzando a crecer sus propios modelos de fundación en lugar de tomar prestados los construidos para un trabajo diferente. Esa es una dirección saludable. Un campo que sigue reutilizando codificadores visuales de gatos y coches para facturas y contratos siempre iba a encontrar un techo en algún lugar, y este paper es un argumento decente de que lo estamos encontrando.