AI मॉडल्स की नकली दृष्टि को पकड़ने वाला मैप बेंचमार्क
आधारित शोध-पत्र: OmniMapBench: Benchmarking Visual-Centric Reasoning on Diverse Map Documents — Yang Chen, Yunwen Li, Yufan Shen, Minghao Liu, Tianyu Zheng, Bin Fu, Qunshu Lin, Zhi Yu, Botian Shi
इस पेपर में आकृति 1 (Figure 1) को देखें और आपको कुछ अजीब दिखाई देगा। एक तरफ, DocVQA की एक स्क्रीनशॉट है, जो दस्तावेज़-समझ (document-understanding) के मानक बेंचमार्कों में से एक है: धूम्रपान करने वालों के बारे में सर्वेक्षण डेटा से भरा एक तालिका, जिसके नीचे एक प्रश्न है कि कितने प्रतिशत लोगों को जीवन में अधिक रोमांच खोजने की आवश्यकता महसूस होती है। दूसरी तरफ, बच्चों की किताब की एक चित्रकला जैसा कुछ है: एक सादा हरा पड़ोस जिसमें कुछ घर, कुछ टेढ़े-मेढ़े रास्ते, और कार्टून पेड़ हैं। प्रश्न पूछता है कि यदि आप बाईं ओर से प्रवेश करते हैं और ड्राइविंग जारी रखते हैं, तो आप दाईं ओर कौन सा घर देखेंगे।
तालिका को "वर्णन में आसान" (easy to describe) लेबल किया गया है। कार्टून पड़ोस को "वर्णन में कठिन" (difficult to describe) लेबल किया गया है। यह एक इंसान की नज़र में दिखने वाले विपरीत है, और यही बिल्कुल उद्देश्य है। एक मॉडल सर्वेक्षण तालिका को पाठ के एक पैराग्राफ में बदल सकता है और प्रश्न का उत्तर आसानी से दे सकता है, क्योंकि तालिकाएं पहले से ही पाठ के आधे रास्ते पर होती हैं। लेकिन एक पैराग्राफ लिखने की कोशिश करें जो एक टेढ़े रास्ते की प्रणाली के सापेक्ष किस घर का स्थान है, इसे पूरी तरह से कैप्चर करे, और किसी भी संभावित प्रश्न का उत्तर देने के लिए पर्याप्त विस्तार से, और आप खुद को या तो एक निबंध लिखते हुए या कुछ छोड़ते हुए पाएंगे। "सरल दिखने" और "वर्णन का प्रतिरोध करने" के बीच यह अंतर OmniMapBench, शंघाई एआई लैबोरेटरी, जियांगशियांग विश्वविद्यालय और सहयोगियों द्वारा एक नए बेंचमार्क द्वारा, उजागर करने के लिए बनाया गया है।
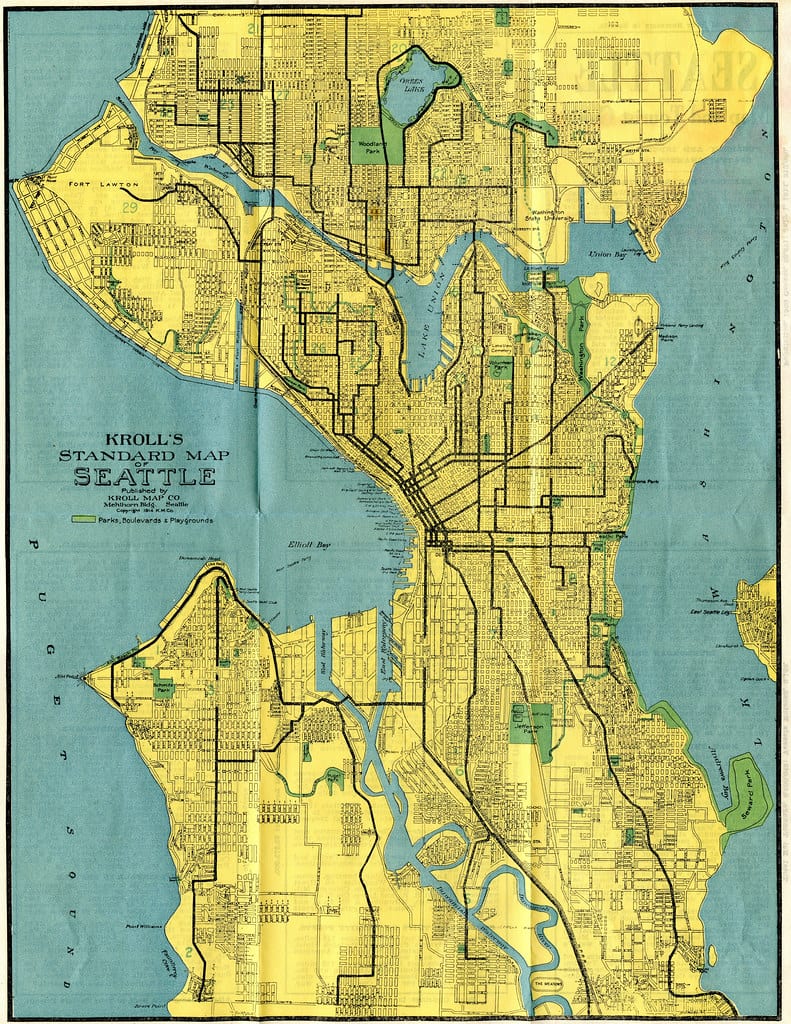
Seattle Map 1914 — by Rob Ketcherside via flickr, BY 2.0.
"दृश्य" बेंचमार्क जो अक्सर यह नहीं समझते कि वे किस खेल में फंसे हैं
इस पेपर के केंद्र में एक असुविधाजनक सच छिपा है। कई बेंचमार्क जो दावा करते हैं कि वे बड़े विज़न-लैंग्वेज मॉडल्स (LVLMs, जो इमेज और टेक्स्ट दोनों को इनपुट के रूप में ले सकते हैं) में दृश्य तर्कशक्ति का परीक्षण करते हैं, वास्तव में बिना किसी गंभीर दृश्य तर्कशक्ति के हल किए जा सकते हैं। यदि किसी चार्ट को डेटा टेबल में, किसी दस्तावेज़ को OCR टेक्स्ट में, या किसी ज्यामिति आरेख को निर्देशांकों की सूची में बिना किसी नुकसान के बदला जा सकता है, तो मॉडल को इमेज को वास्तव में देखने की आवश्यकता नहीं होती। उसे बस इमेज को टेक्स्ट में एक बार बदलना होता है और फिर वह काम करना होता है जिसमें LLMs पहले से ही माहिर हैं: टेक्स्ट पर तर्क करना।
यह कोई काल्पनिक चिंता नहीं है। शोधकर्ताओं का कहना है कि रीट्रिवल पाइपलाइनों में दस्तावेज़ इमेज अक्सर मार्कडाउन में बदले जाते हैं, और चार्ट और टेबल को नियमित रूप से कोड या संरचित डेटा में बदल दिया जाता है। ज्यामिति के प्रश्न भी, जो सतह पर दृश्य लगते हैं, अक्सर "टेक्स्ट-कम्प्लीट" होते हैं, जिसका अर्थ है कि आकृतियों का शब्दों में वर्णन करने से उन्हें हल किया जा सकता है। इसलिए जब कोई बेंचमार्क रिपोर्ट करता है कि किसी मॉडल ने किसी "दृश्य तर्कशक्ति" कार्य में 90% स्कोर किया है, तो एक सवाल पूछना जरूरी है: क्या मॉडल ने वास्तव में अपनी आँखों का इस्तेमाल किया, या उसने बस पढ़ा?
इस सवाल का जवाब लेखकों के अनुसार मैप्स हैं। किसी मैप का अर्थ उसके स्थानिक लेआउट में निहित होता है: कंटूर लाइनें, रंग-कोडेड क्षेत्र, ऐसे प्रतीक जिनका अर्थ लेजेंड पर निर्भर करता है, और चीजों का एक-दूसरे के सापेक्ष स्थान। आप स्प्रेडशीट की तरह उसे एक साफ पैराग्राफ में नहीं बदल सकते। यही कारण है कि मैप्स एक अच्छा स्ट्रेस टेस्ट हैं, और यही कारण है कि OmniMapBench का अस्तित्व है।
एक बेचमार्क को वास्तव में दृष्टि की आवश्यकता होती है, यह कैसे सिद्ध करें
इस पेपर की चतुराई सिर्फ "हमने एक मैप बेचमार्क बनाया" इस बात में नहीं है। इसमें लेखकों ने एक तरीका विकसित किया है जो किसी भी बेचमार्क के लिए मापता है कि वह कितना हद तक छवि पर निर्भर करता है और कितना हद तक उसे टेक्स्ट के साथ गेम किया जा सकता है।
वे इसे विजुअल डिपेंडेंसी इंडेक्स (VDI) कहते हैं, और इसकी अवधारणा एक बार देखने पर सरल है। एक बेचमार्क लें। एक मजबूत मॉडल को सामान्य रूप से, असली छवि के साथ चलाएं, और सटीकता रिकॉर्ड करें। फिर छवि को हटा दें, लेकिन उसी मॉडल को उस छवि का एक लिखित विवरण उत्पन्न करने दें (एक निश्चित टोकन बजट तक सीमित, ताकि वह अनंत विस्तृत ट्रांसक्रिप्ट नहीं डंप कर सके)। उस विवरण को छवि के बजाय मॉडल को वापस फीड करें, और सटीकता को फिर से मापें। VDI उन दो संख्याओं के बीच प्रतिशत गिरावट है। यदि एक मॉडल अपने स्वयं के टेक्स्ट विवरण से काम करते हुए असली छवि को देखने जितना ही अच्छा प्रदर्शन करता है, तो VDI कम होता है, और बेचमार्क आपको बताता है कि उसे वास्तविक दृष्टि की आवश्यकता नहीं है। यदि छवि के बिना सटीकता गिर जाती है, तो VDI उच्च होता है।
परिणाम स्पष्ट हैं। 1,024 टोकन के विवरण बजट पर, जो लगभग कुछ सघन पैराग्राफ के लिए पर्याप्त है, AI2D (विज्ञान आरेख) और MMBench जैसे बेचमार्क लगभग टूट जाते हैं: उनका VDI लगभग शून्य तक गिर जाता है, जिसका अर्थ है कि एक पर्याप्त अच्छा पैराग्राफ आपको असली छवि के जितनी ही सटीकता प्रदान करता है। OmniMapBench दूसरे छोर पर है, जिसका VDI 0.338 है, जो ग्यारह परीक्षण किए गए बेचमार्क में सबसे उच्च है, जिसमें DocVQA, ChartQA, और MathVista जैसे परिचित नाम शामिल हैं। लेखकों ने एक साथी मेट्रिक का भी ट्रैक रखा जिसे डिस्क्रिप्टिव सैचुरेशन इंडेक्स (DSI) कहा जाता है, जो मापता है कि मॉडल छवि का वर्णन करने के लिए अपने पूरे टोकन बजट का उपयोग करते रहते हैं या इसलिए जल्दी छोड़ देते हैं क्योंकि कहने के लिए कुछ नहीं बचा है। OmniMapBench वहां 0.629 स्कोर करता है, तुलना में दूसरा सबसे उच्च, जिसका अर्थ है कि मॉडल टोकन सीमा पर भी इन मानचित्रों का वर्णन करने के लिए अधिक शब्दों के लिए प्रयास करते रहते हैं। उन दो संख्याओं को एक साथ रखें और आपको एक बेचमार्क मिलता है जो दो अलग-अलग कोणों से टेक्स्ट-कनवर्जन शॉर्टकट का प्रतिरोध करता है।
1,603 ऐसे नक्शे जो छल-कपट से नहीं हल हो सकते
डेटासेट स्वयं कुछ प्रसिद्ध VQA बेचमार्क्स (DocVQA में लगभग 50,000 प्रश्न-उत्तर जोड़े हैं; OmniMapBench में 2,096 हैं) से छोटा है, लेकिन निर्माण प्रक्रिया पर एक नज़र डालने लायक है क्योंकि यह समझाती है कि प्रश्नों को शॉर्टकट करना क्यों कठिन है।
टीम ने शुरू में नौ लक्षित श्रेणियों में विविध खोज क्वेरी उत्पन्न करने के लिए LLM का उपयोग करते हुए 5,000 से अधिक नक्शे छवि स्क्रैप और मैन्युअल रूप से एकत्र कीं, साथ ही ट्रांसिट आरेखों जैसे विशेष नक्शों के लिए सरकारी पोर्टल और सोशल प्लेटफॉर्म से लक्षित स्रोत जुटाए। उन्होंने उस पूल को लगभग 2,000 छवियों तक कम कर दिया, जिनमें से लगभग डुप्लिकेट, कम रिज़ॉल्यूशन वाले स्कैन और राजनीतिक रूप से संवेदनशील क्षेत्रों से जुड़ी कोई भी चीज़ हटा दी गई। मानव एनोटेटर्स ने फिर सख्त नियमों का पालन करते हुए हाथ से प्रश्न-उत्तर जोड़े लिखे: हर प्रश्न का उत्तर केवल नक्शे में दी गई दृश्य जानकारी का उपयोग करके दिया जाना चाहिए था, बिना किसी बाहरी ज्ञान की आवश्यकता के, और ग्रेडिंग को वस्तुनिष्ठ रखने के लिए इसे एकल-चयन, बहु-चयन या क्रमबद्ध प्रश्नों के रूप में प्रारूपित किया गया था।
एनोटेटर्स को जानबूझकर तीन कठिनाई स्तरों को हासिल करना भी था: स्तर 1 के प्रश्न बुनियादी प्रत्यक्षीकरण का परीक्षण करते हैं (क्या आप प्रतीक को खोज और पढ़ सकते हैं), स्तर 2 एकल-चरण स्थानिक तर्क का परीक्षण करता है (इन दो बिंदुओं में से कौन सा नदी के करीब है), और स्तर 3 बहु-चरण संबंधी तर्क का परीक्षण करता है (कई मोड़ों से मार्ग का पता लगाएं और रास्ते में दिखाई देने वाली चीज़ों की रिपोर्ट करें)। उस पहले चरण ने 3,386 QA जोड़े उत्पन्न किए, जिन्हें फ़िल्टर और पुनः संतुलित करके 2,882 तक कम किया गया, फिर एक दूसरे, स्वतंत्र क्रॉस-वैलिडेशन दौर से गुज़ारा गया जहाँ एनोटेटर्स की एक अलग टीम ने सटीकता और श्रेणी सटीकता के लिए हर जोड़े की जाँच की। जो भी उस जाँच में टिक नहीं पाया, उसे फेंक दिया गया। जो बचा: 1,603 छवियों में 2,096 जोड़े।
नौ श्रेणियाँ इस बात का अंदाज़ा देती हैं कि यहाँ "नक्शा" शब्द कितना विस्तृत है: इंडोर नेविगेशन (छवियों का 18.3%), शिक्षा और इतिहास (17.2%), इंजीनियरिंग और सुविधाएँ (16.8%), परिवहन (15.7%), पर्यटन (13.2%), भूगोल और रिमोट सेंसिंग (7.3%), पर्यावरण और प्रकृति (5.2%), सामाजिक-आर्थिक (3.9%), और विशेष रूप से, गेम नक्शे (2.4%), जिसका अर्थ है काल्पनिक फैंटेसी या वीडियो-गेम दुनिया के नक्शे। यह अंतिम श्रेणी उन बेचमार्क्स पर एक जानबूझकर किया गया हमला है जो मानते हैं कि नक्शों का अर्थ वास्तविक दुनिया का भूगोल है। पूर्व नक्शा-विशिष्ट बेचमार्क्स अक्सर संकीर्ण रूप से विशेषज्ञ होते हैं, जैसे कि ReasonMap (केवल ट्रांसिट नक्शे, लगभग 30 छवियाँ) या MapQA (केवल कोरप्लेथ नक्शे)। OmniMapBench की दांव यह है कि विविधता, सबवे आरेखों से लेकर मॉल निर्देशिकाओं और आपातकालीन मार्गों के फ्लोर प्लान तक, ही मॉडल की सामान्य स्थानिक तर्क शक्ति को परखती है, न कि किसी एक नक्शे की शैली से परिचितता।
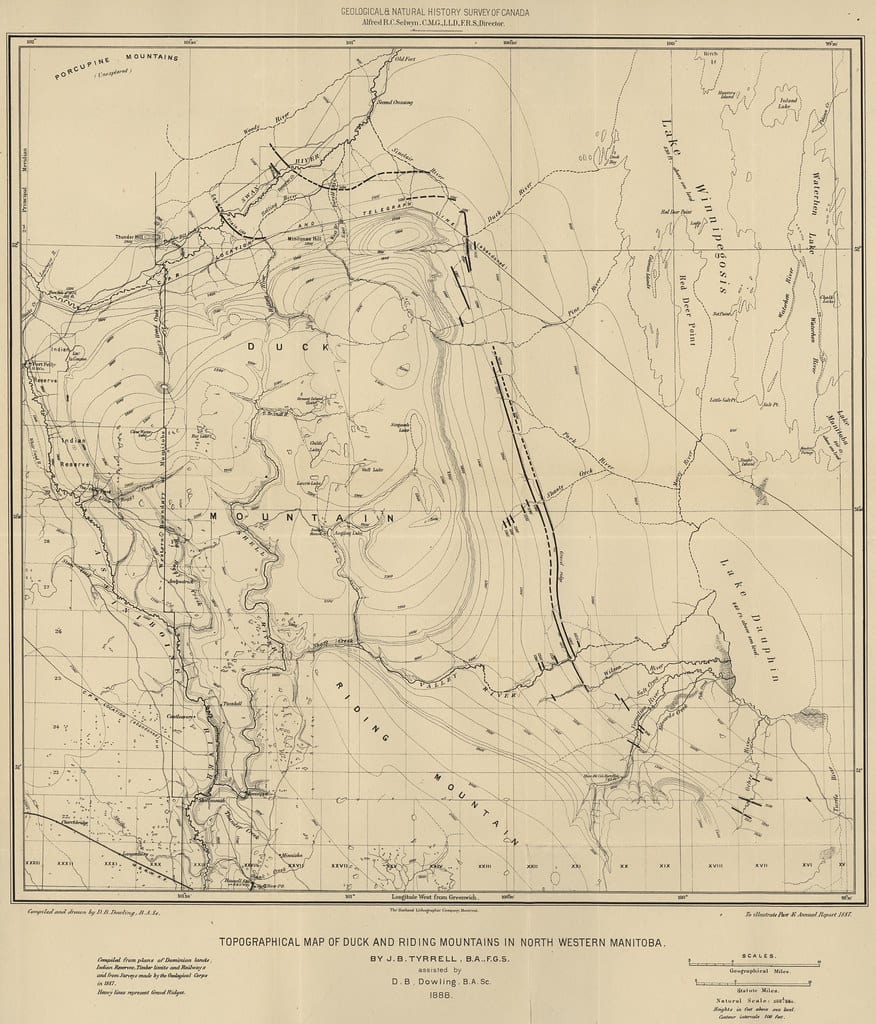
डक और राइडिंग पहाड़ियों का टोपोग्राफिक नक्शा, उत्तर-पश्चिमी मैनिटोबा (1888) — मैनिटोबा हिस्टोरिकल मैप्स द्वारा flickr के माध्यम से, BY 2.0।
स्कोरबोर्ड: 25 मॉडल, और 75% की सीमा
मुख्य परिणाम यह है कि सबसे अच्छा परीक्षण किया गया मॉडल, Gemini-3.1-Pro, ने कुल मिलाकर 75.03% स्कोर किया। एक ऐसे बेंचमार्क के लिए जो बहुविकल्पीय और क्रमबद्ध प्रश्नों से बना है, जहां यादृच्छिक अनुमान लगाने से भी कुछ मिल जाता है, यह 2026 में एक फ्रंटियर मॉडल के लिए एक सार्थक रूप से कम सीमा है।
25 मॉडलों के पूर्ण लीडरबोर्ड में कुछ बातें उभर कर सामने आती हैं। सबसे पहले, शीर्ष प्रोप्राइटरी और शीर्ष ओपन-सोर्स मॉडलों के बीच का अंतर उम्मीद से कम है: Qwen3.5-397B-A17B ने 72.22% स्कोर किया, जो Gemini-3.1-Pro से तीन अंक कम है, और स्पष्ट रूप से कई अन्य प्रोप्राइटरी सिस्टमों जैसे GPT-5 (56.54%), Claude-Sonnet-4-5 (45.04%), और GPT-4o से आगे है, जो सभी 25 मॉडलों में अंतिम स्थान पर 31.47% स्कोर के साथ रहा। यदि आप यह मान रहे थे कि "प्रोप्राइटरी फ्लैगशिप" का अर्थ स्वचालित रूप से "विजुअल रीजनिंग में सर्वश्रेष्ठ" होता है, तो यह लीडरबोर्ड इसके विपरीत तर्क देता है।
दूसरा, जैसे-जैसे तर्क करना कठिन होता जाता है, प्रदर्शन में तेजी से गिरावट आती है। Gemini-3.1-Pro के अपने स्कोर कठिनाई के अनुसार कहानी बताते हैं: लेवल 1 (अवधारणा) पर 88.24%, लेवल 2 (एक-चरणीय तर्क) पर 81.53%, और लेवल 3 (बहु-चरणीय तर्क) पर 62.88%। नक्शे से एक प्रतीक पढ़ना एक बात है। प्रश्न का उत्तर देने के लिए कई स्थानिक तथ्यों को एक साथ जोड़ना एक अलग कौशल है, और यह वही है जो स्पष्ट रूप से अभी भी विकसित हो रहा है।
तीसरा, श्रेणी बहुत मायने रखती है। मॉडल Tourism जैसी श्रेणियों में तुलनात्मक रूप से अच्छा प्रदर्शन करते हैं, जहां नक्शों में अधिक पारंपरिक लेबल किया गया पाठ (लैंडमार्क नाम, स्ट्रीट साइन) शामिल होता है जिस पर मॉडल निर्भर कर सकते हैं। वे Topography & Remote Sensing पर कम अच्छा प्रदर्शन करते हैं, जहां जानकारी घने, गैर-मानक प्रतीकों, कंटूर लाइनों और निरंतर रंग ग्रेडिएंट में एन्कोड की गई होती है, न कि असतत लेबल किए गए पाठ में। यह पेपर के पूरे प्रमेय के साथ सुसंगत है: नक्शे को शब्दों में बताना जितना कठिन है, वर्तमान मॉडलों के लिए उतना ही कठिन है।
इसके अलावा, एक नियंत्रण प्रयोग का उल्लेख करना भी महत्वपूर्ण है। लेखकों ने एक "बिना छवि" बेसलाइन चलाया: मॉडल को केवल प्रश्न और उत्तर विकल्प दिए गए, कोई छवि और कोई विवरण नहीं, यह देखने के लिए कि क्या बेंचमार्क को केवल उत्तर-विकल्प पूर्वाग्रह या सामान्य विश्व ज्ञान के माध्यम से गेम किया जा सकता है। तीन परीक्षण किए गए मॉडलों में औसत सटीकता सामान्य पहुंच के साथ 58.87% से अंधेरे में 23.35% तक गिर गई। यह यादृच्छिक अनुमान लगाने और संभावनापूर्ण लगने वाले उत्तरों की ओर हल्के पूर्वाग्रह के बीच के कुछ के लिए उम्मीद की गई बात के करीब है, जो अच्छी खबर है: इसका मतलब है कि बेंचमार्क गुप्त रूप से हल नहीं किया जा सकता है, बस एक ऐसा मॉडल जो सबसे कम अजीब लगने वाले बहुविकल्पीय उत्तर को चुनने में अच्छा हो।
यह क्यों मायने रखता है किसी भी ऐसे व्यक्ति के लिए जो OCR पाइपलाइन बना रहा है या चुन रहा है
अगर आपका प्रोडक्ट उन दस्तावेज़ों को छूता है जो मूल रूप से स्थानिक (spatial) हैं न कि पाठ-आधारित—जैसे फ्लोर प्लान, ट्रांजिट मैप्स, साइट डायग्राम, एवाक्यूएशन रूट्स, GIS ओवरले—तो यह पेपर एक चेतावनी की तरह है। एक पाइपलाइन जो OCR चलाकर या "इस इमेज का वर्णन करो" वाले पास से होकर गुजरती है और फिर परिणामी टेक्स्ट को LLM को सौंपती है, वह इसी श्रेणी के दस्तावेज़ों पर चुपके से फेल हो जाएगी, क्योंकि जो जानकारी मायने रखती है (क्या किसके पास है, कौन सा पथ किस कमरे से जुड़ता है, कौन सी क्षेत्र किस रंग में छाई है) वह कैप्शन में बदलने पर बची नहीं रहती। OCR और डॉक्यूमेंट-AI वेंडर्स जो DocVQA-स्टाइल बेंचमार्क नंबर प्रकाशित करना पसंद करते हैं, वे आपको इस श्रेणी को उनके सिस्टम कैसे हैंडल करता है, इसके बारे में कुछ नहीं बताते, क्योंकि उन बेंचमार्क को इस पेपर के अपने मापदंड के अनुसार, मुख्य रूप से टेक्स्ट शॉर्टकट्स के जरिए हल किया जा सकता है।
प्रैक्टिकल कदम यह है कि एग्रीगेट एक््युरेसी स्कोर पर भरोसा करने के बजाय असली फेल्योर मोड को ध्यान में रखकर टेस्ट करें। पूछें कि क्या एक इंजन फ्लोर प्लान के जरिए एक रूट को ट्रेस कर सकता है और बता सकता है कि उसमें क्या है, न कि क्या वह बाउंडिंग बॉक्स के अंदर टेक्स्ट को ट्रांसक्राइब कर सकता है। अगर आप मैप्स, ब्लूप्रिंट्स, टेक्निकल स्कीमेटिक्स या डायग्राम वाले किसी भी काम के लिए OCR या डॉक्यूमेंट-AI वेंडर्स का मूल्यांकन कर रहे हैं, तो "हम विजुअल डॉक्यूमेंट्स हैंडल करते हैं" को सतही रूप में न लें: स्पष्ट रूप से मल्टी-स्टेप, स्थानिक रूप से आधारित सवालों पर एक््युरेसी के लिए पूछें, क्योंकि यही वह जगह है जहां जनरल-पर्पोज OCR पाइपलाइंस और मजबूत LVLMs वर्तमान में संघर्ष कर रहे हैं। अभी, दुनिया का सबसे बेहतरीन मॉडल भी इस पर तीन-चौथाई एक््युरेसी पर ही रुक जाता है। अगर आपका यूज केस उस आखिरी चौथाई को सही पाने पर निर्भर करता है, तो मानवीय समीक्षा या एक संकीर्ण, उद्देश्य-निर्मित दृष्टिकोण के लिए योजना बनाएं, बजाय इसके कि मान लें कि एक जेनरिक विजन-लैंग्वेज मॉडल आपको बॉक्स से बाहर निकाल देगा। मजबूत अंग्रेजी OCR का मतलब यह नहीं होता कि देवनागरी OCR भी उतना ही अच्छा होगा; इसलिए, यदि आपका डेटा हिंदी या अन्य भारतीय भाषाओं में है, तो मॉडल की देवनागरी स्क्रिप्ट हैंडलिंग क्षमता को अलग से सत्यापित करना अनिवार्य है।
यह बेचमार्क जितना दिखता है, उससे पतला है
OmniMapBench को अंतिम सत्य मानने से पहले कुछ सावधानियाँ ध्यान में रखने योग्य हैं। 2,096 QA जोड़ों के साथ, यह DocVQA के 50,000 से अधिक मामलों या कुछ चार्ट बेचमार्कों में लाखों मामलों की तुलना में छोटा है, और श्रेणी वितरण असंतुलित है: Indoor Navigation, Education & History, और Engineering & Facilities मिलकर छवियों का आधा से अधिक हिस्सा बनाते हैं, जबकि Game maps कुल मिलाकर 40 से कम छवियों का हिस्सा हैं। अपने सबसे छोटे श्रेणियों में इतना पतला बेचमार्क श्रेणी स्तर पर शोर (noise) वाला हो सकता है, भले ही समग्र संख्याएँ मजबूत हों।
VDI मेट्रिक स्वयं भी केवल एक संदर्भ मॉडल (GPT-4.1) पर निर्भर करता है, जिसका उपयोग केवल-पाठ तुलना के लिए विवरण उत्पन्न करने के लिए किया जाता है। लेखकों ने एक एब्लेशन चलाया जिसमें एक अलग संदर्भ मॉडल का उपयोग किया गया और स्थिर प्रवृत्तियाँ पाईं, जो मददगार है, लेकिन मेट्रिक मूल रूप से यह पूछ रहा है "यह एक मॉडल इस बेचमार्क को शब्दों में कितना अच्छे से वर्णित कर सकता है," न कि छवियों के स्वयं के किसी मॉडल-स्वतंत्र गुण को। और बेचमार्क केवल अंग्रेजी और चीनी (क्रमशः प्रश्नों का 61% और 39%) को कवर करता है, इसलिए यह इस बारे में कुछ नहीं कहता कि अन्य भाषाओं या लिपियों में एनोटेट किए गए मानचित्रों के लिए ये परिणाम कैसे बदल सकते हैं।
इनमें से कोई भी बात मुख्य निष्कर्ष को कमजोर नहीं करती। एक छोटे डेटासेट और एक अपूर्ण मेट्रिक के बावजूद, OmniMapBench के VDI और अन्य सभी परीक्षण किए गए मॉडलों के बीच का अंतर इतना बड़ा है कि यह विश्वासनीय है, और दुनिया के सर्वश्रेष्ठ मॉडल से 75% की सीमा एक वास्तविक परिणाम है, गोल करने की त्रुटि नहीं। पेपर का वास्तविक योगदान कम "यहाँ अंतिम मानचित्र बेचमार्क है" और अधिक "यहाँ एक विधि है यह जानने के लिए कि क्या आपका बेचमार्क दृष्टि का परीक्षण कर रहा है या छुपे हुए रूप में पढ़ने की समझ का परीक्षण कर रहा है" है। यह एक उपकरण है जिसकी आवश्यकता है, और यह एक ऐसा उपकरण है जिसकी देर हो चुकी है, यह देखते हुए कि कितने "दृश्य तर्क" लीडरबोर्ड वर्तमान में, संभवतः अनजाने में, पिछले वाले के करीब कुछ माप रहे हैं।