ईंजीनियर की तरह, स्कैनर की तरह नहीं ब्लूप्रिंट पढ़ने वाला AI
आधारित शोध-पत्र: Drawing-Recode: Annotation Grounding for Parametric CAD Code Generation from Raster 2D CAD Drawings — Mingi Kim, Yongjun Kim, Hyungki Kim
ड्रॉइंग-रिकोड: 2D ड्रॉइंग से CAD कोड तक की यात्रा
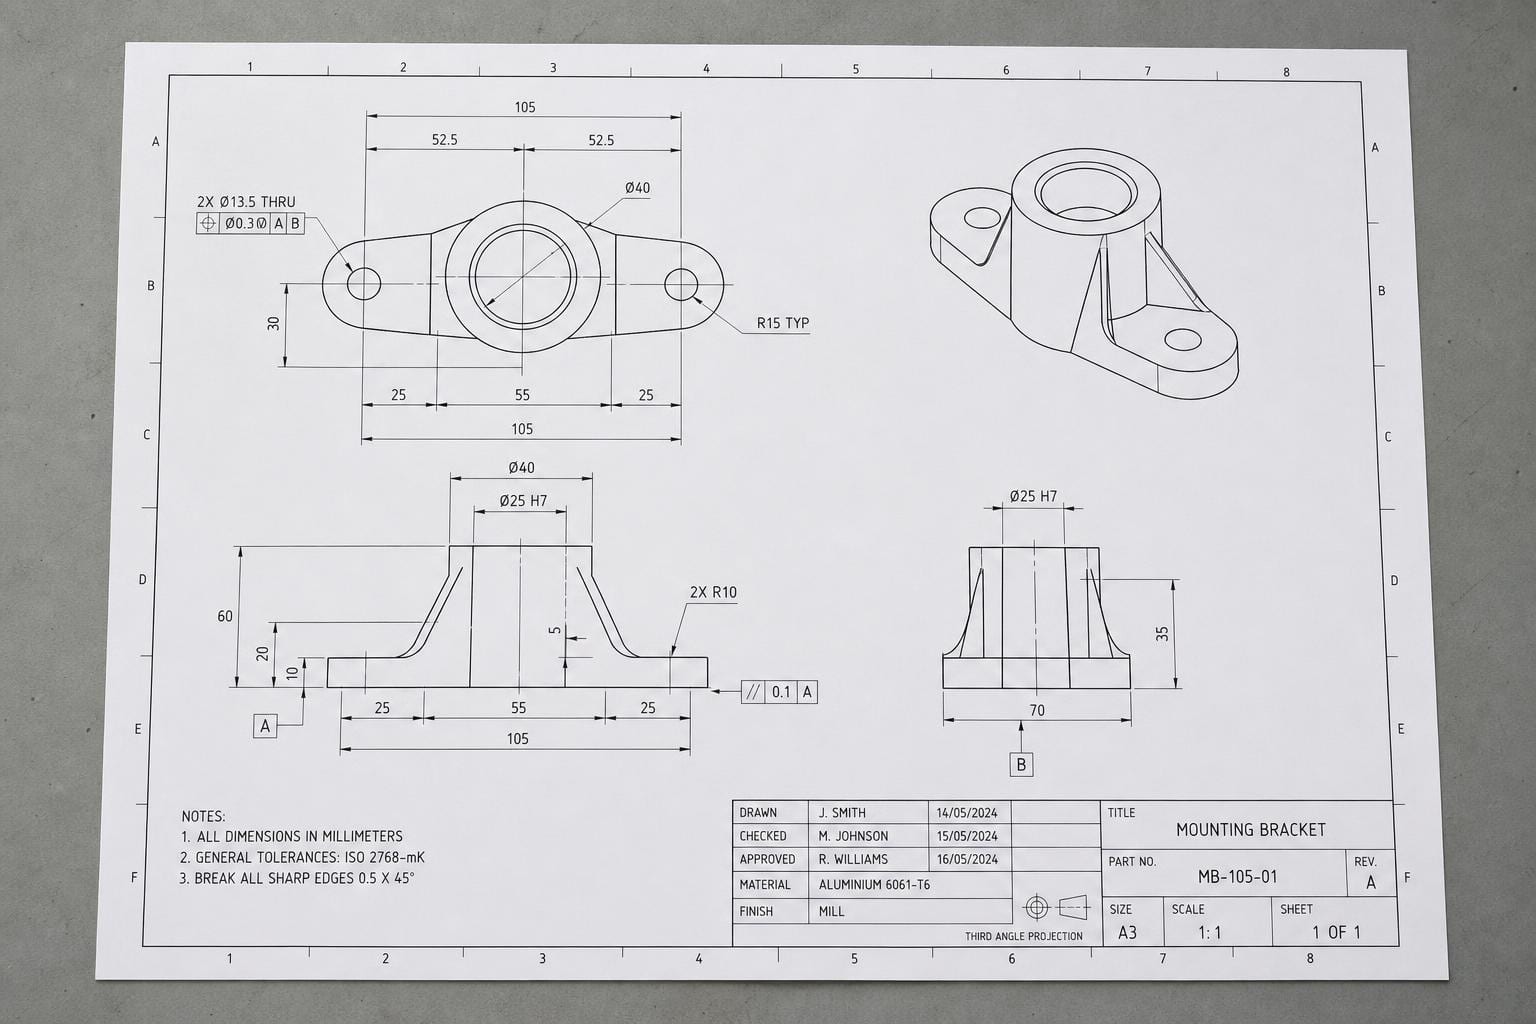
किसी भी समय, किसी भी मैन्युफैक्चरिंग प्लांट में, ऐसे पार्ट्स के लिए ड्रॉइंग्स से भरा एक फाइलिंग कैबिनेट हो सकता है जिन्हें अब ऑर्डर नहीं किया जा सकता। 1994 का एक ब्रैकेट, जो हाथ से डायमेंशन किया गया था और इतनी बार फोटोकॉपी किया गया कि उसकी लाइनें धुंधली पड़ गई हैं। मूल पार्ट बनाने वाली कंपनी अब नहीं है। जिस इंजीनियर ने इसे बनाया था, वह दशक पहले रिटायर हो चुके हैं। लेकिन एक ग्राहक को अभी भी उसी ब्रैकेट की जरूरत है, और इसका एकमात्र रिकॉर्ड कागज का एक सपाट टुकड़ा है।
आधुनिक CNC मशीन या 3D प्रिंटर पर उस पार्ट को बनाने के लिए, किसी को उस ड्रॉइंग को वापस एक लाइव, पैरामेट्रिक 3D मॉडल में बदलना होगा: पार्ट की एक तस्वीर नहीं, बल्कि निर्देशों का एक सेट जो कंप्यूटर को रीसाइज, एडिट और मशीन करने में सक्षम बनाता है। आज इसका मतलब है कि एक CAD तकनीशियन बैठकर पूरा काम हाथ से दोबारा ड्रॉ करता है, कागज से प्रत्येक डायमेंशन पढ़ता है और उसे सॉफ्टवेयर में दोबारा दर्ज करता है। यह धीमा है, महंगा है, और यह बिल्कुल वही प्रकार का कार्य है जिसमें एक अच्छा AI सिस्टम मदद कर सकता है।
Mingi Kim, Yongjun Kim, और Hyungki Kim द्वारा लिखी गई एक नई पेपर, Drawing-Recode, उस पाइपलाइन को ऑटोमेट करने का प्रयास करती है: एक स्कैन की गई 2D ड्रॉइंग डालें, और काम करने वाला CAD कोड वापस पाएं। इसे दिलचस्प बनाने वाली बात सिर्फ यह नहीं है कि यह इसका प्रयास करती है। यह वह विशिष्ट समस्या है जिसे लेखकों ने वास्तविक बाटलनेक के रूप में पहचाना है, और यह वह समस्या है जिसे अधिकांश OCR-संबंधित सिस्टम चुपचाप नजरअंदाज कर देते हैं।
एक संख्या को पढ़ने और उस माप को समझने के बीच का अंतर
यहाँ एक महत्वपूर्ण भेद से शुरुआत करें: रैस्टर बनाम वेक्टर। एक वेक्टर CAD फ़ाइल (उदाहरण के लिए एक DXF या एक नेटिव SolidWorks फ़ाइल) ज्यामिति को संरचित डेटा के रूप में संग्रहित करती है: यह रेखा बिंदु A से बिंदु B तक जाती है, इस वृत्त का यह त्रिज्या है। एक रैस्टर छवि केवल पिक्सेल है। एक स्कैन की गई ड्राइंग, ब्लूप्रिंट की एक फोटो, या एक PDF जो वास्तव में नीचे एक तस्वीर है, ये सभी रैस्टर हैं। इनमें बिल्कुल भी संरचना नहीं है, केवल रंगीन बिंदु हैं जो इंसानी आंख को रेखाओं और पाठ जैसे लगते हैं।
एक रैस्टर CAD ड्राइंग से पाठ को पढ़ना एक हल हो चुका (थोड़ा-बहुत) समस्या है। OCR पृष्ठ से "Ø25" या "50.5" को, आयाम प्रतीकों सहित, काफी अच्छी तरह निकाल सकता है। Drawing-Recode वास्तव में इस बारे में नहीं है।
कठिन समस्या यह है: एक बार जब आप पृष्ठ से "50.5" पढ़ लेते हैं, तो यह किससे संबंधित है? एक CAD ड्राइंग लेबल वाले फ़ील्ड वाला फॉर्म नहीं है। यह एक भाग की तस्वीर है, जिसमें आयाम रेखाओं और संख्याओं का एक समूह विशिष्ट किनारों, छेदों और सतहों की ओर इशारा कर रहा है। एक आयत के पास "50.5" संभवतः इसकी चौड़ाई का वर्णन करता है, लेकिन यह विकर्ण, एक छेद की दूरी, या तीन पंक्तियों दूर किसी चीज़ का वर्णन भी कर सकता है जिससे एक्सटेंशन लाइन बस क्रॉस हो जाती है। यदि आप उस लिंक को गलत समझते हैं, तो आपको थोड़ा-बहुत गलत भाग नहीं मिलता। आपको संरचनात्मक रूप से गलत भाग मिलता है, क्योंकि एक पैरामेट्रिक CAD मॉडल ऑपरेशनों का एक अनुक्रम है (इस आयत को स्केच करें, इसे इतनी दूर एक्सट्रूड करें, इस छेद को काटें) जहाँ हर कदम इस बात पर निर्भर करता है कि संख्याएं सही ज्यामिति से जुड़ी हों।
पेपर का फ्रेमवर्क यह है कि पिछले सिस्टम या तो केवल वेक्टर ड्राइंग्स पर काम करते हैं (जिनमें यह संरचना पहले से ही बनाई गई है, इसलिए हल करने के लिए कुछ नहीं है) या संकीर्ण हैं, एक प्रकार की ड्राइंग या एक उद्योग के लिए बनाए गए हैं, और उनमें से कोई भी स्पष्ट रूप से एक एनोटेशन को उस ज्यामिति से जोड़ता नहीं है जिसका वर्णन यह कर रहा है। वे पाठ पहचान और ज्यामिति पहचान को अलग-अलग काम मानते हैं और उम्मीद करते हैं कि कनेक्शन डाउनस्ट्रीम में अपने आप ठीक हो जाएगा। आमतौर पर ऐसा नहीं होता।
ड्रॉइंग-रिकोड (Drawing-Recode) एक नंबर को उस रेखा से कैसे जोड़ता है जिसका माप वह दर्शाता है
इस आर्किटेक्चर में कुछ अलग-अलग भाग हैं, और दिलचस्प भाग बीच में है।
सबसे पहले, एक इमेज एन्कोडर रैस्टर ड्रॉइंग को देखता है और ज्यामितीय विशेषताओं (geometric features) को निकालता है: मूल रूप से, पृष्ठ पर मौजूद रेखाओं, वक्रों और आकारों का एक समृद्ध आंतरिक प्रतिनिधित्व, जो किसी भी पाठ से स्वतंत्र होता है। अलग से, एक पाठ पहचान मॉड्यूल एनोटेशन (annotations) को पढ़ता है: ड्रॉइंग में बिखरे हुए आयाम संख्याएँ, सहनशीलताएँ (tolerances) और लेबल। अभी तक यह मानक डॉक्यूमेंट AI है, दो विशेषज्ञ रीडर्स समानांतर रूप से काम कर रहे हैं।
वास्तविक योगदान वह है जो इसके बाद होता है। ड्रॉइंग-रिकोड क्रॉस-एटेंशन (cross-attention) का उपयोग करता है, एक तंत्र जो एक सेट की विशेषताओं को दूसरे सेट को "देखने" और यह तय करने की अनुमति देता है कि क्या प्रासंगिक है, ताकि प्रत्येक पहचाने गए एनोटेशन को उस विशिष्ट ज्यामितीय विशेषता से जोड़ा जा सके जिसका वर्णन वह कर रहा है। इसे इस तरह सोचें जैसे मॉडल अपने स्वयं के एक्सटेंशन लाइन्स खींचना सीख रहा हो: पाठ "50.5" दिया गया है, यह सीखता है कि ज्यामितीय प्रतिनिधित्व में उस किनारे (edge) की तलाश करे जिसका माप उस संख्या द्वारा सबसे अधिक संभावित है, ठीक उसी तरह जैसे मानव आंख एक आयाम लाइन को संख्या से वापस पार्ट आउटलाइन की ओर फॉलो करती है।
इस कनेक्शन को अनुमानित होने के बजाय विश्वसनीय बनाने के लिए, लेखकों ने कुछ जोड़ा है जिसे वे एनोटेशन ग्रौंडिंग लॉस (Annotation Grounding Loss - AGL) कहते हैं। मशीन लर्निंग में "लॉस" वह जुर्माना है जो मॉडल को ट्रेनिंग के दौरान तब मिलता है जब उसका आउटपुट गलत होता है, वह सिग्नल जिसका उपयोग वह सुधार के लिए करता है। एक सामान्य ट्रेनिंग सेटअप मॉडल को केवल अंतिम CAD कोड गलत होने पर जुर्माना दे सकता है। AGL अंतिम आउटपुट तक पहुंचने से पहले ही एनोटेशन-टू-जियोमेट्री लिंक गलत होने के लिए एक अतिरिक्त, स्पष्ट जुर्माना जोड़ता है। यह एक जानबूझकर की गई डिज़ाइन चयन है: अच्छी कोड जनरेशन के एक पार्श्व प्रभाव के रूप में सही ग्रौंडिंग के उभरने की उम्मीद करने के बजाय, वे मॉडल को अपने स्वयं के नियमों में सही ग्रौंडिंग प्राप्त करने के लिए ट्रेन करते हैं।
एक बार जब ज्यामिति, पहचाना गया पाठ, और उनके बीच के ग्रौंडेड लिंक्स को एक फीचर सेट में संयोजित कर लिया जाता है, तो उसे एक लार्ज लैंग्वेज मॉडल (LLM) में फीड किया जाता है, जो ChatGPT जैसे टूल्स के पीछे वाले मॉडल के उसी परिवार से है, जिसे यहाँ प्रोज के बजाय कोड जनरेट करने के लिए अनुकूलित किया गया है। आउटपुट कोई तस्वीर या निर्देशांकों का सेट नहीं है। यह लेखकों द्वारा संरचित पैरामीट्रिक CAD कोड (Structured Parametric CAD Code - SPCC) फॉर्मेट में CAD कोड है: "इस प्रोफाइल को स्केच करें, इसे 12mm एक्सट्रूड करें, यहाँ 6mm का छेद काटें" जैसे ऑपरेशन्स का एक अनुक्रम, जिसे एक CAD प्रोग्राम वास्तविक 3D मॉडल को फिर से बनाने के लिए निष्पादित कर सकता है, जो पूरी तरह से एडिटेबल है, न कि केवल एक स्थिर आकार।
उन्होंने क्या पाया, और वास्तविक दुनिया के उपयोग के लिए जो हिस्सा वास्तव में मायने रखता है
गवेषणा पत्र (paper) में रिपोर्ट किया गया है कि Drawing-Recode, रैस्टर ड्राइंग्स से सही पैरामीट्रिक CAD अनुक्रमों को पुनर्प्राप्त करने में मौजूद बेसलाइन विधियों से बेहतर प्रदर्शन करता है। यह अपेक्षित है। किसी भी नए पत्र में कोई नया तरीका पिछले तरीकों को मात देना चाहिए, वरना उसका कोई अस्तित्व नहीं है।
अधिक सारगर्भित परिणाम दूसरा दावा है: यह सिस्टम उन स्कैन की गई ड्राइंग्स पर भी स्थिर (robust) रहता है जो वास्तविक औद्योगिक परिस्थितियों के समान होती हैं। इस पर विचार करने योग्य है, क्योंकि यह एक डेमो और एक उपकरण के बीच का अंतर है। साफ, उच्च रिज़ॉल्यूशन वाले CAD रेंडरिंग्स आसान मामला है। वास्तविक दुनिया की ड्राइंग्स, जो उस फाइलिंग कैबिनेट में पड़ी होती हैं, फोटोकॉपी की फोटोकॉपी होती हैं, फीकी पड़ी हुई, थोड़ी घुमी हुई, जिन पर कॉफी के दाग और पेंसिल के निशान होते हैं जिनके चारों ओर AI को रास्ता बनाना पड़ता है। एक ऐसा सिस्टम जो केवल निर्दोष इनपुट पर अच्छा प्रदर्शन करता है, वह किसी ऐसे समस्या को हल कर रहा है जिसका कोई वास्तव में सामना नहीं करता है। लेखकों ने विशेष रूप से खराब स्कैन्स के लिए डिज़ाइन किया और उनका परीक्षण किया, जो यह सुझाव देता है कि उन्होंने समझा था कि प्रयोगशाला-स्तर की साफ-सफाई वाला मामला कभी भी मुख्य उद्देश्य नहीं था।
हालाँकि, सारांश (abstract) कठिन संख्याएँ, सटीकता प्रतिशत, सटीक बेसलाइन तुलनाएँ, डेटासेट के आकार आदि नहीं देता, इसलिए "बेहतर प्रदर्शन" और "स्थिर रहना" को प्रयोगों द्वारा समर्थित दिशात्मक दावों के रूप में लें, न कि किसी स्कोरबोर्ड के रूप में जिसे आप सीधे उद्धृत कर सकें। यदि आप यह तय कर रहे हैं कि इस पर निर्माण करना है या नहीं, तो तंत्र (क्रॉस-एटेंशन के माध्यम से स्पष्ट ग्रौंडिंग और एक समर्पित लॉस) वह स्थानांतरणीय विचार है, इस प्रारंभिक पत्र में किसी विशिष्ट बेंचमार्क संख्या से अधिक।
OCR बनाने या चुनने वाले किसी के लिए यह क्यों मायने रखता है
CAD से थोड़ा पीछे हटकर देखें तो दस्तावेज़ AI (Document AI) के लिए एक सबक है, जो OpenOCR के क्षेत्र में बिल्कुल फिट बैठता है।
वास्तविक दुनिया के दस्तावेज़ प्रसंस्करण का बहुत बड़ा हिस्सा केवल "पाठ पढ़ना" नहीं है। यह "यह पता लगाना है कि कौन सा पाठ किस चीज़ से संबंधित है।" एक इनवॉइस की लाइन आइटम को सही SKU और सही कुल राशि से लिंक होना चाहिए। एक मेडिकल फॉर्म का चेकबॉक्स उस लेबल से लिंक होना चाहिए जो उसके बगल में है, न कि तीन पंक्तियाँ ऊपर वाले लेबल से। एक वित्तीय विवरण के फुटनोट मार्कर को उस संख्या से लिंक होना चाहिए जिसे वह एनोटेट कर रहा है। इन सभी मामलों में, साधारण OCR आपको केवल अक्षर देता है और संबंधों को समझने में पूरी तरह विफल रहता है। वह संबंध ही आमतौर पर असली मूल्य का स्रोत होता है।
Drawing-Recode उस संबंध समस्या को जानबूझकर हल करने का एक साफ-सुथरा केस स्टडी है, बजाय इसके कि उम्मीद की जाए कि कोई बड़ा मॉडल इसे गलती से सीख लेगा। स्पष्ट डिज़ाइन विकल्प, ग्राउंडिंग के लिए एक समर्पित लॉस फंक्शन और क्रॉस-एटेंशन जो आर्किटेक्चरल रूप से दो मोडालिटी को जोड़ने के लिए मजबूर है, वह हिस्सा है जिसे याद रखना चाहिए, भले ही आप कभी CAD ड्रॉइंग को छुएँ भी न। जब आप किसी ऐसे OCR या दस्तावेज़-AI इंजन का मूल्यांकन कर रहे हों जिसमें एनोटेशन, लेबल या क्रॉस-रेफरेंस शामिल हों (केवल चलते पाठ नहीं), तो वेंडर से पूछें कि क्या उनका सिस्टम उन लिंक्स को स्पष्ट रूप से मॉडल करता है या केवल पाठ और ज्यामिति को अलग-अलग निकालकर आपको उन्हें जोड़ने के लिए छोड़ देता है। इन दो दृष्टिकोणों के बीच की खाई में ही आमतौर पर सटीकता की समस्याएँ निवास करती हैं।
विशेष रूप से OpenOCR उपयोगकर्ताओं के लिए, यह एक ऐसे श्रेणी की ओर भी इशारा करता है जिस पर नज़र रखनी चाहिए: एक संकीर्ण लेकिन गहरे कार्य के लिए बनाए गए इंजन, जैसे पार्ट डिजिटाइज़ेशन, उस कार्य पर सामान्य उद्देश्य वाले OCR को हरा देते हैं, भले ही सामान्य इंजन के पीछे बड़ी ट्रेनिंग बजट हो। यदि आप इंजीनियरिंग आर्काइव को डिजिटाइज़ कर रहे हैं, तो सही कदम शायद एक सामान्य OCR इंजन चलाना और अनुमान लगाने के लिए कस्टम ग्लू कोड लिखना नहीं है कि कौन सी संख्या किस लाइन से संबंधित है। बल्कि Drawing-Recode के दृष्टिकोण के करीब कुछ खोजना या बनाना है, जहाँ लिंकिंग मॉडल का हिस्सा है, न कि पोस्ट-प्रोसेसिंग में बाद में जोड़ा गया एक विचार। मजबूत अंग्रेज़ी OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा होगा; देवनागरी की जटिल संयुक्त वर्णों और शिरोरेखा संरचनाओं को सही ढंग से पढ़ना अक्सर अलग चुनौती होती है, इसलिए ऐसे मिश्रित भाषा दस्तावेज़ों के लिए विशेष रूप से प्रशिक्षित मॉडल ही वास्तविक सटीकता दे सकते हैं।
जहाँ यह अभी भी अपूर्ण है
कुछ कमीयाँ स्पष्ट हैं, जिनमें से कुछ पेपर के फ्रेमवर्क द्वारा स्वीकार की गई हैं, जबकि अन्य केवल वर्णित दृष्टिकोण के अंतर्निहित हैं।
इसका दायरा 2D ड्रॉइंग्स से व्यक्तिगत भागों के लिए 3D पैरामीट्रिक अनुक्रम उत्पन्न करना है, न कि पूर्ण असेंबली। एक वास्तविक निर्माण आर्काइव में केवल सिंगल-पार्ट ड्रॉइंग्स नहीं होतीं; इसमें असेंबली ड्रॉइंग्स होती हैं जिनमें कई भाग, सब-रेफरेंस और क्रॉस-शीट कॉलआउट्स ("शीट 3 पर विवरण देखें") होते हैं। सारांश में कुछ भी यह संकेत नहीं देता कि Drawing-Recode अभी उस व्यापक मामले को संभालता है।
LLM-आधारित कोड जनरेशन के साथ मानक जोखिम भी है: प्रवाहमय, संरचनात्मक रूप से वैध आउटपुट, आयामिक रूप से सही आउटपुट के बराबर नहीं है। एक जनरेटेड SPCC अनुक्रम सही दिख सकता है, सही दिशा में सही आकार को एक्सट्रूड कर सकता है, और फिर भी गलत पढ़े गए नंबर या थोड़ा गलत ग्रาวंडिंग निर्णय से बना हो सकता है। एक ब्लॉग पोस्ट के लिए यह एक जिज्ञासा है। मशीन में बोल्ट किए जाने वाले निर्मित भाग के लिए, यह काम करने वाले प्रतिस्थापन और एक बहुत महंगी गलती के बीच का अंतर है। सारांश में डाउनस्ट्रीम वेरिफिकेशन स्टेप का वर्णन नहीं है जो भौतिक सहिष्णुता (physical tolerances) के खिलाफ जनरेटेड कोड की जांच करता है, जो असंरक्षित रूप से उत्पादन भागों पर इसका इस्तेमाल करने से पहले इस प्रकार की सुरक्षा की आवश्यकता है।
और अधिकांश विशेषज्ञता वाले रिकग्निशन मॉडल्स की तरह, ट्रेनिंग डेटा की गुणवत्ता ही सीमा है। CAD-विशिष्ट एनोटेशन कन्वेंशन को पढ़ने के लिए इस प्रकार से ट्यून किया गया मॉडल संभवतः CAD-विशिष्ट डेटा पर ट्रेन किया गया है, जिसका अर्थ है कि ट्रेनिंग डिस्ट्रीब्यूशन के बाहर ड्रॉइंग स्टाइल्स, सिंबल कन्वेंशन या उद्योगों पर इसकी प्रदर्शन एक खुला सवाल है जिसका उत्तर पेपर दावा नहीं करता है।
इनमें से कोई भी कोर आइडिया को कमजोर नहीं करता है। टेक्स्ट रिकग्निशन और शेप रिकग्निशन को दो अलग-अलग कामों के बजाय जो केवल एक-दूसरे के पास चलते हैं, एनोटेशन को ज्यामिति से स्पष्ट रूप से जोड़ना सही अंतर्ज्ञान है, और यह वह बात है जिसे पूरे डॉक्यूमेंट-AI क्षेत्र को अधिक बार अपनाना चाहिए।