لا يستطيع روبوت الدردشة الخاص بك العثور على الرسم البياني الذي يحتوي على الإجابة. تحاول هذه الورقة إصلاح ذلك.
استنادًا إلى: ConceptFormer: Learning Adaptive Latent Concepts for Query-Document Alignment in Visual Document Retrieval — Peng Chunyi, Xu Zhipeng, Yan Yukun, Liu Zhenghao, Yu Shi, Mei Sen, Sun Yubo, Zhang Yongheng, Zhou Jie, Gu Yu, Yu Ge, Sun Maosong
تخيل روبوت دردشة للعلاقات مع المستثمرين قد استوعب عرضاً ربعياً مكوناً من 40 صفحة. يسأل شخص ما: "ما كان معدل التراجع لدينا في الربع الماضي؟" الرقم حقيقي، وهو موجود في الصفحة 23. لكنه غير مكتوب في أي مكان كجملة. إنه يمثل ارتفاع أحد الأعمدة في رسم بياني، بجانب ثلاثة أعمدة أخرى، مع وجود تسمية مئوية صغيرة مُرسَّمة داخل الرسم نفسه.
سيتم تجاوز هذه الصفحة بسهولة من قبل نظام استرجاع يعتمد على قراءة النص المستخرج. لا توجد جملة يمكن مطابقتها مع السؤال. هذه هي المشكلة بالضبط التي تحاول ورقة بحثية جديدة بعنوان ConceptFormer، من فريق يضم باحثين من جامعة نورث إيسترن وجامعة تسينغ هوا، حلها، وطريقتهم في حلها أكثر إثارة للاهتمام من القصة المعتادة حول "نموذج أكبر، بيانات أكثر".
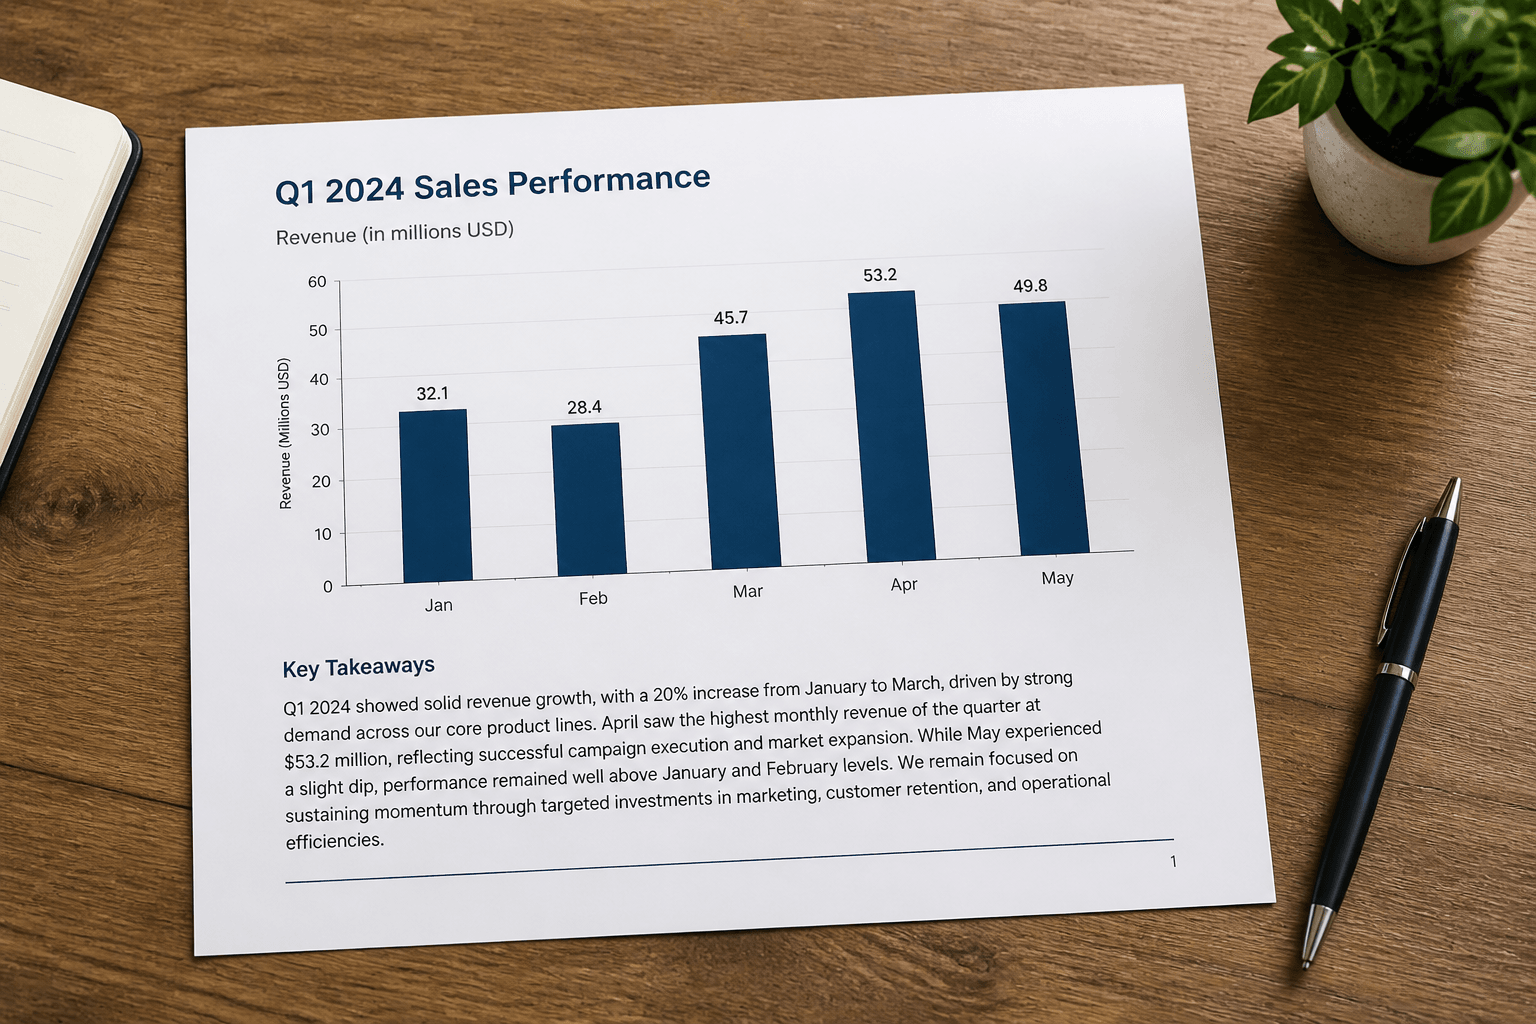
الصفحة التي تحتوي على إجابتك لا تحتوي دائماً على الكلمات الخاصة بها
قبل أن تتمكن من جعل نظام الذكاء الاصطناعي يجيب على سؤال يتعلق بمستند، تحتاج إلى العثور على الصفحة الصحيحة. تُعرف هذه الخطوة بالاسترجاع (Retrieval)، وهي العمود الفقري لتوليد المعلومات المعززة بالاسترجاع (RAG): ابحث أولاً عن الأدلة ذات الصلة، ثم قم بتمريرها إلى نموذج لغوي للإجابة الفعلية على السؤال. إذا أخطأت في الاسترجاع، فلن يهم مدى جودة نموذج قراءة الصفحة. فهو لن يرى الصفحة أبداً.
على مدار سنوات، كانت الطريقة القياسية للبحث في المستندات هي تشغيل التعرف الضوئي على الحروف (OCR) لاستخراج النص، ثم البحث في هذا النص بنفس الطريقة التي تبحث بها في أي مجموعة نصية أخرى. تعمل هذه الطريقة بشكل جيد للعقد النصية البسيطة. لكنها تنهار في حالة عروض الشرائح، أو التقارير السنوية، أو النماذج الممسوحة ضوئياً، لأن تقنية OCR تتجاهل كل ما ليس نصاً: شكل الرسم البياني، حقيقة أن رقماً معيناً يقع في الخلية العلوية اليمنى من الجدول، والتأكيد البصري للمجموع المكتوب بخط عريض. يعيش الكثير من المعنى الفعلي في المستند التجاري في هذه البنية، وليس في الكلمات.
تتخطى الطريقة الأحدث، التي يسميها الورق البحثي بالاسترجاع البصري، تقنية OCR تماماً، وتستخدم نموذج لغة-رؤية (نموذج يمكنه معالجة الصور والنص معاً، مثل GPT-4V أو Qwen-VL) للنظر إلى الصفحة كصورة وتحويل كل شيء إلى متجه، وهو قائمة طويلة من الأرقام التي تلتقط معناها. يتم تحويل الاستعلام إلى متجه أيضاً، ويصبح الاسترجاع مسألة العثور على متجهات المستندات الأقرب إلى متجه الاستعلام في ذلك الفضاء المشترك. يحافظ هذا على التخطيط والبنية البصرية، وهو تحسن حقيقي. لكنه يخلق مشكلة تدريبية: كيف تُعلم النموذج أي جزء من الصفحة المزدحمة هو الذي يهم حقاً لسؤال معين؟
اعتمدت المحاولات الأخيرة للحصول على إشارة تدريبية دقيقة على بديلين. أحدهما هو الأوصاف النصية: اجعل نموذجاً قوياً يكتب، بالكلمات، ما هو الدليل ذو الصلة. والآخر هو المناطق البصرية المحددة: ارسم مربعاً محددًا حول الجزء من الصفحة الذي يجيب على السؤال. كلاهما يعاني من عيوب حقيقية. لا يمكن للعنوان أن يلتقط تماماً ما يفعله شكل الرسم البياني أو تخطيط الجدول. يفترض المربع المحدد أن الدليل موجود في مستطيل واحد واضح، وهو ما ينهار في اللحظة التي يعتمد فيها الجواب على ربط رقم في رسم بياني بعنوان يبعد بوصتين، أو هامش سفلي في أسفل الصفحة.
المفاهيم الكامنة: دليل بدون عنوان توضيحي أو مربع محدد
تتمثل الخطوة الأساسية في نموذج ConceptFormer في التوقف عن إجبار إشارة الدليل على الانصياع لأحد التنسيقين. بدلاً من كتابة عنوان توضيحي أو رسم مستطيل، يمثل النموذج "ما هو المهم في هذه الصفحة بالنسبة لهذا الاستعلام" كمجموعة من المتجهات المستمرة يسميها المفاهيم الكامنة.
إليك طريقة للتفكير في ذلك. العنوان التوضيحي هو وصف مضغوط باللغة الإنجليزية. ومربع التحديد هو وصف مضغوط بإحداثيات البكسل. كلا التنسيقين يتسببان في فقدان المعلومات أثناء الترجمة، لأنهما يجبران شيئاً بصرياً وعلائقياً على الانصياع لمفردات ثابتة. يتخطى المفهوم الكامن خطوة الترجمة. إنه متجه يعيش مباشرة في نفس الفضاء الرياضي الذي توجد فيه تضمينات الاستعلام والوثيقة، ويُشكّل من خلال التدريب ليقترب من أي جزء من تمثيل الوثيقة يكون ذا صلة فعلياً. لا يمكن لأحد قراءة المفهوم الكامن بصوت عالٍ كما يمكنه قراءة العنوان التوضيحي، لكنه لا يحتاج أيضاً إلى فقدان المعلومات البصرية والدلالية بالطريقة التي يفقدها العنوان التوضيحي.
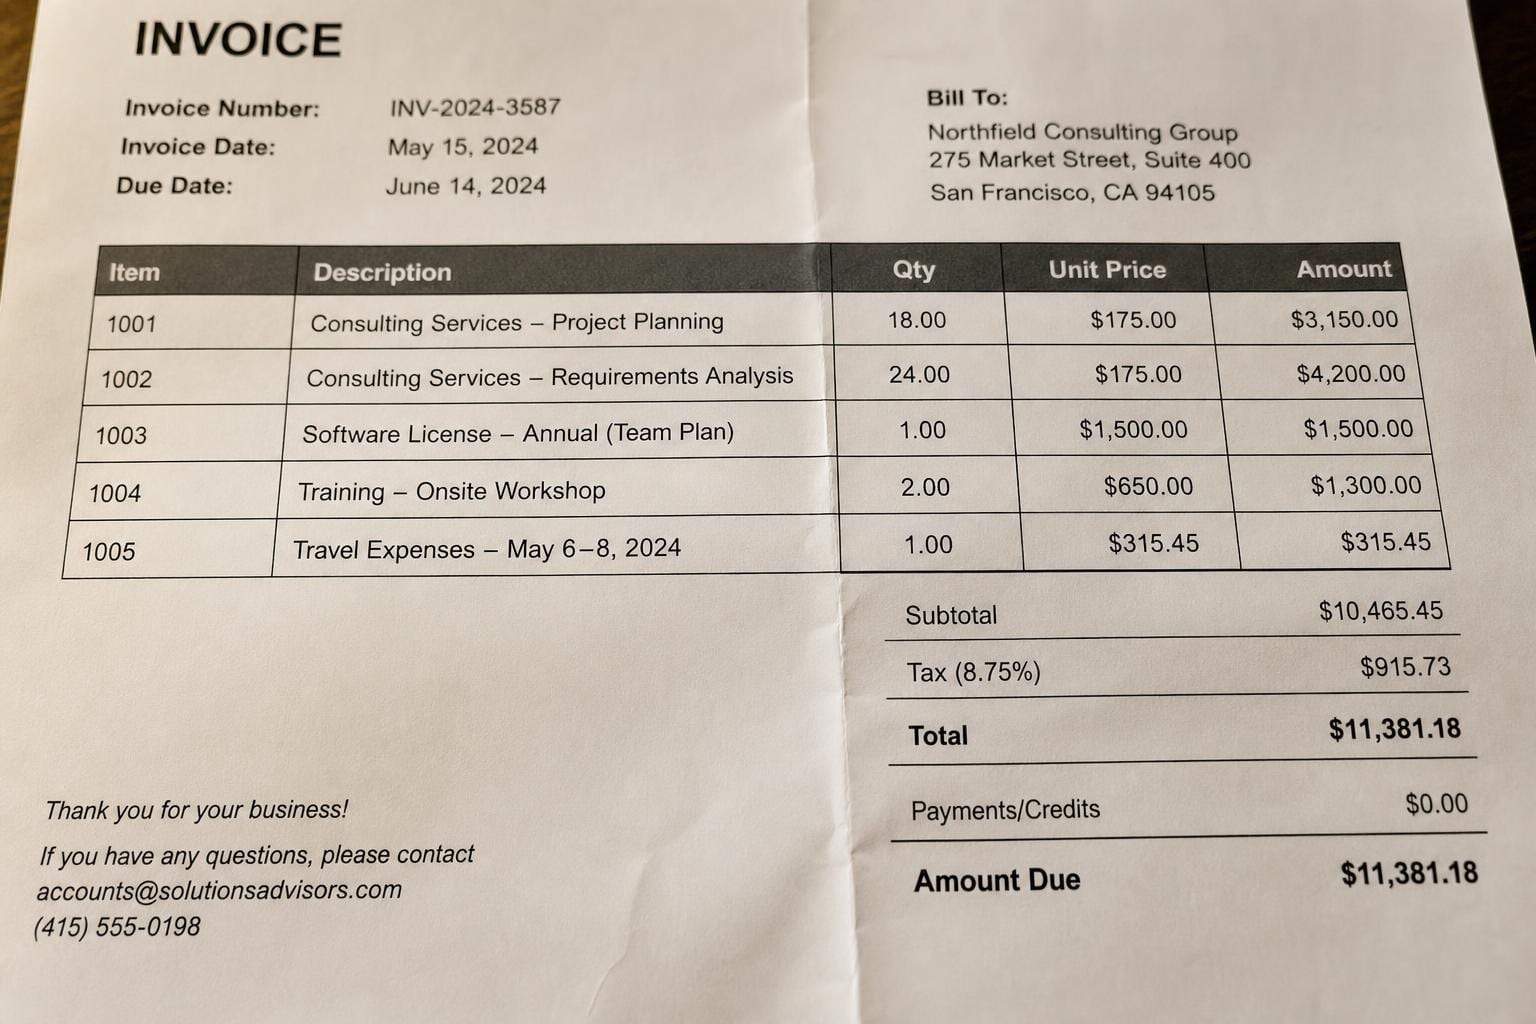
الجزء الآخر الجدير بالذكر هو الحجم الديناميكي. أثناء التدريب، يقرر نموذج قوي للرؤية واللغة، لكل زوج من الاستعلام والوثيقة، عدد رموز المفاهيم اللازمة لتمثيل الدليل ذي الصلة. قد يحتاج سؤال بحث بسيط (ما هو الإجمالي في هذه الفاتورة) إلى رمز واحد فقط. وقد يحتاج سؤال تركيب يعتمد على كل من الرسم البياني والفقرة التي تشرحه إلى عدة رموز. وهذا يمثل انحرافاً ذا معنى عن تمرير كل مثال عبر تمثيل بحجم ثابت بغض النظر عن كمية الدليل التي يتطلبها فعلياً.
تظهر هذه المفاهيم فقط أثناء التدريب. تعمل كهدف وسيط يوجه فضاء التضمين الخاص بجهاز الاسترجاع، مما يجمع بين تمثيلات الاستعلام والوثيقة بطريقة تعكس الدليل الحقيقي بدلاً من وكيل مضغوط له. في وقت الاستدلال، عندما يكتب شخص ما سؤالاً في مربع البحث، يقوم جهاز الاسترجاع ببساطة بحساب تضمينات الاستعلام والوثيقة ومقارنتها مباشرة. لا يتطلب النظام المنفذ تشغيل نموذج ثقيل للرؤية واللغة في وقت الاستعلام، وهو أمر مهم جداً لأي شخص يفكر في تكلفة الإنتاج.
الأرقام: التفوق على المعسكرين في آن واحد
تم الإبلاغ عن النتائج على شكل تحسينات نسبية في مقياس NDCG@10، وهو أسلوب قياسي لتقييم جودة القائمة المرتبة. يرمز NDCG إلى "المكسب التراكمي المخصوم المعيار" (Normalized Discounted Cumulative Gain). وببساطة: إذا تم ترتيب الصفحة ذات الصلة فعلياً في المرتبة الأولى، تحصل على كامل الاعتماد؛ وإذا كانت في المرتبة العاشرة، تحصل على اعتماد أقل بكثير؛ وإذا لم تكن ضمن أفضل 10 نتائج على الإطلاق، فلا تحصل على أي اعتماد تقريباً. وتعني كلمة "معيار" (Normalized) أن الدرجة تم قياسها مقابل أفضل ترتيب ممكن، مما يمنحك رقماً يمكن مقارنته عبر استعلامات ومجموعات بيانات مختلفة.
عبر مجموعة من معايير التقييم لاسترجاع المستندات المرئية، حقق نموذج ConceptFormer تحسناً نسبياً بنسبة 16.7% في متوسط NDCG@10 مقارنة بأقوى خط أساس مرئي للاسترجاع تم اختباره ضده، وتحسناً نسبياً بنسبة 22.1% مقارنة بأقوى خط أساس للاسترجاع النصي المعتمد على التعرف الضوئي على الحروف (OCR). هذه أرباح نسبية مقارنة بأفضل نظام منافس في كل فئة، وليس مقارنة بنظام ضعيف容易被 دحض، وهو الأسلوب الأكثر صدقاً للإبلاغ عن هذا النوع من النتائج.
ما أجد أنه أكثر إقناعاً من الأرقام الرئيسية هو التحليل اللاحق. تشير الورقة البحثية إلى أنه عند النظر إلى ما تركز عليه المفاهيم الكامنة فعلياً، فإنها تهبط على الأدلة المرئية ذات الصلة حقاً: المنطقة الصحيحة من الرسم البياني، أو الخلية الصحيحة في الجدول. هذا التحقق يستحق أخذَه بجدية، لأنه من السهل لإشارة تدريب مساعدة أن تحسن درجة المعيار لأسباب لا علاقة لها بالقصة التي تحكيها عنها. هنا، يبدو أن المفاهيم تؤدي الوظيفة التي صُممت من أجلها: ربط التفاصيل النصية الدقيقة (النوع الذي يتقنه التعرف الضوئي على الحروف) بالهيكل المرئي على مستوى المستند (النوع الذي يفوته البحث النصي الخالص)، داخل جهاز استرجاع واحد، دون أن يستهلك أحد النهجين الآخر.
لماذا يهم الأمر إذا كنت تبني أو تختار مجموعة أدوات الذكاء الاصطناعي المستندة إلى المستندات
إذا كنت تبني نظام بحث أو استرجاع مع توليد (RAG) لأي شيء ليس نصًا عاديًا، فإن هذه الورقة البحثية تمثل نقطة بيانات تستحق الانتباه، حتى لو لم تلمس الكود أبدًا. نمط "التعرف الضوئي على الحروف ثم البحث" الذي تعتمد عليه العديد من الفرق لأنه مألوف، يتخلف بشكل قابل للقياس عن الاسترجاع الأصلي للرؤية على المستندات حيث توجد الأدلة في الرسوم البيانية والجداول والتخطيط، ويبدو أن هذه الفجوة تتسع بدلاً من أن تضيق. إذا كانت مستنداتك هي التقارير المالية أو أوراق مواصفات المنتج أو النماذج الممسوحة ضوئيًا أو عروض الشرائح، وكان مستخدمو يطرحون أسئلة تكون إجاباتها داخل رسم بياني أو جدول بدلاً من جملة، فإن خط الأنابيب النصي فقط سيستمر في تفويت الصفحات التي سيجدها البشر على الفور.
لا يعني ذلك أن التعرف الضوئي على الحروف قد مات. هناك الكثير من المستندات التي هي بالفعل نص كثيف ومنظم جيدًا، ويبقى البحث القائم على التعرف الضوئي على الحروف أرخص وأسهل في تصحيح الأخطاء لهذه الحالات. ولكن إذا كنت تقيم محركات أو مسترجعات لأحمال عمل كثيفة المستندات ذات بنية بصرية حقيقية، فهذا تذكير جيد باختبارها مع نوع الصفحات التي تكسر بالفعل التعرف الضوئي على الحروف البسيط: رسم بياني يحتوي على رقم لم يكتبه أحد كجملة، جدول حيث تتطلب الإجابة معرفة العمود الذي أنت فيه، نموذج حيث يعني مربع الاختيار المجاور لسطر شيئًا لا يمكن لاستخراج النص رؤيته. قم بإجراء اختبارات الأداء على تلك الصفحات، وليس على الفقرات النظيفة، لأن هذا هو المكان الذي تظهر فيه الفجوة فعليًا بين الاسترجاع التقليدي والاسترجاع الأصلي للرؤية. ومن الجدير بالذكر أن تعقيدات النصوص العربية، مثل طبيعتها المتصلة واتجاهها من اليمين إلى اليسار وتشكيلاتها الحركية، تجعل التعرف الضوئي على الحروف فيها تحديًا إضافيًا يعزز الحاجة إلى الحلول البصرية المتقدمة.
ما لا يزال غامضاً
بصراحة، هناك بعض الأمور التي تستحق الإشارة. تعتمد عملية التدريب على نموذج قوي للرؤية واللغة لتوليد الإشراف المفاهيمي الكامن، مما يعني أن جودة إشارة تدريب ConceptFormer محدودة بجودة نموذج المعلم هذا، مما يضيف تكلفة حقيقية إلى خط أنابيب التدريب، على الرغم من أنه لا يؤثر على تكلفة الاستدلال. المفاهيم الكامنة نفسها ليست قابلة للقراءة من قبل البشر بالتصميم، وهو مقايضة مقبولة للأداء ولكن تكلفة حقيقية لتصحيح الأخطاء: إذا أخطأ المسترجع في شيء ما في الإنتاج، فلا يوجد عنوان توضيحي أو مربع محدد للفحص والسؤال عما إذا كان هذا هو المشكلة.
مقارنات العناوين الرئيسية هي أيضاً الأفضل مقابل الأفضل: أقوى تكوين لـ ConceptFormer مقابل أقوى خط أساس بصري وأقوى خط أساس لـ OCR، كل منها على المعايير التي تم اختبارها عليها. هذه طريقة مشروعة وشائعة لتقرير النتائج، ولكن من الجدير بالذكر أن النظام المنفذ نادراً ما يحصل على انتقاء أفضل مقارنة لخط الأساس الخاص به كما يمكن للورقة البحثية. ويصف الملخص المعايير فقط على أنها "معايير متنوعة لاسترجاع المستندات البصرية"، لذا فمن غير الواضح من المعلومات المتاحة مدى تعميمها على أكثر الحالات الواقعية فوضوية: جودة المسح الضوئي السيئة، والكتابة اليدوية، والمستندات متعددة اللغات بشكل كبير، أو نوع الصور القبيحة منخفضة الدقة للأوراق التي تظهر باستمرار في حركة المرور الفعلية للإنتاج بدلاً من المعايير المنتقاة.
الكود والبيانات متاحة للعامة على GitHub، وهو الخطوة الصحيحة وتجعل من الممكن لأي شخص التحقق من هذه الادعاءات بدلاً من الاعتماد على كلمة الملخص. لمجال كان يعتمد بشدة على "الثقة في المعيار"، هذا يستحق الإشادة بحد ذاته.