チャットボットは答えがあるチャートを見つけられない。この論文はその問題を解決しようとする。
元論文: ConceptFormer: Learning Adaptive Latent Concepts for Query-Document Alignment in Visual Document Retrieval — Peng Chunyi, Xu Zhipeng, Yan Yukun, Liu Zhenghao, Yu Shi, Mei Sen, Sun Yubo, Zhang Yongheng, Zhou Jie, Gu Yu, Yu Ge, Sun Maosong
投資家向けチャットボットが40ページの四半期レポートを学習したと想像してください。誰かが「前四半期の離脱率( churn rate )は?」と尋ねます。その数値は実在し、23ページに記載されています。しかし、文章として書かれているわけではありません。グラフ内の棒グラフの一つの高さであり、他の三つの棒グラフの隣にあり、小さなパーセント表記が画像内に直接描画されています。
抽出されたテキストを読み取ることで動作する検索システムは、そのページをすっと通り過ぎてしまいます。質問と一致する文章が存在しないからです。ノースイースタン大学や清華大学の研究者らを含むチームが発表した新しい論文『ConceptFormer』が解決しようとしているのが、まさにこの問題です。そして、彼らの解決策は、通常の「より大きなモデル、より多くのデータ」という物語よりも興味深いものです。
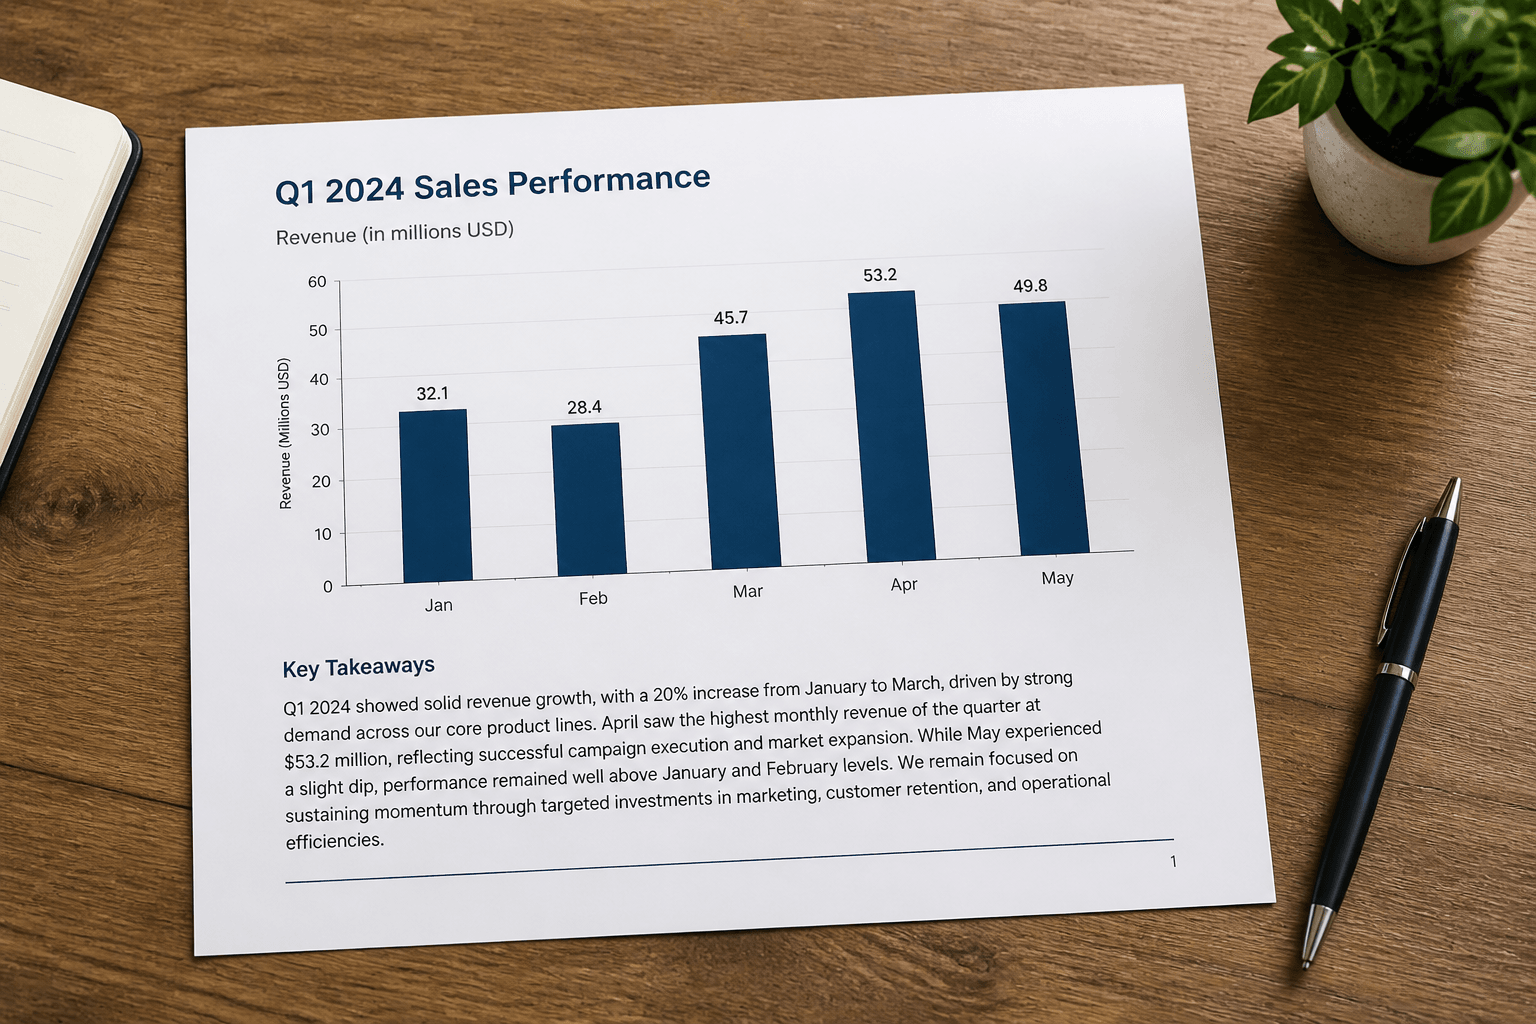
答えがあるページに、その答えの言葉が必ずしも書かれているわけではない
AIシステムにドキュメントに関する質問への答えをさせるには、まず正しいページを見つける必要があります。このステップは「検索(retrieval)」と呼ばれ、検索拡張生成(RAG)の基盤となるものです。まず関連する証拠を見つけ、その後、言語モデルにそのページを読んで実際に質問に答えるよう指示します。検索が間違っていれば、ページを読むモデルがどれほど優秀であっても意味がありません。モデルはそのページを見る機会すら得られないからです。
長年、ドキュメントを検索する標準的な方法は、OCR(光学文字認識)を実行してテキストを抽出し、他のコーパスを検索するのと同じ方法でそのテキストを検索することでした。これはプレーンテキストの契約書では問題なく機能します。しかし、スライドデッキ、年次報告書、またはスキャンされたフォームでは機能しなくなります。なぜなら、OCRはテキスト以外のすべてを破棄してしまうからです。グラフの形状、数字が表の右上のセルにあるという事実、太字の合計値による視覚的な強調などです。ビジネスドキュメントの実際の意味の多くは、言葉ではなく、その構造の中に存在します。
論文で「視覚的検索(visual retrieval)」と呼んでいる新しいアプローチは、OCRを完全にスキップし、ビジョン言語モデル(GPT-4VやQwen-VLのように、画像とテキストの両方を同時に処理できるモデル)にページを画像として見させ、全体をベクトル(その意味を捉える長い数値のリスト)に変換します。クエリもベクトルに変換され、検索は、共有空間内でどのドキュメントベクトルがクエリベクトルに最も近いかを見つけることになります。これにより、レイアウトと視覚的な構造が保持され、これは確かに大きな進歩です。しかし、これはトレーニングの問題を生み出します。つまり、混雑したページのどの部分が、与えられた質問にとって実際に重要なのかをモデルにどう教えるかという問題です。
そのような微細なトレーニングシグナルに関する最近の試みは、2つのプロキシに頼ってきました。1つはテキスト記述です。強力なモデルに、関連する証拠が何であるかを言葉で記述させます。もう1つは局所的な視覚領域です。質問に答えるページの部分を囲むバウンディングボックスを描きます。どちらも本質的な欠陥があります。キャプションは、グラフの形状や表のレイアウトが何をしているかを完全に捉えることはできません。バウンディングボックスは、証拠が1つのきれいな長方形の中に存在すると仮定しており、答えがグラフの数字と2インチ離れたキャプション、またはページの下部にある脚注を結びつけることに依存している瞬間に崩壊します。
潜在概念:キャプションやボックスなしのエビデンス
ConceptFormerの核心的なアプローチは、エビデンス信号をどちらかの形式に強制しないことです。キャプションを記述したり矩形を描画したりする代わりに、このクエリにとってこのページで「何が重要か」を、潜在概念(latent concepts)と呼ぶ連続ベクトルの集合として表現します。
これを理解するための一つの考え方があります。キャプションは英語で圧縮された記述です。バウンディングボックスはピクセル座標で圧縮された記述です。どちらも視覚的・関係的な情報を固定された語彙に押し込めるため、変換の過程で情報が失われます。潜在概念はこの変換ステップをスキップします。それはクエリやドキュメントの埋め込みと同じ数学的空間に直接存在するベクトルであり、訓練によってドキュメントの表現の中で実際に関連する部分の近くに位置するように形成されます。潜在概念をキャプションのように声に出して読むことはできませんが、キャプションのように視覚的・意味的な情報を失う必要もありません。
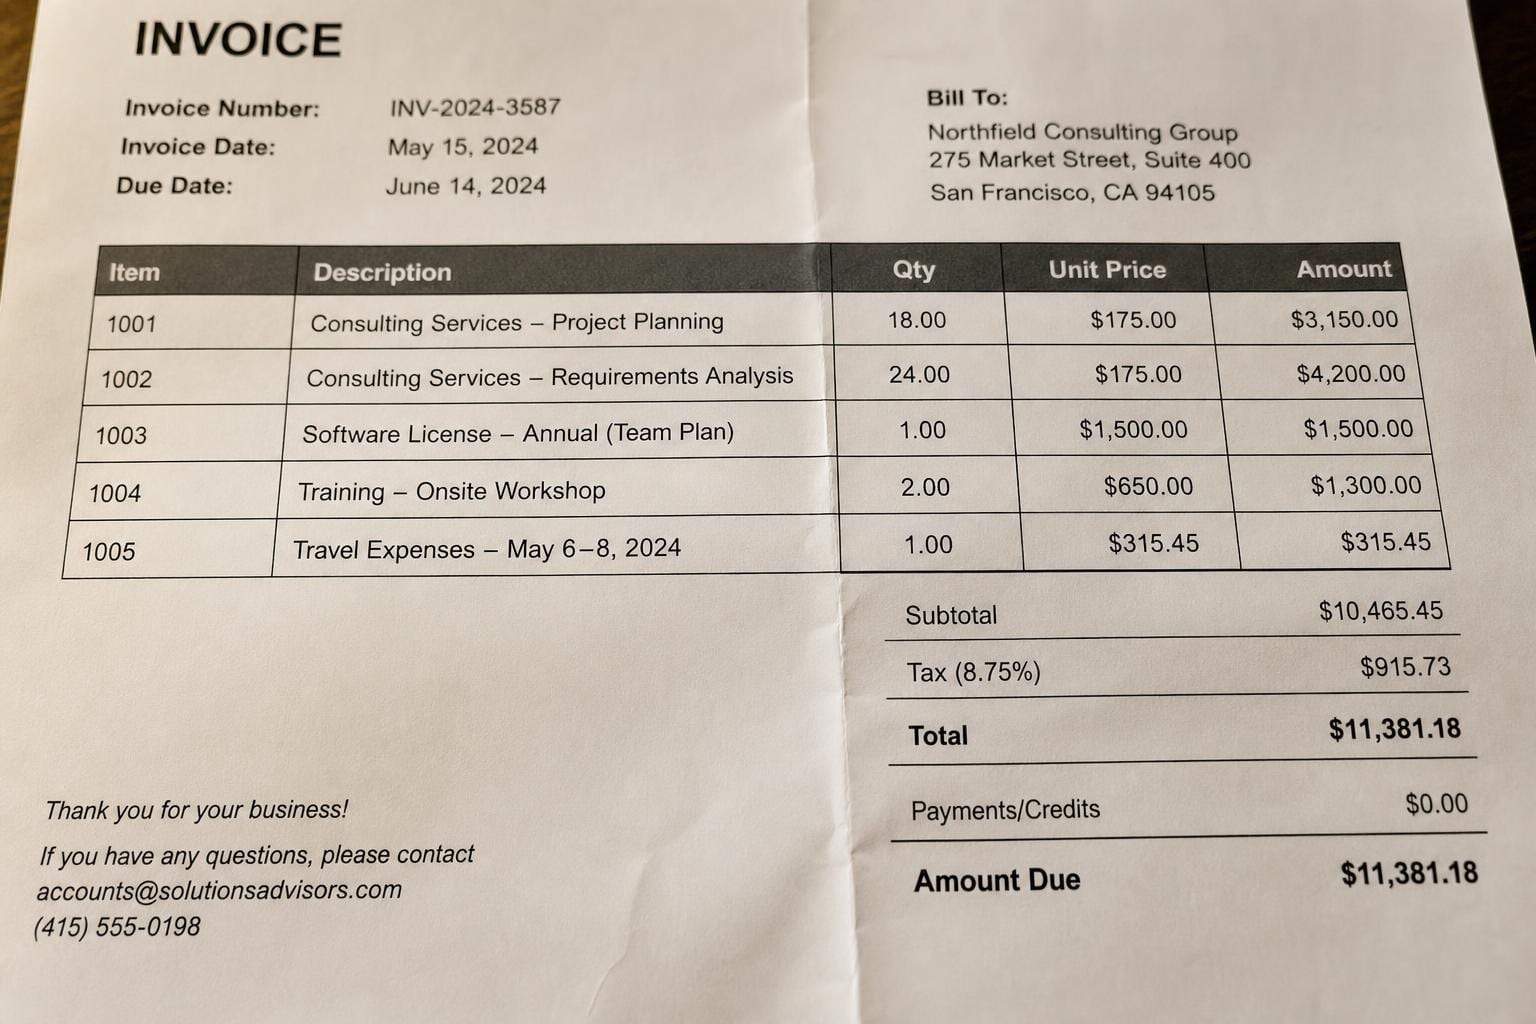
もう一つ注目すべき点は、動的なサイズ設定です。訓練中、強力なビジョン・ランゲージモデルが、各クエリ・ドキュメントペアに対して、関連するエビデンスを表現するために必要な概念トークンの数を決定します。単純な参照質問(この請求書の合計はいくつか)には1つだけで済むかもしれませんが、チャートとその説明段落の両方に依存する統合的な質問には複数のトークンが必要になるかもしれません。これは、実際に必要なエビデンスの量に関係なく、すべての例を固定サイズの表現で処理する従来の方針からの意味のある逸脱です。
これらの概念は訓練時のみ現れます。それらは、損失の大きいプロキシではなく、真のエビデンスを反映する形でクエリとドキュメントの表現を引き寄せるように、レトリバーの埋め込み空間を導く中間的なターゲットとして機能します。推論時、つまり誰かが実際に検索ボックスに質問を入力した際には、レトリバーは単にクエリとドキュメントの埋め込みを計算し、それらを直接比較します。デプロイされたシステムは、クエリ時に重たいビジョン・ランゲージモデルを実行することを必要としないため、本番環境のコストを考慮している人々にとってこれは非常に重要な点です。
数字:両陣営を同時に凌駕する
結果は、ランク付きリストの質を評価する標準的な指標であるNDCG@10の相対改善率として報告されています。NDCGとは、正規化された割引累積利得(Normalized Discounted Cumulative Gain)の略です。平易に説明すると、実際に関連性の高いページが1位にランク付けされれば満点の信用を得られ、10位なら大幅に減点され、トップ10に入っていなければ実質的に得点がない、という仕組みです。「正規化」とは、スコアを理論上最高のランキングに対してスケーリングすることを意味し、これにより異なるクエリやデータセット間で比較可能な数値が得られます。
視覚的文書検索ベンチマークのセット全体で、ConceptFormerは、テスト対象となった最強の視覚検索ベースラインに対して平均NDCG@10で16.7%の相対改善を記録し、最強のOCRベースのテキスト検索ベースラインに対しては22.1%の相対改善を記録しました。これらは、弱い藁人形ではなく、各カテゴリで最も強力な競合システムに対する相対的な向上値であり、この種の結果を報告する上でより誠実な方法です。
見出しの数字よりも私がより説得力を感じるのは、その後の分析です。論文では、潜在概念が実際に何に注意を向けているかを調べると、それらは真に関連する視覚的証拠、つまりグラフの正しい領域や表の正しいセルに収束することが報告されています。これは真剣に受け止めるべき検証です。なぜなら、補助的な学習信号は、あなたが語るストーリーとは無関係な理由でベンチマークスコアを向上させることが容易だからです。ここでは、概念は設計された役割を果たしているように見えます。すなわち、1つの検索エンジン内で、細粒度のテキスト詳細(OCRが得意とするもの)と文書レベルの視覚構造(純粋なテキスト検索が見逃すもの)を結びつけ、一方の手法が他方を蚕食することなく統合しています。
ドキュメントAIスタックの構築・選択において、なぜこれが重要なのか
プレーンテキスト以外の対象で検索やRAG(検索拡張生成)を構築している場合、この論文はコードに触れなくても注目すべきデータポイントです。多くのチームが慣れ親しんでいるためデフォルトで採用しがちな「OCRしてから検索」のパターンは、証拠がグラフ、表、レイアウトの中に存在するドキュメントにおいて、ビジョンネイティブな検索よりも明らかに遅れており、そのギャップは縮まるどころか広がっているように見えます。財務報告書、製品仕様書、スキャンされたフォーム、スライドデッキなどのドキュメントを扱っており、ユーザーの質問に対する答えが文章ではなくグラフや表の中にある場合、テキストオンリーのパイプラインは人間が瞬時に発見できるページを見逃し続けることになります。
これはOCRが死んだことを意味するわけではありません。多くのドキュメントは実際に高密度で構造化されたテキストであり、そのようなケースではOCRベースの検索は依然としてコストが低く、デバッグも容易です。しかし、実際の視覚的構造を持つドキュメント集荷のワークロード向けにエンジンやリトリーバーを評価している場合、これはナイーブなOCRが壊れるようなページでテストを行うよう促す良いリマインダーとなります。文章として書かれていない数字を含むグラフ、答えを出すにはどの列にいるかを知る必要がある表、テキスト抽出器が見逃すチェックボックスの意味を持つフォームなどがそれです。クリーンな段落ではなく、そのようなページでベンチマークを行ってください。なぜなら、旧来の検索とビジョンネイティブな検索の間のギャップが実際に現れるのはそこだからです。特に日本語の漢字や縦書きレイアウトを無視するモデルの場合、これらの視覚的構造の欠落は、日本語読者にとって重要な文脈や数値の認識失敗に直結します。
まだ不明瞭な点
正直にいくつか指摘すべき点があります。学習プロセスは、潜在概念の教師信号を生成するために強力なビジョン・ランゲージモデルに依存しており、これはConceptFormerの学習信号の質がその教師モデルの性能によって制限されることを意味します。推論コストには影響しませんが、学習パイプラインには実質的なコストがかかります。また、潜在概念自体は設計上、人間が読める形式ではありません。これはパフォーマンスとのトレードオフとしては妥当ですが、デバッグには実際のコストがかかります。例えば、リトリーバーが本番環境で何かを誤って取得した場合、問題の原因を特定するために確認できるキャプションやバウンディングボックスが存在しないため、「これが問題だったのか?」と問いかけることができません。
主要な比較結果も、最良の設定同士の比較となっています。ConceptFormerの最も強力な構成を、それぞれがテストされたベンチマークにおいて、最も強力な視覚ベースラインおよび最も強力なOCRベースラインと比較しています。これは結果を報告する上で正当かつ一般的な手法ですが、単一のデプロイされたシステムが、論文のように最良のベースライン比較を自由に選べるわけではないことを覚えておく価値があります。また、抄録ではベンチマークは「多様な視覚ドキュメント検索ベンチマーク」とのみ記述されており、公開されている情報からは、これが実際の生産環境で頻繁に見られるような、スキャン品質の低下、手書き文字、高度に多言語化されたドキュメント、あるいはキュレーションされたベンチマークではなく実際のトラフィックで絶えず現れるような粗く低解像度の紙の写メといった、最も複雑な現実世界のケースに対してどの程度一般化できるかが明確ではありません。
コードとデータはGitHubで公開されており、これは適切な対応であり、誰もがこれらの主張を検証することを可能にしています。これは「ベンチマークを信じてください」という傾向が強かった分野において、それだけで称賛に値する点です。