O seu chatbot não consegue encontrar o gráfico que tem a resposta. Este artigo tenta resolver isso.
Baseado em: ConceptFormer: Learning Adaptive Latent Concepts for Query-Document Alignment in Visual Document Retrieval — Peng Chunyi, Xu Zhipeng, Yan Yukun, Liu Zhenghao, Yu Shi, Mei Sen, Sun Yubo, Zhang Yongheng, Zhou Jie, Gu Yu, Yu Ge, Sun Maosong
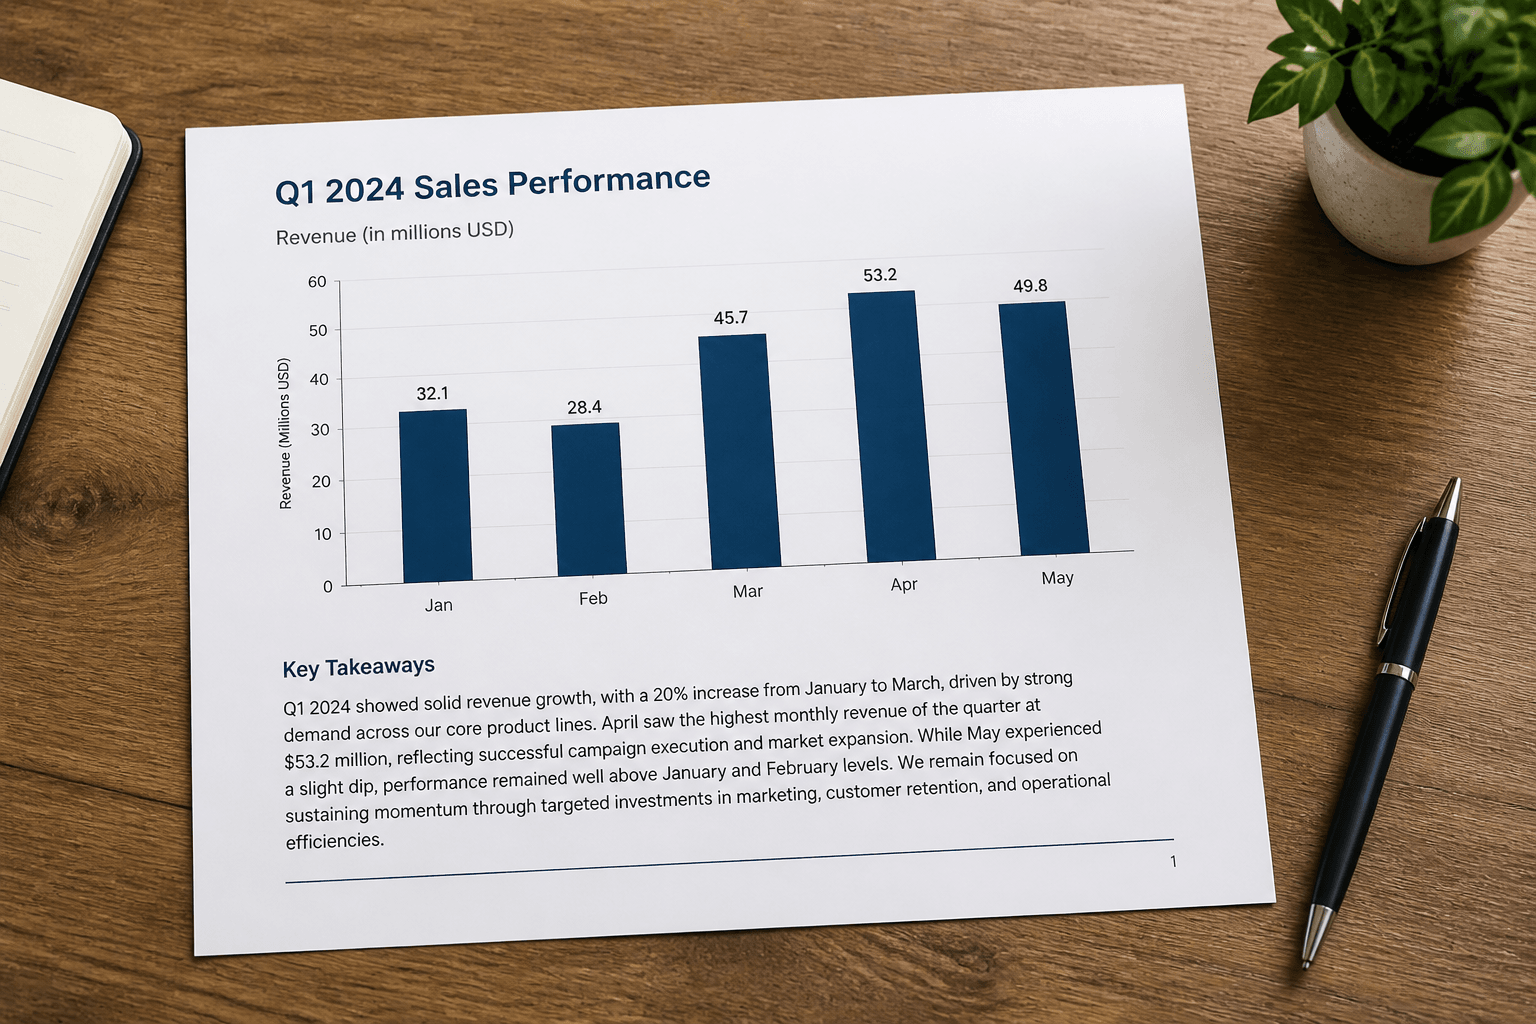
Imagine um chatbot de relações com investidores que processou uma apresentação trimestral de 40 páginas. Alguém pergunta: "Qual foi nossa taxa de churn no último trimestre?" O número é real e está na página 23. Mas não está escrito em lugar nenhum como uma frase. É a altura de uma barra em um gráfico, ao lado de outras três barras, com uma pequena etiqueta de porcentagem renderizada dentro do próprio gráfico.
Um sistema de recuperação que funciona lendo texto extraído passará direto por essa página. Não há frase para combinar com a pergunta. Esse é exatamente o problema que um novo artigo chamado ConceptFormer, de uma equipe que inclui pesquisadores da Northeastern University e da Tsinghua University, está tentando resolver, e a maneira como eles o resolvem é mais interessante do que a história habitual de "modelo maior, mais dados".
A página com sua resposta nem sempre tem as palavras para ela
Antes de conseguir que um sistema de IA responda a uma pergunta sobre um documento, você precisa encontrar a página correta. Essa etapa é chamada de recuperação (retrieval), e é a espinha dorsal da geração aumentada por recuperação (RAG): encontre primeiro as evidências relevantes e, em seguida, entregue-as a um modelo de linguagem para responder efetivamente à pergunta. Se a recuperação estiver errada, não importa o quão bom seja o modelo que lê a página. Ele nunca verá a página.
Por anos, a maneira padrão de pesquisar documentos era executar OCR (reconhecimento óptico de caracteres) para extrair o texto e, em seguida, pesquisar esse texto da mesma forma que se pesquisaria qualquer outro corpus. Isso funciona bem para um contrato em texto puro. Mas falha para uma apresentação de slides, um relatório anual ou um formulário digitalizado, porque o OCR descarta tudo que não é texto: a forma de um gráfico, o fato de um número estar na célula superior direita de uma tabela, a ênfase visual de um total em negrito. Grande parte do significado real em um documento corporativo reside nessa estrutura, não nas palavras.
A abordagem mais recente, que o artigo chama de recuperação visual, ignora completamente o OCR e faz com que um modelo de visão-linguagem (um modelo que pode processar imagens e texto juntos, como GPT-4V ou Qwen-VL) observe a página como uma imagem e transforme tudo em um vetor, uma longa lista de números que captura seu significado. A consulta também é transformada em um vetor, e a recuperação passa a ser uma questão de encontrar quais vetores de documentos estão mais próximos do vetor da consulta nesse espaço compartilhado. Isso preserva o layout e a estrutura visual, o que é uma melhoria real. Mas cria um problema de treinamento: como ensinar ao modelo qual parte de uma página movimentada realmente importa para uma determinada pergunta?
Tentativas recentes de obter esse sinal de treinamento de granularidade fina têm se apoiado em dois proxies. Um é descrições textuais: fazer com que um modelo forte descreva, em palavras, qual é a evidência relevante. O outro são regiões visuais localizadas: desenhar uma caixa delimitadora (bounding box) ao redor da parte da página que responde à pergunta. Ambos têm falhas reais. Uma legenda não consegue capturar totalmente o que a forma de um gráfico ou o layout de uma tabela estão fazendo. Uma caixa delimitadora assume que a evidência reside em um único retângulo limpo, o que falha no momento em que a resposta depende de conectar um número em um gráfico a uma legenda dois polegadas de distância, ou a uma nota de rodapé na parte inferior da página.
Conceitos latentes: evidências sem legenda ou caixa delimitadora
A jogada central do ConceptFormer é parar de forçar o sinal de evidência em qualquer um dos formatos. Em vez de escrever uma legenda ou desenhar um retângulo, ele representa "o que importa nesta página para esta consulta" como um conjunto de vetores contínuos que ele chama de conceitos latentes.
Aqui está uma maneira de pensar sobre isso. Uma legenda é uma descrição comprimida em inglês. Uma caixa delimitadora é uma descrição comprimida em coordenadas de pixels. Ambos os formatos descartam informações na tradução, porque estão forçando algo visual e relacional em um vocabulário fixo. Um conceito latente pula a etapa de tradução. É um vetor que vive diretamente no mesmo espaço matemático que as incorporações de consulta e documento, moldado pelo treinamento para ficar perto de qualquer parte da representação do documento que seja realmente relevante. Ninguém pode ler um conceito latente em voz alta como pode ler uma legenda, mas ele também não precisa perder as informações visuais e semânticas da maneira que uma legenda faz.
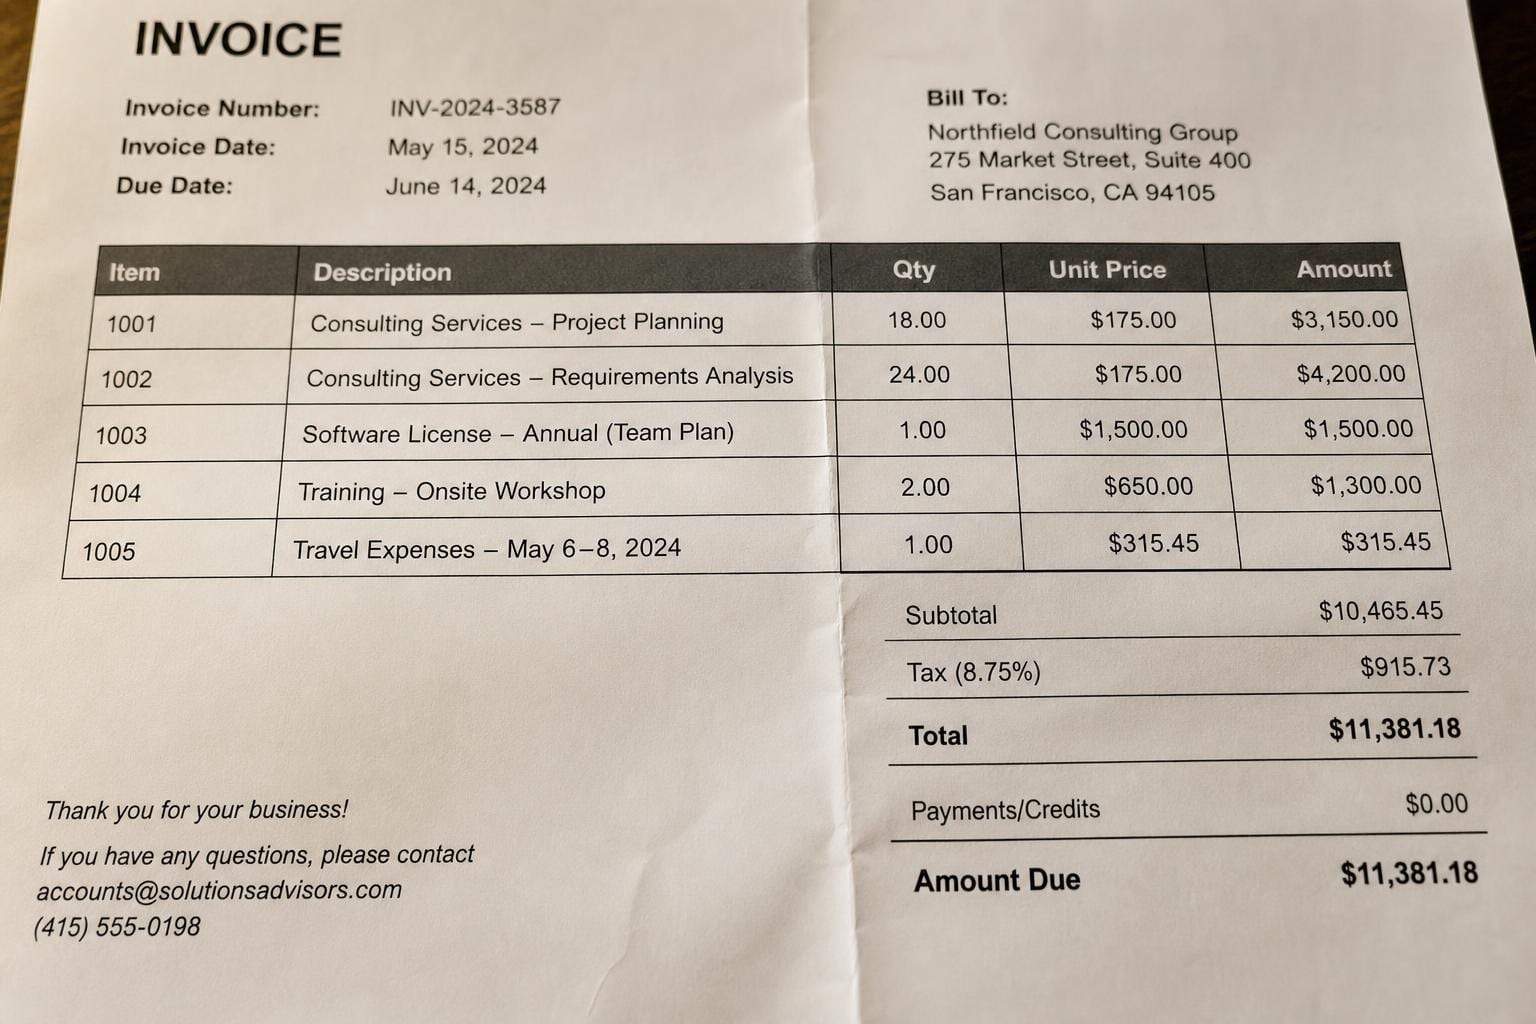
A outra peça importante é o dimensionamento dinâmico. Durante o treinamento, um modelo forte de visão-linguagem decide, para cada par consulta-documento, quantos tokens de conceito são necessários para representar a evidência relevante. Uma pergunta simples de consulta (qual é o total nesta fatura) pode precisar apenas de um. Uma pergunta de síntese que depende tanto de um gráfico quanto do parágrafo que o explica pode precisar de vários. Essa é uma mudança significativa em relação a alimentar cada exemplo através de uma representação de tamanho fixo, independentemente de quanta evidência ele realmente requer.
Esses conceitos só aparecem durante o treinamento. Eles atuam como um alvo intermediário que guia o espaço de incorporação do recuperador, aproximando as representações de consulta e documento de uma maneira que reflete a verdadeira evidência em vez de um proxy com perdas. No momento da inferência, quando alguém realmente digita uma pergunta em uma caixa de pesquisa, o recuperador apenas calcula as incorporações de consulta e documento e as compara diretamente. Nada no sistema implantado exige a execução de um modelo pesado de visão-linguagem no momento da consulta, o que é muito importante para quem pensa em custos de produção.
Os números: superando ambos os campos ao mesmo tempo
Os resultados são relatados como melhorias relativas no NDCG@10, uma forma padrão de avaliar a qualidade de uma lista classificada. NDCG significa ganho cumulativo descontado normalizado. Em termos simples: se a página verdadeiramente relevante for classificada em primeiro lugar, você recebe crédito total; se for classificada em décimo, recebe muito menos; se não estiver entre as 10 primeiras, recebe praticamente nada. "Normalizado" significa que a pontuação é escalonada em relação à melhor classificação possível, permitindo obter um número comparável entre diferentes consultas e conjuntos de dados.
Em um conjunto de benchmarks de recuperação de documentos visuais, o ConceptFormer apresenta uma melhoria relativa de 16,7% na média do NDCG@10 em relação à linha de base de recuperação visual mais forte testada, e uma melhoria relativa de 22,1% em relação à linha de base de recuperação de texto baseada em OCR mais forte. Esses são ganhos relativos em comparação com o sistema concorrente mais forte em cada categoria, e não contra algum adversário fraco, o que é a maneira mais honesta de relatar esse tipo de resultado.
O que acho mais convincente do que os números principais é a análise subsequente. O artigo relata que, ao observar o que os conceitos latentes realmente atendem, eles se concentram nas evidências visuais genuinamente relevantes: a região correta de um gráfico, a célula correta de uma tabela. Essa é uma verificação que merece ser levada a sério, pois é fácil para um sinal de treinamento auxiliar melhorar a pontuação de um benchmark por razões que não têm nada a ver com a narrativa apresentada sobre ele. Aqui, os conceitos parecem estar desempenhando a função para a qual foram projetados: conectar detalhes textuais de grão fino (o tipo em que o OCR é bom) com a estrutura visual em nível de documento (o tipo que a busca puramente textual perde), dentro de um único recuperador, sem que uma abordagem canibalize a outra.
Por que isso importa se você está construindo ou escolhendo uma stack de IA para documentos
Se você está construindo busca ou RAG sobre qualquer coisa que não seja texto puro, este artigo é um ponto de dados que vale a pena prestar atenção, mesmo que você nunca toque no código. O padrão de OCR-e-então-buscar que muitas equipes adotam por familiaridade está mensuravelmente atrás da recuperação nativa de visão em documentos onde a evidência reside em gráficos, tabelas e layout, e essa lacuna parece estar se ampliando, não se fechando. Se seus documentos são relatórios financeiros, fichas técnicas de produtos, formulários digitalizados ou apresentações de slides, e seus usuários fazem perguntas cujas respostas estão dentro de um gráfico ou tabela, em vez de uma frase, um pipeline apenas de texto vai continuar perdendo páginas que um humano encontraria instantaneamente.
Isso não significa que o OCR está morto. Muitos documentos são genuinamente texto denso e bem estruturado, e a busca baseada em OCR continua sendo mais barata e fácil de depurar para esses casos. Mas se você está avaliando motores ou recuperadores para cargas de trabalho pesadas em documentos com estrutura visual real, este é um bom lembrete para testar com o tipo de página que realmente quebra o OCR ingênuo: um gráfico com um número que ninguém escreveu como uma frase, uma tabela onde a resposta requer saber em qual coluna você está, um formulário onde uma caixa de seleção ao lado de uma linha significa algo que um extrator de texto não pode ver. Faça benchmark nisso, não em parágrafos limpos, porque é aí que a lacuna entre a recuperação antiga e a nativa de visão realmente aparece.
O que ainda está nebuloso
Vale a pena destacar algumas questões com honestidade. O processo de treinamento depende de um modelo robusto de visão e linguagem para gerar a supervisão de conceitos latentes, o que significa que a qualidade do sinal de treinamento do ConceptFormer é limitada pela qualidade desse modelo professor e adiciona um custo real ao pipeline de treinamento, embora não afete o custo de inferência. Os próprios conceitos latentes não são legíveis por humanos por design, o que é um compromisso aceitável em troca de desempenho, mas representa um custo real para a depuração: se o recuperador cometer um erro em produção, não há legenda ou caixa delimitadora para inspecionar e perguntar "foi esse o problema?".
As comparações principais também são do tipo "melhor contra melhor": a configuração mais forte do ConceptFormer contra a linha de base visual mais forte e a linha de base de OCR mais forte, cada uma nos benchmarks onde foram testadas. Essa é uma maneira legítima e comum de relatar resultados, mas vale lembrar que um único sistema implantado raramente tem a liberdade de escolher sua melhor comparação de linha de base da forma como um artigo acadêmico pode. Além disso, o resumo descreve os benchmarks apenas como "benchmarks diversos de recuperação de documentos visuais", portanto, não está claro, com base no que é público, o quão bem isso se generaliza para os casos mais caóticos do mundo real: baixa qualidade de digitalização, manuscritos, documentos altamente multilíngues ou o tipo de fotos feias e de baixa resolução de papel que aparecem constantemente no tráfego de produção real, em vez de em benchmarks curados.
O código e os dados estão públicos no GitHub, o que é a atitude correta e permite que qualquer pessoa verifique essas alegações, em vez de confiar apenas na palavra do resumo. Para um campo que tem apostado fortemente em "confie no benchmark", isso merece crédito por si só.