Tu chatbot no puede encontrar el gráfico que tiene la respuesta. Este artículo intenta solucionarlo.
Basado en: ConceptFormer: Learning Adaptive Latent Concepts for Query-Document Alignment in Visual Document Retrieval — Peng Chunyi, Xu Zhipeng, Yan Yukun, Liu Zhenghao, Yu Shi, Mei Sen, Sun Yubo, Zhang Yongheng, Zhou Jie, Gu Yu, Yu Ge, Sun Maosong
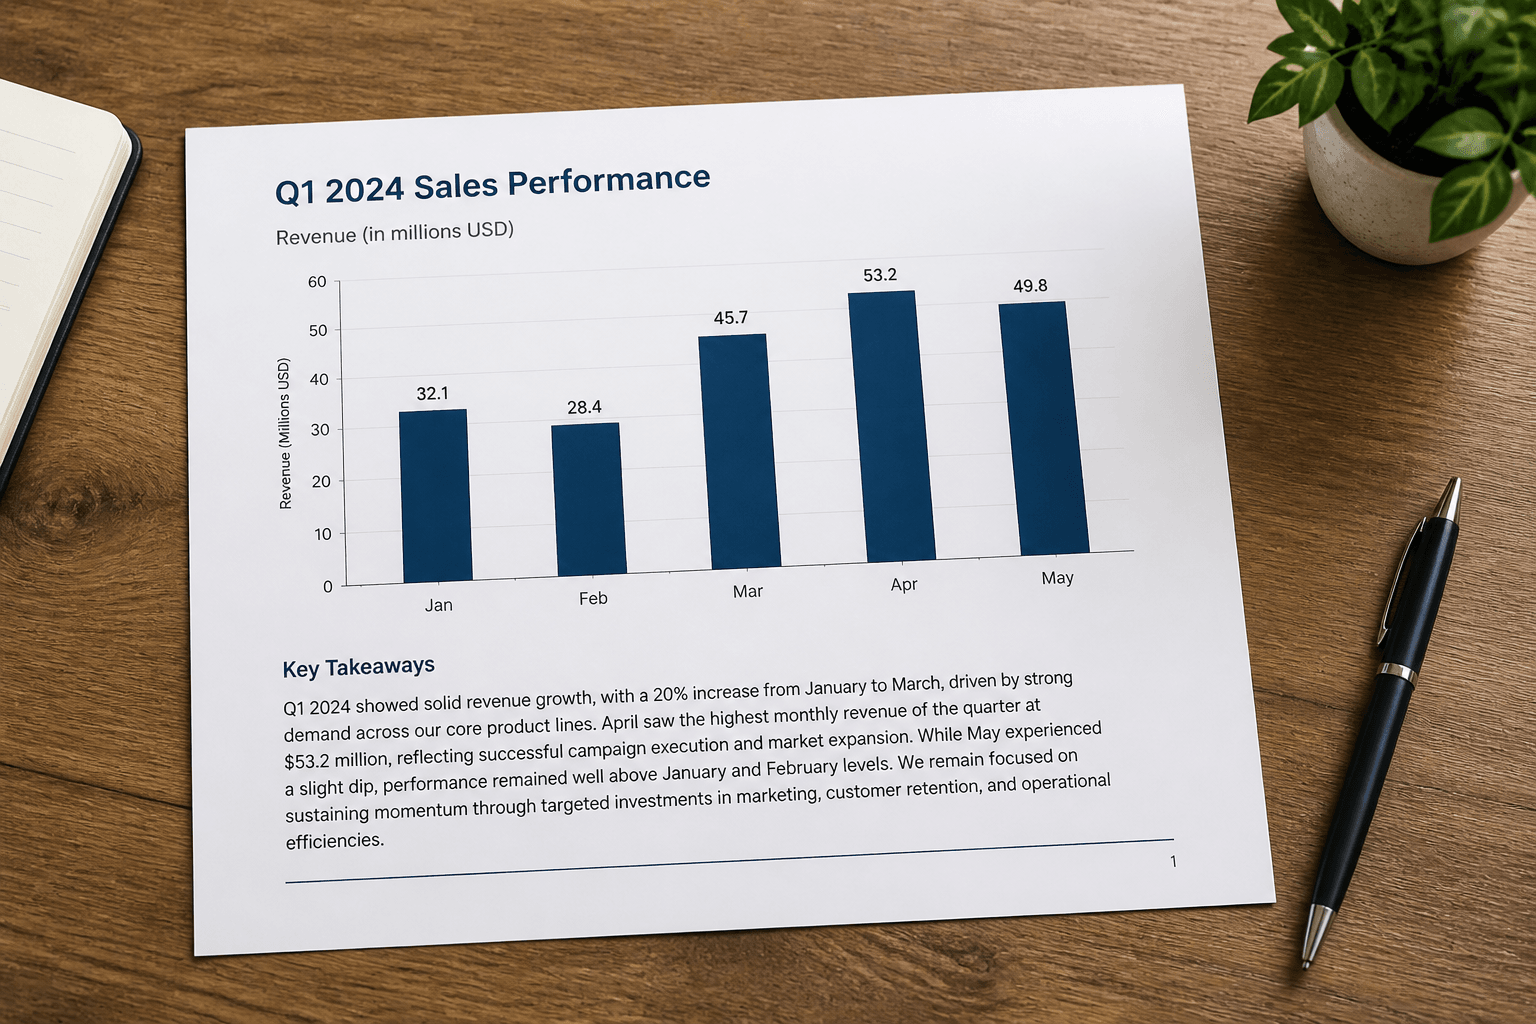
Imagina un chatbot de relaciones con inversores que ha procesado una presentación trimestral de 40 páginas. Alguien le pregunta: "¿Cuál fue nuestra tasa de cancelación el trimestre pasado?" El número es real y está en la página 23. Pero no está escrito en ninguna parte como una oración. Es la altura de una barra en un gráfico, junto a otras tres barras, con una pequeña etiqueta de porcentaje renderizada dentro del propio gráfico.
Un sistema de recuperación que funciona leyendo texto extraído pasará directamente por esa página. No hay ninguna oración que coincida con la pregunta. Este es exactamente el problema que intenta resolver un nuevo artículo llamado ConceptFormer, de un equipo que incluye investigadores de la Universidad Northeastern y la Universidad Tsinghua, y la forma en que lo resuelven es más interesante que la historia habitual de "modelo más grande, más datos".
La página con tu respuesta no siempre tiene las palabras para ella
Antes de que un sistema de IA pueda responder a una pregunta sobre un documento, es necesario encontrar la página correcta. Este paso se denomina recuperación (retrieval) y constituye la columna vertebral de la generación aumentada con recuperación (RAG): primero se busca la evidencia relevante y luego se la entrega a un modelo de lenguaje para que responda la pregunta. Si la recuperación falla, no importa lo bueno que sea el modelo que lee la página. Nunca verá la página.
Durante años, el método estándar para buscar en documentos consistía en ejecutar OCR (reconocimiento óptico de caracteres) para extraer el texto y luego buscar en ese texto como si se tratara de cualquier otro corpus. Esto funciona bien para un contrato de texto plano. Sin embargo, falla por completo en presentaciones, informes anuales o formularios escaneados, porque el OCR descarta todo lo que no sea texto: la forma de un gráfico, el hecho de que un número se encuentre en la celda superior derecha de una tabla, el énfasis visual de un total en negrita. Gran parte del significado real en un documento empresarial reside en esa estructura, no en las palabras.
El enfoque más reciente, que el artículo denomina recuperación visual, omite por completo el OCR y utiliza un modelo de visión y lenguaje (un modelo que puede procesar imágenes y texto simultáneamente, como GPT-4V o Qwen-VL) para examinar la página como una imagen y convertir todo en un vector, una larga lista de números que captura su significado. La consulta también se convierte en un vector, y la recuperación se reduce a encontrar qué vectores de documentos están más cerca del vector de la consulta en ese espacio compartido. Esto preserva el diseño y la estructura visual, lo cual representa una mejora real. Pero crea un problema de entrenamiento: ¿cómo se enseña al modelo qué parte de una página concurrida es realmente relevante para una pregunta dada?
Los intentos recientes de obtener esa señal de entrenamiento de grano fino se han apoyado en dos proxies. Uno son las descripciones textuales: hacer que un modelo potente escriba, en palabras, cuál es la evidencia relevante. El otro son las regiones visuales localizadas: dibujar un cuadro delimitador alrededor de la parte de la página que responde a la pregunta. Ambos tienen defectos reales. Una descripción no puede capturar por completo lo que hace la forma de un gráfico o el diseño de una tabla. Un cuadro delimitador asume que la evidencia reside en un rectángulo limpio, lo cual se desmorona en el momento en que la respuesta depende de conectar un número en un gráfico con una leyenda que está a dos pulgadas de distancia, o con una nota al pie en la parte inferior de la página.
Conceptos latentes: evidencia sin subtítulo ni cuadro delimitador
El movimiento central de ConceptFormer es dejar de forzar la señal de evidencia en uno u otro formato. En lugar de escribir un subtítulo o dibujar un rectángulo, representa "qué es relevante en esta página para esta consulta" como un conjunto de vectores continuos a los que llama conceptos latentes.
Una forma de pensarlo es la siguiente: un subtítulo es una descripción comprimida en inglés. Un cuadro delimitador es una descripción comprimida en coordenadas de píxeles. Ambos formatos descartan información al traducirse, porque fuerzan algo visual y relacional a un vocabulario fijo. Un concepto latente omite el paso de traducción. Es un vector que existe directamente en el mismo espacio matemático que las incrustaciones (embeddings) de la consulta y del documento, moldeado por el entrenamiento para situarse cerca de aquella parte de la representación del documento que es realmente relevante. Nadie puede leer en voz alta un concepto latente como se lee un subtítulo, pero tampoco necesita perder la información visual y semántica de la manera en que lo hace un subtítulo.
Otro aspecto destacable es el dimensionamiento dinámico. Durante el entrenamiento, un potente modelo de visión y lenguaje decide, para cada par consulta-documento, cuántos tokens de concepto se necesitan para representar la evidencia relevante. Una pregunta de consulta simple (¿cuál es el total en esta factura?) podría necesitar solo uno. Una pregunta de síntesis que dependa tanto de un gráfico como del párrafo que lo explica podría necesitar varios. Esto supone un cambio significativo respecto a procesar cada ejemplo a través de una representación de tamaño fijo, independientemente de la cantidad de evidencia que realmente requiera.
Estos conceptos solo aparecen durante el entrenamiento. Actúan como un objetivo intermedio que guía el espacio de incrustaciones del recuperador, acercando las representaciones de la consulta y del documento de una manera que refleja la evidencia real en lugar de un proxy con pérdida de información. En el momento de la inferencia, cuando alguien escribe una pregunta en una caja de búsqueda, el recuperador simplemente calcula las incrustaciones de la consulta y del documento y las compara directamente. Nada del sistema desplegado requiere ejecutar un modelo pesado de visión y lenguaje en el momento de la consulta, lo cual es muy importante para quienes consideran el costo en producción.
Los números: superando a ambos campos a la vez
Los resultados se informan como mejoras relativas en NDCG@10, una forma estándar de puntuar qué tan buena es una lista clasificada. NDCG significa ganancia acumulativa descontada normalizada. En términos sencillos: si la página verdaderamente relevante se clasifica en primer lugar, obtienes crédito completo; si se clasifica en décimo lugar, obtienes mucho menos; si no está en los primeros 10 en absoluto, obtienes esencialmente ninguno. "Normalizado" significa que la puntuación se escala en comparación con la clasificación posible mejor, por lo que obtienes un número que puedes comparar entre diferentes consultas y conjuntos de datos.
En un conjunto de benchmarks de recuperación de documentos visuales, ConceptFormer registra una mejora relativa del 16,7% en el NDCG@10 promedio sobre la línea base de recuperación visual más fuerte contra la que se probó, y una mejora relativa del 22,1% sobre la línea base de recuperación de texto basada en OCR más fuerte. Esas son ganancias relativas frente al sistema competidor mejor en cada categoría, no frente a algún hombre de paja débil, que es la forma más honesta de informar este tipo de resultado.
Lo que encuentro más convincente que los números principales es el análisis posterior. El informe indica que cuando miras a lo que los conceptos latentes realmente prestan atención, caen en la evidencia visual verdaderamente relevante: la región correcta de un gráfico, la celda correcta en una tabla. Esa es una verificación que vale la pena tomar en serio, porque es fácil para una señal de entrenamiento auxiliar mejorar una puntuación de benchmark por razones que no tienen nada que ver con la historia que estás contando sobre ella. Aquí, los conceptos parecen estar haciendo el trabajo para el que fueron diseñados: conectar detalles textuales de grano fino (el tipo en el que OCR es bueno) con la estructura visual a nivel de documento (el tipo que la búsqueda de texto puro pierde), dentro de un solo recuperador, sin que un enfoque canibalice al otro.
Por qué importa si estás construyendo o eligiendo una pila de IA para documentos
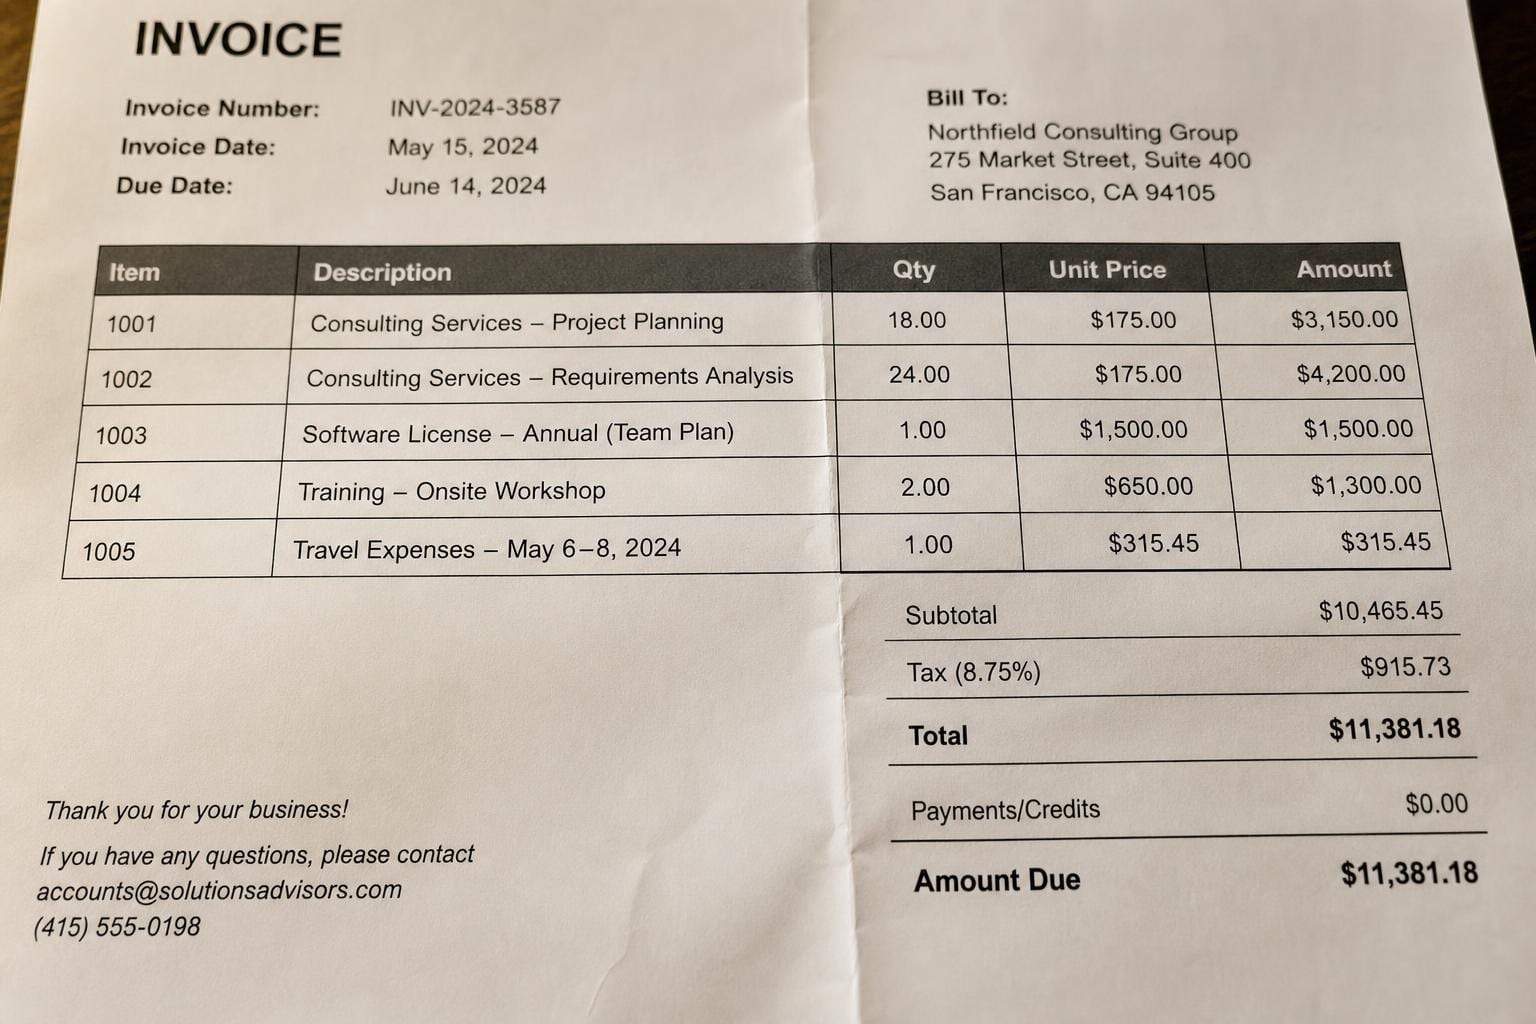
Si estás construyendo búsqueda o RAG sobre cualquier cosa que no sea texto plano, este artículo es un dato empírico al que vale la pena prestar atención, incluso si nunca tocas el código. El patrón de OCR y luego búsqueda al que muchos equipos recurren por familiaridad está mediblemente por detrás de la recuperación nativa de visión en documentos donde la evidencia reside en gráficos, tablas y diseño, y esa brecha parece estar ampliándose en lugar de cerrarse. Si tus documentos son informes financieros, hojas de especificaciones de productos, formularios escaneados o presentaciones de diapositivas, y tus usuarios hacen preguntas cuyas respuestas están dentro de un gráfico o una tabla en lugar de una oración, una canalización solo de texto seguirá omitiendo páginas que un humano encontraría al instante.
Eso no significa que el OCR esté muerto. Muchos documentos son genuinamente texto denso y bien estructurado, y la búsqueda basada en OCR sigue siendo más barata y fácil de depurar para esos casos. Pero si estás evaluando motores o recuperadores para cargas de trabajo intensivas en documentos con estructura visual real, este es un buen recordatorio para probar con el tipo de páginas que realmente rompen el OCR ingenuo: un gráfico con un número que nadie escribió como una oración, una tabla donde la respuesta requiere saber en qué columna estás, un formulario donde una casilla de verificación junto a una línea significa algo que un extractor de texto no puede ver. Realiza pruebas de rendimiento en esos casos, no en párrafos limpios, porque es ahí donde realmente se muestra la brecha entre la recuperación de estilo antiguo y la nativa de visión.
Qué sigue siendo difuso
Hay algunos aspectos que vale la pena señalar con honestidad. El proceso de entrenamiento depende de un modelo de visión-idioma robusto para generar la supervisión de conceptos latentes, lo que significa que la calidad de la señal de entrenamiento de ConceptFormer está limitada por la calidad de ese modelo maestro y añade un costo real a la tubería de entrenamiento, aunque no afecte al costo de inferencia. Los propios conceptos latentes no son legibles por humanos por diseño, lo cual es un compromiso aceptable para el rendimiento, pero supone un costo real para la depuración: si el recuperador comete un error en producción, no hay ninguna leyenda ni caja delimitadora que inspeccionar para preguntarse "¿era este el problema?".
Las comparaciones principales también son de lo mejor contra lo mejor: la configuración más fuerte de ConceptFormer frente a la línea base visual más fuerte y la línea base de OCR más fuerte, cada una en los conjuntos de evaluación donde se probaron. Esta es una forma legítima y común de informar los resultados, pero vale la pena recordar que un sistema desplegado individualmente rara vez puede seleccionar a dedo su mejor comparación de línea base como lo hace un artículo académico. Y el resumen describe los conjuntos de evaluación simplemente como "conjuntos de evaluación diversos para la recuperación de documentos visuales", por lo que no está claro, a partir de lo que es público, qué tan bien se generaliza a los casos del mundo real más caóticos: mala calidad de escaneo, escritura a mano, documentos altamente multilingües o ese tipo de fotos feas y de baja resolución de papel que aparecen constantemente en el tráfico de producción real, en lugar de en conjuntos de evaluación curados.
El código y los datos son públicos en GitHub, lo cual es la decisión correcta y permite que cualquiera verifique estas afirmaciones en lugar de confiar ciegamente en lo que dice el resumen. Para un campo que ha estado apostando fuerte a "confía en el conjunto de evaluación", esto merece crédito por sí solo.