आपका चैटबॉट वह चार्ट नहीं ढूंढ सकता जिसमें उत्तर है। यह पेपर इसे ठीक करने की कोशिश करता है।
आधारित शोध-पत्र: ConceptFormer: Learning Adaptive Latent Concepts for Query-Document Alignment in Visual Document Retrieval — Peng Chunyi, Xu Zhipeng, Yan Yukun, Liu Zhenghao, Yu Shi, Mei Sen, Sun Yubo, Zhang Yongheng, Zhou Jie, Gu Yu, Yu Ge, Sun Maosong
एक निवेशक संबंधों (investor-relations) चैटबॉट की कल्पना करें जिसने 40 पृष्ठों का एक त्रैमासिक डेक (quarterly deck) पढ़ लिया है। कोई पूछता है: "पिछले तिमाही में हमारी चर्न दर (churn rate) क्या थी?" संख्या वास्तविक है, और यह पृष्ठ 23 पर है। लेकिन यह कहीं वाक्य के रूप में नहीं लिखी गई है। यह एक चार्ट में एक बार (bar) की ऊंचाई है, तीन अन्य बार के बगल में, जिसमें ग्राफिक के अंदर ही एक छोटा प्रतिशत लेबल रेंडर किया गया है।
एक रीट्रीवल सिस्टम (retrieval system) जो निकाली गई टेक्स्ट को पढ़कर काम करता है, उस पृष्ठ को बिल्कुल नजरअंदाज करके आगे बढ़ जाएगा। प्रश्न से मिलान करने के लिए कोई वाक्य नहीं है। यह वही सटीक समस्या है जिसे ConceptFormer नामक एक नई पेपर, जिसमें Northeastern University और Tsinghua University के शोधकर्ताओं सहित एक टीम ने हल करने की कोशिश की है, और वे इसे हल करने का तरीका सामान्य "बड़ा मॉडल, अधिक डेटा" की कहानी से अधिक दिलचस्प है।
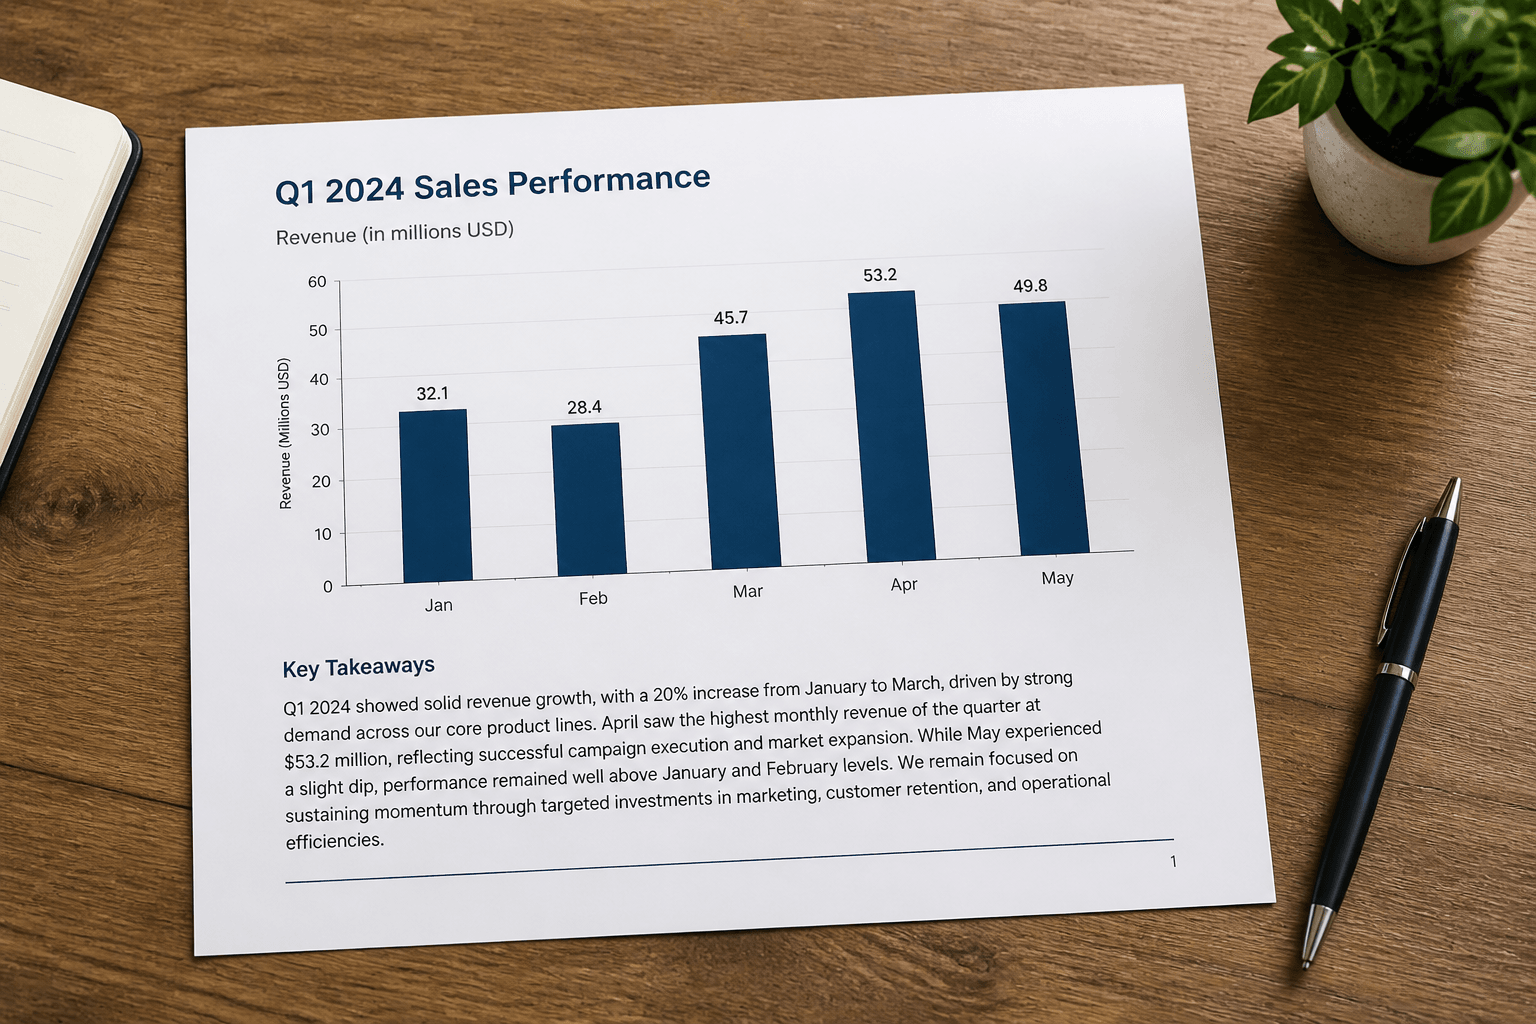
जिस पृष्ठ पर आपका उत्तर है, उसमें हमेशा उसके शब्द नहीं होते
किसी दस्तावेज़ के बारे में प्रश्न का उत्तर देने के लिए एआई सिस्टम को तैयार करने से पहले, आपको सही पृष्ठ खोजना होगा। इस चरण को रीट्रिवल (retrieval) कहा जाता है, और यह रीट्रिवल-ऑगमेंटेड जनरेशन (RAG) की रीढ़ है: पहले प्रासंगिक सबूत खोजें, फिर प्रश्न का वास्तविक उत्तर देने के लिए उसे एक भाषा मॉडल को सौंपें। रीट्रिवल गलत हो तो पृष्ठ पढ़ने वाले मॉडल की गुणवत्ता का कोई महत्व नहीं है। वह कभी भी उस पृष्ठ को नहीं देखता।
वर्षों से, दस्तावेज़ों को खोजने का मानक तरीका यह था कि टेक्स्ट निकालने के लिए OCR (ऑप्टिकल कैरेक्टर रिकग्निशन) चलाया जाता था, और फिर उस टेक्स्ट को किसी अन्य कॉर्पस की तरह खोजा जाता था। यह सादे टेक्स्ट वाले अनुबंध के लिए ठीक काम करता है। यह स्लाइड डेक, वार्षिक रिपोर्ट, या स्कैन किए गए फॉर्म के लिए टूट जाता है, क्योंकि OCR टेक्स्ट नहीं होने वाली हर चीज़ को फेंक देता है: चार्ट का आकार, यह तथ्य कि कोई संख्या टेबल के ऊपरी-दाएं सेल में स्थित है, बोल्ड कुल राशि का दृश्य जोर। व्यावसायिक दस्तावेज़ में वास्तविक अर्थ का एक बड़ा हिस्सा शब्दों में नहीं, बल्कि उस संरचना में निहित होता है।
नया दृष्टिकोण, जिसे कागज़ विजुअल रीट्रिवल (visual retrieval) कहता है, OCR को पूरी तरह छोड़ देता है और एक विज़न-लैंग्वेज मॉडल (एक ऐसा मॉडल जो छवियों और टेक्स्ट दोनों को एक साथ प्रोसेस कर सकता है, जैसे GPT-4V या Qwen-VL) को पृष्ठ को एक छवि के रूप में देखने और पूरे पृष्ठ को एक वेक्टर (अर्थात संख्याओं की एक लंबी सूची जो इसके अर्थ को कैप्चर करती है) में बदलने के लिए कहता है। क्वेरी को भी एक वेक्टर में बदल दिया जाता है, और रीट्रिवल उस साझा स्थान में कौन से दस्तावेज़ वेक्टर क्वेरी वेक्टर के सबसे करीब हैं, यह खोजने की बात बन जाती है। इससे लेआउट और दृश्य संरचना बनी रहती है, जो एक वास्तविक सुधार है। लेकिन यह एक प्रशिक्षण समस्या पैदा करता है: आप मॉडल को कैसे सिखाते हैं कि व्यस्त पृष्ठ का कौन सा हिस्सा किसी दिए गए प्रश्न के लिए वास्तव में महत्वपूर्ण है?
इस सूक्ष्म प्रशिक्षण सिग्नल के लिए हाल की कोशिशें दो प्रॉक्सी पर निर्भर रही हैं। एक है पाठ्य विवरण: एक शक्तिशाली मॉडल से शब्दों में लिखवाएं कि प्रासंगिक सबूत क्या है। दूसरा है स्थानीयकृत दृश्य क्षेत्र: पृष्ठ के उस हिस्से के चारों ओर बाउंडिंग बॉक्स खींचें जो प्रश्न का उत्तर देता है। दोनों में वास्तविक कमियाँ हैं। एक कैप्शन चार्ट के आकार या टेबल के लेआउट के क्या कर रहे हैं, इसे पूरी तरह कैप्चर नहीं कर सकता। एक बाउंडिंग बॉक्स यह मानता है कि सबूत एक साफ आयत में स्थित है, जो तुरंत टूट जाता है जब उत्तर चार्ट में एक संख्या को दो इंच दूर कैप्शन से, या पृष्ठ के निचले हिस्से में फुटनोट से जोड़ने पर निर्भर करता है।
गुप्त अवधारणाएँ: बिना कैप्शन या बॉक्स के प्रमाण
ConceptFormer की मूल रणनीति यह है कि प्रमाण संकेत को किसी एक प्रारूप में जबरन फिट करने से बचना। कैप्शन लिखने या आयत खींचने के बजाय, यह "इस क्वेरी के लिए इस पृष्ठ पर क्या मायने रखता है" को एक सतत वेक्टर (continuous vectors) के सेट के रूप में दर्शाता है, जिसे वह गुप्त अवधारणाएँ (latent concepts) कहता है।
इसे समझने का एक तरीका यह है। कैप्शन अंग्रेजी में एक संपीड़ित विवरण है। बाउंडिंग बॉक्स पिक्सेल निर्देशांकों में एक संपीड़ित विवरण है। दोनों प्रारूप अनुवाद के दौरान जानकारी को खो देते हैं, क्योंकि वे दृश्य और संबंधित चीज़ों को एक निश्चित शब्दावली में जबरन ढाल रहे हैं। एक गुप्त अवधारणा अनुवाद चरण को छोड़ देती है। यह एक वेक्टर है जो सीधे उसी गणितीय स्थान में मौजूद होता है जहाँ क्वेरी और दस्तावेज़ एम्बेडिंग्स होती हैं, और प्रशिक्षण के दौरान इसे दस्तावेज़ के प्रतिनिधित्व के उस हिस्से के पास रखने के लिए आकार दिया जाता है जो वास्तव में प्रासंगिक हो। कोई भी गुप्त अवधारणा को कैप्शन की तरह ज़ोर से नहीं पढ़ सकता, लेकिन इसका मतलब यह नहीं है कि यह कैप्शन की तरह दृश्य और अर्थबोधित जानकारी को खो देता है।
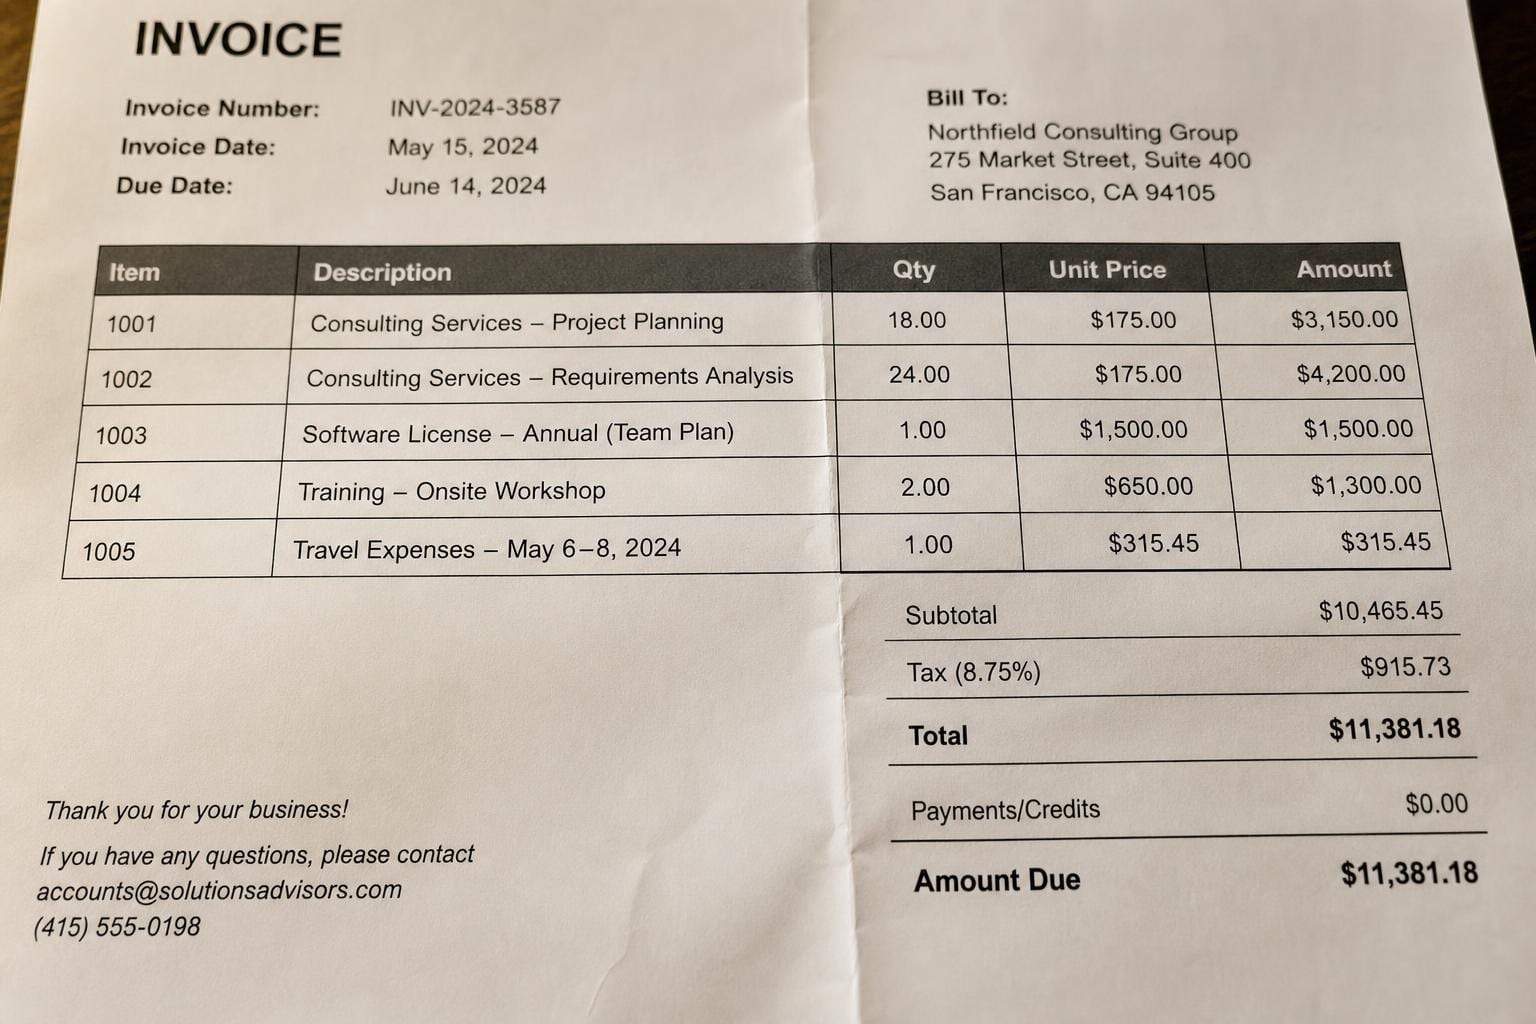
एक और महत्वपूर्ण पहलू डायनामिक साइजिंग (dynamic sizing) है। प्रशिक्षण के दौरान, एक शक्तिशाली विज़न-लैंग्वेज मॉडल यह तय करता है कि प्रत्येक क्वेरी-दस्तावेज़ जोड़ी के लिए प्रासंगिक प्रमाण को दर्शाने के लिए कितनी अवधारणा टोकन (concept tokens) की आवश्यकता है। एक सरल लुकअप प्रश्न (इस इनवॉइस पर कुल राशि क्या है) के लिए शायद केवल एक की आवश्यकता हो। एक संश्लेषण प्रश्न जिसका संबंध एक चार्ट और उसे समझाते पैराग्राफ दोनों से हो, के लिए कई की आवश्यकता हो सकती है। यह उस दृष्टिकोण से एक महत्वपूर्ण विचलन है जहाँ हर उदाहरण को उस प्रमाण की मात्रा की परवाह किए बिना एक निश्चित आकार के प्रतिनिधित्व से गुज़ारा जाता है।
ये अवधारणाएँ केवल प्रशिक्षण के दौरान दिखाई देती हैं। वे एक मध्यवर्ती लक्ष्य के रूप में कार्य करती हैं जो रीट्रीवर के एम्बेडिंग स्पेस को मार्गदर्शन प्रदान करती है, क्वेरी और दस्तावेज़ प्रतिनिधित्वों को उस प्रकार से एक साथ लाती है जो वास्तविक प्रमाण को दर्शाता है, न कि उसका कोई ह्रासित प्रतिनिधि (lossy proxy)। अनुमान (inference) समय पर, जब कोई वास्तव में एक खोज बॉक्स में प्रश्न टाइप करता है, तो रीट्रीवर बस क्वेरी और दस्तावेज़ एम्बेडिंग्स की गणना करता है और उन्हें सीधे तुलना करता है। तैनात सिस्टम में क्वेरी समय पर भारी विज़न-लैंग्वेज मॉडल चलाने की कोई आवश्यकता नहीं होती, जो उत्पादन लागत के बारे में सोचने वाले किसी के लिए बहुत महत्वपूर्ण है।
संख्याएँ: एक साथ दोनों शिविरों को मात देना
परिणाम NDCG@10 में सापेक्ष सुधार के रूप में रिपोर्ट किए गए हैं, जो एक रैंकedList की गुणवत्ता को मापने का एक मानक तरीका है। NDCG का अर्थ है normalized discounted cumulative gain। सरल शब्दों में: यदि वास्तव में प्रासंगिक पृष्ठ पहले स्थान पर रैंक होता है, तो आपको पूर्ण क्रेडिट मिलता है; यदि यह दसवें स्थान पर है, तो आपको बहुत कम मिलता है; और यदि यह शीर्ष 10 में बिल्कुल नहीं है, तो आपको लगभग कुछ नहीं मिलता है। "Normalized" का अर्थ है कि स्कोर को सर्वोत्तम संभव रैंकिंग के विरुद्ध स्केल किया गया है, ताकि आपको एक संख्या मिले जिसका उपयोग आप विभिन्न क्वेरी और डेटासेट के बीच तुलना के लिए कर सकें।
दृश्य दस्तावेज़ पुनर्प्राप्ति (visual document retrieval) बेंचमार्क के एक सेट में, ConceptFormer ने जिस सबसे मजबूत दृश्य पुनर्प्राप्ति बेसलाइन के विरुद्ध परीक्षण किया था, उसके मुकाबले औसत NDCG@10 में 16.7% सापेक्ष सुधार दर्ज किया, और सबसे मजबूत OCR-आधारित पाठ पुनर्प्राप्ति बेसलाइन के मुकाबले 22.1% सापेक्ष सुधार दर्ज किया। ये प्रत्येक श्रेणी में सर्वश्रेष्ठ प्रतिस्पर्धी सिस्टम के विरुद्ध सापेक्ष लाभ हैं, न कि किसी कमजोर प्रतिद्वंद्वी के विरुद्ध, जो इस प्रकार के परिणाम को रिपोर्ट करने का अधिक ईमानदार तरीका है।
मुझे हेडलाइन संख्याओं की तुलना में फॉलो-अप विश्लेषण अधिक प्रभावशाली लगता है। पेपर में रिपोर्ट किया गया है कि जब आप देखते हैं कि लैटेंट कॉन्सेप्ट्स (latent concepts) वास्तव में किस पर ध्यान केंद्रित करते हैं, तो वे वास्तव में प्रासंगिक दृश्य सबूतों पर केंद्रित होते हैं: चार्ट का सही क्षेत्र, टेबल में सही सेल। यह एक चेक है जिसे गंभीरता से लेना चाहिए, क्योंकि यह आसान है कि एक सहायक प्रशिक्षण सिग्नल किसी ऐसे कारण से बेंचमार्क स्कोर में सुधार कर दे जो उस कहानी से बिल्कुल भी संबंधित न हो जिसका आप उसका वर्णन कर रहे हैं। यहाँ, कॉन्सेप्ट्स वह काम कर रहे प्रतीत होते हैं जिसके लिए उन्हें डिज़ाइन किया गया था: एक ही रीट्रीवर के भीतर, बिना एक दृष्टिकोण दूसरे को निगल जाने के, बारीक-बारीक पाठ्य विवरण (जिसमें OCR अच्छा है) को दस्तावेज़-स्तरीय दृश्य संरचना (जो शुद्ध पाठ खोज छूट देती है) से जोड़ना।
यदि आप डॉक्यूमेंट AI स्टैक बना रहे हैं या चुन रहे हैं, तो यह क्यों मायने रखता है
यदि आप सादे पाठ (plain text) के अलावा किसी भी चीज़ पर सर्च या RAG बना रहे हैं, तो यह पेपर एक ऐसा डेटा पॉइंट है जिस पर ध्यान देना चाहिए, भले ही आप कभी कोड को छुएँ नहीं। कई टीमें जो परिचित होने के कारण OCR-फिर-सर्च पैटर्न का डिफ़ॉल्ट रूप से उपयोग करती हैं, वह उन डॉक्यूमेंट्स पर विज़न-नेटिव रीट्रीवल से मापनीय रूप से पीछे हैं जहाँ सबूत चार्ट, टेबल और लेआउट में होते हैं, और यह अंतर बढ़ता हुआ प्रतीत होता है, बंद नहीं हो रहा। यदि आपके डॉक्यूमेंट्स फाइनेंशियल रिपोर्ट्स, प्रोडक्ट स्पेक शीट्स, स्कैन किए गए फॉर्म्स या स्लाइड डेक्स हैं, और आपके उपयोगकर्ता ऐसे सवाल पूछते हैं जिनके जवाब वाक्य के बजाय चार्ट या टेबल के अंदर हैं, तो एक टेक्स्ट-ओनली पाइपलाइन उन पेजों को लगातार छूटने देगी जिन्हें एक इंसान तुरंत ढूंढ लेगा।
इसका मतलब यह नहीं है कि OCR मर चुका है। बहुत से डॉक्यूमेंट्स वास्तव में घने, अच्छी तरह संरचित पाठ हैं, और उन मामलों के लिए OCR-आधारित सर्च अभी भी सस्ता और डीबग करने में आसान है। लेकिन यदि आप वास्तविक विज़ुअल संरचना वाले डॉक्यूमेंट-भारी वर्कलोड के लिए इंजन या रीट्रीवर्स का मूल्यांकन कर रहे हैं, तो यह एक अच्छा याद दिलाव है कि उन पेजों के साथ टेस्ट करें जो वास्तव में नाइव OCR को तोड़ देते हैं: एक चार्ट जिसमें कोई संख्या वाक्य के रूप में लिखी नहीं गई है, एक टेबल जहाँ जवाब के लिए यह जानना ज़रूरी है कि आप किस कॉलम में हैं, या एक फॉर्म जहाँ लाइन के बगल में चेकबॉक्स का मतलब होता है जो एक टेक्स्ट एक्सट्रैक्टर नहीं देख सकता। उन पर बेन्चमार्क करें, साफ़ पैराग्राफ़ पर नहीं, क्योंकि वही जगह है जहाँ पुराने स्टाइल और विज़न-नेटिव रीट्रीवल के बीच का अंतर वास्तव में सामने आता है। मजबूत अंग्रेज़ी OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा होगा; देवनागरी की जटिल संयुक्त वर्णों और शिरोरेखा की वजह से यहाँ अक्सर और चुनौतियाँ आती हैं।
क्या अभी भी धुंधला है
ईमानदारी से कहें तो कुछ बातें ध्यान देने योग्य हैं। प्रशिक्षण प्रक्रिया एक मजबूत विज़न-लैंग्वेज मॉडल पर निर्भर करती है जो लैटेंट कॉन्सेप्ट सपर्विज़न (latent concept supervision) उत्पन्न करता है, जिसका अर्थ है कि ConceptFormer के प्रशिक्षण सिग्नल की गुणवत्ता उस टीचर मॉडल की क्षमता से सीमित है और प्रशिक्षण पाइपलाइन में वास्तविक लागत जोड़ता है, भले ही यह इनफरेंस लागत को प्रभावित नहीं करता। डिज़ाइन के अनुसार, लैटेंट कॉन्सेप्ट्स स्वयं मानव-पठनीय (human-readable) नहीं हैं, जो प्रदर्शन के लिए एक उचित समझौता है, लेकिन डीबगिंग के लिए एक वास्तविक लागत है: यदि प्रोडक्शन में रीट्रीवर कुछ गलत करता है, तो जांचने और पूछने के लिए कोई कैप्शन या बाउंडिंग बॉक्स नहीं होता कि "क्या यह समस्या थी।"
मुख्य तुलनाएं भी सर्वश्रेष्ठ-विरुद्ध-सर्वश्रेष्ठ (best-versus-best) हैं: ConceptFormer की सबसे मजबूत कॉन्फ़िगरेशन की तुलना सबसे मजबूत विज़ुअल बेसलाइन और सबसे मजबूत OCR बेसलाइन से की गई है, प्रत्येक उन बेंचमार्क पर जहां उन्हें परीक्षण किया गया था। परिणाम रिपोर्ट करने का यह एक वैध और सामान्य तरीका है, लेकिन यह याद रखना महत्वपूर्ण है कि एकल डिप्लॉय किए गए सिस्टम को अक्सर उस तरह से अपने सर्वश्रेष्ठ बेसलाइन तुलना का चयन करने का मौका नहीं मिलता जैसे कि एक पेपर कर सकता है। और सारांश में बेंचमार्क को केवल "विविध विज़ुअल डॉक्यूमेंट रीट्रीवल बेंचमार्क" के रूप में वर्णित किया गया है, इसलिए यह स्पष्ट नहीं है कि यह सार्वजनिक रूप से उपलब्ध जानकारी के आधार पर वास्तविक दुनिया के सबसे जटिल मामलों — जैसे खराब स्कैन गुणवत्ता, हाथ से लिखाई, भारी बहुभाषी दस्तावेज़, या वास्तविक प्रोडक्शन ट्रैफ़िक में लगातार दिखने वाले कागज़ के खराब, कम रिज़ॉल्यूशन वाले फ़ोटो — के लिए कितनी अच्छी तरह सामान्यीकृत (generalize) होता है, न कि केवल तैयार किए गए बेंचमार्क में।
कोड और डेटा GitHub पर सार्वजनिक हैं, जो सही कदम है और किसी भी व्यक्ति को इन दावों की जांच करने की अनुमति देता है, बजाय इसके कि वे केवल सारांश पर भरोसा करें। एक ऐसे क्षेत्र के लिए जो "बेंचमार्क पर भरोसा करें" के प्रति बहुत अधिक झुका हुआ रहा है, यह अपने आप में सराहनीय है।