نموذج OCR يقرأ هوامشك الفارغة، وهذا هو سبب بطئه
استنادًا إلى: LayoutLite: Token-Level Implicit Layout Analysis for Efficient Document OCR — Xudong Liu, Bicheng Wan, Yulin Jin
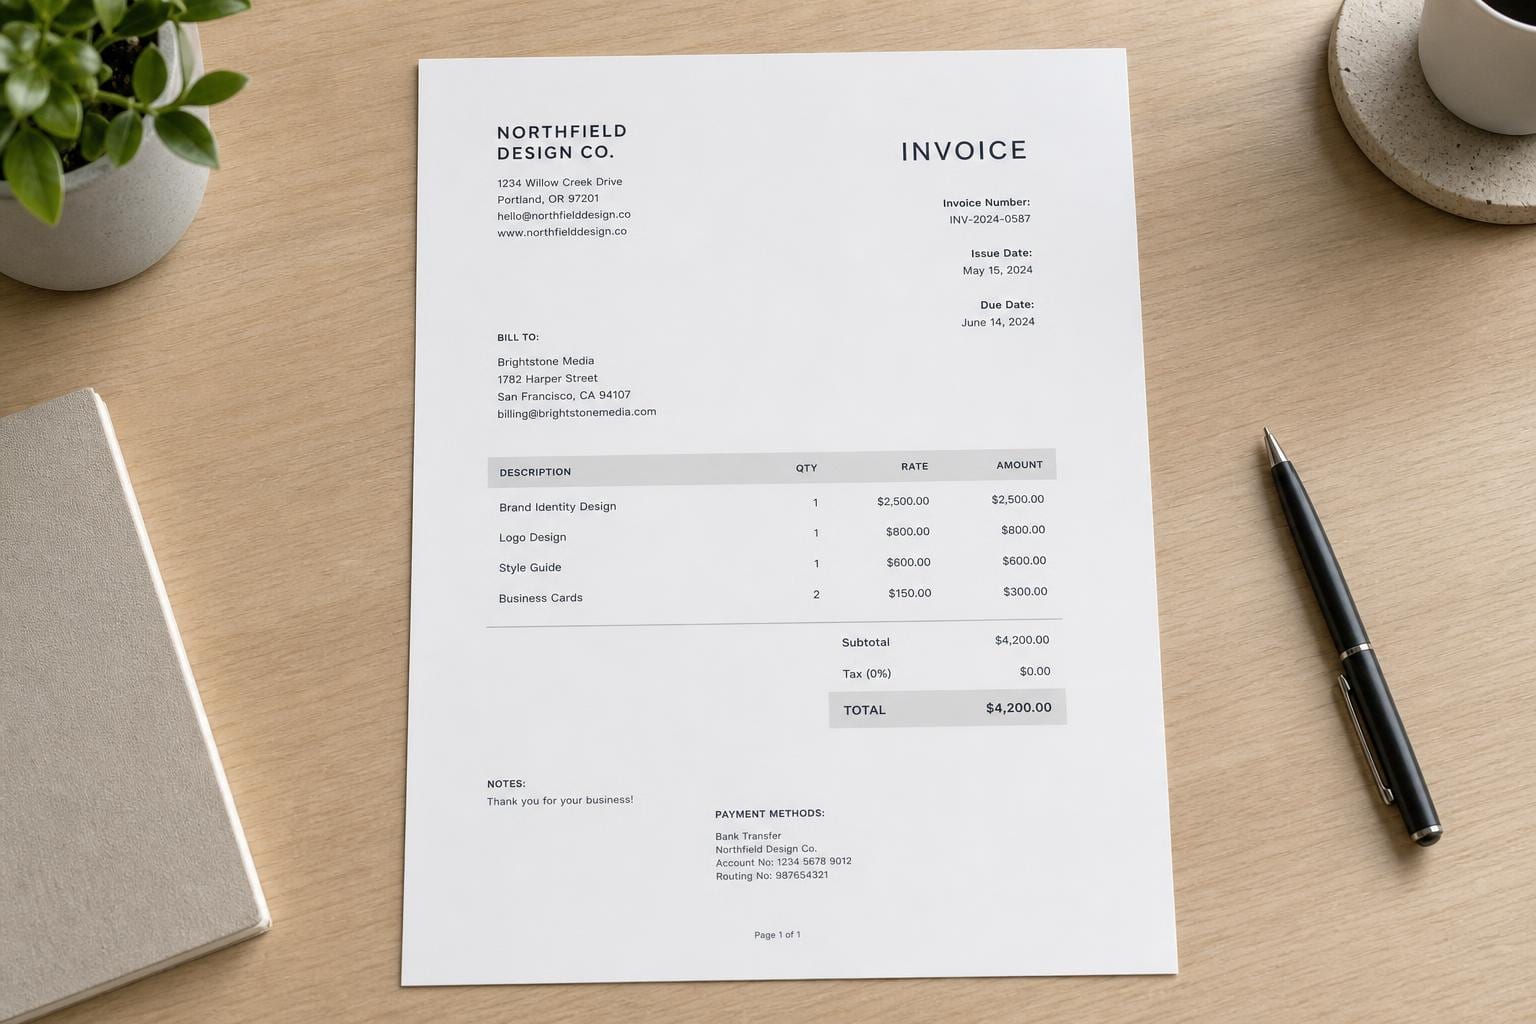
افتح أي فاتورة أو إيصال أو نموذج ممسوح ضوئيًا على مكتبك وانظر إليه كما تفعل الآلة. ربما يمثل النص خمس المساحة فقط. والباقي هو مساحة بيضاء: هوامش، وفراغات بين بنود الأسطر، والنصف الفارغ من مربع التوقيع. تتخطى العين البشرية هذه الفراغات فورًا. لكن نموذج اللغة البصرية لا يفعل ذلك. فهو يقسم الصورة بأكملها إلى شبكة من الرموز (tokens)، وهي القطع الصغيرة التي يحول النموذج بكسلات الصورة إليها قبل أن يتمكن من "التفكير" فيها، ويقدم كل رمز منها، بما في ذلك البقع الفارغة، إلى مُفكِّش لغوي مكلف. وفي تقرير كثيف متعدد الأعمدة، قد يعني ذلك إنفاق آلاف الرموز في وصف لا شيء على الإطلاق.
هذا الهدر هو الهدف من ورقة بحثية جديدة بعنوان "LayoutLite: تحليل التخطيط الضمني على مستوى الرموز لـ OCR المستندات بكفاءة"، من الباحثين شودونغ ليو، وبيتشيانغ وان، ويولين جين (نُشرت على arXiv في 24 يوليو 2026). زعمهم: يمكنك التخلص من ما يصل إلى نصف الرموز البصرية لصورة المستند قبل أن تصل إلى نموذج اللغة، ولن يتغير مخرجات OCR تقريبًا. وعلى نموذجين إنتاجيين لـ OCR، قللوا زمن التأخير في مرحلة التهيئة (prefill latency)، وتكلفة الحوسبة، واستهلاك الذاكرة بنسبة تزيد عن 40%، مع دفع ضريبة صغيرة فقط تتمثل في معالجة إضافية.
لماذا لا تعمل فكرة "ضغط الصورة فقط" في التعرف الضوئي على الحروف (OCR)
تُعد تقنية ضغط الرموز (Token compression) أسلوباً موجوداً بالفعل للنماذج اللغوية البصرية (VLMs) بشكل عام. إذا كنت تسأل النموذج "ما الذي يظهر في هذه الصورة"، فيمكنك بأمان التخلص من الكثير من التفاصيل البصرية. فزاوية ضبابية من السماء لا تزال تُعرف بوضوح على أنها سماء. النموذج لا يحتاج إلى كل بكسل للإجابة بشكل صحيح.
إلا أن التعرف الضوئي على الحروف (OCR) يكسر هذا الافتراض. فقد يكون رمز (Token) ضال واحد هو المكان الوحيد في الصورة الذي يحتوي فيه على نقطة عشرية، أو فوقية صغيرة، أو ختم باهت. إذا قمت بالضغط بشكل مفرط باستخدام طريقة مُصممة للفهم العام للصور، فلن تفقد تفاصيل الخلفية الغامضة فحسب، بل ستفقد الحرف الدقيق الذي يعتمد عليه المهمة بأكملها. يشير المؤلفون إلى ذلك مباشرة: قد تزيل طرق الضغط العامة "التفاصيل الدقيقة الحرجة للتعرف الضوئي على الحروف". هذه هي التوترية التي صُمم LayoutLite لحلها: تقليل عدد الرموز بشكل جذري، ولكن فقط تلك التي تمثل سعة فائضة، وليس الرموز الحاملة للمعلومات.
القيد الآخر الجدير بالتأمل هو التكلفة المعتادة لـ "تحليل التخطيط". الطريقة التقليدية لاكتشاف المناطق الفارغة في المستند هي تشغيل كاشف تخطيط صريح أولاً: نموذج منفصل يرسم مربعات حول الفقرات والجداول والترويسات قبل أن يبدأ التعرف الضوئي على الحروف حتى. هذا يعني نموذجاً إضافياً، ومرحلة استنتاج إضافية، وعاملاً إضافياً قد يكون خاطئاً. تتمثل فكرة LayoutLite في إجراء هذا التحليل ضمنياً، داخل خط الأنابيب الذي يعمل بالفعل، بدلاً من إضافة نظام ثانٍ.
كيف يعمل فعلياً: حارس يقف بين العينين والدماغ
تخيل خط أنابيب OCR-VLM القياسي في ثلاث مراحل: يقوم مُشفّر بصري بتحويل الصورة إلى رموز بصرية، ثم يقرأ مُفكك اللغة هذه الرموز ويخرج النص. يدخل LayoutLite في المنتصف، كحارس بوابات يقرر بشكل أساسي أي الرموز تستحق وقت المفكك.
بشكل ملموس، تحدث ثلاث أمور:
- إنه ينظر إلى أكثر من الطبقة الأخيرة. تبني المُشفّرات البصرية تمثيلات عبر طبقات متعددة، حيث تميل الطبقات اللاحقة إلى التخصص في الدلالات عالية المستوى، بينما تحتفظ الطبقات المبكرة بالتفاصيل المكانية الدقيقة. يجمع LayoutLite التمثيلات البصرية متعددة الطبقات بدلاً من قراءة المخرجات النهائية للمُشفّر فقط، لذا فهو يقيّم كل رمز مع أخذ السياق العام والإشارة الدقيقة في الاعتبار.
- إنه يقيّم كل رمز من حيث الأهمية. تقوم شبكة تقييم خفيفة الوزن، صغيرة بما يكفي لعدم محو المكاسب في السرعة التي تحاول تحقيقها، بتعيين درجة أهمية لكل رمز بصري. يتم التخلص من الرموز منخفضة الدرجات (الهوامش الفارغة، الخلفيات المتكررة، البقع الزائدة) قبل أن تصل إلى المفكك.
- إنه يحافظ على الخريطة حتى بعد اختفاء الرموز. هذه هي التفاصيل التي تجعل كل شيء يعمل: عند حذف رموز من وسط شبكة، تفقد عادةً تتبع أماكن الرموز الباقية. يحافظ LayoutLite صراحةً على المعلومات المكانية الأصلية للمواقع للرموز المحتفظ بها، لذا يعرف المفكك لا يزال أن هذه الكلمة كانت في خلية الجدول العلوية اليمنى رغم اختفاء ثلث الشبكة.
المخرجات هي تسلسل أقصر وأرخص من الرموز يُسلّم إلى المفكك، دون الحاجة إلى تشغيل نموذج كشف تخطيط منفصل مسبقاً.
الجزء الذكي هو كيفية تدريبه دون توثيق وثيقة واحدة
إليك المشكلة الأصعب التي يحلها البحث تحت الآلية المذكورة أعلاه: كيف تُعلّم شبكة التقييم أي الرموز "مهمة" عندما لم يقوم أحد بتوثيق ملايين الوثائق يدويًا بدرجات أهمية لكل رمز؟ هذه التسمية غير موجودة في أي مجموعة بيانات.
إجابتهم هي معالجة اختيار الرموز كمشكلة تعلم بالتعزيز بدلاً من مشكلة إشرافية. يتدرب النظام في التعلم بالتعزيز عبر المكافأة بدلاً من مطابقة إجابة موسومة: يجرب النموذج شيئًا ما، ويتم تقييمه بناءً على النتيجة، ثم يعدل. هنا، إشارة المكافأة هي اتساق مخرجات التعرف الضوئي على الحروف (OCR): هل يؤدي إسقاط هذه الرموز إلى تغيير ما ينسخه النموذج فعليًا؟ إذا تطابقت مخرجات التعرف الضوئي على الحروف قبل وبعد الضغط، تحصل الشبكة على مكافأة لهذا الاختيار للرموز التي تم إسقاطها. وإذا تأثرت الدقة سلبًا، تتعرض للعقاب.
طريقة التحسين المحددة هي تحسين السياسة النسبية للمجموعة (GRPO). بدلاً من تقييم محاولة واحدة مقابل هدف ثابت، يقارن GRPO مجموعة من خيارات اختيار الرموز المرشحة مع بعضها البعض ويعزز الأفضل ضمن تلك المجموعة. إنها نفس فئة التقنية الكامنة وراء التدريب الفعال الأخير للاستدلال في نماذج اللغة الكبيرة (LLM). وبحد ذاتها، كانت إشارة المكافأة هذه غير مستقرة بما يكفي لتحتاج إلى مساعدة، لذا يضيف المؤلفون إشارة إشرافية تخطيطية مساعدة لإبقاء التدريب على المسار الصحيح. وحتى هذه الإشارة لا تتطلب توثيقًا بشريًا؛ فهي أداة تدريب ثانوية وليست حقيقة أرضية موسومة يدويًا.
الفكرة هنا هي أن النظام بأكمله يتدرب من البيانات التي لديك بالفعل: الوثائق ونسخها الصحيحة. لا يدفع أحد الموثقين البشريين لرسم مربعات حول هوامش فارغة عبر مئة ألف وثيقة.
ماذا حدث فعلياً عند اختبارها
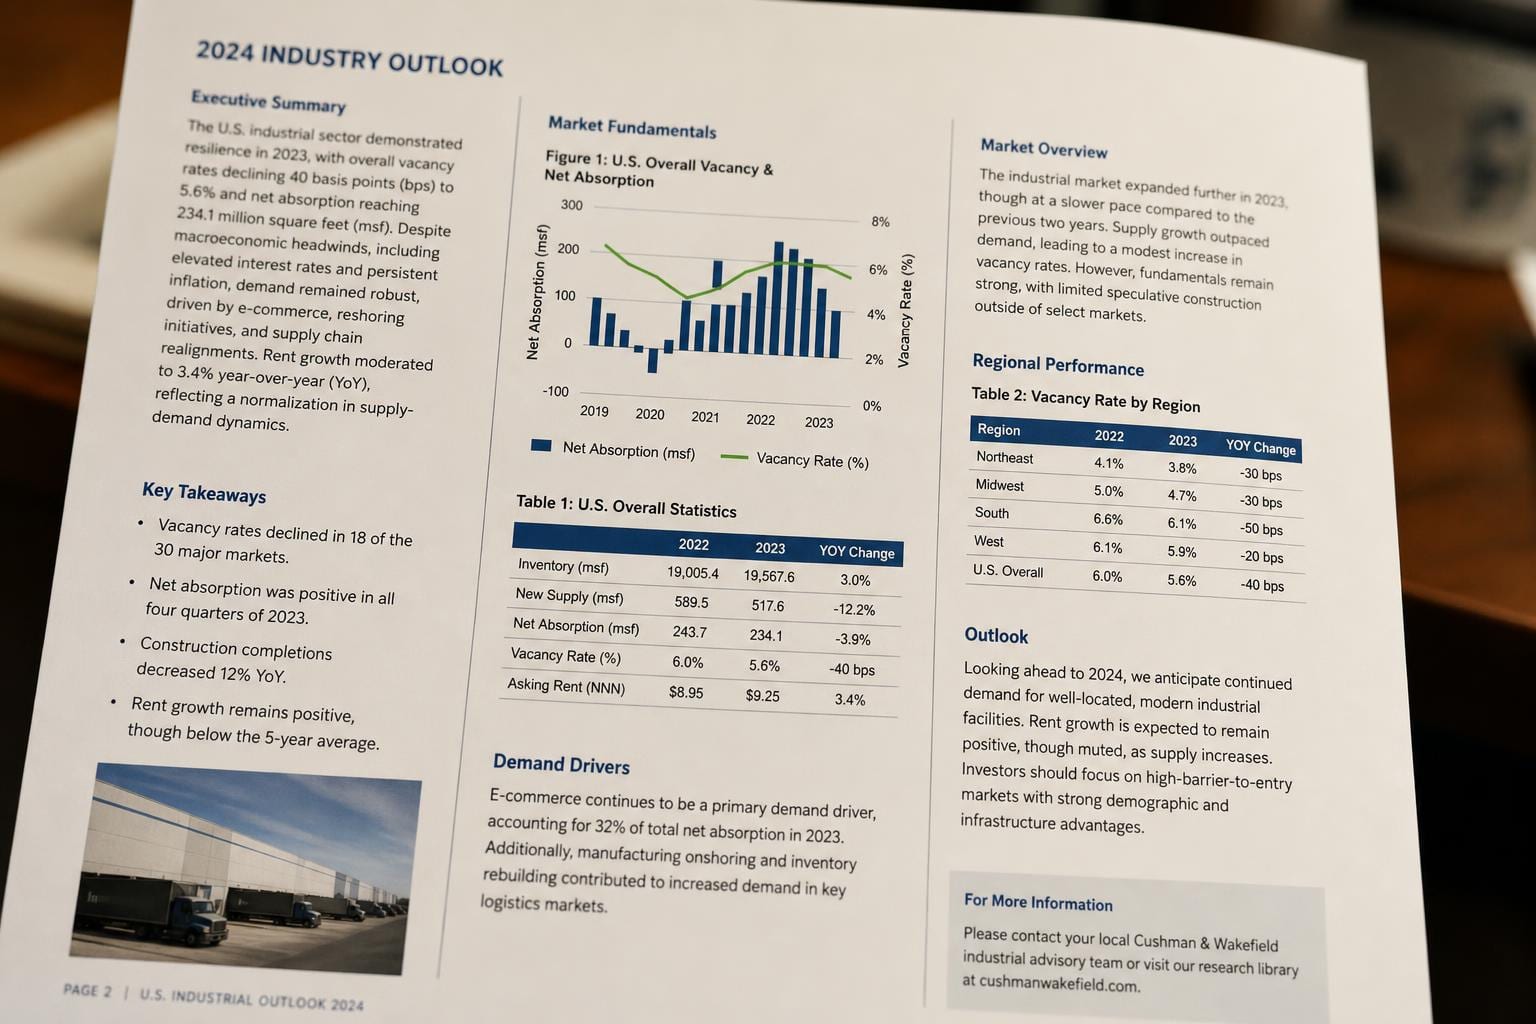
تم الإبلاغ عن النتائج على OmniDocBench، وهو معيار تقييم لتحليل المستندات عبر تخطيطات مختلطة (متعددة الأعمدة، جداول، نماذج). تبرز ادعاءان رئيسيان.
أولاً، على OmniDocBench، قللت LayoutLite بشكل كبير من طول الرموز البصرية (visual tokens) مع الحفاظ على جودة التعرف الضوئي على الحروف (OCR) دون تغيير جوهري. هذه هي النتيجة الرئيسية، وهي الأسهل للتكرار على معيار قمت ببناء منهجيتك حوله، لذا تعامل معها كحالة متفائلة، وليس كحد أقصى للأداء.
الاختبار الأكثر إثارة للاهتمام هو ما حدث عند إدخال LayoutLite في نموذجين للتعرف الضوئي على الحروف لم يتم تصميمهما خصيصاً لهذا الغرض، وهما FireRed-OCR و Logics-Parsing-V2، كوحدة قابلة للتوصيل والاستخدام الفوري (plug-and-play). تحت ضغط للرموز بنسبة تصل إلى 50% في كلا النموذجين:
- بقيت درجة التعرف شبه متطابقة مع خط الأساس غير المضغوط.
- انخفضت زمن الاستجابة المبدئي (Prefill latency)، وهو الوقت المستغرق في معالجة الإدخال قبل أن يبدأ النموذج في توليد المخرجات، بنسبة تزيد عن 40%.
- انخفضت عمليات FLOPs (عدد عمليات الحساب الخام) بنسبة تزيد عن 40%.
- انخفضت ذاكرة التخزين المؤقت لـ KV (KV cache memory)، وهي الذاكرة التي يستهلكها المحول (transformer) للاحتفاظ بالسياق أثناء التوليد، بنسبة تزيد عن 40%.
- أضافت شبكة التقييم نفسها "فقط عبئاً استنتاجياً إضافياً طفيفاً" فوق هذه الوفورات.
هذا مقايضة جيدة حقاً: نصف تكلفة الحساب مقابل خطأ إهمال في الدقة، وقد عملت على هيكلين مختلفين تم تدريبهما مسبقاً بدلاً من الهيكل الواحد الذي تم ضبط الطريقة عليه. قابلية النقل عبر الهياكل الأساسية هي الجزء الذي يقلقني أقل بشأن تحول هذه الطريقة إلى حيلة معيارية متخصصة.
لماذا يهمك هذا الأمر إذا كنت تبني أو تشتري نظام OCR
إذا كنت تشغّل نظام OCR بأي حجم حقيقي، فإن زمن استجابة التوليد المسبق (prefill latency) وذاكرة مخزن المفاتيح والقيم (KV cache) هما البنود التي تدفع ثمنها فعلياً. خط أنابيب معالجة المستندات الذي يستهلك آلاف ملفات PDF يومياً لا يواجه اختناقات بسبب تحسينات دقة النموذج من 98% إلى 98.5%، بل يواجه اختناقات بسبب عدد الصفحات التي يمكن لوحدة معالجة الرسومات (GPU) معالجتها في الثانية، وكمية الذاكرة التي تستهلكها كل طلب متزامن. خفض بنسبة 40%+ لكلٍ من هذين العاملين، بتكلفة دقة شبه معدومة، هو نوع التغيير الذي يظهر مباشرة في فاتورة الاستدلال (inference) الخاصة بك وفي الحد الأقصى لمعدل الإنتاجية لديك.
إطار العمل "الجاهز للعمل فوراً" (plug-and-play) مهم أيضاً، إذا ثبتت صحته خارج اختبارات هذه الورقة البحثية نفسها. وحدة تعمل كحلقة وصل بين مُشفّر بصري (vision encoder) وفكّاش (decoder) موجودين مسبقاً، بدلاً من إعادة تدريب النموذج من الصفر، هي الفرق بين "ورقة بحثية مثيرة للاهتمام" و"شيء تقدمه شركة فعلياً". حقيقة أنها عملت على نموذجين مختلفين ومتخصصين من نماذج اللغة البصرية (VLMs) المخصصة لـ OCR دون أن تكون مصممة خصيصاً لأي منهما، هي أقوى دليل في الورقة على أن هذه التقنية قابلة للتعميم بدلاً من الإفراط في التخصيص (overfitting) لخصائص معمارية واحدة. تجدر الإشارة إلى أن تعقيدات النصوص العربية، مثل طبيعتها المتصلة واتجاهها من اليمين إلى اليسار وأشكال الحروف السياقية، تجعل هذه التحسينات في الكفاءة أكثر إلحاحاً لنظم التعرف الضوئي على الحروف.
إذا كنت تقيّم محركات OCR بدلاً من بناء واحدة، فإن السؤال العملي الذي يطرحه هذا الأمر هو: أي من مقدمي الخدمات يقوم بالفعل بشيء مشابه تحت الغطاء، وأيهم لا يزال يحرق الرموز (tokens) على هوامش صفحاتك الفارغة؟ هذا ليس سؤالاً تجيب عليه هذه الورقة، لأنها ورقة بحثية وليست إعلاناً عن منتج، لكنه السؤال الصحيح الذي يجب أن تبدأ بطرحه على البائعين.
ما لا يزال غير مثبت
اختبار عمودين فقريين ومقياس واحد هو اختبار حقيقي، لكنه ليس كبيراً. يغطي OmniDocBench مجموعة من التخطيطات، لكنه لا يزال مقياساً واحداً، و"التدهور الضئيل" عند ضغط بنسبة 50% لا يخبرك بما يحدث عند 60% أو 70%, حيث يتوقف المنحنى عن أن يكون مسطحاً على الأرجح. لا يحدد الورق البحثي أين يقع هذا الانحدار الحاد.
هناك أيضاً فئة من المستندات يجب أن تواجه هذه الطريقة صعوبة أكبر معها مقارنة بغيرها: النماذج الكثيفة التي تحتوي على مساحة فارغة شبه معدومة، والجداول المكدسة بإحكام، أو الصفحات المكتوبة بخط اليد حيث تتداخل المناطق "المهمة" و"غير المهمة". الهوامش هي المكسب السهل. السؤال الأصعب هو ما يحدث في مستند يتكون 90% من الحبر، وهو أمر لا تتعمق فيه قسم النتائج.
إشارة التدريب، وهي اتساق مخرجات التعرف الضوئي على الحروف (OCR) المقاسة قبل وبعد الضغط، لا تكون جيدة إلا بقدر خط الأساس الخاص بنسخ النموذج نفسه. إذا كان النموذج الأساسي يقرأ بالفعل حرفاً باهتاً بشكل خاطئ، فلا يوجد للإشارة التعزيزية ما يصححه، لأن إسقاط الرمز القريب من تلك الخطأ لن يبدو وكأنه انتهاك للاتساق. هذه نقطة عمياء دقيقة في طريقة ذكية بشكل عام لتجاوز التسمية البشرية.
لا يمحو أي من ذلك النتيجة الأساسية. وحدة إضافية تقطع أكثر من 40% من التكلفة الحقيقية لتشغيل OCR للمستندات، دون الحاجة إلى مجموعة بيانات من التخطيطات الموسومة يدوياً ودون تأثير كبير على الدقة، هي قطعة هندسية مفيدة حقاً. سواء أصبحت ممارسة قياسية أم لا يعتمد على ما إذا كانت تصمد أمام المستندات الأكثر فوضوية وكثافة التي لم تدخل في مجموعة اختبار هذا الورق البحثي.