O Modelo de OCR Está Lendo Suas Margens em Branco, e É Por Isso Que Ele Está Lento
Baseado em: LayoutLite: Token-Level Implicit Layout Analysis for Efficient Document OCR — Xudong Liu, Bicheng Wan, Yulin Jin
LayoutLite: Análise de Layout Implícita em Nível de Token para OCR de Documentos Eficiente
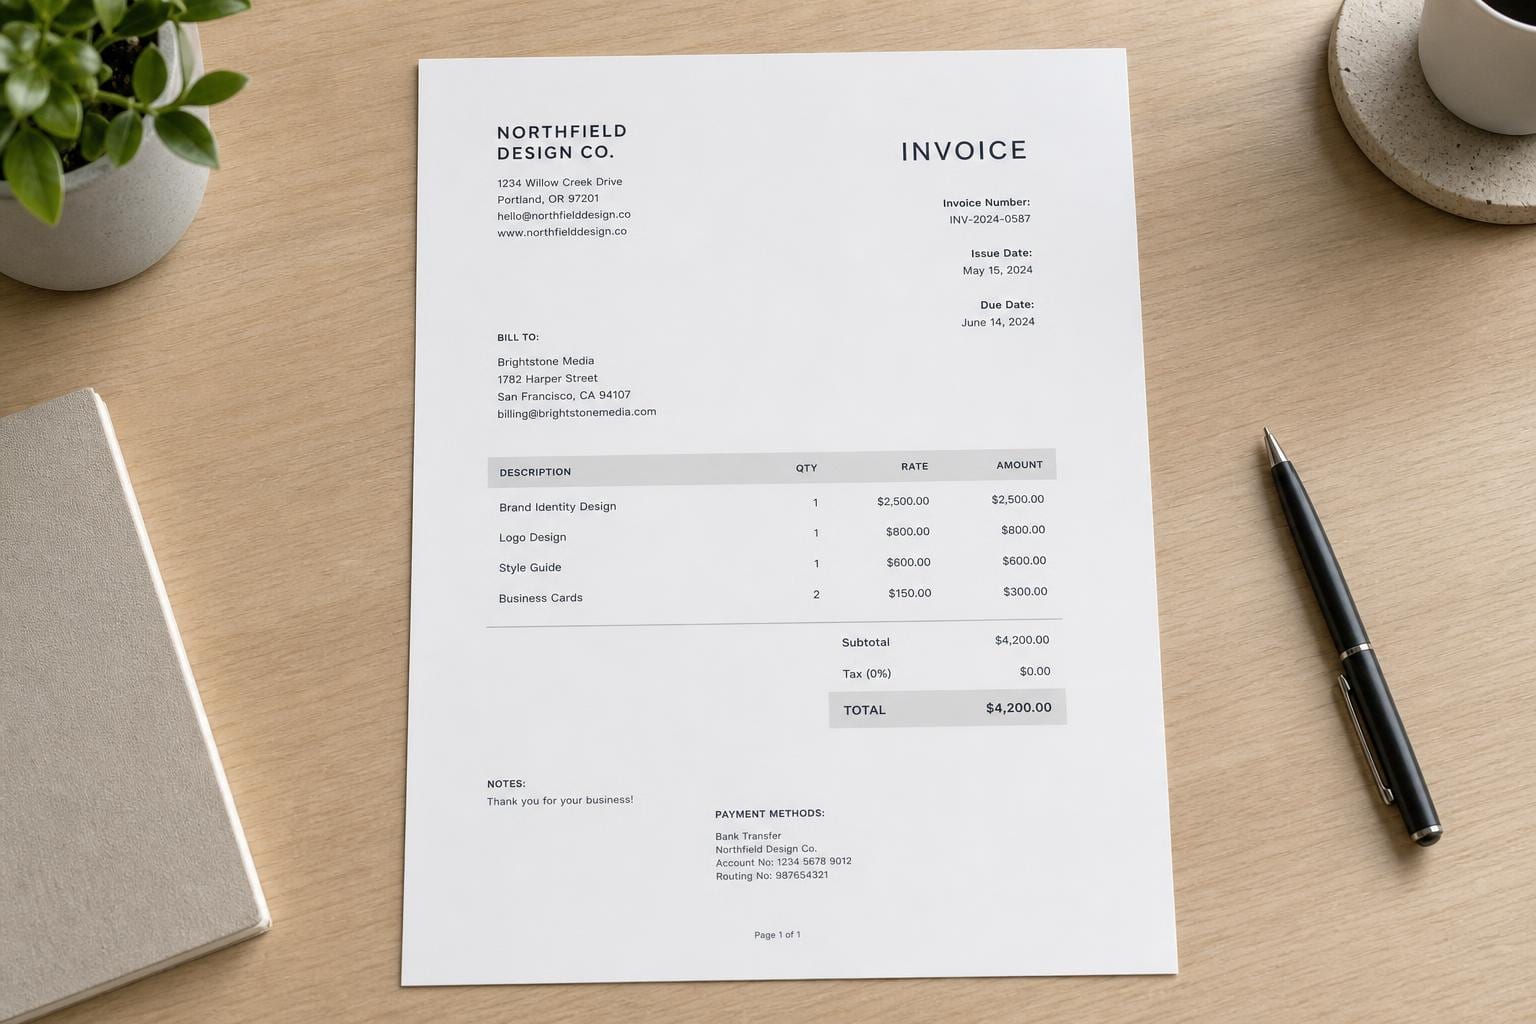
Abra qualquer fatura, recibo ou formulário digitalizado na sua mesa e observe-o do ponto de vista de uma máquina. Talvez um quinto do documento seja texto. O restante é espaço em branco: margens, lacunas entre os itens da linha, a metade vazia de uma caixa de assinatura. O olho humano ignora isso instantaneamente. Um modelo de visão-linguagem não. Ele divide a imagem inteira em uma grade de tokens, os pequenos blocos em que o modelo converte pixels antes de poder "pensar" sobre eles, e alimenta cada um deles, incluindo os patches em branco, em um decodificador de linguagem caro. Em um relatório denso com várias colunas, isso pode significar milhares de tokens gastos apenas descrevendo nada.
Esse desperdício é o alvo de um novo artigo, LayoutLite: Token-Level Implicit Layout Analysis for Efficient Document OCR, dos pesquisadores Xudong Liu, Bicheng Wan e Yulin Jin (publicado no arXiv em 24 de julho de 2026). A afirmação deles: é possível descartar até metade dos tokens visuais de uma imagem de documento antes que eles cheguem ao modelo de linguagem, e a saída do OCR praticamente não muda. Em dois modelos de OCR de nível de produção, eles reduziram a latência de pré-preenchimento, o custo computacional e o uso de memória em mais de 40%, com apenas um pequeno custo adicional pago em processamento extra.
Por que "apenas comprimir a imagem" não funciona para OCR
A compressão de tokens já existe como uma técnica para VLMs em geral. Se você está perguntando ao modelo "o que há nesta foto", pode descartar com segurança muitos detalhes visuais. Um canto desfocado do céu ainda é reconhecivelmente céu. O modelo não precisa de cada pixel para responder corretamente.
O OCR quebra essa suposição. Um único token perdido pode ser o único lugar na imagem onde um ponto decimal, um pequeno sobrescrito ou um carimbo fraco realmente reside. Comprimir com muita agressividade, usando um método construído para compreensão geral de imagens, e você não perde detalhes vagos do plano de fundo, você perde o caractere exato do qual toda a tarefa depende. Os autores destacam isso diretamente: métodos de compressão genéricos "podem remover detalhes finos críticos para o OCR". Essa é a tensão que o LayoutLite foi construído para resolver: reduzir agressivamente a contagem de tokens, mas apenas a contagem de tokens que é realmente capacidade ociosa, não os tokens que carregam informações.
A outra restrição que vale a pena considerar é o que a "análise de layout" geralmente custa. A maneira tradicional de encontrar regiões em branco em um documento é executar primeiro um detector de layout explícito: um modelo separado que desenha caixas ao redor de parágrafos, tabelas e cabeçalhos antes mesmo que o OCR comece. Isso é um modelo extra, uma passagem de inferência extra e mais uma coisa que pode estar errada. A proposta do LayoutLite é fazer essa análise implicitamente, dentro do pipeline que já está em execução, em vez de acoplar um segundo sistema.
Como funciona na prática: um segurança entre os olhos e o cérebro
Imagine o pipeline padrão de OCR-VLM em três etapas: um codificador visual transforma a imagem em tokens visuais, e um decodificador de linguagem lê esses tokens e gera o texto. O LayoutLite se insere nesse meio, atuando essencialmente como um segurança que decide quais tokens valem o tempo do decodificador.
Concretamente, três coisas acontecem:
- Ele analisa mais do que a última camada. Os codificadores visuais constroem representações em camadas, e as camadas posteriores tendem a se especializar em semântica de alto nível, enquanto as camadas iniciais retêm detalhes espaciais finos. O LayoutLite agrega representações visuais de múltiplas camadas, em vez de ler apenas a saída final do codificador, julgando cada token com o contexto geral e o sinal de grão fino em vista.
- Ele atribui uma pontuação de importância a cada token. Uma rede de pontuação leve, pequena o suficiente para não anular os ganhos de velocidade que busca criar, atribui a cada token visual uma pontuação de importância. Tokens com baixa pontuação (margens em branco, fundos repetidos, patches redundantes) são descartados antes de chegar ao decodificador.
- Ele mantém o mapa mesmo após os tokens desaparecerem. Este é o detalhe que faz tudo funcionar: ao excluir tokens do meio de uma grade, normalmente perde-se o controle de onde os tokens sobreviventes estavam posicionados. O LayoutLite preserva explicitamente a informação posicional espacial original dos tokens retidos, para que o decodificador ainda saiba que esta palavra estava na célula superior direita da tabela, mesmo que um terço da grade tenha desaparecido.
O resultado é uma sequência de tokens mais curta e econômica entregue ao decodificador, sem a necessidade de um modelo de detecção de layout separado ter sido executado primeiro.
A parte inteligente é como eles treinaram o modelo sem rotular um único documento
Aqui está o problema mais difícil que o artigo resolve por trás do mecanismo acima: como ensinar uma rede de pontuação quais tokens são "importantes" quando ninguém rotulou manualmente milhões de documentos com pontuações de importância por token? Esse rótulo não existe em nenhum conjunto de dados.
A resposta deles é tratar a seleção de tokens como um problema de aprendizado por reforço em vez de um problema supervisionado. O aprendizado por reforço treina um sistema por meio de recompensas, em vez de combinar uma resposta rotulada: o modelo tenta algo, recebe uma pontuação com base no resultado e faz ajustes. Aqui, o sinal de recompensa é a consistência da saída de OCR: a remoção desses tokens altera o que o modelo realmente transcreve? Se a saída de OCR antes e depois da compressão for igual, a rede é recompensada por essa escolha de tokens a serem descartados. Se a precisão cair, ela é penalizada.
O método de otimização específico é a otimização de política relativa por grupo (GRPO). Em vez de pontuar uma tentativa em relação a um alvo fixo, o GRPO compara um grupo de escolhas candidatas de seleção de tokens entre si e reforça as melhores dentro desse grupo. É a mesma classe de técnica por trás do treinamento recente de raciocínio eficiente em LLMs. Por si só, esse sinal de recompensa era aparentemente instável o suficiente para precisar de ajuda, então os autores adicionam um sinal de supervisão de layout auxiliar para manter o treinamento no caminho certo. Mesmo esse sinal não requer rotulação humana; é uma ferramenta de treinamento secundária, não uma verdade fundamental anotada manualmente.
A proposta aqui é que todo o sistema seja treinado a partir de dados que você já possui: documentos e suas transcrições corretas. Ninguém está pagando anotadores humanos para desenhar caixas em torno de margens em branco em cem mil documentos.
O que realmente aconteceu quando testaram
Os resultados são relatados no OmniDocBench, um benchmark para análise de documentos em layouts mistos (colunas múltiplas, tabelas, formulários). Duas afirmações se destacam.
Primeiro, no OmniDocBench, o LayoutLite reduziu substancialmente o comprimento dos tokens visuais, mantendo a qualidade do OCR essencialmente inalterada. Esse é o resultado principal e é o mais fácil de reproduzir em um benchmark construído em torno do seu próprio método, então trate-o como o cenário otimista, não como o limite máximo.
O teste mais interessante é o que aconteceu quando inseriram o LayoutLite em dois modelos de OCR para os quais ele não foi projetado, o FireRed-OCR e o Logics-Parsing-V2, como um módulo plug-and-play. Com até 50% de compressão de tokens em ambos os modelos:
- A pontuação de reconhecimento permaneceu quase a mesma que a linha de base sem compressão.
- A latência de pré-preenchimento (prefill), o tempo gasto processando a entrada antes do modelo começar a gerar a saída, caiu em mais de 40%.
- Os FLOPs (a contagem bruta de operações de computação) caíram em mais de 40%.
- A memória do cache KV, a memória que um transformer gasta retendo o contexto durante a geração, caiu em mais de 40%.
- A própria rede de pontuação adicionou "apenas um pequeno sobrecarga de inferência adicional" sobre essas economias.
Esse é um compromisso genuinamente bom: metade da computação por um erro de arredondamento na precisão, e funcionou em duas arquiteturas pré-treinadas diferentes, não apenas naquela em que o método foi ajustado. A portabilidade entre diferentes arquiteturas é o aspecto que menos me preocupa quanto a isso se tornar apenas um truque de nicho para benchmarks.
Por que isso importa se você está construindo ou comprando OCR
Se você está executando OCR em qualquer volume real, a latência de pré-preenchimento e a memória do cache KV são os itens de custo que você realmente paga. Um pipeline de processamento de documentos que ingere milhares de PDFs por dia não é limitado por melhorias de precisão do modelo de 98% para 98,5%. Ele é limitado pelo número de páginas por segundo que uma GPU pode processar e pela quantidade de memória que cada solicitação concorrente consome. Uma redução de mais de 40% em ambos, com custo de precisão próximo de zero, é o tipo de mudança que aparece diretamente na sua fatura de inferência e no seu limite de throughput.
A abordagem de plug-and-play também é importante, se se sustentar fora dos próprios testes deste artigo. Um módulo que se encaixa entre um codificador e decodificador de visão existentes, em vez de exigir o retreinamento de um modelo do zero, é a diferença entre "um artigo interessante" e "algo que um provedor realmente entrega". O fato de ter funcionado em dois VLMs especializados em OCR separados, sem ser construído especificamente para nenhum deles, é a evidência mais forte no artigo de que isso se generaliza, em vez de superajustar às peculiaridades de uma única arquitetura.
Se você está avaliando motores de OCR em vez de construir um, a pergunta prática que isso levanta é: quais provedores já estão fazendo algo assim nos bastidores e quais ainda estão gastando tokens nas suas margens em branco? Essa não é uma pergunta que este artigo responde, já que é um artigo de pesquisa, não um anúncio de produto, mas é a pergunta certa para começar a fazer aos fornecedores.
O que ainda está sem comprovação
Dois backbones e um benchmark constituem um teste real, mas não um teste extenso. O OmniDocBench abrange uma variedade de layouts, mas continua sendo apenas um benchmark, e a "degradação insignificante" em 50% de compressão não indica o que acontece em 60% ou 70%, onde a curva presumivelmente deixa de ser plana. O artigo não relata onde está esse ponto de ruptura.
Existe também uma categoria de documentos com os quais este método deveria, em princípio, ter mais dificuldade do que com outros: formulários densos com quase nenhum espaço em branco, tabelas compactas ou páginas manuscritas onde as regiões "importantes" e "não importantes" se confundem. As margens são a vitória fácil. O que acontece em um documento que é 90% tinta é uma questão mais difícil que a seção de resultados não aprofunda.
E o sinal de treinamento, a consistência da saída do OCR medida antes e depois da compressão, é tão bom quanto a própria linha de base de transcrição do modelo de OCR. Se o modelo subjacente já lê incorretamente um caractere fraco, o sinal de recompensa não tem nada para corrigir, já que remover o token perto desse erro não pareceria uma violação de consistência. Essa é uma falha sutil em uma maneira, de outra forma engenhosa, de contornar a anotação humana.
Nada disso apaga o resultado principal. Um módulo plug-in que reduz em mais de 40% o custo real de executar OCR de documentos, sem precisar de um conjunto de dados de layouts anotados manualmente e sem um impacto significativo na precisão, é uma peça de engenharia genuinamente útil. Se isso se tornará uma prática padrão depende de se sustenta nos documentos mais desordenados e densos que não entraram no conjunto de testes deste artigo.