OCR मॉडल आपके खाली मार्जिन पढ़ रहा है, और यही कारण है कि यह धीमा है
आधारित शोध-पत्र: LayoutLite: Token-Level Implicit Layout Analysis for Efficient Document OCR — Xudong Liu, Bicheng Wan, Yulin Jin
LayoutLite: दस्तावेज़ OCR के लिए टोकन-स्तर का अंतर्निहित लेआउट विश्लेषण
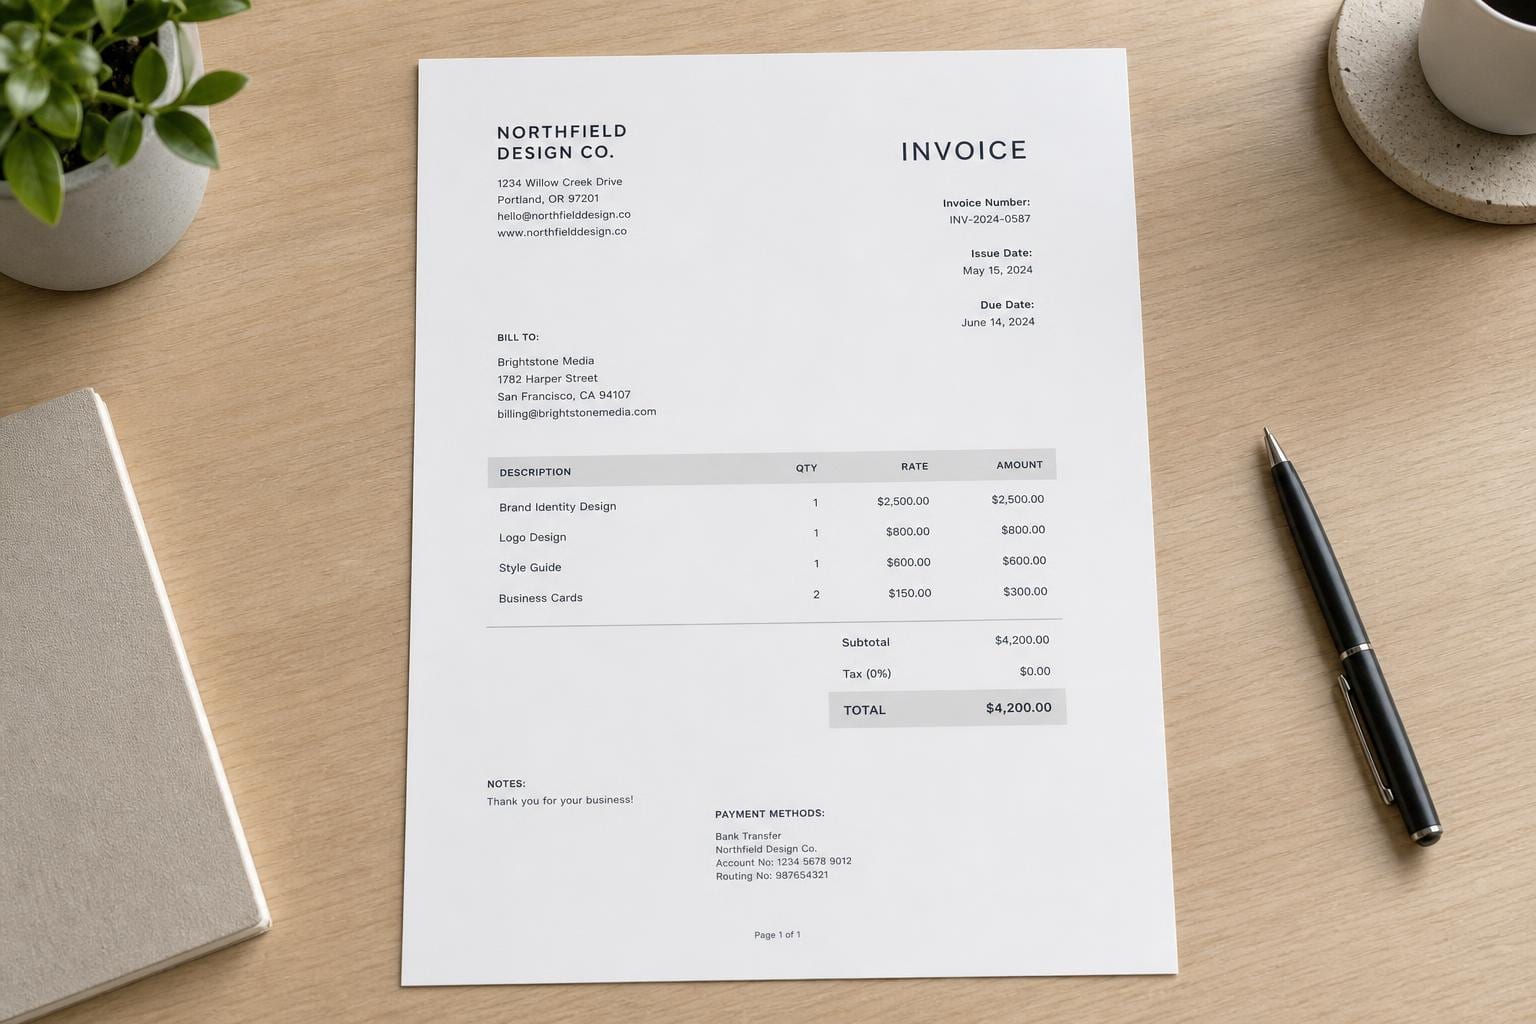
अपने डेस्क पर किसी भी इनवॉइस, रसीद या स्कैन किए गए फॉर्म को खोलें और उसे एक मशीन की तरह देखें। शायद इसका पाँचवाँ हिस्सा पाठ है। बाकी सब सफेद जगह है: मार्जिन, पंक्ति आइटमों के बीच की खाली जगह, हस्ताक्षर बॉक्स का खाली आधा हिस्सा। एक मानवीय आँख तुरंत इसे छोड़ देती है। एक विज़न-लैंग्वेज मॉडल ऐसा नहीं करता। यह पूरे इमेज को टोकन के ग्रिड में काटता है, जो छोटे टुकड़े हैं जिन्हें मॉडल उन्हें "सोचने" से पहले पिक्सेल में बदलता है, और हर एक टोकन को, खाली पैच सहित, एक महंगे लैंग्वेज डिकोडर में फीड करता है। एक घने मल्टी-कॉलम रिपोर्ट पर, इसका मतलब हो सकता है कि हजारों टोकन बस कुछ भी नहीं बताते हुए बर्बाद हो जाते हैं।
यह बर्बादी एक नई पेपर, LayoutLite: Token-Level Implicit Layout Analysis for Efficient Document OCR, का लक्ष्य है, जिसका लेखन शोधकर्ताओं Xudong Liu, Bicheng Wan, और Yulin Jin ने किया है (arXiv पर 24 जुलाई, 2026 को पोस्ट की गई)। उनका दावा है: आप दस्तावेज़ इमेज के दृश्य टोकन के आधे हिस्से को भाषा मॉडल तक पहुँचने से पहले ही फेंक सकते हैं, और OCR आउटपुट में बहुत कम बदलाव आता है। दो प्रोडक्शन-ग्रेड OCR मॉडल्स पर, उन्होंने प्रीफिल लेटेंसी, कंप्यूट लागत और मेमोरी उपयोग को 40% से अधिक कम किया, केवल थोड़े से अतिरिक्त प्रोसेसिंग के बदले में।
OCR के लिए "बस इमेज को कंप्रेस करो" क्यों काम नहीं करता
VLMs (विजुअल लैंग्वेज मॉडल्स) के लिए टोकन कंप्रेशन पहले से ही एक तकनीक के रूप में मौजूद है। यदि आप मॉडल से पूछ रहे हैं "इस फोटो में क्या है," तो आप सुरक्षित रूप से बहुत सारे विजुअल डिटेल को छोड़ सकते हैं। आसमान का धुंधला कोना पहचानने योग्य रूप से आसमान ही रहता है। सही उत्तर देने के लिए मॉडल को हर पिक्सेल की आवश्यकता नहीं होती।
OCR इस धारणा को तोड़ देता है। एक अकेला टोकन वह एकमात्र स्थान हो सकता है जहाँ दशमलव बिंदु, छोटा सुपरस्क्रिप्ट, या हल्का सा स्टाम्प वास्तव में मौजूद होता है। यदि आप सामान्य इमेज समझ के लिए बनाए गए किसी तरीके का उपयोग करके बहुत अधिक आक्रामकता से कंप्रेशन करते हैं, तो आपको अस्पष्ट बैकग्राउंड डिटेल नहीं, बल्कि वह सटीक कैरेक्टर खोना पड़ता है जिस पर पूरा कार्य निर्भर करता है। लेखक इसे सीधे तौर पर उठाते हैं: सामान्य कंप्रेशन विधियाँ "OCR-क्रिटिकल फाइन-ग्रेन्डेड डिटेल को हटा सकती हैं।" यही वह तनाव है जिसका समाधान LayoutLite करने के लिए बनाया गया है: टोकन काउंट को आक्रामकता से कटौती करें, लेकिन केवल वही टोकन जो वास्तव में अतिरिक्त क्षमता हैं, न कि वे टोकन जो जानकारी वहन कर रहे हैं।
दूसरा प्रतिबंध जिस पर विचार करना चाहिए, वह है "लेआउट एनालिसिस" की आमतौर पर लागत। दस्तावेज़ में खाली क्षेत्रों को खोजने का पारंपरिक तरीका पहले एक स्पष्ट लेआउट डिटेक्टर चलाना है: एक अलग मॉडल जो OCR शुरू होने से पहले पैराग्राफ, टेबल और हेडर के चारों ओर बॉक्स बनाता है। यह एक अतिरिक्त मॉडल, एक अतिरिक्त इनफरेंस पास, और एक अतिरिक्त चीज़ है जो गलत हो सकती है। LayoutLite का प्रस्ताव है कि यह एनालिसिस को निहित रूप से (implicitly), उस पाइपलाइन के अंदर किया जाए जो पहले से ही चल रही है, बजाय इसके कि दूसरे सिस्टम को जोड़ा जाए।
यह वास्तव में कैसे काम करता है: आंखों और मस्तिष्क के बीच खड़ा एक बॉन्सर
मानक OCR-VLM पाइपलाइन को तीन चरणों में कल्पना करें: एक विज़न एन्कोडर छवि को विज़ुअल टोकन में बदलता है, और एक लैंग्वेज डिकोडर उन टोकन को पढ़कर टेक्स्ट लिखता है। LayoutLite अपने आप को बीच में डाल देता है, जो मूल रूप से एक बॉन्सर की तरह काम करता है जो यह तय करता है कि कौन से टोकन डिकोडर के समय के लायक हैं।
वास्तव में, तीन चीजें होती हैं:
- यह केवल आखिरी लेयर पर नज़र नहीं डालता। विज़न एन्कोडर लेयर्स में रिप्रेजेंटेशन बनाते हैं, और बाद की लेयर्स आमतौर पर हाई-लेवल सेमैंटिक्स में विशेषज्ञ होती हैं जबकि शुरुआती लेयर्स बारीक स्पेशियल डिटेल को बरकरार रखती हैं। LayoutLite एन्कोडर के अंतिम आउटपुट को केवल पढ़ने के बजाय मल्टी-लेयर विज़ुअल रिप्रेजेंटेशन को एग्रीगेट करता है, इसलिए यह प्रत्येक टोकन का आकलन बड़े-चित्र संदर्भ और बारीक-सूई संकेत दोनों को ध्यान में रखकर करता है।
- यह प्रत्येक टोकन के लिए महत्व का स्कोर देता है। एक लाइटवेट स्कोरिंग नेटवर्क, जो इतना छोटा है कि यह उस गति लाभ को मिटा न दे जिसकी यह कोशिश कर रहा है, प्रत्येक विज़ुअल टोकन को एक महत्व स्कोर देता है। कम स्कोर वाले टोकन (खाली मार्जिन, दोहराया गया बैकग्राउंड, अनावश्यक पैच) डिकोडर तक पहुंचने से पहले ही ड्रॉप कर दिए जाते हैं।
- यह टोकन गायब होने के बाद भी मैप को बनाए रखता है। यह वह विवरण है जो पूरी चीज़ को काम करने में सक्षम बनाता है: जब आप ग्रिड के मध्य से टोकन हटाते हैं, तो आप आमतौर पर यह खो देते हैं कि बचे हुए टोकन कहाँ स्थित थे। LayoutLite संरक्षित टोकन के मूल स्पेशियल पोजिशनल इन्फॉर्मेशन को स्पष्ट रूप से संरक्षित करता है, इसलिए डिकोडर को अभी भी पता चलता है कि यह शब्द ऊपरी-दाएं टेबल सेल में था, भले ही ग्रिड का एक-तिहाई हिस्सा गायब हो गया हो।
आउटपुट टोकन की एक छोटी और सस्ती सीक्वेंस है जो डिकोडर को दी जाती है, बिना पहले किसी अलग लेआउट-डिटेक्शन मॉडल को चलाने की आवश्यकता के।
चालाकी यह है कि उन्होंने इसे एक भी दस्तावेज़ को लेबल किए बिना कैसे ट्रेन किया
यहाँ वह कठिन समस्या है जो पेपर ऊपर बताए गए मैकेनिज़्म के नीचे हल कर रहा है: आप एक स्कोरिंग नेटवर्क को कैसे सिखाते हैं कि कौन से टोकन "महत्वपूर्ण" हैं, जब किसी ने भी प्रति-टोकन महत्व स्कोर के साथ लाखों दस्तावेज़ों को हाथ से लेबल नहीं किया है? वह लेबल किसी भी डेटासेट में मौजूद नहीं है।
उनका उत्तर टोकन चयन को एक सपरवाइज़्ड प्रॉब्लम के बजाय एक रिनफोर्समेंट लर्निंग प्रॉब्लम के रूप में लेना है। रिनफोर्समेंट लर्निंग एक लेबल किए गए उत्तर से मिलान करने के बजाय इनाम द्वारा एक सिस्टम को ट्रेन करता है: मॉडल कुछ को आज़माता है, परिणाम पर स्कोर प्राप्त करता है, और समायोजन करता है। यहाँ, रिवॉर्ड सिग्नल OCR आउटपुट स्थिरता है: क्या इन टोकन को छोड़ने से मॉडल द्वारा वास्तव में ट्रांसक्राइब किए गए टेक्स्ट में बदलाव आता है? यदि संपीड़न से पहले और बाद का OCR आउटपुट मेल खाता है, तो नेटवर्क को टोकन छोड़ने के उस चयन के लिए इनाम मिलता है। यदि सटीकता प्रभावित होती है, तो उसे दंडित किया जाता है।
विशिष्ट ऑप्टिमाइज़ेशन विधि ग्रुप-रिलेटिव पॉलिसी ऑप्टिमाइज़ेशन (GRPO) है। किसी निश्चित लक्ष्य के खिलाफ एक प्रयास को स्कोर करने के बजाय, GRPO उम्मीदवार टोकन-चयन विकल्पों के एक समूह की तुलना एक-दूसरे से करता है और उस समूह के भीतर बेहतर विकल्पों को मजबूत करता है। यह तकनीक का वही वर्ग है जो हाल के कुशल LLM रीज़निंग ट्रेनिंग के पीछे है। अपने आप में, यह रिवॉर्ड सिग्नल इतना अस्थिर था कि उसे मदद की आवश्यकता थी, इसलिए लेखकों ने ट्रेनिंग को ट्रैक पर रखने के लिए एक सहायक लेआउट सपरविज़न सिग्नल जोड़ा। उस सिग्नल के लिए भी मानवीय लेबलिंग की आवश्यकता नहीं है; यह एक द्वितीयक ट्रेनिंग सहायक है, हाथ से एनोटेट की गई ग्राउंड ट्रूथ नहीं।
यहाँ पेशकश यह है कि पूरा सिस्टम उस डेटा से ट्रेन होता है जो आपके पास पहले से है: दस्तावेज़ और उनके सही ट्रांसक्रिप्शन। कोई भी मानवीय एनोटेटर्स को एक लाख दस्तावेज़ों में खाली मार्जिन के चारों ओर बॉक्स खींचने के लिए भुगतान नहीं कर रहा है।
जब उन्होंने इसे परखा तो वास्तव में क्या हुआ
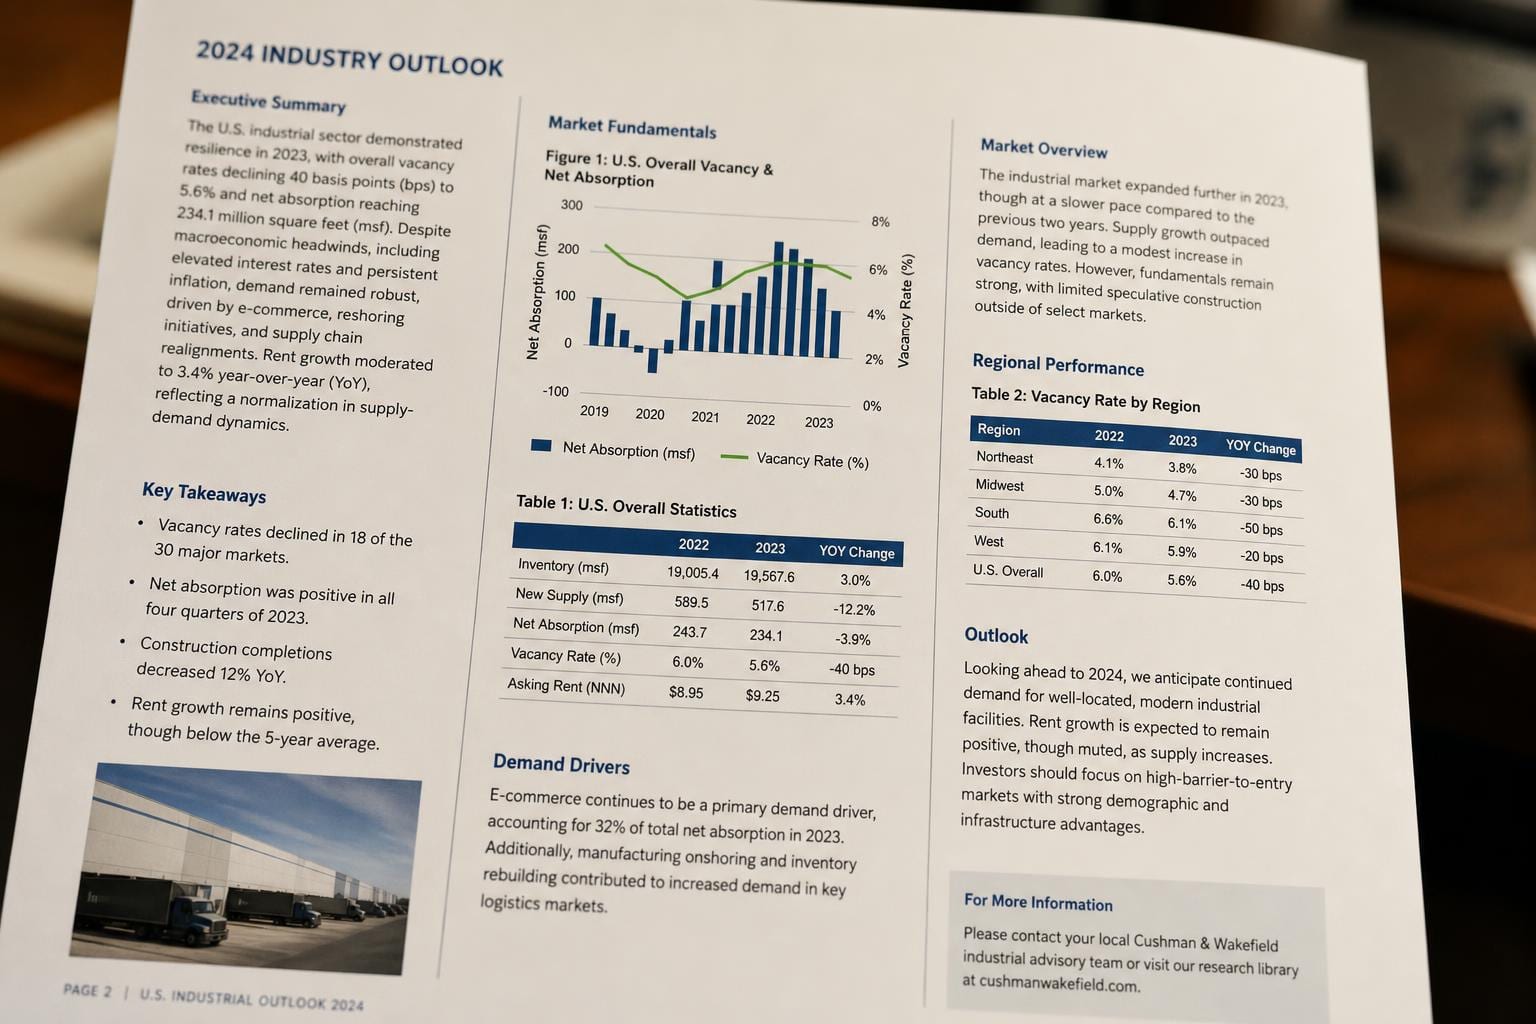
परिणाम OmniDocBench पर रिपोर्ट किए गए हैं, जो मिश्रित लेआउट (बहु-स्तंभ, तालिकाएं, फॉर्म) में दस्तावेज़ पार्सिंग के लिए एक बेंचमार्क है। दो दावे उभरकर सामने आते हैं।
पहला, OmniDocBench पर, LayoutLite ने दृश्य टोकन की लंबाई में उल्लेखनीय कमी की जबकि OCR गुणवत्ता को मूल रूप से अप्रभावित छोड़ दिया। यह मुख्य परिणाम है, और यह उस बेंचमार्क पर दोहराने में आसान है जिसके इर्द-गिर्द आपने अपना विधि विकसित की थी, इसलिए इसे आशावादी स्थिति के रूप में देखें, न कि ऊपरी सीमा के रूप में।
और भी दिलचस्प परीक्षण यह था कि जब उन्होंने LayoutLite को दो OCR मॉडलों में ड्रॉप किया जिनके इर्द-गिर्द इसका डिज़ाइन नहीं किया गया था, FireRed-OCR और Logics-Parsing-V2, एक प्लग-एंड-प्ले मॉड्यूल के रूप में। दोनों मॉडलों पर 50% तक टोकन संपीड़न के तहत:
- पहचान स्कोर लगभग वही रहा जो असंपीडित बेसलाइन था।
- प्रीफिल लेटेंसी, जो मॉडल आउटपुट जनरेट करना शुरू करने से पहले इनपुट प्रोसेस करने में बिताया गया समय है, 40% से अधिक गिर गया।
- FLOPs (कच्ची कंप्यूटिंग ऑपरेशन गिनती) 40% से अधिक गिर गए।
- KV कैश मेमोरी, जो एक ट्रांसफॉर्मर संदर्भ को बनाए रखने में खर्च करता है जैसे वह जनरेट करता है, 40% से अधिक गिर गई।
- स्कोरिंग नेटवर्क ने स्वयं उन बचतों के ऊपर "केवल थोड़ा अतिरिक्त अनुमान ओवरहेड" जोड़ा।
यह वास्तव में एक अच्छा समझौता है: सटीकता में एक राउंडिंग एरर के लिए आधी कंप्यूटिंग, और यह दो अलग-अलग प्री-ट्रेनड बैकबोन्स पर काम किया न कि केवल उस एक पर जिस पर विधि को ट्यून किया गया था। बैकबोन्स के बीच पोर्टेबिलिटी वह हिस्सा है जिसके बारे में मुझे इसकी एक निश्चित बेंचमार्क ट्रिक बनने की सबसे कम चिंता होगी।
यदि आप OCR बना रहे हैं या खरीद रहे हैं, तो यह क्यों मायने रखता है
यदि आप किसी वास्तविक मात्रा में OCR चला रहे हैं, तो prefill latency और KV cache memory वे line items हैं जिनके लिए आप वास्तव में भुगतान करते हैं। एक document-processing pipeline जो प्रतिदिन हज़ारों PDFs को ingest करता है, उसकी गलती model accuracy में 98% से 98.5% की सुधार में नहीं है। इसकी गलती इस बात में है कि एक GPU प्रति सेकंड कितनी pages को process कर सकता है, और प्रत्येक concurrent request कितनी memory खाता है। इन दोनों में 40%+ की कटौती, लगभग शून्य accuracy cost के साथ, वह बदलाव है जो सीधे आपके inference bill और throughput ceiling में दिखाई देता है।
Plug-and-play framing भी मायने रखता है, यदि यह इस paper के अपने tests के बाहर भी टिकता है। एक module जो एक मौजूदा vision encoder और decoder के बीच बैठता है, बजाय इसके कि एक model को शुरू से retrain करने की आवश्यकता हो, यह "एक दिलचस्प paper" और "कुछ ऐसा जो एक provider वास्तव में ship करता है" के बीच का अंतर है। यह तथ्य कि यह दो अलग-अलग specialized OCR VLMs पर काम किया बिना किसी के लिए purpose-built किए जाने के, इस paper में सबसे मजबूत सबूत है कि यह generalize करता है बजाय एक architecture की quirks के लिए overfitting करने के।
यदि आप एक OCR engine बना रहे हैं बजाय इसके कि एक बना रहे हैं, तो इससे उठने वाला practical सवाल यह है: कौन से providers पहले से ही इसके तहत कुछ ऐसा कर रहे हैं, और कौन से अभी भी आपके blank margins पर tokens जला रहे हैं? यह सवाल इस paper द्वारा उत्तरित नहीं किया जाता, क्योंकि यह एक research paper है, एक product announcement नहीं, लेकिन यह सही सवाल है जो vendors को पूछना शुरू करना चाहिए। मजबूत English OCR का मतलब यह नहीं है कि Devanagari OCR भी उतना ही अच्छा है; अक्सर Devanagari script की जटिलताओं जैसे stacked conjuncts, matras, और shirorekha headline को सही ढंग से process करना एक अलग चुनौती है।
अभी भी क्या साबित नहीं हुआ है
दो बैकबोन और एक बेचमार्क एक वास्तविक परीक्षण है, लेकिन यह बड़ा नहीं है। OmniDocBench लेआउट्स की एक श्रृंखला को कवर करता है, लेकिन यह अभी भी एक बेचमार्क है, और 50% संपीड़न पर "नगण्य गिरावट" आपको यह नहीं बताती कि 60% या 70% पर क्या होता है, जहां वक्र संभवतः समतल नहीं रहता है। पेपर यह नहीं बताता कि वह क्लिफ कहाँ है।
इस विधि के लिए दस्तावेजों की एक श्रेणी भी है जिसमें सिद्धांत रूप में अन्य की तुलना में अधिक संघर्ष करना चाहिए: घने फॉर्म जिनमें लगभग कोई खाली जगह नहीं है, कसकर पैक किए गए तालिकाएं, या हाथ से लिखे गए पृष्ठ जहां "महत्वपूर्ण" और "अमहत्वपूर्ण" क्षेत्र एक दूसरे में मिल जाते हैं। मार्जिन आसान जीत हैं। एक ऐसे दस्तावेज पर क्या होता है जो 90% स्याही से भरा है, यह एक कठिन प्रश्न है जिसमें परिणाम खंड में गहराई से खोदा नहीं गया है।
और प्रशिक्षण संकेत, संपीड़न से पहले और बाद में मापा गया OCR आउटपुट सुसंगतता, केवल OCR मॉडल के अपने ट्रांसक्रिप्शन बेसलाइन के रूप में अच्छा है। यदि अंतर्निहित मॉडल पहले से ही एक धुंधले अक्षर को गलत पढ़ता है, तो इनाम संकेत के पास सुधार करने के लिए कुछ नहीं है, क्योंकि उस त्रुटि के पास टोकन को छोड़ना सुसंगतता उल्लंघन की तरह नहीं दिखेगा। मानव एनोटेशन से बचने के अन्यथा चतुर तरीके में यह एक सूक्ष्म अंधा धब्बा है।
इनमें से कोई भी मुख्य परिणाम को मिटाता नहीं है। एक प्लग-इन मॉड्यूल जो दस्तावेज़ OCR चलाने की वास्तविक लागत से 40%+ काटता है, बिना किसी हाथ से लेबल किए गए लेआउट्स के डेटासेट की आवश्यकता के और सटीकता पर कोई महत्वपूर्ण प्रभाव डाले बिना, इंजीनियरिंग का एक वास्तव में उपयोगी टुकड़ा है। क्या यह मानक अभ्यास बनता है, इस बात पर निर्भर करता है कि क्या यह उन गंदे, घने दस्तावेजों पर खड़ा रहता है जो इस पेपर के परीक्षण सेट में शामिल नहीं थे।