El modelo OCR está leyendo tus márgenes en blanco, y esa es la razón por la que es lento
Basado en: LayoutLite: Token-Level Implicit Layout Analysis for Efficient Document OCR — Xudong Liu, Bicheng Wan, Yulin Jin
LayoutLite: Análisis implícito de diseño a nivel de token para OCR de documentos eficiente
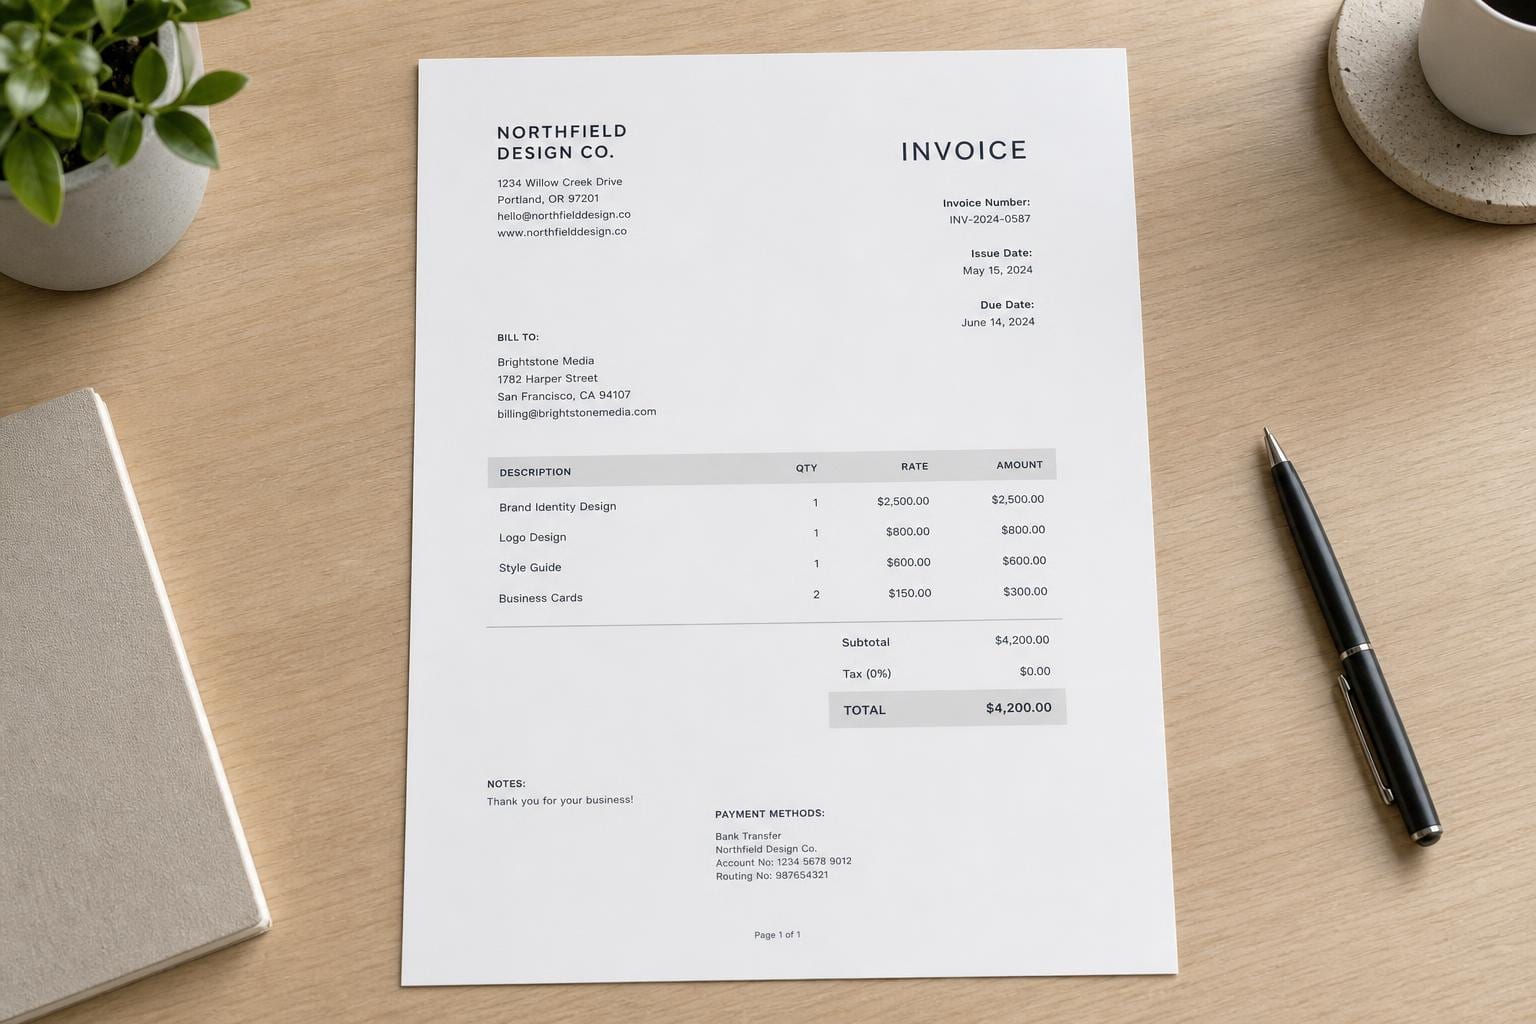
Abra cualquier factura, recibo o formulario escaneado que tenga en su escritorio y mírelo como lo haría una máquina. Quizás una quinta parte sea texto. El resto es espacio en blanco: márgenes, huecos entre líneas de detalle, la mitad vacía de un cuadro de firma. El ojo humano lo salta al instante. Un modelo de visión y lenguaje no. Divide toda la imagen en una cuadrícula de tokens, los pequeños fragmentos en los que un modelo convierte los píxeles antes de poder "pensar" sobre ellos, y alimenta cada uno de ellos, incluidas las zonas vacías, en un decodificador de lenguaje costoso. En un informe denso de varias columnas, eso puede significar miles de tokens gastados en describir la nada.
Ese desperdicio es el objetivo de un nuevo artículo, LayoutLite: Token-Level Implicit Layout Analysis for Efficient Document OCR, de los investigadores Xudong Liu, Bicheng Wan y Yulin Jin (publicado en arXiv el 24 de julio de 2026). Su afirmación: puede descartar hasta la mitad de los tokens visuales de una imagen de documento antes de que lleguen al modelo de lenguaje, y la salida del OCR apenas cambia. En dos modelos de OCR de grado de producción, redujeron la latencia de prellenado, el costo computacional y el uso de memoria en más de un 40%, con solo un pequeño costo adicional en procesamiento posterior.
Por qué "solo comprimir la imagen" no funciona para OCR
La compresión de tokens ya existe como una técnica para los VLMs en general. Si le preguntas a un modelo "qué hay en esta foto", puedes descartar con seguridad gran parte del detalle visual. Una esquina borrosa del cielo sigue siendo reconocible como cielo. El modelo no necesita cada píxel para responder correctamente.
El OCR rompe esa suposición. Un único token errante podría ser el único lugar en la imagen donde reside un punto decimal, un pequeño superíndice o un sello difuminado. Si se comprime de forma demasiado agresiva, utilizando un método diseñado para la comprensión general de imágenes, no se pierde detalle de fondo vago, sino el carácter exacto del que depende toda la tarea. Los autores lo señalan directamente: los métodos de compresión genéricos "pueden eliminar detalles finos críticos para el OCR". Esa es la tensión que LayoutLite está diseñado para resolver: reducir agresivamente la cantidad de tokens, pero solo los tokens que son capacidad de sobra, no los que transportan información.
La otra restricción que vale la pena considerar es lo que suele costar el "análisis de diseño". La forma tradicional de encontrar regiones en blanco en un documento es ejecutar primero un detector de diseño explícito: un modelo separado que dibuja cajas alrededor de párrafos, tablas y encabezados antes de que comience el OCR. Eso implica un modelo adicional, una pasada de inferencia adicional y otra cosa que puede fallar. La propuesta de LayoutLite es realizar este análisis de forma implícita, dentro de la tubería que ya se está ejecutando, en lugar de añadir un segundo sistema.
Cómo funciona realmente: un portero entre los ojos y el cerebro
Imagina la tubería estándar de OCR-VLM en tres etapas: un codificador visual convierte la imagen en tokens visuales, y un decodificador de lenguaje lee esos tokens y escribe el texto. LayoutLite se inserta en medio, actuando esencialmente como un portero que decide qué tokens merecen la atención del decodificador.
Concretamente, ocurren tres cosas:
- Observa más allá de la última capa. Los codificadores visuales construyen representaciones en capas; las capas posteriores tienden a especializarse en semántica de alto nivel, mientras que las capas anteriores conservan detalles espaciales finos. LayoutLite agrega representaciones visuales de múltiples capas en lugar de leer solo la salida final del codificador, por lo que evalúa cada token teniendo en cuenta tanto el contexto general como la señal de grano fino.
- Asigna una puntuación de importancia a cada token. Una red de puntuación ligera, lo suficientemente pequeña como para no anular las ganancias de velocidad que intenta crear, asigna a cada token visual una puntuación de importancia. Los tokens con baja puntuación (márgenes en blanco, fondos repetidos, parches redundantes) se eliminan antes de llegar al decodificador.
- Mantiene el mapa incluso después de que los tokens desaparezcan. Este es el detalle que hace que todo funcione: cuando eliminas tokens del medio de una cuadrícula, normalmente pierdes el rastro de dónde estaban ubicados los tokens supervivientes. LayoutLite preserva explícitamente la información posicional espacial original de los tokens retenidos, por lo que el decodificador sigue sabiendo que esta palabra estaba en la celda superior derecha de la tabla, aunque un tercio de la cuadrícula haya desaparecido.
El resultado es una secuencia de tokens más corta y económica que se entrega al decodificador, sin necesidad de que un modelo de detección de diseño separado se haya ejecutado previamente.
La parte ingeniosa es cómo lo entrenaron sin etiquetar ni un solo documento
Aquí está el problema más difícil que el artículo resuelve bajo el mecanismo anterior: ¿cómo enseñas a una red de puntuación qué tokens son "importantes" cuando nadie ha etiquetado manualmente millones de documentos con puntuaciones de importancia por token? Esa etiqueta no existe en ningún conjunto de datos.
Su respuesta es tratar la selección de tokens como un problema de aprendizaje por refuerzo en lugar de uno supervisado. El aprendizaje por refuerzo entrena un sistema mediante recompensas en lugar de hacer coincidir una respuesta etiquetada: el modelo intenta algo, recibe una puntuación sobre el resultado y se ajusta. Aquí, la señal de recompensa es la consistencia de la salida de OCR: ¿cambia la eliminación de estos tokens lo que el modelo realmente transcribe? Si la salida de OCR antes y después de la compresión coincide, la red recibe una recompensa por esa elección de tokens a eliminar. Si la precisión se ve afectada, recibe un castigo.
El método de optimización específico es la optimización de política relativa por grupos (GRPO). En lugar de puntuar un intento contra algún objetivo fijo, GRPO compara un grupo de elecciones candidatas de selección de tokens entre sí y refuerza las mejores dentro de ese grupo. Es la misma clase de técnica detrás del entrenamiento de razonamiento de LLM eficiente reciente. Por sí solo, esta señal de recompensa fue aparentemente inestable suficiente como para necesitar ayuda, por lo que los autores añaden una señal de supervisión de diseño auxiliar para mantener el entrenamiento en el camino. Incluso esa señal no requiere etiquetado humano; es una ayuda de entrenamiento secundaria, no una verdad fundamental anotada a mano.
La propuesta aquí es que todo el sistema se entrena a partir de datos que ya tienes: documentos y sus transcripciones correctas. Nadie está pagando a anotadores humanos para dibujar cajas alrededor de márgenes en blanco en cien mil documentos.
Qué ocurrió realmente cuando lo probaron
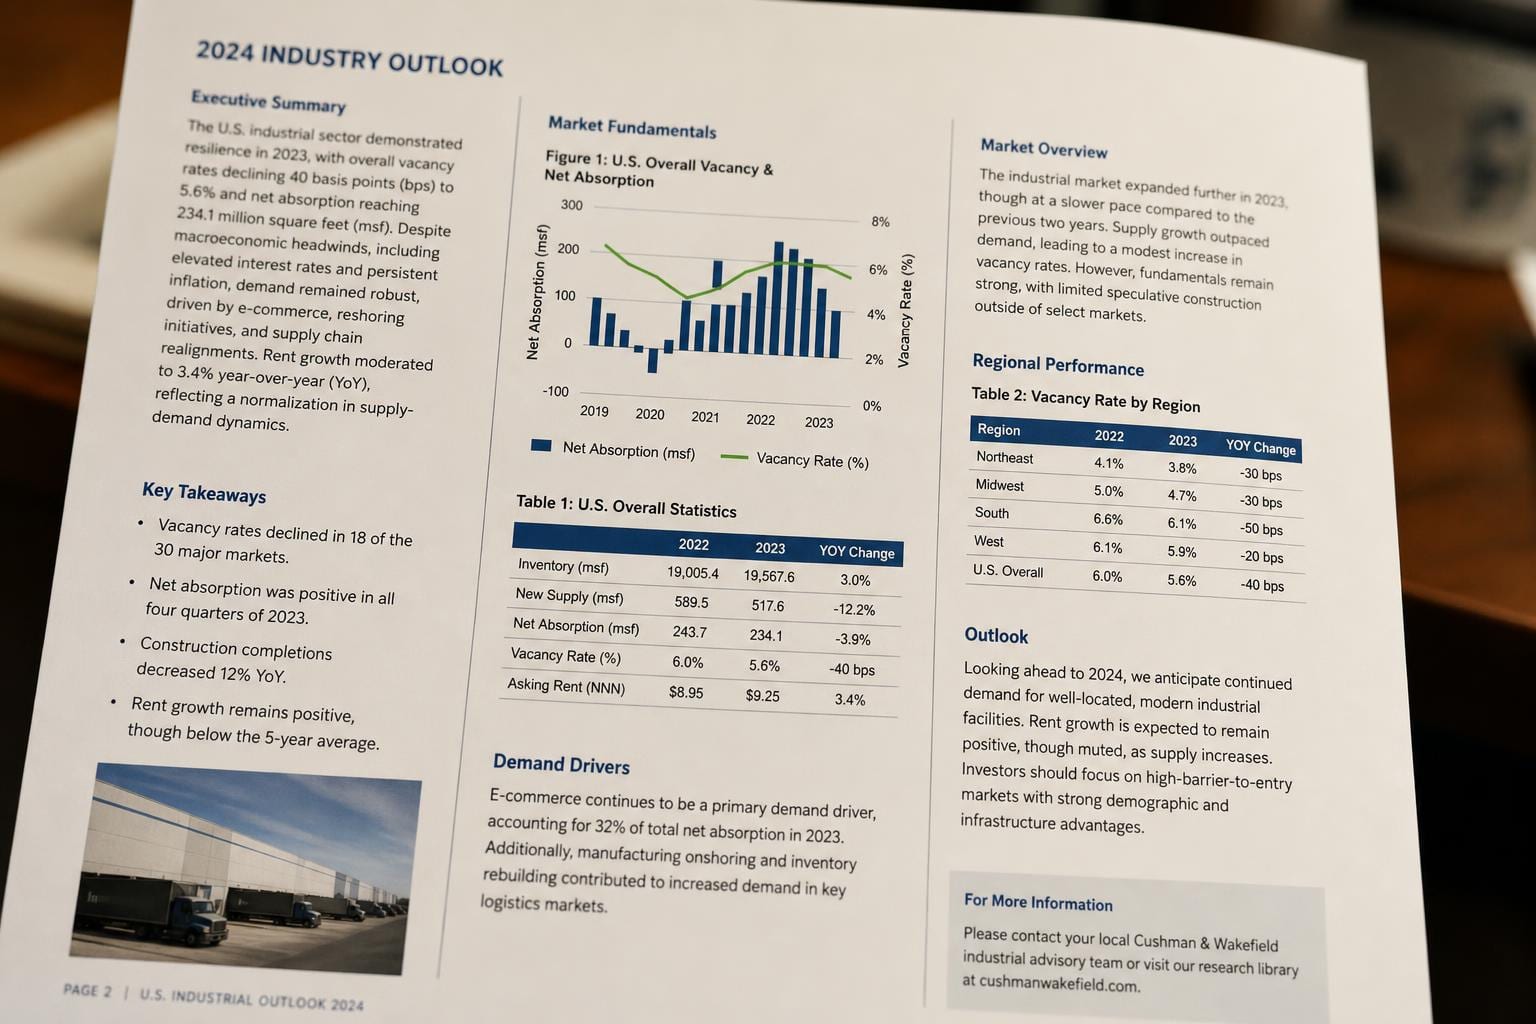
Los resultados se informan en OmniDocBench, un benchmark para la interpretación de documentos con diseños mixtos (multicolumna, tablas, formularios). Dos afirmaciones destacan.
En primer lugar, en OmniDocBench, LayoutLite redujo sustancialmente la longitud de los tokens visuales mientras mantenía la calidad de OCR esencialmente intacta. Ese es el resultado principal, y es el más fácil de reproducir en un benchmark diseñado alrededor de tu propio método, así que trátalo como el caso optimista, no como el límite superior.
La prueba más interesante es lo que ocurrió cuando integraron LayoutLite en dos modelos de OCR para los cuales no fue diseñado, FireRed-OCR y Logics-Parsing-V2, como un módulo plug-and-play. Con una compresión de tokens de hasta un 50% en ambos modelos:
- La puntuación de reconocimiento se mantuvo casi igual que la línea base sin compresión.
- La latencia de prellenado (prefill), el tiempo dedicado a procesar la entrada antes de que el modelo comience a generar la salida, disminuyó en más del 40%.
- Las FLOPs (el conteo bruto de operaciones de cómputo) disminuyeron en más del 40%.
- La memoria de la caché KV, la memoria que un transformer dedica a retener el contexto mientras genera, disminuyó en más del 40%.
- La red de puntuación en sí añadió "solo una pequeña sobrecarga de inferencia adicional" sobre esos ahorros.
Ese es un intercambio genuinamente bueno: la mitad del cómputo por un error de redondeo en la precisión, y funcionó en dos arquitecturas preentrenadas diferentes, no solo en la una para la que se ajustó el método. La portabilidad entre arquitecturas es la parte que menos me preocupa respecto a que esto se convierta en un truco de nicho para benchmarks.
Por qué importa si estás construyendo o comprando OCR
Si ejecutas OCR a cualquier volumen real, la latencia de prellenado y la memoria de la caché KV son los conceptos clave por los que realmente pagas. Una canalización de procesamiento de documentos que ingresa miles de PDFs al día no se ve limitada por mejoras en la precisión del modelo del 98% al 98.5%. Se ve limitada por cuántas páginas por segundo puede procesar una GPU y cuánta memoria consume cada solicitud concurrente. Una reducción del 40%+ en ambos, con un costo de precisión cercano a cero, es el tipo de cambio que se refleja directamente en tu factura de inferencia y en tu techo de rendimiento.
El enfoque de "conectar y usar" también es importante, si se sostiene fuera de las propias pruebas de este artículo. Un módulo que se sitúa entre un codificador y un decodificador de visión existentes, en lugar de requerir un modelo entrenado desde cero, es la diferencia entre "un artículo interesante" y "algo que un proveedor realmente lanza". El hecho de que funcionara en dos VLMs especializados en OCR separados sin haber sido diseñado específicamente para ninguno es la evidencia más fuerte en el artículo de que esto generaliza en lugar de sobreajustarse a las peculiaridades de una arquitectura.
Si estás evaluando motores de OCR en lugar de construir uno, la pregunta práctica que esto plantea es: ¿qué proveedores ya están haciendo algo así bajo el capó y cuáles todavía están consumiendo tokens en tus márgenes en blanco? Esa no es una pregunta que este artículo responda, ya que es un artículo de investigación, no un anuncio de producto, pero es la pregunta correcta para empezar a hacer a los proveedores.
Qué sigue sin probarse
Dos backbones y un benchmark constituyen una prueba real, pero no una extensa. OmniDocBench abarca una variedad de diseños, pero sigue siendo un único benchmark, y una "degradación despreciable" con una compresión del 50 % no indica qué ocurre al 60 % o 70 %, donde la curva presumiblemente deja de ser plana. El artículo no informa dónde se encuentra ese precipicio.
Existe también una categoría de documentos con los que este método debería, en principio, tener más dificultades que con otros: formularios densos con casi ningún espacio en blanco, tablas muy compactas o páginas manuscritas donde las regiones "importantes" e "inimportantes" se difuminan. Los márgenes son la victoria fácil. Qué ocurre con un documento que es 90 % tinta es una pregunta más compleja que la sección de resultados no profundiza.
Y la señal de entrenamiento, la consistencia de la salida de OCR medida antes y después de la compresión, es tan buena como la línea base de transcripción del propio modelo de OCR. Si el modelo subyacente ya malinterpreta un carácter tenue, la señal de recompensa no tiene nada contra qué corregirse, ya que eliminar el token cerca de ese error no parecería una violación de consistencia. Ese es un punto ciego sutil en un enfoque, por lo demás ingenioso, para evitar la anotación humana.
Nada de eso borra el resultado central. Un módulo plug-in que reduce más del 40 % del costo real de ejecutar OCR de documentos, sin necesidad de un conjunto de datos de diseños etiquetados a mano y sin un impacto significativo en la precisión, es una pieza de ingeniería genuinamente útil. Si se convierte en una práctica estándar dependerá de si resiste en los documentos más desordenados y densos que no entraron en el conjunto de pruebas de este artículo.