قرأت الذكاء الاصطناعي خاتماً عمره 2000 عام وابتكر قصيدة
استنادًا إلى: Ancient-Bench: A Comprehensive Multi-millennial, Multi-medium, and Multi-script Benchmark for Ancient Chinese Artifact Text Recognition — Hiuyi Cheng, Nuo Xu, Yuyi Zhang, Xuhan Zheng, Wei Pan, Jing Zhang, Dezhi Peng, Minghui Liao, Yihua Teng, Jihao Wu, Haoyu Ren, Lianwen Jin
ختم، ومثل، ونموذج ابتكر قصيدته الخاصة
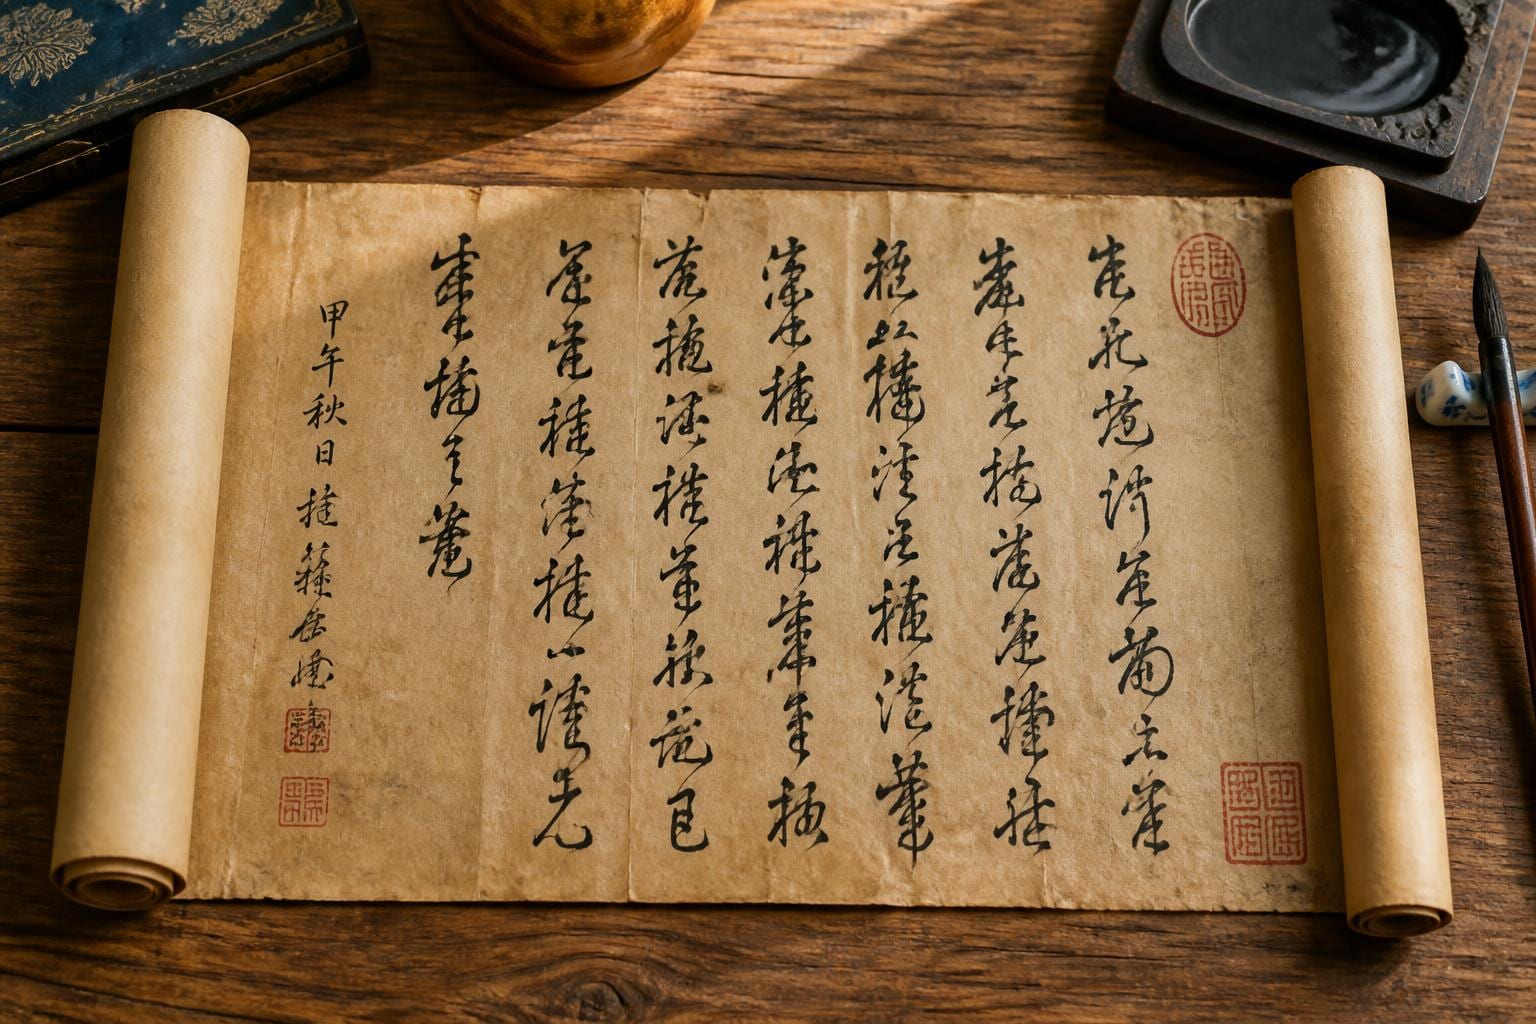
إليك السياق. عرض الباحثون على نموذج لغوي بصري (vision-language model) صورة لختم صيني عمره 2000 عام. النص المنقوش هو مثل كلاسيكي حقيقي، يشبه إلى حد ما "لا يوجد نكهة دنيوية تدوم أطول من مرارة جذور الخضروات" (世間滋味賞來無過菜根甜). قرأ أحد أقوى النماذج المتخصصة في التعرف الضوئي على الحروف (OCR) في الاختبار النص على أنه "美酒歸來無人問和賞"، وهو تسلسل مختلف من الأحرف يصادف أيضاً أن يبدو كسطر معقول من الشعر الكلاسيكي. قام نموذج الأغراض العامة بشيء أغرب: تركز على مقطع مكون من خمسة أحرف، "賞來無人花"، وكرر ذلك باستمرار، منتجاً حلقة تقرأ بسلاسة ولا تقول شيئاً مما يقوله الختم فعلياً.
لم يتوقف أي من النموذجين. ولم يحدد أي منهما المقطع على أنه غير واضح. قدم كلاهما نصاً صينياً واثقاً، صحيحاً نحوياً، ويبدو تاريخياً معقولاً، وكان كلاهما مخطئاً. هذه هي النتيجة الأساسية لـ Ancient-Bench، وهو معيار جديد من جامعة جنوب الصين للتكنولوجيا وهواوي، يختبر مدى قدرة نماذج الذكاء الاصطناعي الحالية على قراءة النصوص المنقوشة والمصبوبة والمكتوبة بالفرشاة والمطبوعة على القطع الأثرية الصينية التاريخية الفعلية. وهو دراسة حالة مفيدة لأي شخص يفترض أن عبارة "يمكن للذكاء الاصطناعي قراءة الوثائق القديمة الآن" هي مسألة حسمت.
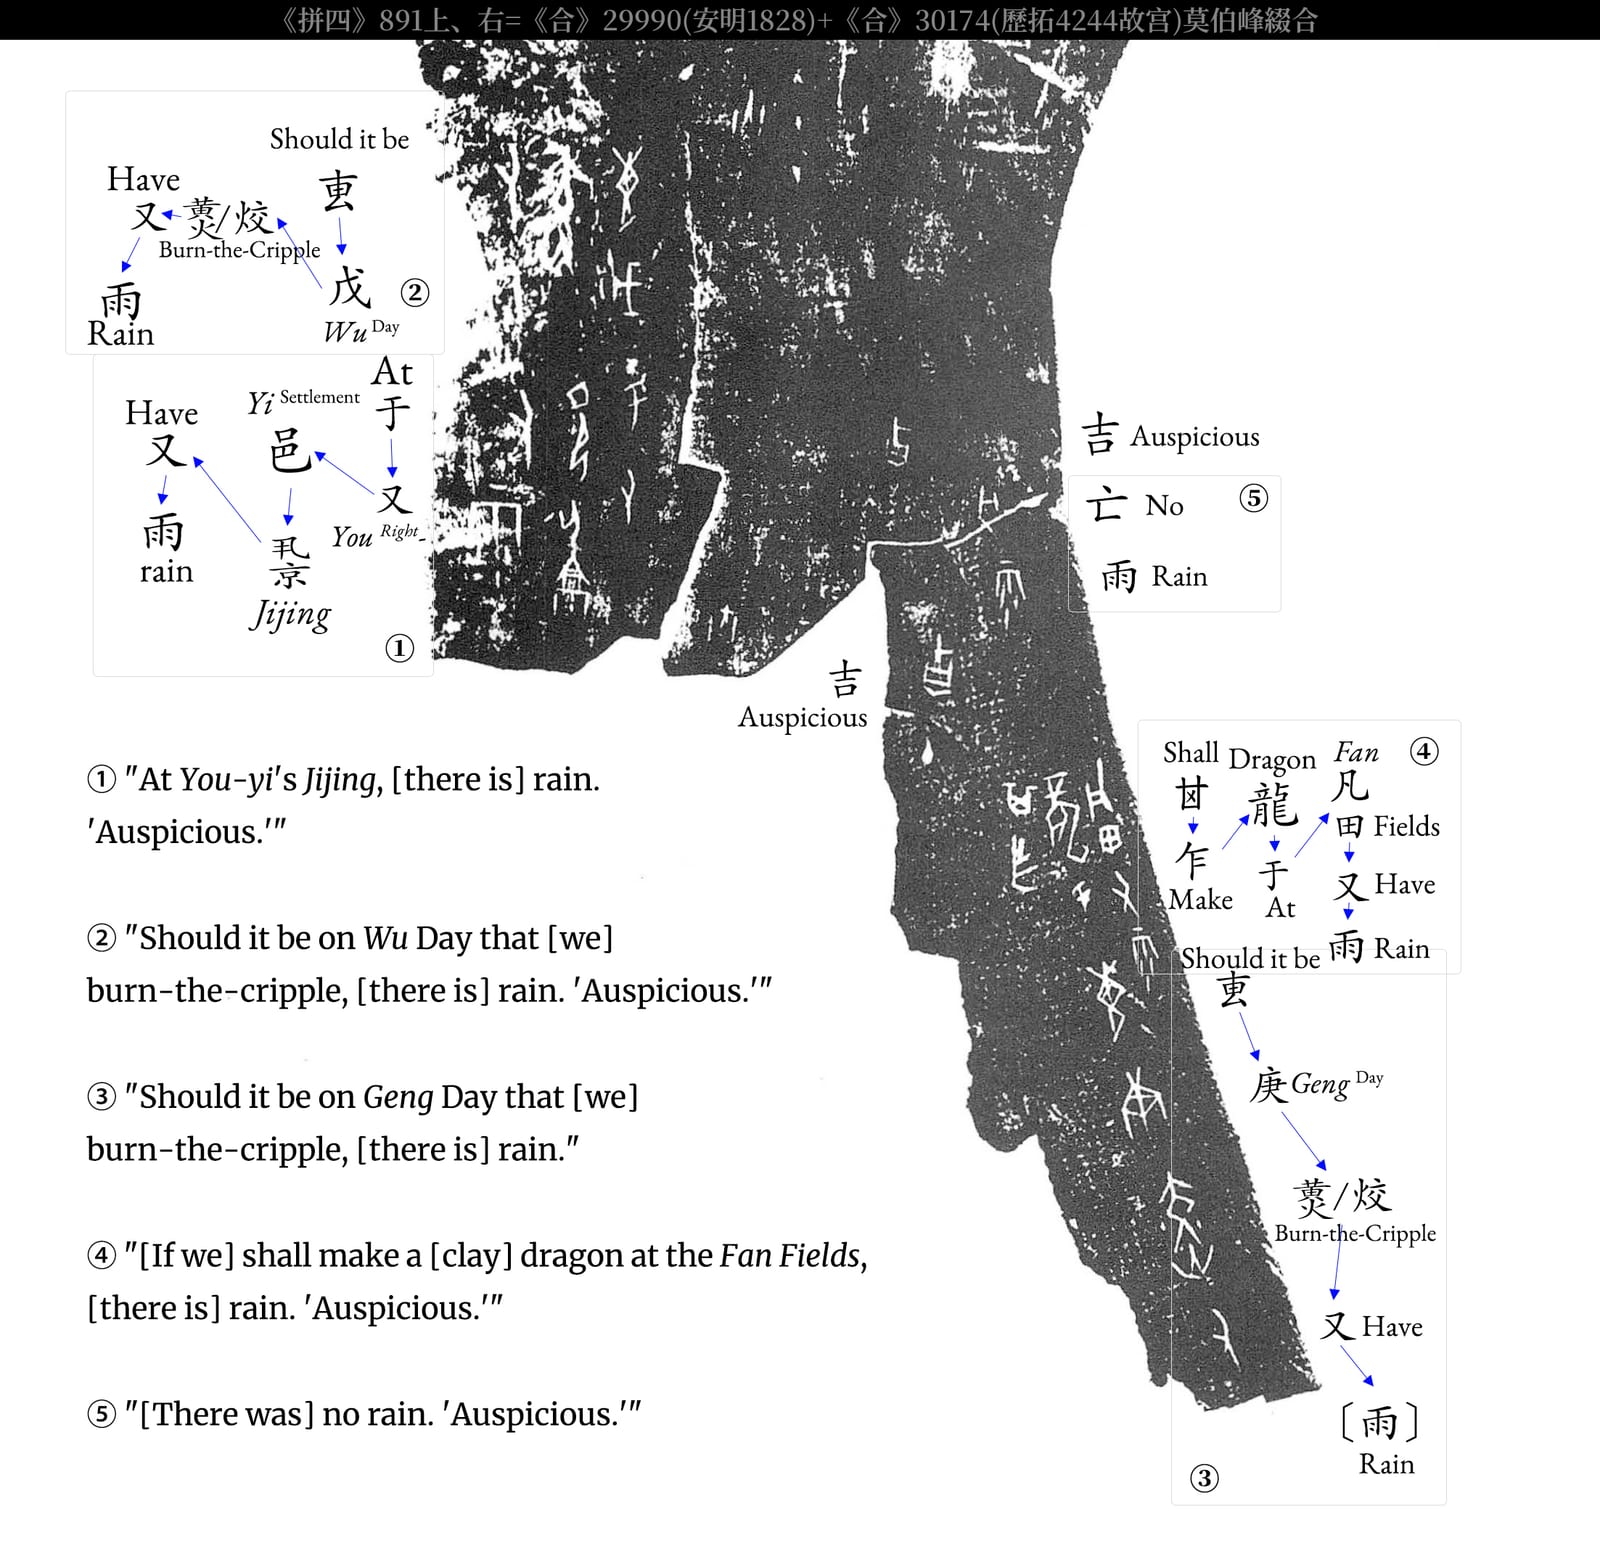
نقش عظم التنجيم الموضح - Heji 29990 و 30174 - تنجيم المطر — بواسطة Quinlan718 عبر ويكيميديا، CC0 1.0.
لماذا لا يُعد هذا حقاً مشكلة OCR واحدة
إذا طلبت من شخص ما بناء نظام "قراءة البصريات الحاسوبية للصينية" (Chinese OCR)، فغالباً ما يتخيل صفحة مطبوعة: خط متناسق، حبر داكن، وخلفية نظيفة. هذا يمثل الجانب السهل من معيار التقييم هذا. أما الجانب الصعب فهو مجموعة من القطع الأثرية التي لا تشترك في نظام كتابة واحد بأي شكل يمكن للقارئ الحديث التعرف عليه.
خضعت الكتابة الصينية لنحو سبع أشكال رئيسية على مر تاريخها، ويغطي Ancient-Bench جميعها: الكتابة على العظام والأصداف (Oracle bone script) التي نقشها الكهنة في عهد سلالة شانغ على أصداف السلاحف وعظام الحيوانات قبل أكثر من 3000 عام، والكتابة على البرونز (Bronze script) المصبوبة في الأواني الطقسية، والكتابة الختمية (Seal script)، والكتابة الإدارية (Clerical script)، والكتابة المنتظمة (Regular script)، والكتابة المتصلة (Cursive script)، والكتابة الجارية (Running script). كل منها يمثل مجموعة مختلفة حقاً من أشكال الأحرف، وليس مجرد تغيير في نوع الخط. فقد يكون الحرف الذي يُعد رمزاً بسيطاً ومعروفاً في الكتابة المنتظمة مجرد صورة رمزية مجردة في الكتابة على العظام والأصداف، لا يستطيع قراءتها سوى حفنة من المتخصصين.
أضف إلى ذلك تسع وسائط فيزيائية مختلفة، لأن سطح الكتابة يغير مظهر "النص" نفسه: العظام والأصداف والبرونز (نقوش قصيرة وكثيفة، غالباً ما تكون متآكلة أو متآكلة)، والألواح الخشبية والخيزرانية (شرائط رقيقة مربوطة معاً لتشكل كتباً، وعرضة للانحناء والتلاشي)، والمخطوطات الحريرية (قماش هش، وغالباً ما يتلف)، والخواتم (نص منقوش بشكل معكوس، وأحياناً بارز)، والنقوش الصخرية والنصب التذكارية (نسخ مأخوذة من صخور متآكلة، مع شقوق وتآكل مدمجين في الصورة)، والكتب المطبوعة بالكتل الخشبية، والخط الحبري. اقرأ عقار أرض من عهد أسرة هان على لوح من الخيزران وشيئاً متصلاً من عهد أسرة مينغ على لفة معلقة، وستجد نفسك أمام مشكلتي التعرف مختلفتين تماماً، يحدثان أنهما يستخدمان نفس اللغة الأساسية، ويفصل بينهما أكثر من ثلاثة آلاف عام.
تجادل الورقة البحثية بأن معايير التقييم الحالية تختار في الغالب أحد هذه المحاور وتتوقف عند ذلك. فبعضها يغطي عدة أنواع من الخطوط ولكن فقط في الكتب المطبوعة. وبعضها يغطي الكتابة على العظام والأصداف بعمق ولا يغطي شيئاً آخر. وحاولت محاولة سابقة لإنشاء مجموعة متعددة الوسائط، وهي MCHDoc، دمج عدة وسائط معاً، لكنها استمدت بياناتها من مجموعات بيانات أحادية الوسيط موجودة مسبقاً دون قواعد تسمية موحدة، لذا لم تكن الأرقام قابلة للمقارنة حقاً عبر الفئات. وتتمثل فكرة Ancient-Bench في بناء مجموعة بيانات واحدة تكون صادقة بشأن الأبعاد الثلاثة في آن واحد: الوسيط، والخط، والفترة الزمنية.
تحديد معنى "الصحيح"
قبل أن تتمكن من تقييم نموذج في التعرف على النصوص القديمة، يجب أن تحدد كيف تبدو النسخة النصية الصحيحة، ويتبين أن هذا يمثل مشكلة تصميم حقيقية وليس مجرد إجراء شكلي.
خذ على سبيل المثال حرفاً منحوتاً على عظم تنجيم. قد لا يوجد هذا الحرف في ترميز يونيكود الحديث على الإطلاق. يتبع العلماء ممارسة قياسية تسمى "التنقيح" (隶定): وهي تحويل شكل حرف قديم إلى ما يقابله في خط لاحق قابل للقراءة، تماماً كما قد تشرح أن رمزاً مكتوباً بخط اليد قديماً "يعادل" حرفاً حديثاً رغم اختلاف شكله تماماً. كان على مُعلِّمي بيانات Ancient-Bench أن يقرروا، حرفاً بحرف، ما إذا كان للشكل القديم المحدد ما يقابله من معادل حديث متفق عليه، أم أنه يجب وضع علامة عليه كـ "غير مقروء" لعدم وجود معادل، أم أن تسمية المتحف الخاصة بالمؤسسة المصدر (التي غالباً ما تبسط الأمور بشكل كبير للجمهور العام) يمكن الوثوق بها أصلاً. وجد الفريق أن تعليقات المتاحف تطبع الأحرف المتغيرة أو التقليدية إلى أشكال مبسطة حديثة من أجل سهولة القراءة، مما يمحو بصمت فروقاً مهمة للبحث التاريخي: فمثلاً، حرفان اندمجا لاحقاً في شكل مبسط واحد كان لهما معانٍ مختلفة في النصوص الأصلية.
تعالج الورقة هذه المسألة من خلال ثلاث معايير للتعليم. يحدد توحيد الرموز كيفية وضع علامات على الأحرف المتكررة، والأجزاء التالفة أو غير المقروءة، والأحرف الموجودة في الصورة ولكن لا يمكن كتابتها في أي مجموعة أحرف. يحدد توحيد الأحرف القواعد الخاصة بالتعامل مع الأشكال القديمة والمتغيرة، مع إعطاء الأولوية لما تراه عينك هو ما تحصل عليه بدلاً من التبسيط الصامت. يغطي توحيد التحليل النحوي (Parsing) تخطيط الصفحة: ترتيب القراءة (تتدفق النصوص الصينية العمودية من الأعلى إلى الأسفل ومن اليمين إلى اليسار؛ بينما تختلف بعض القطع الأثرية في ترتيبها)، وانقطاعات الأسطر، والملاحظات بين السطور، وأي مناطق من صفحة الكتاب المطبوع تمثل نصاً فعلياً مقابل ملاحظات الهامش أو آثار التجليد التي يجب تجاهلها.
ليس هذا الجزء من الورقة جذاباً، ولكنه بلا شك المساهمة الأكثر فائدة: تعريف مشترك وقابل للتحقق لـ "الحقيقة الأساسية" (ground truth) لفئة من المستندات حيث يمكن للخبراء المعقولين خلافاً حول النسخ النصي. عمل عشرون مُعلِّماً للبيانات مدربين على هذه المهمة لمدة ستة أشهر، مع التحقق المتبادل ضد أربع قواعد بيانات مرجعية راسخة في علم النصوص القديمة، ومراجع منفصل يتحقق من التسميات النهائية.
الأرقام: لا أحد يتجاوز 60%، وبعض المهام بالكاد تعمل
تحتوي المجموعة النهائية من البيانات على 2,700 صورة، مستمدة من 14 متحفًا ومكتبة على المستوى الوطني، موزعة عبر الأنواع التسعة من الوسائط (من 400 قطعة خطية إلى 200 نقش صخري)، وتغطي الفترة من حوالي 1200 قبل الميلاد إلى 1911 ميلادي. ثم قام الباحثون بتشغيل 33 نموذجًا ضدها: نماذج مغلقة مثل GPT-5 وGemini وClaude؛ ونماذج مفتوحة مثل Qwen وKimi؛ ومجموعة من أنظمة OCR المتخصصة في المستندات والمبنية خصيصًا لاستخراج النص بدلاً من المحادثة العامة. تم تقييم مخرجات كل نموذج مقابل النصوص المعيارية باستخدام مقياسين: F1 (كم عدد الأحرف المتوقعة التي تتطابق مع الحقيقة الأساسية، مع معاقبة كل من الأحرف المفقودة والمخترعة) والمسافة التعديلية المعيارية، وهي مقياس على مستوى الأحرف لعدد التعديلات أحادية الحرف المطلوبة لتحويل تخمين النموذج إلى الإجابة الصحيحة.
حقق أفضل نموذج بشكل عام، وهو Doubao-seed-2-0-lite من ByteDance، مسافة تعديلية بنسبة 52.08% وF1 بنسبة 57.86%. اقرأ ذلك ببساطة: أقوى نظام تم اختباره يحصل، في المتوسط، على أقل من ثلاثة أحرف من كل خمسة بشكل صحيح عندما تطلب منه قراءة أثر صيني قديم. كل نموذج آخر يؤدي أداءً أسوأ. أفضل متخصص OCR مخصص، HunyuanOCR، يصل إلى حد أقصى بنسبة 46.11% من F1، متخلفًا بشكل كبير عن نماذج الدردشة متعددة الأغراض مثل Doubao وGemini وKimi K2.6 مفتوح الأوزان (56.62% F1). هذا عكس حقيقي لما تتوقعه: النماذج المبنية والمسوقة خصيصًا لتحليل المستندات تخسر أمام المساعدين متعددي الأغراض في هذه المهمة.
كما ينقسم الأداء بشدة حسب نوع الأثر، وهذا الانقسام يخبرك بشيء مفيد. كتابة العظام الفخارية قريبة من أن تكون غير محلولة: حتى Gemini، الأفضل أداءً في هذه المهمة المحددة، يدير فقط 15.75% من F1. النقوش البرونزية ليست أفضل بكثير، بنسبة 38.48% للنموذج الأفضل. كلا الفئتين تتضمن أشكال رموز كثيفة وقديمة لا يوجد لها مكافئ حديث يمكن للنموذج مطابقة الأنماط ضده. الأختام هي فخها الخاص: لأن نقوش الأختام تستشهد عادة بالشعر الكلاسيكي، تتحول النماذج إلى مسبقاتها الخاصة ببيانات التدريب وتنتج شعرًا يبدو سلسًا وليس ما هو محفور فعليًا، وهو بالضبط مثال الختم من الافتتاحية. في حين أن اللوحات الحجرية، التي تميل إلى الحفاظ على خط الكتابي أو المنتظم بشكل جيد في حالة جيدة، حققت 88.88% من F1 للنموذج الأفضل، أقرب إلى نتيجة قابلة للاستخدام حقًا.
الفجوة بين هذه الأرقام (أقل من 16% على العظام الفخارية، وقرب 89% على اللوحات الحجرية) هي النتيجة الحقيقية هنا، أكثر من أي درجة لوحة قيادة فردية. "OCR الصينية القديمة" ليست قدرة واحدة يمتلكها النموذج أو يفتقدها. إنها عشرات القدرات الضيقة، والأنظمة الحالية تمتلك بعضها وليس الأخرى.
مشكلة الهلوسة هي مشكلة تجربة المستخدم، وليست مجرد مشكلة دقة
يبني البحث مجموعة فرعية منفصلة من الخط العربي خصيصًا لدراسة الهلوسة، ويحدد نمطين متميزين من الفشل يستحقان المعرفة إذا كنت تقيم أي نظام OCR على مدخلات غير مرتبة، وليس فقط النصوص الصينية القديمة.
الأول هو ما يسميه المؤلفون "الإكمال الدلالي المدفوع بالسابق": عندما تكون السكتات الخطية غامضة أو مشوهة (وهو أمر طبيعي في الخط المتصل)، يعتمد النموذج على نصفه الخاص بنموذج اللغة بدلاً من نصفه البصري، وينتج نصًا يبدو صحيحًا بدلاً من النص الموجود فعليًا. هذا هو فشل "شعر الختم" المذكور في الافتتاح، بشكل عام. والثاني هو "الفرط في التعرف الناتج عن الاقتطاع والكشف": عندما يرسم خطوة الكشف عن المنطقة الخاصة بالنظام مربعًا خاطئًا قليلاً حول النص، يلتقط السكتات المجاورة أو ضوضاء الخلفية ويحولها إلى أحرف إضافية ومخترعة، ويخيطها في قراءة سلسة لكن مُصنَّعة.
تشارك كلا طريقتي الفشل في خاصية يجب أن تقلق أي شخص يبني منتجًا على أساس هذه النماذج: يبدو المخرج بنفس الثقة تمامًا، بنفس التنسيق الجيد تمامًا، سواء كان صحيحًا أو مُخترعًا بالكامل. لا يوجد تحفظ مرئي، ولا توجد درجة ثقة أقل تُعرض للمستخدم، ولا شيء يميز بين "قرأت هذا بشكل صحيح" و"أنا أقرن الأنماط بشيء معقول". بالنسبة للمستخدم العادي، هذا هو الفرق بين أداة تكون أحيانًا خاطئة وأداة تكون أحيانًا خاطئة بطريقة لا يمكنك اكتشافها دون معرفة الإجابة بالفعل بشكل مستقل.
لماذا يهمك هذا الأمر إذا كنت تبني أو تختار نظام OCR
إذا كانت مستنداتك تشبه الطرف السهل من معيار الاختبار هذا (صفحات مطبوعة، خط يدوي حديث، مسوحات ضوئية جيدة)، فإن هذا لا يغير حساباتك كثيرًا؛ فأنظمة OCR الرئيسية ونماذج اللغة المرئية العامة (VLMs) تتعامل مع ذلك بشكل معقول بالفعل. لكن هذه الورقة البحثية تقدم دليلاً واضحًا ومدروسًا على أين ينهار هذا الثقة، وينطبق هذا النمط على أي حالة استخدام لـ OCR تتضمن مواد مصدر متدهورة أو غير معتادة أو خارج نطاق التوزيع (out-of-distribution): الخطوط اليدوية القديمة، الإيصالات الباهتة، النماذج التالفة، أو النصوص غير اللاتينية ذات بيانات التدريب المحدودة. ومن الجدير بالذكر أن طبيعة النصوص العربية، بكتابتها المتصلة واتجاهها من اليمين إلى اليسار وأشكال الحروف المتغيرة حسب السياق، تجعل مهمة التعرف الضوئي عليها أكثر تعقيدًا وتتطلب معالجة دقيقة لهذه الخصائص المحلية.
ثلاث نقاط رئيسية تستحق أن تأخذها معك في التقييم الحقيقي:
تتفوق نماذج اللغة المرئية العامة (VLMs) حاليًا على نماذج OCR المتخصصة عند التعامل مع مدخلات صعبة وغير مألوفة حقًا. قد يكون هذا الأمر محرجًا قليلاً إذا كنت قد بنت خط أنابيب (pipeline) يعتمد على نموذج OCR متخصص بناءً على افتراض أن التخصص يفوز، ومن الجدير إعادة اختبار هذا الافتراض على مستنداتك الفعلية بدلاً من الاعتماد على معايير تسويقية.
الثقة والدقة غير مرتبطتين في هذه الأنظمة بعد. في هذا المعيار، تنتج النماذج إجابات خاطئة ولكنها سلسة بنفس سهولة إنتاج إجابات صحيحة وسلسة، خاصة عندما يكون الإدخال غامضًا. إذا كان منتجك يعرض مخرجات OCR مباشرة للمستخدم دون أي شكل من أشكال التحقق أو إشارة ثقة، فإن المستندات المتدهورة أو غير المعتادة هي حيث يتحول هذا الفجوة إلى تذكرة دعم فني، أو أسوأ من ذلك.
أرقام الدقة الإجمالية تخفي الانهيار في الفئات الفرعية. يحتاج نموذج يدعي أن "OCR يعمل" إلى نسخته الخاصة من التفصيل حسب الوسط الموجود في هذه الورقة قبل أن تثق به في نوع مستندك المحدد، لأن المتوسط القوي يمكن أن يُبنى على فئة واحدة قريبة من الحل التام وأخرى بالكاد تعمل.
ما لا تدعيه الورقة البحثية
يكون المؤلفون صريحين بشأن نقطتي ضعف. أولاً، يقوم Ancient-Bench بتعليق النصوص على مستوى السطر أو المنطقة، وليس باستخدام مربعات تحديد (bounding boxes) على مستوى الأحرف، لذا فهو جيد لتقييم التعرف الشامل من البداية إلى النهاية، لكنه غير مناسب لتقييم الكشف الدقيق عن النصوص. وقد أشاروا إلى أن ذلك قيد التخطيط للإضافة لاحقاً. ثانياً، والأمر الأكثر إثارة للاهتمام: نظراً لأن الصور المصدرية تأتي من أرشيفات المتاحف والمكتبات العامة، فقد يكون جزء من هذه المواد موجوداً بالفعل ضمن بيانات تدريب النماذج نفسها التي يتم اختبارها. هذه مشكلة مألوفة لأي معيار مرجعي (benchmark) مبني على مصادر عامة، وإذا كان له تأثير، فهو يميل إلى رفع الدرجات المبلغ عنها بدلاً من جعل النتائج تبدو صعبة بشكل مصطنع. ونظراً لأن حتى أفضل النماذج لا تزال تفشل فشلاً ذريعاً في قراءة العظام الكهنوتية والنقوش البرونزية، فإن هذا التحفظ لا يخفف كثيراً من النقطة الرئيسية للورقة: قراءة 3,000 عام من نصوص القطع الأثرية الصينية لا تزال، في الوقت الحالي، مشكلة لم تحلها الذكاء الاصطناعي الحالي.