AIが2000年前の印章を読み取り、詩を創作した
元論文: Ancient-Bench: A Comprehensive Multi-millennial, Multi-medium, and Multi-script Benchmark for Ancient Chinese Artifact Text Recognition — Hiuyi Cheng, Nuo Xu, Yuyi Zhang, Xuhan Zheng, Wei Pan, Jing Zhang, Dezhi Peng, Minghui Liao, Yihua Teng, Jihao Wu, Haoyu Ren, Lianwen Jin
印鑑、ことわざ、そして自作詩を生み出したモデル
以下がその状況です。研究者たちは、視覚言語モデルに2,000年前の中国の印鑑の写真を見せました。刻まれた文字は「世間滋味賞來無過菜根甜(世間の味を賞してこれに勝るものなし、菜根の甘さ)」のような、実在する古典的なことわざです。テストの中で最も強力なOCR専門モデルの一つは、これを「美酒歸來無人問和賞」と読み取り、これは別の文字列ですが、たまたま古典詩の一節としてありそうな響きを持っていました。汎用モデルはさらに奇妙な行動を示し、「賞來無人花」という五文字の断片に固執し、それを繰り返してループを生成しました。この出力は流暢ですが、印鑑が実際に伝えている内容とは無関係なものでした。
どちらのモデルも一時停止することはありませんでした。また、その記述が不明瞭であることを警告することもありませんでした。両者とも、自信に満ちた文法的に正しく、歴史的にもありそうな中国語を返しましたが、どちらも誤りでした。これは、南華理工大学と華為技術(Huawei)が発表した新しいベンチマーク「Ancient-Bench」の中核的な発見です。このベンチマークは、今日のAIモデルが、実際の歴史的な中国の遺物に刻まれ、鋳造され、筆で書き、印刷された文字をどの程度正確に読めるかをテストするものです。これは、「AIはもう古い文書を読める」ということが確定した問題だと考えている人々にとって、有用なケーススタディとなっています。
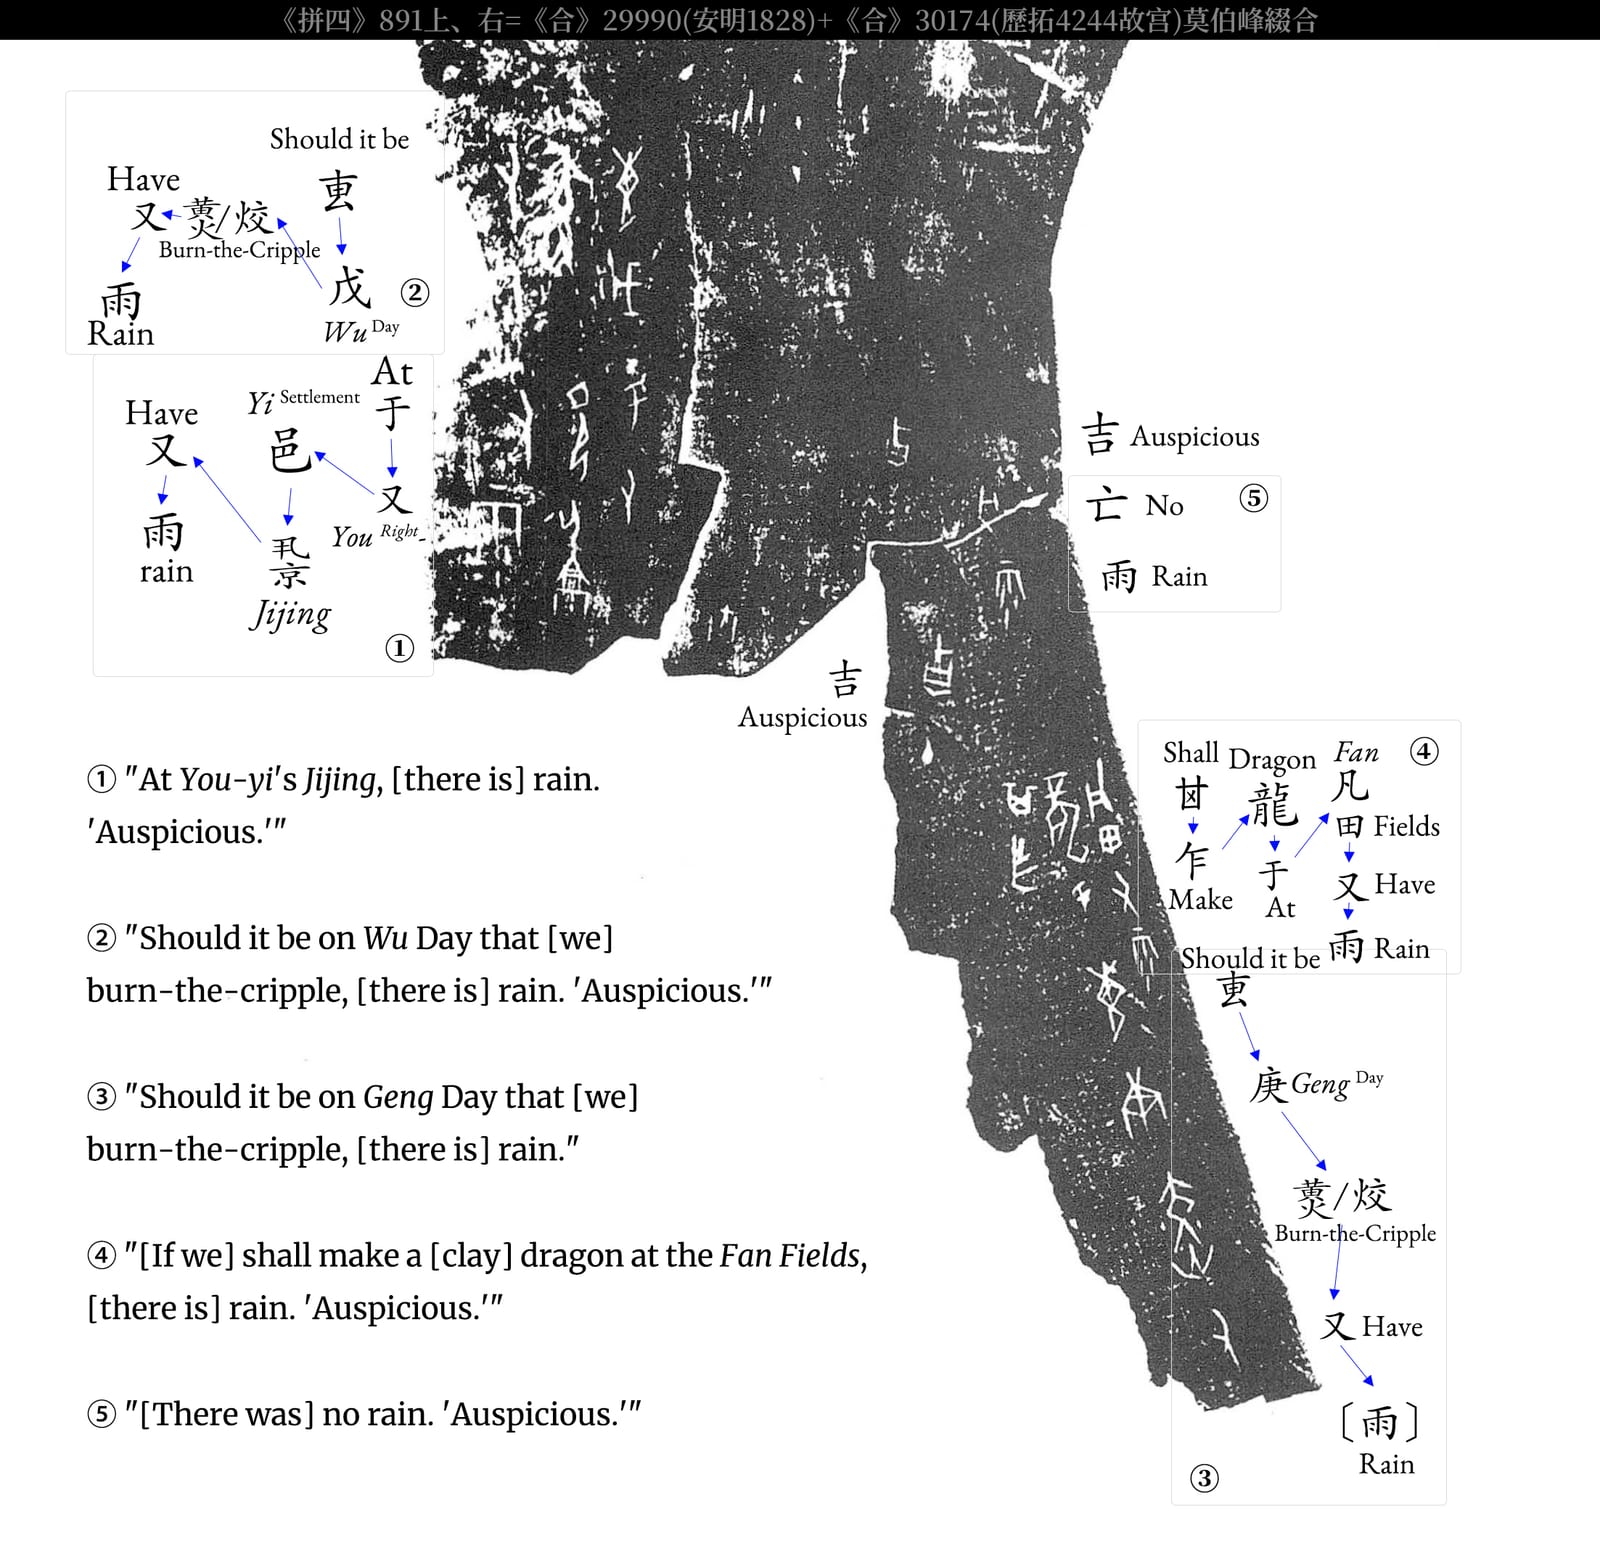
注釈付き甲骨文字拓本 - 合集29990および30174 - 雨占い — Quinlan718による wikimedia 提供、CC0 1.0。
なぜこれが単なる1つのOCR問題ではないのか
「中国語OCR」を作れと言われたら、多くの人は印刷されたページを想像するだろう。一貫したフォント、濃いインク、きれいな背景。それはこのベンチマークの簡単な側面だ。難しい側面は、現代の読者が認識しうるどのような方法でも文字体系を共有していない一連の遺物から成る。
漢字は歴史上、おおむね7つの主要な書体を経てきたが、Ancient-Benchはそれらすべてをカバーしている。甲骨文字(3,000年以上前に殷の王朝の巫師によって亀甲や獣骨に刻まれたもの)、金文(祭祀用の器に鋳込まれたもの)、篆書、隷書、楷書、草書、行書である。それぞれは単なるフォントの変更ではなく、真に異なる字形の集合体だ。楷書では単純でよく知られた文字でも、甲骨文字では少数の専門家でしか読めない抽象的な象形文字になっているかもしれない。
さらに9種類の異なる物理媒体が重なる。書かれた表面が「テキスト」の見た目そのものを変えるからだ。甲骨と青銅器(短く密集した銘文で、しばしば欠けや腐食がある)、竹簡と木簡(本に綴じられた細長い板で、歪みや色あせを起こしやすい)、絹本(壊れやすい布地で、頻繁に損傷している)、印章(鏡像で刻まれた文字で、浮き彫りの場合もある)、石碑と崖刻(風化した岩から拓本が取りられ、ひび割れや侵食が画像に焼き付いている)、木版印刷の書籍、そして墨書の書道作品である。漢代の竹簡に書かれた土地契約と、明代の掛け軸に書かれた草書の詩を読むことは、同じ基盤言語を使用しているものの、3,000年以上の時を超えた、実質的に2つの異なる認識問題に取り組むことになる。
論文では、既存のベンチマークはこれらの軸の1つを選んでそこで止まっていると主張されている。いくつかは複数の書体をカバーしているが、印刷された書籍に限定されている。いくつかは甲骨文字を深くカバーしているが、それ以外はカバーしていない。マルチメディアセットの以前の試みであるMCHDocは、いくつかの媒体を結合しようとしたが、既存の単一媒体データセットから抽出しており、共有されたラベリングルールがなかったため、カテゴリ間で数値を本当に比較することはできなかった。Ancient-Benchの提案は、媒体、書体、時代という3つの次元すべてを正直に反映した1つのデータセットを構築することにある。
「正解」の定義をどう決めるか
古代文献認識モデルを評価する前に、どのような転写が「正解」なのかを定義する必要がありますが、これは単なる形式上の問題ではなく、本質的な設計課題です。
甲骨に刻まれた文字を例にとります。その文字が現代のUnicodeに存在しない場合もあります。学者の間では「隷定」と呼ばれる標準的な慣行があり、古代の字形を後世の読みやすい書体(現代漢字など)に相当する形へ変換します。これは、外見は似ていなくても、古い手書きの記号が現代の文字の「どれ」に相当するかを説明することに似ています。Ancient-Benchのアノテーターは、文字ごとに、その古代字形に合意された現代の対応文字が存在するか、対応文字が存在しないため「不明」などのプレースホルダーでマークすべきか、あるいは出典機関の博物館ラベル(一般向けに過度に簡略化されていることが多い)を信頼できるか、を判断する必要がありました。チームは、博物館のアノテーションでは、可読性を高めるために異体字や繁体字が現代の簡体字に正規化されることが多く、これにより歴史研究において実際に重要な区別が静かに消去されてしまうことを発見しました。例えば、後に1つの簡体字に統合された2つの文字は、原文では異なる意味を持っていたことがあります。
本論文では、3つのアノテーション基準でこの問題を解決しています。記号の標準化は、繰り返し出現する文字、損傷または判読不能な箇所、画像には存在するがどの文字セットでも入力できない文字をどのようにマークするかを定義します。文字の標準化は、古代の字形や異体字を処理するルールを設定し、静かな簡略化ではなく「見たまま」を優先します。解析の標準化はレイアウトをカバーし、読み順(中国語の縦書きは上から下、右から左へ読むが、一部の遺物は異なる)、改行、夾注(行間の注釈)、印刷された書籍のページのうちどの領域が本文で、どの領域が余白の注釈や製本によるアーティファクトとして無視すべきかを含みます。
これは論文の中で最も華やかな部分ではありませんが、おそらく最も実用的な貢献です。専門家の間でも転写について意見が分かれる可能性がある文書カテゴリにおいて、「正解(ground truth)」の共有可能で検証可能な定義を提供するものです。20人の訓練されたアノテーターが6ヶ月にわたり作業し、4つの確立された文字学参考文献データベースと相互検証を行い、別のレビュアーが最終的なラベルを検証しました。
数値:60%を突破するモデルはなく、一部のタスクではほぼ機能しない
最終的なデータセットは、14の国家レベルの博物館や図書館から収集した2,700枚の画像で構成され、9つのメディアタイプ(書道作品400点から崖刻200点まで)に分割され、紀元前1200年頃〜西暦1911年頃をカバーしています。研究者たちは、これに対して33のモデルを実行しました。GPT-5、Gemini、Claudeなどのクローズドモデル、QwenやKimiなどのオープンモデル、そして一般的な会話ではなくテキスト抽出のために特別に構築された専門的なドキュメントOCRシステムのセットです。各モデルの出力は、2つの指標を使用して標準化された写本と比較してスコアリングされました。F1(予測された文字が正解と一致する割合で、見逃しと誤検知の両方をペナルティとする)と、正規化編集距離(モデルの推測を正解に変えるために必要な1文字あたりの編集回数を示す文字レベルの測定値)です。
総合的に最も優れたモデルは、ByteDanceのDoubao-seed-2-0-liteで、編集距離52.08%、F1 57.86%を達成しました。これを素直に解釈すると、テストされた中で最も強力なシステムでさえ、古代中国の遺物を読み取らせる際、平均して5文字中3文字未満しか正しく認識できないということです。他のすべてのモデルはこれより劣ります。最も優れた専用OCR専門モデルであるHunyuanOCRは、F1が46.11%で頭打ちとなり、DoubaoやGemini、オープンウェイトのKimi K2.6(F1 56.62%)のような汎用チャットモデルに明確に遅れています。これは予想と真逆の結果です。ドキュメント解析のために特別に構築・販売されたモデルが、このタスクにおいて汎用アシスタントに負けているのです。
パフォーマンスは遺物の種類によって大きく分かれます。この分け方は有益な情報を提供します。甲骨文字はほぼ未解決状態です。この特定のタスクで最も優れたパフォーマンスを示したGeminiでさえ、F1は15.75%に留まります。青銅器銘文もそれほど良くなく、上位モデルで38.48%です。両方のカテゴリには、モデルがパターンマッチングできる現代の同等物を持たない、密集した古代の文字形式が含まれています。印章は独自の罠です。印章の銘文は古典詩を引用することが多いため、モデルは学習データの事前確率に依存し、実際に刻まれているものではないが流暢に聞こえる詩を生成します。これは冒頭の印章の例とまさに同じ現象です。一方、石碑は比較的状態の良い楷書や隷書がよく保存されている傾向があり、上位モデルでF1 88.88%を達成し、実際に使用可能な結果に近づいています。
これらの数値の差(甲骨文字では16%未満、石碑では約89%)こそが、単一のリーダーボードスコアよりも真の発見です。「古代中国OCR」は、モデルが持つか持たないかの1つの能力ではありません。それは数十のより狭い能力の集合体であり、現在のシステムはそれらの一部を持ち、他の一部は持っていないのです。
ハルシネーション問題は精度の問題ではなく、UXの問題である
この論文では、ハルシネーションを研究するために専用の書道データサブセットを構築し、古代中国のテキストだけでなく、不鮮明な入力に対してOCRシステムを評価する際に知っておくべき2つの明確な失敗パターンを特定しています。
1つ目は、著者が「事前知識駆動の意味的補完」と呼ぶものです。筆画が曖昧または変形している場合(草書の書道では一般的です)、モデルは視覚的な側面ではなく言語モデルの側面に依存し、実際に存在するテキストではなく、文脈的に自然なテキストを出力します。これは冒頭で言及された「印詩の失敗」を一般化したものです。2つ目は、「切り抜きおよび検出による過剰認識」です。システムの領域検出ステップがテキストの周囲にわずかに誤った枠を描くと、隣接する筆画や背景ノイズを拾い上げ、それらを余分な、捏造された文字に変換し、流暢だが虚構の読み解きとして結合します。
これらの失敗モードの両方に共通する特性は、これらのモデルを基盤とした製品を構築するすべての人々を懸念させるべきものです。出力は、正しければ完全な捏造であっても、同じように自信に満ち、同じように適切にフォーマットされています。目に見える曖昧さの表現や、ユーザーに表示される低い信頼度スコア、あるいは「正しく読み取った」ことと「あり得そうなパターンにマッチングしている」ことを区別する何もないのです。カジュアルなユーザーにとって、これは「時折間違えるツール」と「答えをすでに独立して知っていない限り検出できない方法で時折間違えるツール」の違いです。
OCRの構築・選定において、なぜこれが重要なのか
もしあなたの文書がこのベンチマークの「簡単」な側(印刷ページ、現代的な手書き、品質の良いスキャン)に該当するものであれば、この知見はあなたの判断基準に大きな変化をもたらすものではありません。主流のOCRや一般的なVLM(ビジョン言語モデル)は、すでにそれらを相当程度適切に処理できるからです。しかし、この論文は、その自信がどこで崩壊するかを明確かつ計測可能な形で示しており、そのパターンは古代中国の遺物を超えて、劣化・異常・分布外(out-of-distribution)のソース素材を持つあらゆるOCRユースケース(古い手書き、色あせたレシート、損傷したフォーム、学習データが限られる非ラテン文字)に一般化されます。特に日本語(漢字+仮名)は縦書きで表記されることが多く、これは多くのOCR/VLMモデルにとって最も困難なケースの一つですが、もし対象論文が英語のみを対象としており縦書きテキストを無視している場合、それは漢字や縦書きレイアウトがカバーされていないことを意味し、日本語読者にとっては実用性に重要な欠落があります。
実際の評価に持ち込む価値のある3つのポイント:
-
本格的に困難で未知の入力に対して、汎用VLMは現在、専門のOCRモデルを上回っています。これは、専門化が勝利すると仮定して専用OCRモデルを基盤としたパイプラインを構築している人々にとって少し不愉快な事実ですが、マーケティング用のベンチマークではなく、実際の文書でその仮説を再テストする価値があります。
-
これらのシステムにおいて、信頼度と正解率はまだリンクされていません。このベンチマークでは、モデルは入力があいまいな場合、流暢で正しい答えと同様に、流暢だが誤った答えを容易に生成します。もしあなたの製品が、何らかの検証や信頼度シグナルなしにOCR出力をユーザーに直接提示している場合、劣化または異常な文書こそが、そのギャップをサポートチケット、あるいはそれ以上の問題に変える場所となります。
-
集計された精度数値は、カテゴリごとの崩壊を隠蔽します。「OCRは機能する」と主張するモデルは、あなたの特定の文書タイプで信頼する前に、この論文のような媒体別の内訳を独自に持つ必要があります。なぜなら、強い平均値は、ほぼ解決されたカテゴリと、ほとんど機能していないカテゴリの上に構築されている可能性があるからです。
論文が主張していないこと
著者らは2つの限界について率直に述べている。第一に、Ancient-Benchは文字レベルのバウンディングボックスではなく、行または領域レベルでテキストを注釈付けしているため、エンドツーエンドの認識を評価するには適しているが、細粒度のテキスト検出を評価するには適していない。これは将来の追加予定事項として明示されている。第二に、より興味深い点として、ソース画像は公開の博物館や図書館のアーカイブから由来するため、これらの資料の一部は、テストされているモデル自体のトレーニングデータ内にある可能性がある。これは公開ソースから構築されたベンチマークにとってよくある問題であり、何らかの形で報告されたスコアを人為的に難しく見せるのではなく、むしろスコアを上方に押し上げる方向に作用する。しかし、最良のモデルでさえ甲骨文字や青銅器銘文でひどく失敗していることを考えると、この注意書きは論文の主要な主張を和らげるには十分ではない。つまり、3,000年にわたる中国の遺物テキストの読み取りは、現時点では現在のAIが解決していない問題である。