AI阅读了一枚2000年前的印章,并即兴创作了一首诗
参考论文: Ancient-Bench: A Comprehensive Multi-millennial, Multi-medium, and Multi-script Benchmark for Ancient Chinese Artifact Text Recognition — Hiuyi Cheng, Nuo Xu, Yuyi Zhang, Xuhan Zheng, Wei Pan, Jing Zhang, Dezhi Peng, Minghui Liao, Yihua Teng, Jihao Wu, Haoyu Ren, Lianwen Jin
一枚印章、一句谚语,以及一个自创诗句的模型
场景是这样的。研究人员向一个视觉语言模型展示了一张2000年前中国印章的照片。印章上雕刻的文字是一句真实的古典谚语,大意是“世间滋味赏来无过菜根甜”。在测试中表现最强的OCR专家模型之一将其识别为“美酒归来无人问和赏”,这是一串不同的字符,但恰好听起来也像一句合理的古典诗句。而一个通用模型则做了更奇怪的事:它锁定了一个五字片段“赏来无人花”,并不断重复它,生成了一段读起来流畅但完全偏离印章实际内容的循环文本。
两个模型都没有停顿。它们都没有将这段文字标记为模糊不清。两者都返回了自信、语法正确、听起来具有历史合理性的中文,但两者都是错误的。这是Ancient-Bench的核心发现,这是一个由华南理工大学和华为发布的新基准测试,用于评估当今AI模型在读取刻、铸、刷、印于真实历史中国文物上的文字方面的能力。对于任何认为“AI现在可以阅读旧文档”是一个已解决的问题的人来说,这是一个有用的案例研究。
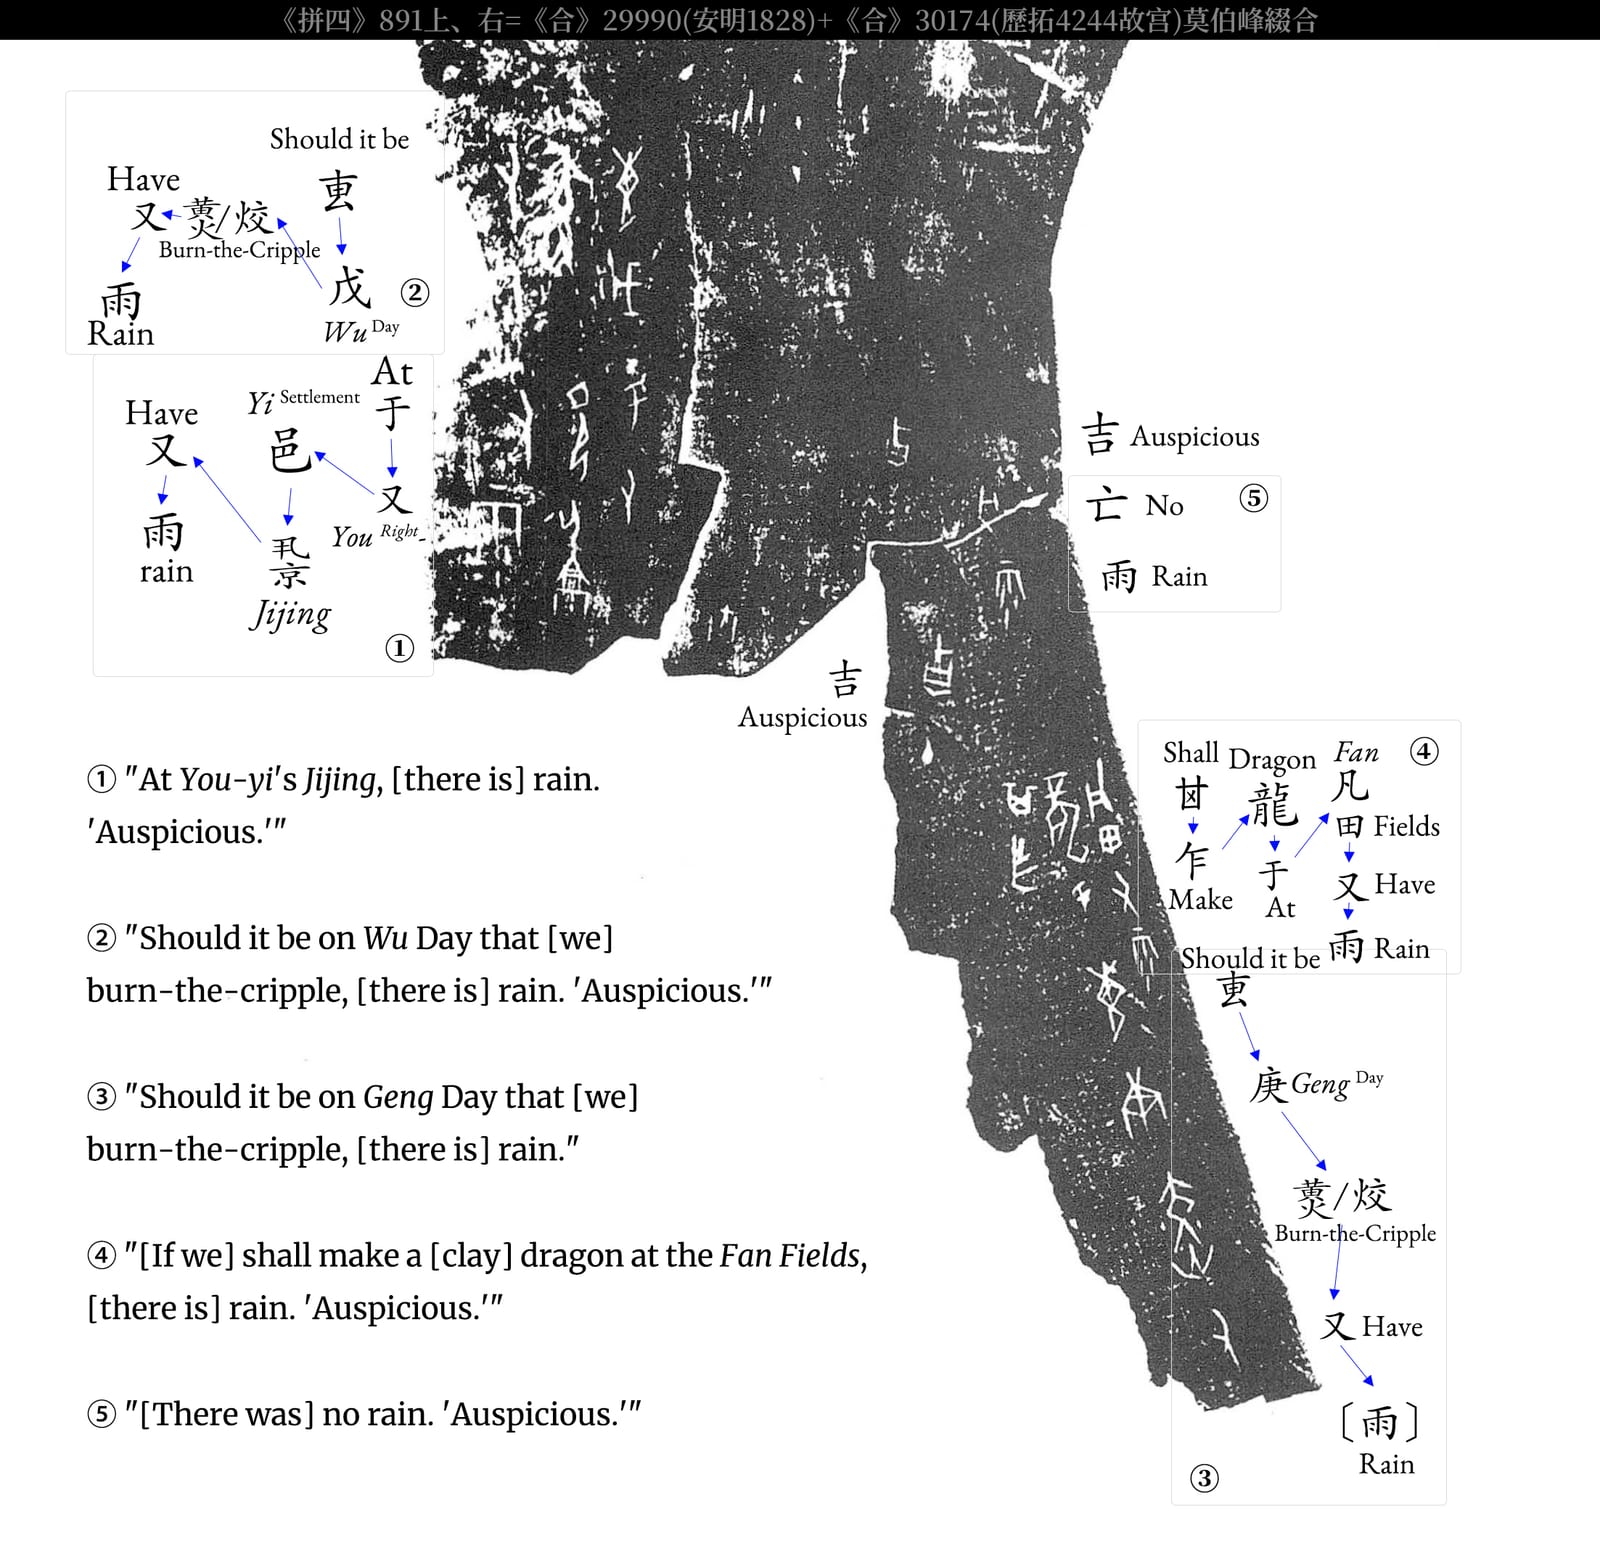
注释甲骨文拓片 - 合集29990和30174 - 雨占卜 — 由Quinlan718通过wikimedia提供,CC0 1.0。
为什么这并非单一的 OCR 问题
如果有人要求构建“中文 OCR”,他们脑海中浮现的很可能是一页印刷品:字体统一、墨色浓重、背景干净。这只是本基准测试中较简单的一端。而更具挑战性的一端,则是一组在现代读者看来完全不属于同一书写系统的文物。
中文书写系统在历史上经历了大约七种主要形态,而 Ancient-Bench 涵盖了所有这些形态:甲骨文(3000 多年前商代占卜师刻在龟甲和兽骨上)、金文(铸在礼器上)、篆书、隶书、楷书、草书和行书。每一种都是真正不同的字形集合,而不仅仅是字体的变化。一个在楷书中简单且广为人知的字符,在甲骨文中可能是一个抽象的象形文字,只有少数专家能够识别。
在此基础上,还叠加了九种不同的物理载体,因为书写表面改变了“文本”的外观:甲骨文和金文(简短密集的铭文,常有残缺或腐蚀)、竹简和木牍(装订成书的薄条,易变形和褪色)、丝绸手稿(脆弱的织物,经常受损)、印章(镜像雕刻的文字,有时为浮雕)、石碑和摩崖石刻(从风化岩石上拓印,图像中带有裂纹和风化痕迹)、木刻版书籍以及墨迹书法。阅读汉代竹简上的土地契约和明代挂轴上的草书诗作,实际上是在面对两个不同的识别问题,尽管它们使用相同的底层语言,但时间跨度超过三千年。
论文指出,现有的基准测试大多只选择其中一个维度并止步于此。有些涵盖多种书体,但仅限于印刷书籍。有些深入覆盖甲骨文,但不涉及其他内容。早期尝试构建多载体数据集的 MCHDoc 试图将几种载体拼接在一起,但它从现有的单载体数据集中抽取数据,且没有共享的标注规则,因此不同类别之间的数据并不可比。Ancient-Bench 的卖点在于构建一个数据集,诚实地同时涵盖所有三个维度:载体、书体和时期。
决定“正确”究竟意味着什么
在对古文识别模型进行评分之前,你必须先定义什么是正确的转录结果,而这实际上是一个真正的设计难题,而非仅仅是形式上的要求。
以甲骨文上的一个字符为例,它可能根本不存在于现代 Unicode 中。学者们有一种称为“隶定”的标准做法:将古文字形转换为后来可读的书写系统中的等价形式,就像你会解释一个古老的手写符号“等同于”现代字母,尽管它们看起来并不相似。Ancient-Bench 的标注人员必须逐字决定:给定的古文字形是否有公认的现代等价形式;是否应标记为“无法识别”的占位符,因为不存在等价形式;或者源机构自己的博物馆标签(通常为了面向大众而大幅简化)是否值得信赖。团队发现,博物馆注释经常将变体或传统字符规范化为现代简体形式以提高可读性,这悄然抹去了对历史研究至关重要的区别:例如,两个后来合并为一个简体形式的字符,在原始文本中承载着不同的含义。
论文通过三项标注标准解决了这一问题。符号标准化定义了如何标记重复字符、损坏或无法辨认的段落,以及存在于图像中但无法在任何字符集中输入的字符。字符标准化制定了处理这些古文字和变体形式的规则,倾向于“所见即所得”,而非静默简化。解析标准化涵盖布局:阅读顺序(中文竖排文本从上到下、从右到左;某些文物则不同)、换行、行间注释,以及印刷书页的哪些区域是实际文本,哪些是应被忽略的边注或装订伪影。
这并非论文中光鲜亮丽的部分,但 arguably 是最有用的贡献:为这一类文档提供了共享且可检查的“真实值”定义,否则合理的专家可能会在转录上产生分歧。二十名经过培训的标注人员为此工作了六个月,对照四个既定的古文字参考数据库进行交叉检查,并由单独的审核人员验证最终标签。
数据表现:无人突破 60%,部分任务几乎无法运行
最终数据集包含 2,700 张图像,源自 14 家国家级博物馆和图书馆,分布在九种媒介类型中(从 400 件书法作品到 200 件摩崖石刻),时间跨度约为公元前 1200 年至公元 1911 年。研究人员随后在该数据集上测试了 33 个模型:包括 GPT-5、Gemini 和 Claude 等闭源模型;Qwen 和 Kimi 等开源模型;以及一组专为文本提取而非通用对话而构建的专用文档 OCR 系统。每个模型的输出都使用两项指标与标准化转录文本进行评分:F1 值(预测字符与真实字符的匹配程度,对漏字和错字均进行惩罚)以及归一化编辑距离,这是一种字符级指标,衡量将模型猜测结果转换为正确答案所需的单字符编辑次数。
整体表现最佳的模型是字节跳动的 Doubao-seed-2-0-lite,其编辑距离为 52.08%,F1 值为 57.86%。直白地解读这一数据:在被要求解读中国古代文物时,测试中最强的系统平均正确识别率远低于五分之三。其他所有模型的表现更差。表现最好的专用 OCR 系统 HunyuanOCR 的 F1 值最高仅为 46.11%,明显落后于 Doubao、Gemini 和开源模型 Kimi K2.6(F1 值为 56.62%)等通用聊天模型。这确实颠覆了人们的预期:专为文档解析构建和营销的模型在此任务上输给了通用助手。
性能还因文物类型不同而出现显著分化,这种分化揭示了有用的信息。甲骨文几乎无解:即使是该特定任务中表现最好的 Gemini,F1 值也仅为 15.75%。金文的表现也好不到哪里去,最佳模型的 F1 值为 38.48%。这两类文物都涉及密集且古老的字形,没有现代等价物供模型进行模式匹配。印章则是另一个陷阱:由于印章铭文常引用古典诗词,模型会依赖其训练数据中的先验知识,生成听起来流畅但并非实际刻写的诗句,这正是开篇印章示例所描述的情况。与此同时,石碑通常保存着形态良好的隶书或楷书,且状况良好,最佳模型的 F1 值达到 88.88%,更接近真正可用的结果。
这些数字之间的差距(甲骨文低于 16%,石碑接近 89%)才是此处真正的发现,比任何单一的排行榜分数都更重要。“中国古代 OCR”并非模型具备或缺失的单一能力。它由数十种更细分的能力组成,而当前系统仅具备其中部分能力,而非全部。
幻觉问题是一个用户体验问题,而不仅仅是准确率问题
该论文构建了一个专门的书法子集,专门用于研究幻觉现象,并指出了两种截然不同的失败模式。如果你正在评估任何处理杂乱输入的 OCR 系统(而不仅仅是古代中文文本),了解这两种模式至关重要。
第一种是作者所称的“先验驱动的语义补全”:当笔画模糊或变形时(这在行草书法中很常见),模型会依赖其语言模型部分而非视觉部分,从而生成听起来合理但实际上并不存在的文本。这是开篇提到的“印章诗”失败案例的泛化。第二种是“裁剪和检测诱导的过度识别”:当系统自身的区域检测步骤在文本周围绘制了略微错误的框时,它会捕获相邻的笔画或背景噪声,并将它们转化为额外的、虚构的字符,从而拼接出一个流畅但伪造的解读。
这两种失败模式共享一个特性,这应该让任何基于这些模型构建产品的人感到担忧:无论输出是正确的还是完全虚构的,其外观都同样自信、格式同样规范。没有可见的保留意见,没有向用户展示更低的置信度分数,没有任何东西能区分“我正确读取了内容”和“我正在模式匹配到某种合理的内容”。对于普通用户来说,这意味着一个偶尔出错的工具和一个以你无法检测的方式偶尔出错的工具之间的区别——除非你已经独立知道答案,否则你无法察觉这种错误。
为什么这对构建或选择 OCR 很重要
如果你的文档看起来像这个基准测试中“容易”的那一端(打印页面、现代手写体、扫描质量尚可),那么这一切对你的决策影响不大;主流 OCR 和通用 VLM 已经能相当好地处理这些情况。但本文清晰地展示了这种信心在何处崩溃,并且这种模式可以泛化到古代中文文物之外的任何 OCR 使用场景:旧手写体、褪色收据、损坏表格、训练数据有限的非拉丁语系。值得注意的是,由于中文属于表意文字系统,字符数量庞大且排版密集,若某项研究仅覆盖英文或拉丁字母文本,其在中文场景下的适用性需格外审慎评估。
值得带入实际评估的三个要点:
通用 VLM 目前在真正困难、不熟悉的输入上胜过专用 OCR 模型。如果你基于“专业化取胜”的假设围绕专用 OCR 模型构建了流程,这会有些令人不安;值得在你实际的文档上重新测试这一假设,而不是依赖营销基准。
在这些系统中,置信度和正确性尚未挂钩。在这个基准测试中,模型产生流畅但错误的答案与流畅且正确的答案一样容易,尤其是在输入模糊时。如果你的产品直接将 OCR 输出展示给用户,而没有某种形式的验证或置信度信号,那么退化或不寻常的文档就是这种差距转化为支持工单(甚至更糟)的地方。
总体准确率数字掩盖了类别崩溃。一个声称“OCR 有效”的模型,在你信任它处理你的特定文档类型之前,需要有自己的类似本文的“按媒介细分”分析,因为一个强大的平均值可能是建立在一个几乎已解决的类别和另一个几乎无法工作的类别之上的。
论文未声称的内容
作者坦诚地指出了两个局限性。首先,Ancient-Bench 是在行或区域级别对文本进行标注,而非使用字符级的边界框,因此它适用于评估端到端识别性能,但不适用于评估细粒度的文本检测。他们已将此列为计划中的改进项。其次,也是更有趣的一点:由于源图像来自公共博物馆和图书馆档案,其中部分材料可能已经存在于正在测试的模型的训练数据中。这是任何基于公共来源构建的基准测试都面临的常见问题,如果有什么影响的话,它只会使报告的分数略微偏高,而不会使结果看起来人为地更难。鉴于即使是最好的模型在甲骨文和青铜器铭文上仍然表现糟糕,这一保留意见并没有削弱论文的主要观点:阅读 3000 年来的中国文物文本,目前仍然是当前人工智能尚未解决的问题。