Una IA leyó un sello de 2.000 años y acaba de inventar un poema
Basado en: Ancient-Bench: A Comprehensive Multi-millennial, Multi-medium, and Multi-script Benchmark for Ancient Chinese Artifact Text Recognition — Hiuyi Cheng, Nuo Xu, Yuyi Zhang, Xuhan Zheng, Wei Pan, Jing Zhang, Dezhi Peng, Minghui Liao, Yihua Teng, Jihao Wu, Haoyu Ren, Lianwen Jin
Un sello, un proverbio y un modelo que se inventó su propio poema
Aquí está el contexto. Los investigadores muestran a un modelo de visión y lenguaje una foto de un sello chino de 2.000 años de antigüedad. El texto grabado es un proverbio clásico real, algo así como "ningún sabor mundano supera la amargura de un vegetal de raíz" (世間滋味賞來無過菜根甜). Uno de los modelos especialistas en OCR más potentes de la prueba lo leyó como "美酒歸來無人問和賞", una cadena diferente de caracteres que, por casualidad, también suena como una línea plausible de poesía clásica. Un modelo de propósito general hizo algo aún más extraño: se fijó en un fragmento de cinco caracteres, "賞來無人花", y simplemente siguió repitiéndolo, generando un bucle que se lee con fluidez pero que no dice nada de lo que el sello realmente expresa.
Ningún modelo hizo una pausa. Ninguno marcó el pasaje como poco claro. Ambos devolvieron chino confiado, gramatical y con un sonido históricamente plausible, y ambos estaban equivocados. Ese es el hallazgo central de Ancient-Bench, una nueva batería de pruebas desarrollada por la South China University of Technology y Huawei que evalúa qué tan bien pueden los modelos de IA actuales leer texto tallado, fundido, pincelado e impreso en artefactos históricos chinos reales. Y es un estudio de caso útil para cualquiera que asuma que "la IA puede leer documentos antiguos ahora" es una cuestión ya resuelta.
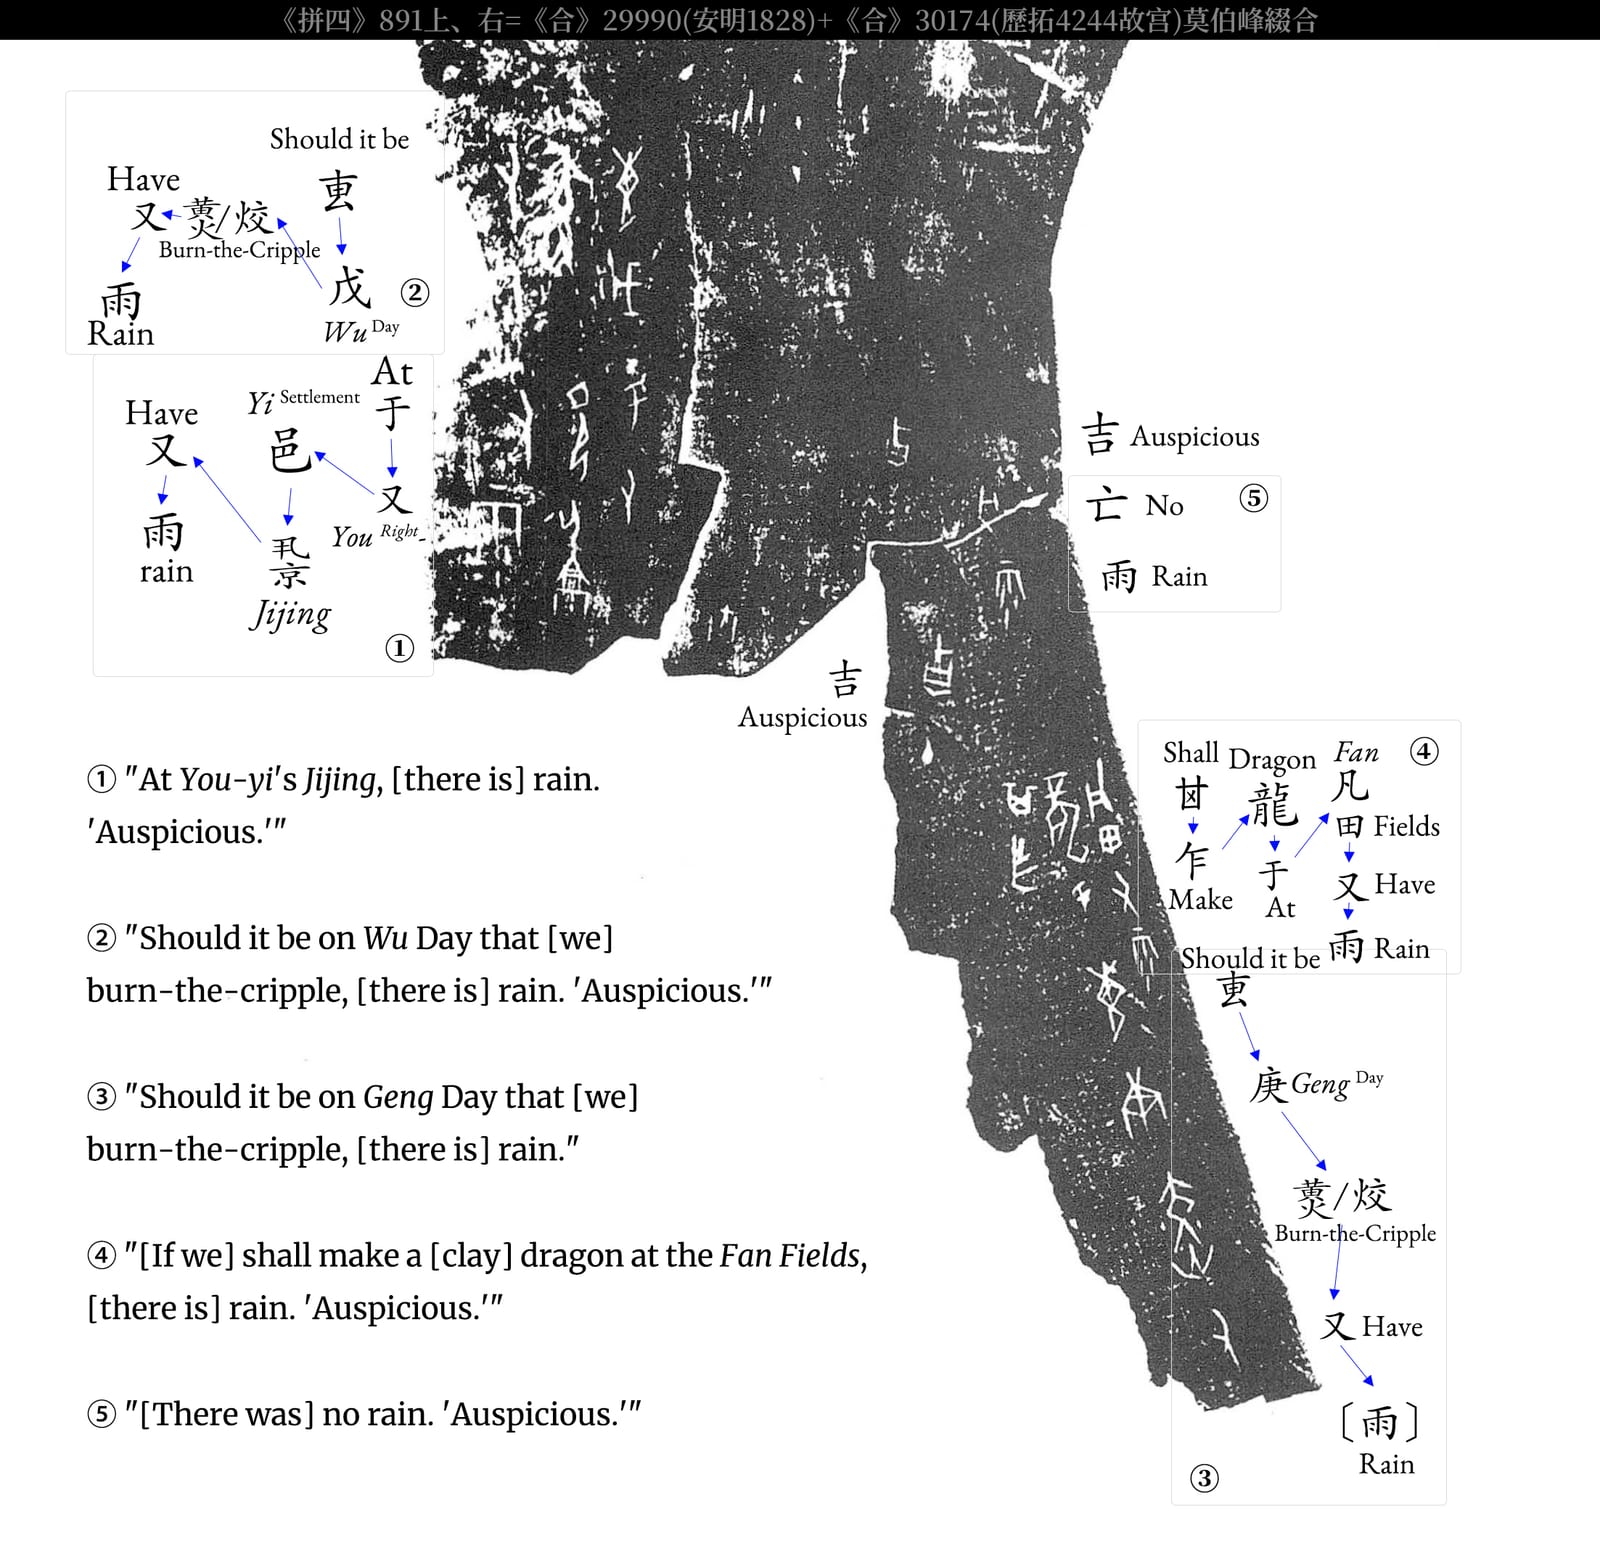
Inscripción en hueso oracular anotada - Heji 29990 y 30174 - Adivinación de la lluvia — por Quinlan718 vía wikimedia, CC0 1.0.
Por qué esto no es realmente un solo problema de OCR
Si le pide a alguien que construya "OCR para chino", probablemente se imagine una página impresa: tipografía consistente, tinta oscura y fondo limpio. Ese es el extremo fácil de este benchmark. El extremo difícil es un conjunto de artefactos que no comparten un sistema de escritura de ninguna manera que un lector moderno reconocería.
La escritura china ha pasado por aproximadamente siete formas principales a lo largo de su historia, y Ancient-Bench las cubre todas: escritura de huesos oraculares (grabada en caparazones de tortuga y huesos de animales por adivinos de la dinastía Shang, hace más de 3.000 años), escritura de bronce (fundida en vasos rituales), escritura sellada, escritura clerical, escritura regular, escritura cursiva y escritura semi-cursiva. Cada una es un conjunto genuinamente diferente de formas de caracteres, no solo un cambio de fuente. Un carácter que es un glifo simple y bien conocido en la escritura regular podría ser un pictograma abstracto en la escritura de huesos oraculares que solo unos pocos especialistas pueden leer.
Añada a eso nueve medios físicos diferentes, porque la superficie de escritura cambia lo que incluso significa "texto": huesos oraculares y bronces (inscripciones cortas y densas, a menudo astilladas o corroídas), tablillas de bambú y madera (tiras delgadas unidas en libros, propensas a deformarse y desvanecerse), manuscritos de seda (tejido frágil, frecuentemente dañado), sellos (texto grabado en imagen espejo, a veces en relieve), estelas de piedra e inscripciones en acantilados (calcos tomados de roca erosionada, con grietas y erosión incorporadas a la imagen), libros impresos con bloques de madera y caligrafía con tinta. Lea un contrato de tierras de la dinastía Han en una tablilla de bambú y un poema cursivo de la dinastía Ming en un pergamano colgante, y realmente está mirando dos problemas de reconocimiento diferentes que suceden en usar el mismo idioma subyacente, separados por más de tres milenios.
Los benchmarks existentes, argumenta el artículo, generalmente eligen uno de estos ejes y se detienen. Algunos cubren varios tipos de escritura pero solo en libros impresos. Otros cubren en profundidad los huesos oraculares pero nada más. Un intento anterior de un conjunto multimedio, MCHDoc, intentó unir varios medios, pero extrajo datos de conjuntos de datos de un solo medio existentes sin reglas de etiquetado compartidas, por lo que los números no eran realmente comparables entre categorías. La propuesta de Ancient-Bench es construir un único conjunto de datos que sea honesto sobre las tres dimensiones a la vez: medio, escritura y período de tiempo.
Decidir qué significa realmente "correcto"
Antes de poder evaluar un modelo en el reconocimiento de textos antiguos, debes decidir cómo se ve una transcripción correcta, y eso resulta ser un verdadero problema de diseño, no una mera formalidad.
Toma un carácter grabado en un hueso oracular. Es posible que no exista en absoluto en el Unicode moderno. Los académicos tienen una práctica estándar llamada transcripción (隶定): convertir una forma de carácter arcaico en su equivalente en un script posterior y legible, de la misma manera que podrías explicar que un símbolo manuscrito antiguo "es" una letra moderna, aunque no se parezca a ella. Los anotadores de Ancient-Bench tuvieron que decidir, carácter por carácter, si una forma arcaica dada tiene un equivalente moderno acordado, si debería marcarse con un marcador de posición de "ininteligible" porque no existe un equivalente, o si la etiqueta del museo de la institución fuente (que a menudo simplifica agresivamente para un público general) puede ser confiable en absoluto. El equipo descubrió que las anotaciones de los museos a menudo normalizan caracteres variantes o tradicionales en formas simplificadas modernas para mejorar la legibilidad, lo que borra silenciosamente distinciones que realmente importan para la investigación histórica: dos caracteres que luego se fusionaron en una sola forma simplificada, por ejemplo, tenían significados diferentes en los textos originales.
El artículo resuelve esto con tres estándares de anotación. La estandarización de símbolos define cómo marcar caracteres repetidos, pasajes dañados o ilegibles y caracteres que existen en la imagen pero no se pueden escribir en ningún conjunto de caracteres. La estandarización de caracteres establece las reglas para manejar esas formas arcaicas y variantes, favoreciendo el principio de "lo que ves es lo que obtienes" sobre la simplificación silenciosa. La estandarización de análisis cubre la disposición: orden de lectura (el texto chino vertical se lee de arriba a abajo y de derecha a izquierda; algunos artefactos tienen un orden diferente), saltos de línea, notas interlineales y qué regiones de una página de libro impreso son texto real frente a notas al margen o artefactos de encuadernación que deben ignorarse.
No es la parte más glamorosa del artículo, pero es probablemente la contribución más útil: una definición compartida y verificable de "verdad fundamental" (ground truth) para una categoría de documentos donde expertos razonables podrían discrepar sobre la transcripción. Veinte anotadores capacitados trabajaron en esto durante seis meses, verificando cruzadamente contra cuatro bases de datos de referencia paleográficas establecidas, con un revisor separado verificando las etiquetas finales.
Los números: nadie supera el 60% y algunas tareas apenas funcionan
El conjunto de datos final contiene 2.700 imágenes, procedentes de 14 museos y bibliotecas de ámbito nacional, distribuidas entre los nueve tipos de soportes (desde 400 piezas de caligrafía hasta 200 inscripciones en acantilados) y que abarcan aproximadamente desde el 1200 a.C. hasta el 1911 d.C. Los investigadores sometieron a prueba 33 modelos con este conjunto: modelos cerrados como GPT-5, Gemini y Claude; modelos abiertos como Qwen y Kimi; y un conjunto de sistemas especializados en OCR de documentos, diseñados específicamente para la extracción de texto y no para la conversación general. La salida de cada modelo se evaluó frente a las transcripciones estandarizadas utilizando dos métricas: F1 (qué cantidad de caracteres predichos coinciden con la realidad, penalizando tanto los caracteres omitidos como los inventados) y la distancia de edición normalizada, una medida a nivel de carácter que indica cuántas ediciones de un solo carácter serían necesarias para transformar la suposición del modelo en la respuesta correcta.
El mejor modelo en general, Doubao-seed-2-0-lite de ByteDance, alcanzó una distancia de edición del 52,08% y un F1 del 57,86%. Léase esto de forma sencilla: el sistema más potente probado acierta, en promedio, muy por debajo de tres de cada cinco caracteres cuando se le pide leer un artefacto chino antiguo. Todos los demás modelos obtienen peores resultados. El mejor especialista en OCR dedicado, HunyuanOCR, alcanza un máximo de 46,11% en F1, quedándose significativamente por detrás de modelos de chat de propósito general como Doubao, Gemini y el de pesos abiertos Kimi K2.6 (56,62% en F1). Esta es una verdadera inversión de lo que cabría esperar: los modelos construidos y comercializados específicamente para el análisis de documentos pierden ante asistentes de propósito general en esta tarea.
El rendimiento también se divide drásticamente según el tipo de artefacto, y esta división aporta información útil. La escritura en huesos oraculares está prácticamente sin resolver: incluso Gemini, el mejor rendimiento en esa tarea específica, logra solo un 15,75% en F1. Las inscripciones en bronce no son mucho mejores, con un 38,48% para el modelo líder. Ambas categorías implican formas de glifos antiguos y densos, sin equivalente moderno contra el cual un modelo pueda realizar una coincidencia de patrones. Los sellos constituyen su propia trampa: dado que las inscripciones en sellos citan comúnmente poesía clásica, los modelos recurren a sus prioris de datos de entrenamiento y producen poesía de sonido fluido que no es lo que realmente está tallado, tal como el ejemplo de sello del inicio. Mientras tanto, los estelas de piedra, que tienden a preservar una escritura clerical o regular bien formada en condiciones decentes, alcanzan un 88,88% en F1 para el modelo líder, acercándose a un resultado genuinamente usable.
La brecha entre esos números (menos del 16% en huesos oraculares, cerca del 89% en estelas) es el hallazgo real aquí, más que cualquier puntuación individual en un ranking. "El OCR de chino antiguo" no es una única capacidad que un modelo tenga o no tenga. Son decenas de capacidades más estrechas, y los sistemas actuales poseen algunas de ellas y no otras.
El problema de las alucinaciones es un problema de UX, no solo de precisión
El artículo construye un subconjunto de caligrafía separado específicamente para estudiar la alucinación, e identifica dos patrones de fallo distintos que vale la pena conocer si estás evaluando cualquier sistema OCR en entradas desordenadas, no solo texto chino antiguo.
El primero es lo que los autores llaman completación semántica impulsada por el prior: cuando los trazos son ambiguos o deformados (lo cual es normal en la caligrafía cursiva), el modelo recurre a su mitad de modelo de lenguaje en lugar de a su mitad visual, y produce texto que suena correcto en lugar de texto que realmente está allí. Este es el fallo del poema en sello del inicio, generalizado. El segundo es el sobre-reconocimiento inducido por el recorte y la detección: cuando el propio paso de detección de regiones del sistema dibuja un cuadro ligeramente incorrecto alrededor del texto, recoge trazos vecinos o ruido de fondo y los convierte en caracteres adicionales e inventados, cosiendo una lectura fluida pero fabricada.
Ambos modos de fallo comparten una propiedad que debería preocupar a cualquiera que construya un producto sobre estos modelos: la salida se ve exactamente igual de confiable, exactamente igual de bien formateada, ya sea que esté correcta o completamente inventada. No hay duda visible, no hay una puntuación de confianza más baja mostrada al usuario, nada que distinga "leí esto correctamente" de "estoy haciendo pattern-matching a algo plausible". Para un usuario casual, esa es la diferencia entre una herramienta que ocasionalmente se equivoca y una herramienta que ocasionalmente se equivoca de una manera que no puedes detectar sin saber la respuesta de manera independiente.
Por qué importa si estás construyendo o eligiendo OCR
Si tus documentos se parecen al extremo fácil de este benchmark (páginas impresas, escritura a mano moderna, escaneos decentes), nada de esto cambia mucho tu cálculo; el OCR convencional y los VLMs generales ya manejan eso razonablemente bien. Pero este artículo es una demostración limpia y medida de dónde se rompe esa confianza, y el patrón se generaliza más allá de los artefactos chinos antiguos a cualquier caso de uso de OCR con material fuente degradado, inusual o fuera de distribución: escritura a mano antigua, recibos desvanecidos, formularios dañados, scripts no latinos con datos de entrenamiento limitados.
Tres conclusiones que vale la pena llevar a una evaluación real:
Los VLMs de propósito general actualmente superan a los modelos de OCR especializados en entradas genuinamente difíciles y desconocidas. Eso es un poco incómodo si has construido una tubería alrededor de un modelo de OCR dedicado bajo la suposición de que la especialización gana, y vale la pena volver a probar esa suposición en tus documentos reales en lugar de un benchmark de marketing.
La confianza y la corrección no están vinculadas en estos sistemas aún. En este benchmark, los modelos producen respuestas fluidas e incorrectas tan fácilmente como respuestas fluidas y correctas, especialmente cuando la entrada es ambigua. Si tu producto muestra la salida de OCR directamente a un usuario sin alguna forma de verificación o señal de confianza, los documentos degradados o inusuales son donde esa brecha se convierte en un ticket de soporte, o peor.
Los números de precisión agregada ocultan el colapso de categorías. Un modelo que afirma "el OCR funciona" necesita su propia versión del desglose por medio de este artículo antes de confiar en él en tu tipo específico de documento, porque un promedio fuerte puede construirse sobre una categoría que está casi resuelta y otra que apenas funciona.
Lo que el artículo no afirma
Los autores son transparentes sobre dos limitaciones. En primer lugar, Ancient-Bench anota el texto a nivel de línea o región, no con cajas delimitadoras a nivel de carácter, por lo que es útil para puntuar el reconocimiento de extremo a extremo, pero no para evaluar la detección de texto de grano fino. Han señalado que esta es una adición planificada. En segundo lugar, y más interesante: dado que las imágenes de origen provienen de archivos públicos de museos y bibliotecas, es posible que parte de este material ya se encuentre dentro de los datos de entrenamiento de los mismos modelos que se están probando. Este es un problema familiar para cualquier benchmark construido a partir de fuentes públicas, y, en todo caso, sesga los resultados en una dirección, empujando ligeramente las puntuaciones reportadas hacia arriba en lugar de hacer que los resultados parezcan artificialmente más difíciles. Dado que incluso los mejores modelos siguen fallando gravemente en los huesos oráculo y las inscripciones en bronce, esta advertencia no suaviza mucho el punto principal del artículo: leer 3.000 años de texto de artefactos chinos sigue siendo, por ahora, un problema que la IA actual no ha resuelto.