Uma IA leu um selo de 2.000 anos e acabou compondo um poema
Baseado em: Ancient-Bench: A Comprehensive Multi-millennial, Multi-medium, and Multi-script Benchmark for Ancient Chinese Artifact Text Recognition — Hiuyi Cheng, Nuo Xu, Yuyi Zhang, Xuhan Zheng, Wei Pan, Jing Zhang, Dezhi Peng, Minghui Liao, Yihua Teng, Jihao Wu, Haoyu Ren, Lianwen Jin
Um selo, um provérbio e um modelo que compôs seu próprio poema
Aqui está o cenário. Pesquisadores mostram a um modelo de visão-linguagem uma foto de um selo chinês de 2.000 anos. O texto gravado é um provérbio clássico real, algo como "nenhum sabor mundano supera a amargura de um vegetal raiz" (世間滋味賞來無過菜根甜). Um dos modelos especialistas em OCR mais fortes no teste leu-o como "美酒歸來無人問和賞", uma sequência diferente de caracteres que também soa como um verso plausível de poesia clássica. Um modelo de propósito geral fez algo ainda mais estranho: fixou-se em um fragmento de cinco caracteres, "賞來無人花", e simplesmente continuou repetindo-o, gerando um loop que soa fluente, mas não diz nada do que o selo realmente afirma.
Nenhum dos modelos fez uma pausa. Nenhum sinalizou a passagem como pouco clara. Ambos retornaram chinês confiante, gramatical e historicamente plausível, e ambos estavam errados. Esse é o achado central do Ancient-Bench, um novo benchmark da South China University of Technology e Huawei que testa o quão bem os modelos de IA atuais conseguem ler textos gravados, fundidos, pintados com pincel e impressos em artefatos históricos chineses reais. E é um estudo de caso útil para qualquer um que assuma que "a IA já consegue ler documentos antigos" seja uma questão resolvida.
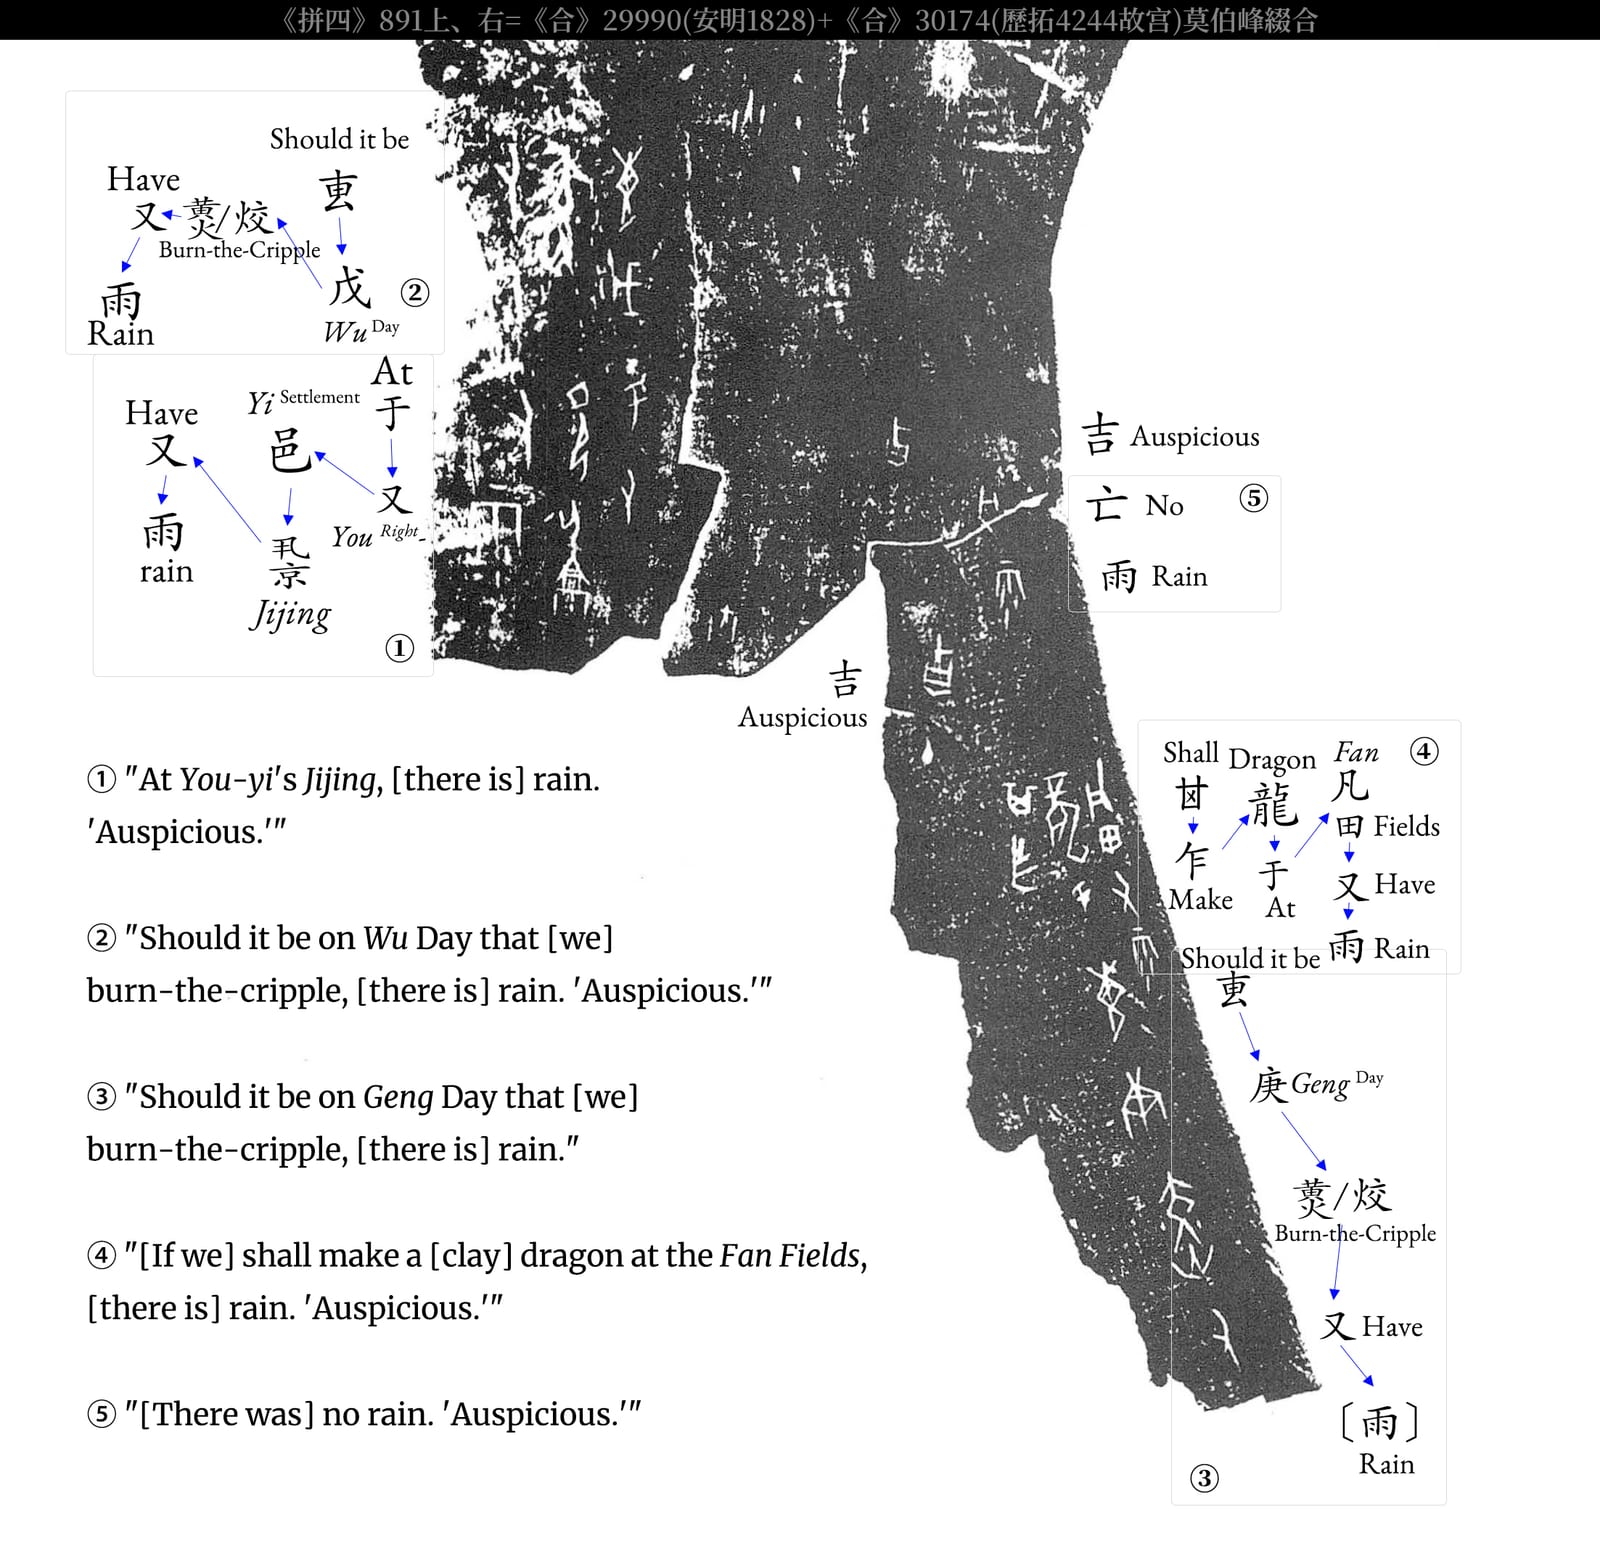
Inscrição Anotada em Ossos Oracle - Heji 29990 e 30174 - Adivinhação da Chuva — por Quinlan718 via wikimedia, CC0 1.0.
Por que isso não é realmente um único problema de OCR
Peça a alguém para construir um "OCR chinês" e provavelmente imaginarão uma página impressa: fonte consistente, tinta escura, fundo limpo. Esse é o extremo fácil deste benchmark. O extremo difícil é um conjunto de artefatos que não compartilham um sistema de escrita de nenhuma forma que um leitor moderno reconheceria.
A escrita chinesa passou por aproximadamente sete formas principais ao longo de sua história, e o Ancient-Bench cobre todas elas: escrita em ossos oraculares (gravada em cascas de tartaruga e ossos de animais por adivinhos da dinastia Shang, há mais de 3.000 anos), escrita em bronze (fundida em vasos rituais), escrita selo, escrita clerical, escrita regular, escrita cursiva e escrita corrida. Cada uma é um conjunto genuinamente diferente de formas de caracteres, não apenas uma mudança de fonte. Um caractere que é um glifo simples e bem conhecido na escrita regular pode ser um pictograma abstrato na escrita em ossos oraculares que apenas alguns especialistas conseguem ler.
Adicione a isso nove mídias físicas diferentes, porque a superfície de escrita muda a aparência do que é "texto": ossos oraculares e bronzes (inscrições curtas e densas, frequentemente lascadas ou corroídas), tábuas de bambu e madeira (faixas finas amarradas em livros, propensas a empenar e desbotar), manuscritos em seda (tecido frágil, frequentemente danificado), selos (texto gravado em imagem espelhada, às vezes em relevo), estelas de pedra e inscrições em penhascos (rubricagens tiradas de rochas desgastadas, com rachaduras e erosão incorporadas à imagem), livros impressos com blocos de madeira e caligrafia em tinta. Leia um contrato de terra da dinastia Han em uma tábua de bambu e um poema cursivo da dinastia Ming em um rolo pendurado, e você está realmente olhando para dois problemas de reconhecimento diferentes que acontecem de usar o mesmo idioma subjacente, separados por mais de três milênios.
Os benchmarks existentes, argumenta o artigo, geralmente escolhem um desses eixos e param por aí. Alguns cobrem vários tipos de escrita, mas apenas em livros impressos. Alguns cobrem ossos oraculares em profundidade, mas nada mais. Uma tentativa anterior de um conjunto multimídia, o MCHDoc, tentou unir várias mídias, mas utilizou conjuntos de dados de mídia única existentes sem regras de rotulagem compartilhadas, portanto, os números não eram realmente comparáveis entre categorias. A proposta do Ancient-Bench é construir um único conjunto de dados que seja honesto sobre todas as três dimensões simultaneamente: mídia, escrita e período histórico.
Definindo o que significa "correto"
Antes de avaliar um modelo em reconhecimento de textos antigos, você precisa decidir como deve ser uma transcrição correta, o que se revela um verdadeiro problema de design, não uma mera formalidade.
Considere um caractere gravado em um osso de oráculo. Ele pode não existir no Unicode moderno. Os estudiosos têm uma prática padrão chamada transcrição (隶定): converter uma forma arcaica de caractere em seu equivalente em um script posterior e legível, da mesma forma que você poderia explicar que um símbolo manuscrito antigo "é" uma letra moderna, mesmo que não se pareça com ela. Os anotadores do Ancient-Bench tiveram que decidir, caractere por caractere, se uma determinada forma arcaica tem um equivalente moderno acordado, se deve ser marcada com um placeholder de "ilegível" porque nenhum equivalente existe, ou se a própria etiqueta do museu da instituição fonte (que frequentemente simplifica agressivamente para um público geral) pode ser confiada. A equipe descobriu que as anotações dos museus frequentemente normalizam variantes ou caracteres tradicionais em formas simplificadas modernas para legibilidade, o que silenciosamente apaga distinções que realmente importam para a pesquisa histórica: dois caracteres que foram posteriormente fundidos em uma única forma simplificada, por exemplo, carregavam significados diferentes nos textos originais.
O artigo resolve isso com três padrões de anotação. A padronização de símbolos define como marcar caracteres repetidos, passagens danificadas ou ilegíveis e caracteres que existem na imagem, mas não podem ser digitados em nenhum conjunto de caracteres. A padronização de caracteres estabelece as regras para lidar com essas formas arcaicas e variantes, privilegiando o que você vê é o que você obtém em vez da simplificação silenciosa. A padronização de análise cobre o layout: ordem de leitura (o texto chinês vertical corre de cima para baixo, da direita para a esquerda; alguns artefatos correm de maneira diferente), quebras de linha, notas interlineares e quais regiões de uma página de livro impresso são texto real versus notas de margem ou artefatos de encadernação que devem ser ignorados.
Não é a parte mais glamourosa do artigo, mas é, argumentavelmente, a contribuição mais útil: uma definição compartilhada e verificável de "verdade fundamental" (ground truth) para uma categoria de documentos onde especialistas razoáveis podem, de outra forma, discordar sobre a transcrição. Vinte anotadores treinados trabalharam nisso por seis meses, verificando cruzadamente contra quatro bancos de dados de referência paleográficos estabelecidos, com um revisor separado verificando os rótulos finais.
Os números: ninguém ultrapassa 60%, e algumas tarefas mal funcionam
O conjunto de dados final contém 2.700 imagens, provenientes de 14 museus e bibliotecas de nível nacional, distribuídas entre os nove tipos de mídia (de 400 peças de caligrafia a 200 inscrições em penhascos) e abrangendo aproximadamente de 1200 a.C. a 1911 d.C. Os pesquisadores então testaram 33 modelos contra ele: modelos fechados como GPT-5, Gemini e Claude; modelos abertos como Qwen e Kimi; e um conjunto de sistemas especialistas de OCR de documentos construídos especificamente para extração de texto, em vez de conversação geral. A saída de cada modelo foi pontuada em comparação com as transcrições padronizadas usando duas métricas: F1 (quantos caracteres previstos correspondem à verdade fundamental, penalizando tanto caracteres perdidos quanto inventados) e distância de edição normalizada, uma medida em nível de caractere de quantas edições de caractere único seriam necessárias para transformar o palpite do modelo na resposta correta.
O melhor modelo geral, o Doubao-seed-2-0-lite da ByteDance, atingiu 52,08% de distância de edição e 57,86% de F1. Leia isso claramente: o sistema mais forte testado acerta, em média, bem menos de três em cada cinco caracteres quando você pede que leia um artefato chinês antigo. Todos os outros modelos performam pior. O melhor especialista OCR dedicado, o HunyuanOCR, atinge no máximo 46,11% de F1, ficando significativamente atrás de modelos de chat de uso geral como Doubao, Gemini e o de pesos abertos Kimi K2.6 (56,62% de F1). Essa é uma verdadeira inversão do que se esperaria: modelos construídos e comercializados especificamente para análise de documentos perdem para assistentes de uso geral nesta tarefa.
O desempenho também se divide drasticamente por tipo de artefato, e essa divisão revela algo útil. A escrita em ossos de oráculo está próxima de ser um problema não resolvido: mesmo o Gemini, o melhor desempenho nessa tarefa específica, consegue apenas 15,75% de F1. As inscrições em bronze não são muito melhores, com 38,48% para o modelo líder. Ambas as categorias envolvem formas de glifos densas e antigas, sem equivalente moderno contra o qual um modelo possa fazer correspondência de padrões. Os selos são uma armadilha à parte: como as inscrições de selos frequentemente citam poesia clássica, os modelos recorrem aos seus priors de dados de treinamento e produzem poesia que soa fluente, mas que não é o que está realmente gravado, exatamente como o exemplo de selo da introdução. Enquanto isso, as estelas de pedra, que tendem a preservar a escrita clerical ou regular bem formada em boas condições, atingem 88,88% de F1 para o modelo líder, mais próximo de um resultado genuinamente utilizável.
A lacuna entre esses números (menos de 16% em ossos de oráculo, perto de 89% em estelas) é a verdadeira descoberta aqui, mais do que qualquer pontuação isolada em um ranking. "OCR chinês antigo" não é uma única capacidade que um modelo tem ou não. São dezenas de capacidades mais estreitas, e os sistemas atuais possuem algumas delas, mas não outras.
O problema da alucinação é um problema de UX, não apenas de precisão
O artigo constrói um subconjunto de caligrafia separado especificamente para estudar a alucinação e identifica dois padrões de falha distintos que valem a pena conhecer se você estiver avaliando qualquer sistema de OCR em entradas desordenadas, não apenas texto chinês antigo.
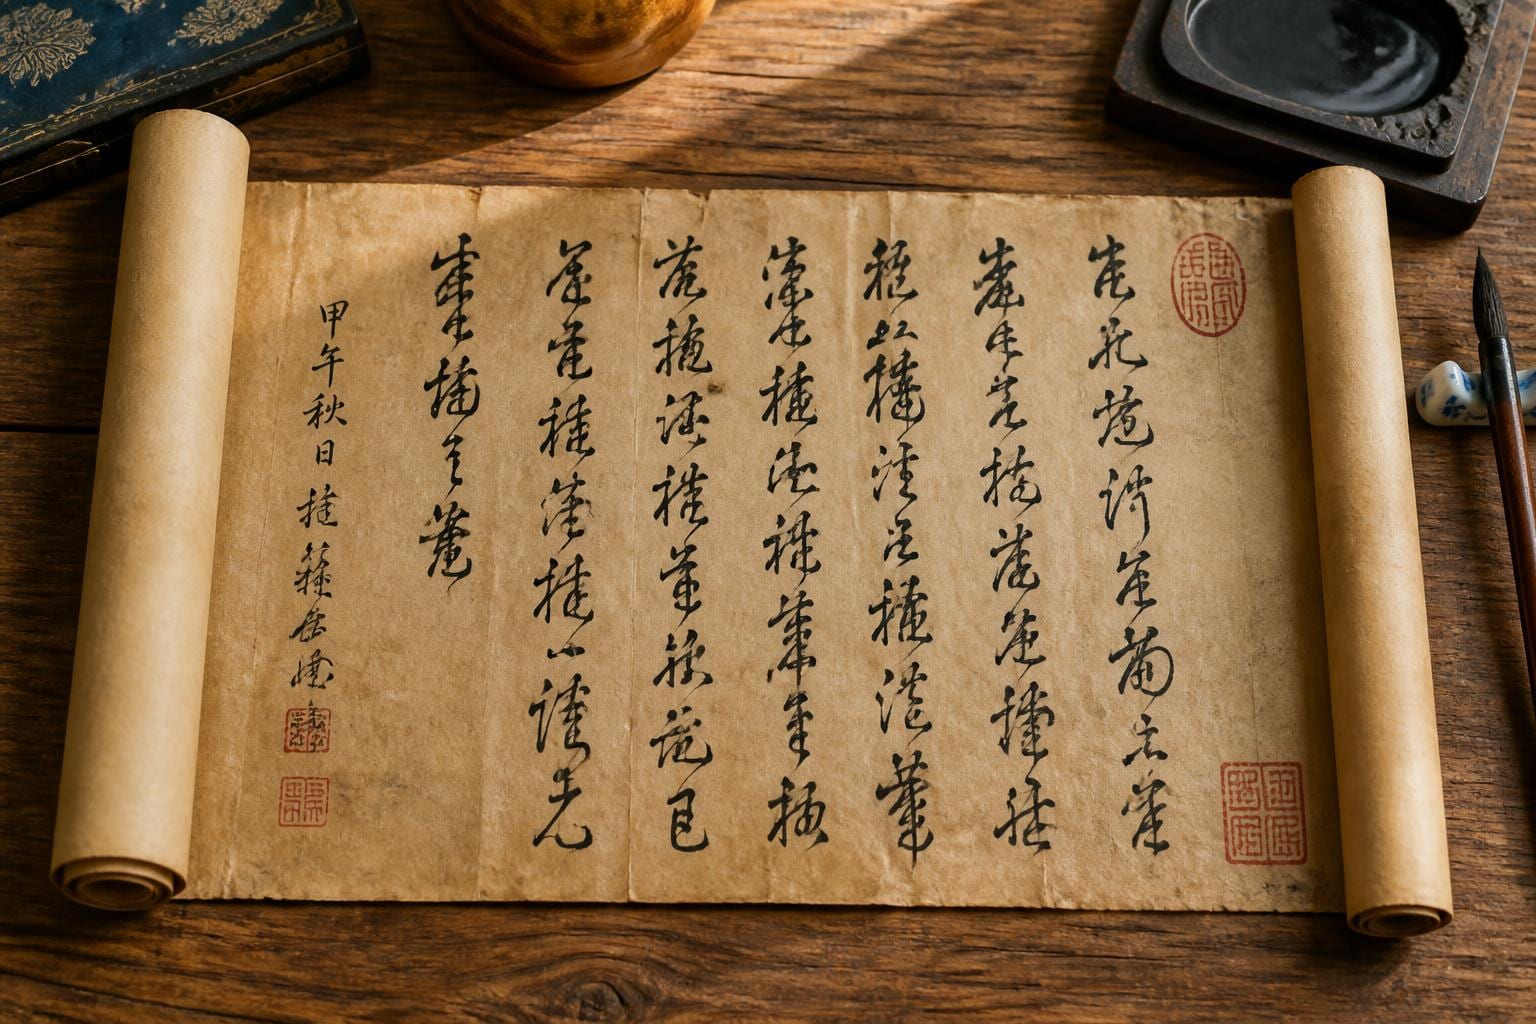
O primeiro é o que os autores chamam de conclusão semântica guiada por prior: quando os traços são ambíguos ou deformados (o que é normal na caligrafia cursiva), o modelo recorre à sua metade de modelo de linguagem em vez de sua metade de visão, e produz texto que soa certo em vez de texto que está realmente lá. Esta é a falha do selo-poema do início, generalizada. O segundo é o excesso de reconhecimento induzido por recorte e detecção: quando a própria etapa de detecção de região do sistema desenha uma caixa ligeiramente errada ao redor do texto, ele capta traços vizinhos ou ruído de fundo e os transforma em caracteres extras e inventados, costurando-os em uma leitura fluente, mas fabricada.
Ambos os modos de falha compartilham uma propriedade que deve preocupar qualquer pessoa que esteja construindo um produto com base nesses modelos: a saída parece exatamente tão confiante, exatamente tão bem formatada, seja ela correta ou completamente inventada. Não há hesitação visível, não há pontuação de confiança mais baixa apresentada ao usuário, nada que distinga "li isso corretamente" de "estou fazendo correspondência de padrões com algo plausível". Para um usuário casual, essa é a diferença entre uma ferramenta que está ocasionalmente errada e uma ferramenta que está ocasionalmente errada de uma maneira que você não pode detectar sem já saber a resposta de forma independente.
Por que isso importa se você está construindo ou escolhendo OCR
Se seus documentos se assemelham ao extremo fácil deste benchmark (páginas impressas, caligrafia moderna, digitalizações de boa qualidade), nada disso altera significativamente sua análise; o OCR convencional e os VLMs de propósito geral já lidam com isso de forma razoável. Mas este artigo é uma demonstração clara e medida de onde essa confiança se desfaz, e o padrão se generaliza para além de artefatos chineses antigos para qualquer caso de uso de OCR com material de origem degradado, incomum ou fora da distribuição: caligrafia antiga, recibos desbotados, formulários danificados, scripts não latinos com dados de treinamento limitados.
Três pontos importantes para levar em uma avaliação real:
VLMs de propósito geral atualmente superam modelos de OCR especializados em entradas genuinamente difíceis e desconhecidas. Isso é um pouco desconfortável se você construiu um pipeline em torno de um modelo de OCR dedicado com a suposição de que a especialização vence, e vale a pena retestar essa suposição nos seus documentos reais, em vez de em um benchmark de marketing.
Confiança e correção ainda não estão vinculadas nestes sistemas. Neste benchmark, os modelos produzem respostas fluentes e erradas tão facilmente quanto respostas fluentes e corretas, especialmente quando a entrada é ambígua. Se seu produto apresenta a saída do OCR diretamente ao usuário sem algum tipo de verificação ou sinal de confiança, documentos degradados ou incomuns são onde essa lacuna se transforma em um chamado de suporte, ou pior.
Números agregados de precisão escondem o colapso de categorias. Um modelo que afirma "o OCR funciona" precisa de sua própria versão da análise por meio deste artigo antes que você confie nele no seu tipo específico de documento, porque uma média forte pode ser construída sobre uma categoria quase resolvida e outra que mal funciona.
O que o artigo não alega
Os autores são diretos sobre duas limitações. Primeiro, o Ancient-Bench anota o texto no nível de linha ou região, e não com caixas delimitadoras (bounding boxes) no nível de caractere, portanto é bom para pontuar o reconhecimento de ponta a ponta, mas não para avaliar a detecção de texto de grão fino. Eles sinalizaram isso como uma adição planejada. Segundo, e mais interessante: como as imagens de origem vêm de arquivos públicos de museus e bibliotecas, parte desse material pode já estar presente nos dados de treinamento dos próprios modelos que estão sendo testados. Esse é um problema familiar para qualquer benchmark construído a partir de fontes públicas e, se houver qualquer viés, ele tende a aumentar as pontuações relatadas, em vez de tornar os resultados artificialmente mais difíceis. Considerando que até os melhores modelos ainda falham gravemente na leitura de ossos oraculares e inscrições em bronze, essa ressalva não ameniza muito o ponto principal do artigo: ler 3.000 anos de textos de artefatos chineses continua sendo, por enquanto, um problema que a IA atual não resolveu.