एक AI ने 2,000 साल पुराने मुहर को पढ़ा और अभी-अभी एक कविता बनाई
आधारित शोध-पत्र: Ancient-Bench: A Comprehensive Multi-millennial, Multi-medium, and Multi-script Benchmark for Ancient Chinese Artifact Text Recognition — Hiuyi Cheng, Nuo Xu, Yuyi Zhang, Xuhan Zheng, Wei Pan, Jing Zhang, Dezhi Peng, Minghui Liao, Yihua Teng, Jihao Wu, Haoyu Ren, Lianwen Jin
एक मुहर, एक कहावत, और एक ऐसा मॉडल जिसने अपनी ही कविता रच ली
यहाँ स्थिति कुछ इस प्रकार है। शोधकर्ताओं ने एक विज़न-लैंग्वेज मॉडल को चीन की 2,000 वर्ष पुरानी एक मुहर की तस्वीर दिखाई। उस पर उकेरी गई वास्तविक शास्त्रीय कहावत थी, जो कुछ इस प्रकार थी: "जगत के स्वादों में जड़-सब्जी की कड़वाहती से बेहतर कुछ नहीं" (世間滋味賞來無過菜根甜)। परीक्षण में शामिल सबसे शक्तिशाली OCR विशेषज्ञ मॉडलों में से एक ने इसे "美酒歸來無人問和賞" के रूप में पढ़ा, जो वर्णों का एक अलग क्रम था जो कि शास्त्रीय कविता की एक संभावनीय पंक्ति जैसा ही लगता था। एक सामान्य उद्देश्य वाले मॉडल ने कुछ और अजीब किया: इसने पाँच-अक्षरों वाले एक टुकड़े, "賞來無人花," पर ध्यान केंद्रित किया और उसे बार-बार दोहराने लगा, जिससे एक ऐसा लूप बना जो प्रवाहमय था परंतु मुहर पर लिखे वास्तविक अर्थ को व्यक्त नहीं करता था।
न तो कोई मॉडल रुका और न ही उसने उस अंश को अस्पष्ट बताया। दोनों ने आत्मविश्वास से भरे, व्याकरणिक और ऐतिहासिक रूप से संभावनीय लगने वाले चीनी वाक्यांश प्रस्तुत किए, और दोनों गलत थे। दक्षिण चीन विश्वविद्यालय और हुआवेई द्वारा विकसित Ancient-Bench नामक नए बेंचमार्क का यह मुख्य निष्कर्ष है, जो यह परीक्षण करता है कि आज के AI मॉडल वास्तविक ऐतिहासिक चीनी कलाकृतियों पर उकेरी, ढाली, ब्रश से लिखी और मुद्रित गई पाठ को कितनी अच्छी तरह पढ़ सकते हैं। और यह उन सभी के लिए एक उपयोगी केस स्टडी है जो यह मानते हैं कि "AI अब पुराने दस्तावेज़ पढ़ सकता है" एक निश्चित प्रश्न है।
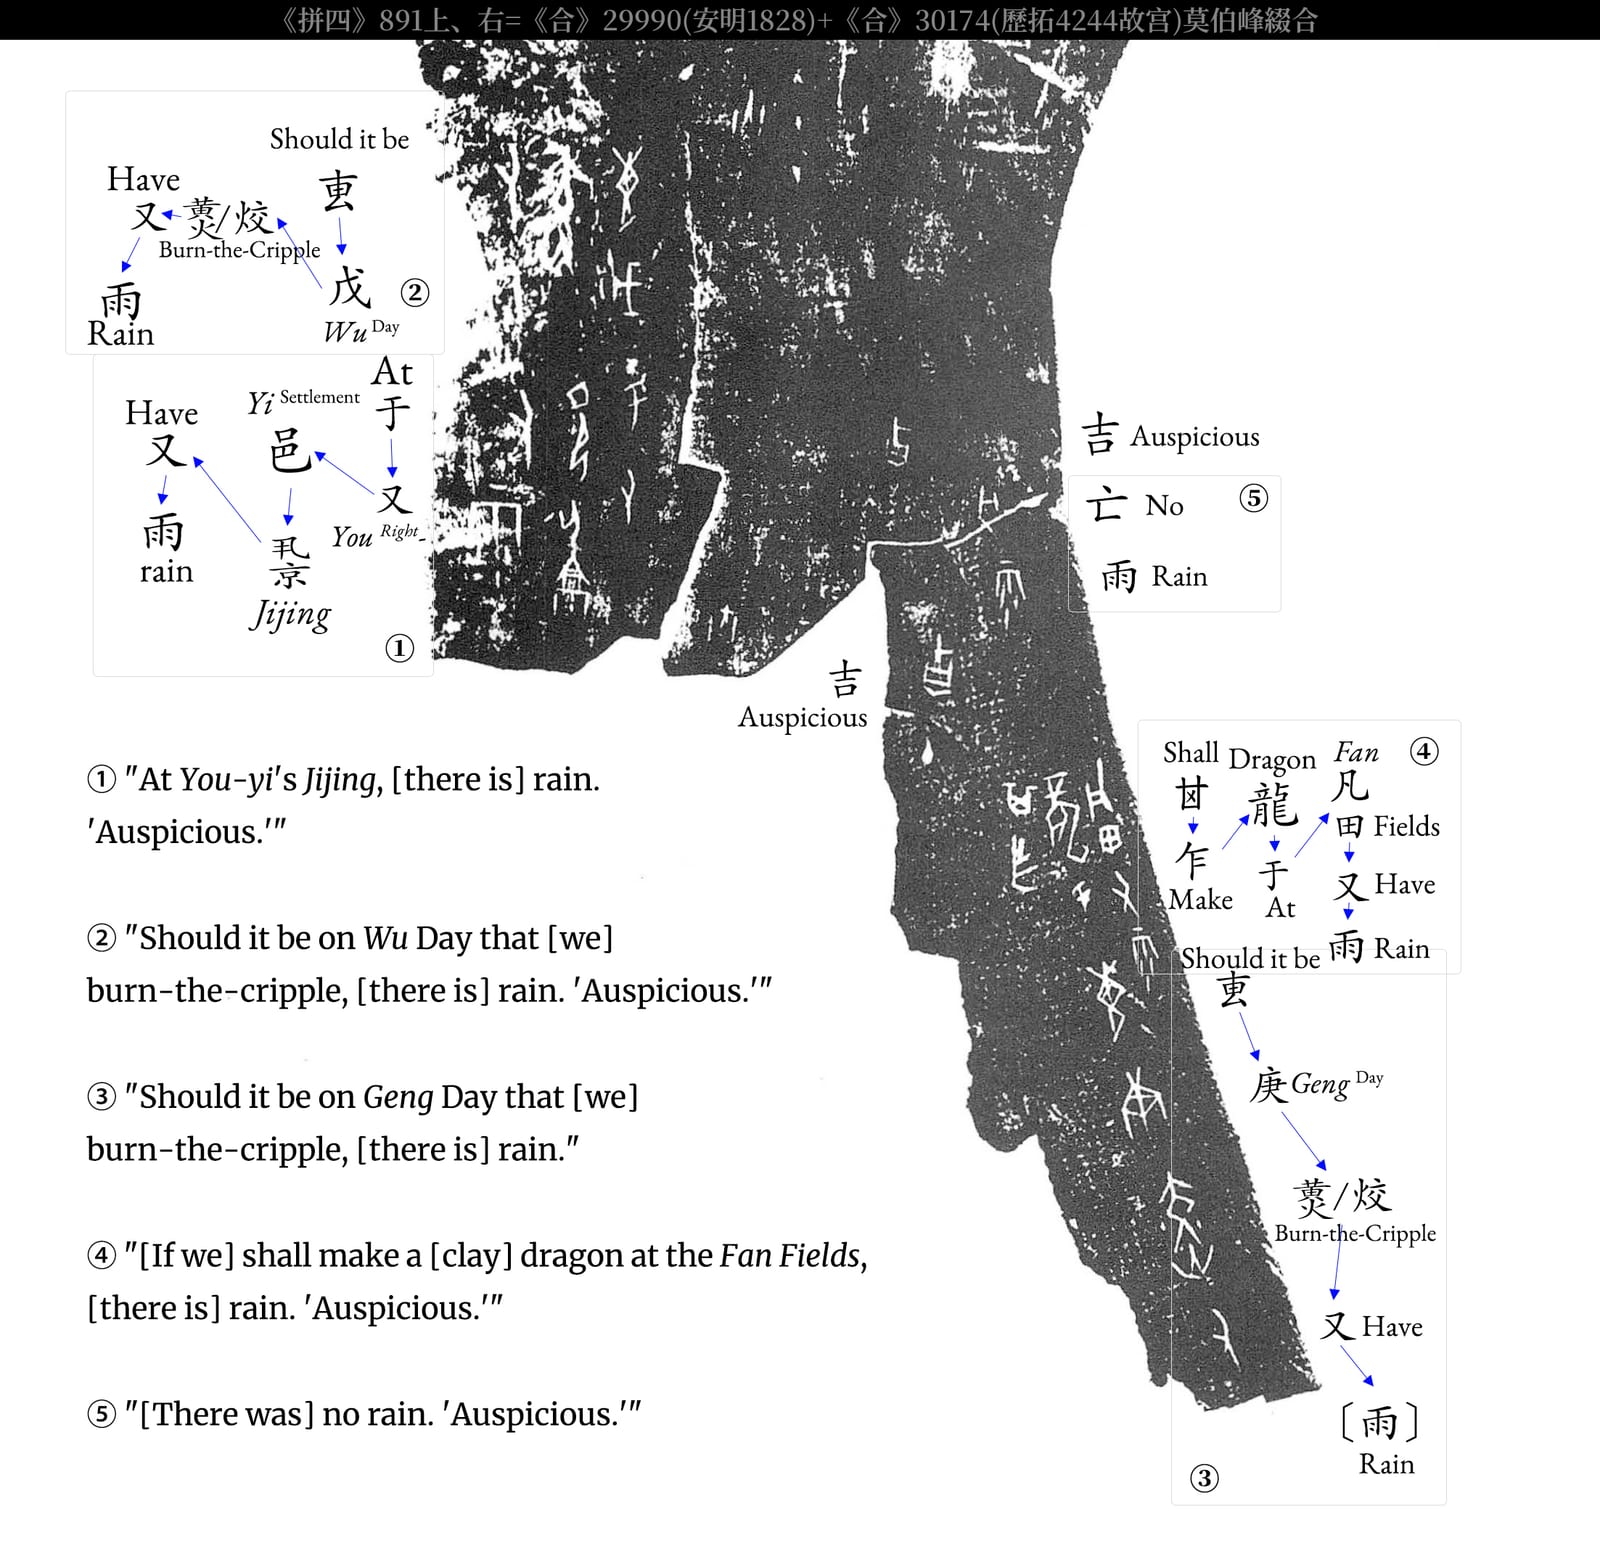
टिप्पणीयित हड्डी-शेल्ड लिपि - Heji 29990 और 30174 - वर्षा भविष्यवाणी — Quinlan718 द्वारा wikimedia के माध्यम से, CC0 1.0.
यह वास्तव में एक OCR समस्या नहीं है
किसी से "चीनी OCR" बनाने को कहें और वे शायद एक मुद्रित पृष्ठ की कल्पना करेंगे: समान फ़ॉन्ट, गहरा स्याही, साफ़ पृष्ठभूमि। यह इस बेंचमार्क का आसान हिस्सा है। कठिन हिस्सा उन अवशेषों का सेट है जो किसी भी तरह से किसी आधुनिक पाठक द्वारा पहचाने जाने वाले लेखन प्रणाली को साझा नहीं करते हैं।
चीनी लिपि ने अपनी इतिहास में लगभग सात प्रमुख रूपों से गुज़ारा है, और Ancient-Bench उन सभी को कवर करता है: ऑरैकल बोन स्क्रिप्ट (3,000 से अधिक वर्ष पहले शांग वंश के भविष्यवक्ताओं द्वारा कछुए के खोल और जानवरों की हड्डियों पर उकेरी गई), ब्रॉन्ज़ स्क्रिप्ट (आराधना के बर्तनों में ढाली गई), सील स्क्रिप्ट, क्लेरिकल स्क्रिप्ट, रेगुलर स्क्रिप्ट, कर्सिव स्क्रिप्ट, और रनिंग स्क्रिप्ट। प्रत्येक वास्तव में अलग-अलग वर्ण आकारों का सेट है, केवल फ़ॉन्ट परिवर्तन नहीं। एक ऐसा वर्ण जो रेगुलर स्क्रिप्ट में एक सरल, अच्छी तरह से ज्ञात ग्लिफ हो सकता है, ऑरैकल बोन स्क्रिप्ट में एक अमूर्त चित्रात्मक चिह्न हो सकता है जिसे केवल कुछ विशेषज्ञ ही पढ़ सकते हैं।
इसके ऊपर नौ अलग-अलग भौतिक माध्यमों को जोड़ें, क्योंकि लेखन सतह बदल देती है कि "पाठ" वास्तव में कैसा दिखता है: ऑरैकल बोन और ब्रॉन्ज़ (छोटी, सघन अंकितियाँ, अक्सर चipped या क्षयग्रस्त), बांस और लकड़ी की पट्टियाँ (पुस्तकों में बंधी पतली पट्टियाँ, विकृत और फीकी पड़ने की प्रवृत्ति), रेशम के मसौदे (भंगुर कपड़ा, अक्सर क्षतिग्रस्त), सील (दर्पण प्रतिबिंब में उकेरा गया पाठ, कभी-कभी उभार में), पत्थर के स्तेले और चट्टानों पर अंकितियाँ (मौसम से प्रभावित चट्टानों से ली गई रबिंग्स, जिनमें दरारें और क्षरण छवि में अंकित हैं), लकड़ी के ब्लॉक से मुद्रित पुस्तकें, और स्याही की कलात्मक लेखनशैली। एक बांस की पट्टी पर हान वंश की जमीन की संधि और एक लटकाए हुए स्क्रॉल पर मिंग वंश की कर्सिव कविता पढ़ें, और आप वास्तव में दो अलग-अलग पहचान समस्याओं को देख रहे हैं जो एक ही मूल भाषा का उपयोग करती हैं, तीन सहस्राब्दियों से अधिक की दूरी पर।
कागज़ का तर्क है कि मौजूदा बेंचमार्क मुख्य रूप से इन अक्षों में से एक को चुनते हैं और वहीं रुक जाते हैं। कुछ कई स्क्रिप्ट प्रकारों को कवर करते हैं लेकिन केवल मुद्रित पुस्तकों में। कुछ ऑरैकल बोन को गहराई से कवर करते हैं लेकिन कुछ और नहीं। एक बहु-माध्यम सेट की एक पूर्व कोशिश, MCHDoc, ने कई माध्यमों को जोड़ने की कोशिश की, लेकिन यह मौजूदा एकल-माध्यम डेटासेट से डेटा लेती थी जिसमें कोई साझा लेबलिंग नियम नहीं थे, इसलिए संख्याएँ वास्तव में श्रेणियों के बीच तुलनीय नहीं थीं। Ancient-Bench का प्रस्ताव एक ऐसा डेटासेट बनाना है जो एक साथ तीनों आयामों के बारे में ईमानदार हो: माध्यम, स्क्रिप्ट, और काल।
"सही" का अर्थ क्या है, यह तय करना
प्राचीन पाठ पहचान पर किसी मॉडल का मूल्यांकन करने से पहले, आपको यह तय करना होगा कि एक सही प्रतिलिपि (transcription) कैसी दिखती है, और यह वास्तव में एक डिज़ाइन समस्या है, कोई औपचारिकता नहीं।
एक कछुए की हड्डी (oracle bone) पर उकेरे गए एक अक्षर को लें। यह आधुनिक यूनिकोड में बिल्कुल मौजूद ही नहीं हो सकता। विद्वानों के पास प्रतिलिपि (隶定) नामक एक मानक अभ्यास है: एक प्राचीन अक्षर रूप को बाद के, पठनीय लिपि के समकक्ष में बदलना, ठीक वैसे जैसे आप समझा सकते हैं कि एक पुराना हाथ से लिखा प्रतीक "एक" आधुनिक अक्षर है, भले ही वह उस जैसा न दिखता हो। Ancient-Bench के एनोटेटर्स को अक्षर-दर-अक्षर तय करना था कि किसी दिए गए प्राचीन रूप का कोई सहमत आधुनिक समकक्ष है या नहीं, क्या इसका चिह्न "अपरिचित" प्लेसहोल्डर के साथ लगाया जाना चाहिए क्योंकि कोई समकक्ष मौजूद नहीं है, या क्या स्रोत संस्थान का अपना संग्रहालय लेबल (जो अक्सर सामान्य दर्शकों के लिए आक्रामक रूप से सरलीकृत करता है) पर भरोसा किया जा सकता है। टीम ने पाया कि संग्रहालय एनोटेशन अक्सर पठनीयता के लिए वैकल्पिक या परंपरागत अक्षरों को आधुनिक सरलीकृत रूपों में सामान्यीकृत करते हैं, जो इतिहास शोध के लिए महत्वपूर्ण भेदों को चुपके से मिटा देते हैं: उदाहरण के लिए, दो अक्षर जो बाद में एक सरलीकृत रूप में विलीन हो गए थे, मूल पाठों में अलग-अलग अर्थ रखते थे।
लेख इस समस्या को तीन एनोटेशन मानकों के साथ हल करता है। प्रतीक मानकीकरण (Symbol standardization) यह परिभाषित करता है कि बार-बार आने वाले अक्षरों, क्षतिग्रस्त या अपठनीय अंशों, और उन अक्षरों को कैसे चिह्नित किया जाए जो छवि में मौजूद हैं लेकिन किसी भी अक्षर सेट में टाइप नहीं किए जा सकते। अक्षर मानकीकरण (Character standardization) उन प्राचीन और वैकल्पिक रूपों को संभालने के नियम सेट करता है, जो मौन सरलीकरण के बजाय "जो आप देखते हैं, वही आप पाते हैं" (what-you-see-is-what-you-get) के पक्ष में होता है। पार्सिंग मानकीकरण (Parsing standardization) लेआउट को कवर करता है: पढ़ने का क्रम (ऊर्ध्वाधर चीनी पाठ ऊपर से नीचे, दाएं से बाएं चलता है; कुछ कलाकृतियां अलग तरह से चलती हैं), लाइन ब्रेक, इंटरलाइनियर नोट्स, और मुद्रित पुस्तक पृष्ठ के कौन से क्षेत्र वास्तविक पाठ हैं बनाम मार्जिन नोट्स या बाइंडिंग आर्टिफैक्ट्स को नजरअंदाज किया जाना चाहिए।
यह लेख का कोई रोमांचक हिस्सा नहीं है, लेकिन यह संभवतः सबसे उपयोगी योगदान है: दस्तावेज़ों की एक श्रेणी के लिए "ग्राउंड ट्रुथ" की एक साझा, जांच योग्य परिभाषा, जहां अन्यथा तर्कसंगत विशेषज्ञ प्रतिलिपि के बारे में असहमत हो सकते हैं। इस पर छह महीनों तक बीस प्रशिक्षित एनोटेटर्स ने काम किया, चार स्थापित पैलेओग्राफिक संदर्भ डेटाबेस के साथ क्रॉस-चेकिंग की, और अंतिम लेबल्स की सत्यापन एक अलग समीक्षक द्वारा की गई।
संख्याएँ: कोई 60% नहीं तोड़ पाता, और कुछ कार्यों में न्यूनतम ही कार्यक्षमता है
अंतिम डेटासेट में 2,700 छवियाँ हैं, जो 14 राष्ट्रीय स्तर के संग्रहालयों और पुस्तकालयों से प्राप्त की गई हैं, और नौ मीडिया प्रकारों (400 कलामादरी कृतियों से लेकर 200 चट्टानों पर उकेरी गई शिलालेखों तक) में विभाजित हैं, जो लगभग 1200 ईसा पूर्व से 1911 ईसाई तक की अवधि को कवर करते हैं। शोधकर्ताओं ने फिर इसके खिलाफ 33 मॉडल्स चलाए: GPT-5, Gemini और Claude जैसे बंद मॉडल्स; Qwen और Kimi जैसे खुले मॉडल्स; और सामान्य चैट के बजाय विशेष रूप से पाठ निष्कर्षण के लिए बनाए गए विशेषज्ञ दस्तावेज़-OCR सिस्टम का एक सेट। प्रत्येक मॉडल के आउटपुट का मानकीकृत प्रतिलिपियों के खिलाफ दो मेट्रिक्स का उपयोग करके स्कोर किया गया: F1 (कितने अनुमानित वर्ण ग्राउंड ट्रुथ से मेल खाते हैं, जो छूटे हुए और बनाए गए दोनों वर्णों पर दंड लगाता है) और सामान्यीकृत संपादन दूरी, जो एक वर्ण-स्तर का माप है कि मॉडल के अनुमान को सही उत्तर में बदलने के लिए कितने एकल-वर्ण संपादन की आवश्यकता होगी।
समग्र सर्वश्रेष्ठ मॉडल, ByteDance का Doubao-seed-2-0-lite, ने 52.08% संपादन दूरी और 57.86% F1 हासिल किया। इसे स्पष्ट रूप से पढ़ें: परीक्षण किए गए सबसे मजबूत सिस्टम, औसतन, जब आप उसे एक प्राचीन चीनी कलाकृति पढ़ने के लिए कहते हैं, तो पाँच में से तीन से भी कम वर्ण सही पाता है। हर अन्य मॉडल इससे भी खराब प्रदर्शन करता है। सर्वश्रेष्ठ समर्पित OCR विशेषज्ञ, HunyuanOCR, 46.11% F1 पर शीर्ष पर है, जो Doubao, Gemini और खुले-वजन Kimi K2.6 (56.62% F1) जैसे सामान्य-उद्देश्यीय चैट मॉडल्स से काफी पीछे है। यह उस उम्मीद का एक वास्तविक उल्टापलट है जो आप करेंगे: इस कार्य पर दस्तावेज़ पार्सिंग के लिए विशेष रूप से बनाए और विपणन किए गए मॉडल्स सामान्य-उद्देश्यीय सहायकों से हार जाते हैं।
प्रदर्शन भी कलाकृति के प्रकार के आधार पर कठोरता से विभाजित होता है, और यह विभाजन आपको कुछ उपयोगी बताता है। कछुए की हड्डी के अक्षर (Oracle bone script) लगभग अविश्लेषित हैं: उस विशिष्ट कार्य पर सर्वश्रेष्ठ प्रदर्शन करने वाला Gemini भी केवल 15.75% F1 प्रबंधित करता है। पित्तल के शिलालेख (Bronze inscriptions) शीर्ष मॉडल के लिए 38.48% पर बहुत बेहतर नहीं हैं। दोनों श्रेणियों में घने, प्राचीन अक्षर रूप शामिल हैं जिनका कोई आधुनिक समकक्ष नहीं है जिसके खिलाफ मॉडल पैटर्न-मैच कर सके। मुहरें (Seals) अपनी तरह की जाल हैं: क्योंकि मुहर शिलालेख अक्सर शास्त्रीय कविताओं का उद्धरण करते हैं, मॉडल्स अपने ट्रेनिंग-डेटा प्रायों (priors) पर डिफ़ॉल्ट करते हैं और प्रवाहमय-सुनने वाली कविताएँ उत्पन्न करते हैं जो वास्तव में उकेरी गई नहीं होती हैं, जो कि शुरुआत में दी गई मुहर के उदाहरण के बिल्कुल समान है। इस बीच, पत्थर के स्तंभ (stone steles), जो अच्छी स्थिति में अच्छी तरह से बनाए गए क्लेरिकल या नियमित लिपि को संरक्षित करने की प्रवृत्ति रखते हैं, शीर्ष मॉडल के लिए 88.88% F1 पर पहुँचते हैं, जो वास्तव में उपयोगी परिणाम के करीब है।
इन संख्याओं के बीच का अंतर (कछुए की हड्डी पर 16% से कम, स्तंभों पर लगभग 89%) यहाँ वास्तविक निष्कर्ष है, किसी भी एक लीडरबोर्ड स्कोर से अधिक। "प्राचीन चीनी OCR" एक ऐसी क्षमता नहीं है जो मॉडल के पास है या नहीं है। यह दर्जनों संकीर्ण क्षमताएँ हैं, और वर्तमान सिस्टम के पास उनमें से कुछ हैं और कुछ नहीं हैं।
हैलुसिनेशन की समस्या एक UX समस्या है, न कि केवल सटीकता की समस्या
यह पेपर हैलुसिनेशन का अध्ययन करने के लिए विशेष रूप से एक अलग कैलिग्राफी सबसेट बनाता है, और यह दो अलग-अलग फेलियर पैटर्न की पहचान करता है जिन्हें जानना जरूरी है अगर आप किसी भी OCR सिस्टम का मूल्यांकन अस्त-व्यस्त इनपुट पर कर रहे हैं, चाहे वह प्राचीन चीनी पाठ ही क्यों न हो।
पहला वह है जिसे लेखक prior-driven semantic completion कहते हैं: जब स्ट्रोक अस्पष्ट या विकृत होते हैं (जो कि मुक्त लेखन कैलिग्राफी में सामान्य है), तो मॉडल अपने विज़न हाफ के बजाय अपने लैंग्वेज मॉडल हाफ पर निर्भर हो जाता है, और उस पाठ को उत्पन्न करता है जो सही लगता है, न कि वह पाठ जो वास्तव में वहां मौजूद है। यह शुरुआत में बताई गई सील-कविता (seal-poem) की असफलता का सामान्यीकृत रूप है। दूसरा cropping और detection-induced over-recognition है: जब सिस्टम का अपना रीजन-डिटेक्शन स्टेप पाठ के चारों ओर थोड़ा गलत बॉक्स बनाता है, तो वह पड़ोसी स्ट्रोक या बैकग्राउंड नॉइज़ को उठा लेता है और उन्हें अतिरिक्त, काल्पनिक अक्षरों में बदल देता है, जिन्हें वह एक प्रवाहमय लेकिन निर्मित पठन में जोड़ देता है।
दोनों ही फेलियर मोड एक ऐसा गुण साझा करते हैं जो इन मॉडलों पर किसी भी प्रोडक्ट बनाने वाले को चिंता में डालना चाहिए: आउटपुट बिल्कुल वैसे ही आत्मविश्वास से भरा और बिल्कुल वैसे ही अच्छी तरह से फॉर्मेटेड दिखता है, चाहे वह सही हो या पूरी तरह से काल्पनिक। कोई भी दृश्य संकेत नहीं है, यूजर को कोई कम कॉन्फिडेंस स्कोर दिखाया नहीं जाता, और कुछ भी ऐसा नहीं है जो "मैंने इसे सही पढ़ा" और "मैं किसी संभावित चीज़ के लिए पैटर्न-मैचिंग कर रहा हूं" के बीच अंतर कर सके। एक सामान्य यूजर के लिए, यह उस टूल के बीच का अंतर है जो कभी-कभी गलत होता है और उस टूल के बीच जो कभी-कभी ऐसे गलत होता है जिसकी पहचान बिना पहले से ही उत्तर जानने के बिना की जा सकती है।
यदि आप OCR बना रहे हैं या चुन रहे हैं, तो यह क्यों मायने रखता है
यदि आपके दस्तावेज़ इस बेचमार्क के आसान सिरे (मुद्रित पृष्ठ, आधुनिक हाथ की लिखावट, अच्छे स्कैन) जैसे दिखते हैं, तो यह आपकी गणना को ज्यादा नहीं बदलता; मुख्यधारा का OCR और सामान्य VLMs इसे पहले ही उचित रूप से संभाल लेते हैं। लेकिन यह पेपर एक साफ़, मापी गई प्रस्तुति है कि कहाँ यह आत्मविश्वास टूट जाता है, और यह पैटर्न प्राचीन चीनी कलाकृतियों से आगे बढ़कर किसी भी OCR उपयोग मामले पर लागू होता है जहाँ स्रोत सामग्री खराब, असामान्य या वितरण के बाहर हो: पुरानी हाथ की लिखावट, फीकी रसीदें, क्षतिग्रस्त फॉर्म, सीमित प्रशिक्षण डेटा वाले गैर-लैटिन स्क्रिप्ट। मजबूत अंग्रेजी OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा है; देवनागरी में जटिल संयुक्त वर्ण, मात्राएँ, शिरोरेखा और नुक्ता के कारण यह चुनौती अक्सर अधिक होती है।
वास्तविक मूल्यांकन में ले जाने के लिए तीन मुख्य बिंदु:
सामान्य-उद्देश्य वाले VLMs वर्तमान में वास्तव में कठिन, अपरिचित इनपुट पर विशेषज्ञ OCR मॉडल्स को हरा रहे हैं। यदि आपने विशेषीकरण जीतता है, इस धारणा पर एक समर्पित OCR मॉडल के चारों ओर एक पाइपलाइन बनाई है, तो यह थोड़ा असुविधाजनक है, और यह मान्यता को आपके वास्तविक दस्तावेज़ों पर पुनः परीक्षण करने योग्य है, न कि किसी मार्केटिंग बेचमार्क पर।
इन प्रणालियों में आत्मविश्वास और सटीकता अभी जुड़ी नहीं हैं। इस बेचमार्क पर, मॉडल फ्लुएंट, गलत उत्तनों को फ्लुएंट, सही उत्तरों के समान ही आसानी से उत्पन्न करते हैं, खासकर जब इनपुट अस्पष्ट हो। यदि आपका उत्पाद किसी सत्यापन या आत्मविश्वास संकेत के बिना OCR आउटपुट को सीधे उपयोगकर्ता के सामने लाता है, तो खराब या असामान्य दस्तावेज़ वहाँ हैं जहाँ यह अंतर सहायता टिकट में बदल जाता है, या उससे भी बदतर।
समग्र सटीकता संख्याएँ श्रेणी पतन को छिपाती हैं। एक मॉडल जो "OCR काम करता है" का दावा करता है, उसका अपने विशिष्ट दस्तावेज़ प्रकार पर भरोसा करने से पहले इस पेपर की प्रति-मीडियम विभाजन का अपना संस्करण होना चाहिए, क्योंकि एक मजबूत औसत एक श्रेणी पर बनाया जा सकता है जो लगभग हल हो चुकी है और दूसरी जो बमुश्किल काम कर रही है।
पेपर क्या दावा नहीं करता
लेखक दो सीमाओं के बारे में स्पष्ट हैं। पहला, Ancient-Bench पाठ को पंक्ति या क्षेत्र स्तर पर एनोटेट करता है, वर्ण-स्तर के बाउंडिंग बॉक्स के साथ नहीं, इसलिए यह एंड-टू-एंड रिकग्निशन को स्कोर करने के लिए अच्छा है, लेकिन सूक्ष्म पाठ डिटेक्शन का मूल्यांकन करने के लिए नहीं। उन्होंने इसे एक योजनाबद्ध जोड़ के रूप में चिह्नित किया है। दूसरा, और अधिक दिलचस्प: चूंकि स्रोत छवियां सार्वजनिक संग्रहालय और लाइब्रेरी आर्काइव से आती हैं, इस सामग्री का कुछ हिस्सा पहले से ही उन मॉडल्स की ट्रेनिंग डेटा के अंदर हो सकता है जिनका परीक्षण किया जा रहा है। यह किसी भी सार्वजनिक स्रोतों से बने बेचमार्क के लिए एक परिचित समस्या है, और यह एक दिशा में काटता है, यदि कुछ हो तो रिपोर्ट किए गए स्कोर को ऊपर की ओर धकेलता है बजाय इसके कि परिणामों को कृत्रिम रूप से कठिन बना दे। यह देखते हुए कि सबसे अच्छे मॉडल्स भी ऑरेकल बोन और ब्रॉन्ज इन्स्क्रिप्शन पर बहुत खराब प्रदर्शन करते हैं, वह कैवियट पेपर के मुख्य बिंदु को नरम करने में ज्यादा मदद नहीं करता: 3,000 वर्षों की चीनी आर्टिफैक्ट टेक्स्ट को पढ़ना अभी भी, वर्तमान में, एक समस्या है जिसे वर्तमान AI ने हल नहीं किया है।