المخطوطات العربية لا تُقرأ من الأعلى إلى الأسفل، والآن هناك مجموعة بيانات تعترف بذلك
استنادًا إلى: AraMS-28k: The Largest Publicly Released Line-Level Dataset of Historical Arabic Manuscripts with Margin and Insertion-Anchor Annotations — Mohamed Guechaoui, Mohamed Diaa Zellagui, Souleyman Chaib, Sahraoui Dhelim
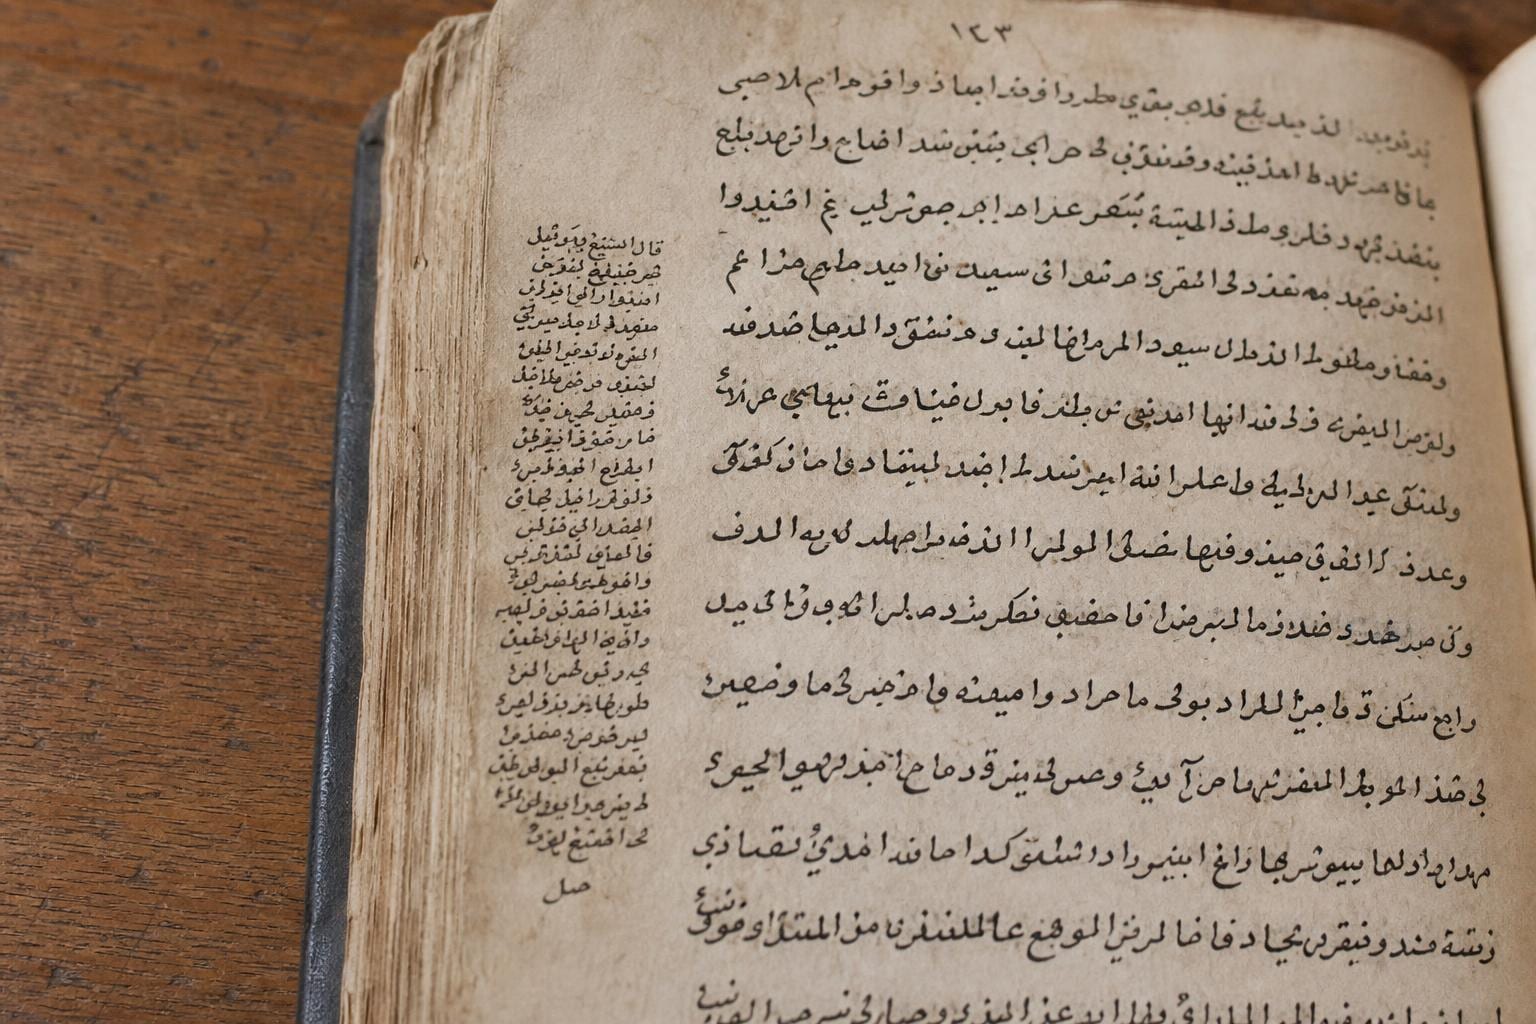
تخيل كاتبًا ينسخ نصًا دينيًا بخط اليد، قبل قرون من أن يتخيل أحد وجود الماسح الضوئي. وفي منتصف الصفحة، يدرك الكاتب أنه قد تخطى سطرًا في فقرات سابقة. لا يوجد زر مسح للخلف، ولا ملاحظات لاصقة. لذلك، يكتب السطر المفقود في الهامش، صغيرًا ومضغوطًا، ويرسم علامة صغيرة تشير بدقة إلى مكان إدراجه مجددًا. وضّع هذا المشهد في سياق مئات الصفحات، وستحصل على مخطوطة يكون فيها "ترتيب القراءة الصحيح" متعرجًا خارج الصفحة وعائدًا إليها، وأي نظام للتعرف الضوئي على الحروف (OCR) يقرأ من الأعلى إلى الأسفل في خط مستقيم سينتج بوثوقية نonsense.
هذه هي المشكلة بالتحديد التي يسعى مجموعة بيانات جديدة تُدعى AraMS-28k إلى حلها، وهي بنية تحتية مفيدة حقًا إذا كنت تهتم باستخراج النصوص من الوثائق القديمة.
لماذا تُعد المخطوطات العربية التاريخية كابوساً للتعرف الضوئي على الحروف
يتميز التعرف الضوئي على الحروف (OCR) الحديث بكفاءته العالية في معالجة النصوص المطبوعة الحديثة والمحاذاة لليسار. إلا أنه يواجه صعوبات جمة بمجرد إدخال خط اليد إلى المعادلة، وتزداد هذه الصعوبات حدة مع النص العربي تحديداً، نظراً لأن الحروف العربية تتغير أشكالها اعتماداً على موقعها داخل الكلمة، وتتصل ببعضها البعض في خط متصل ومتدفق، وغالباً ما كانت تُكتب من قبل خطاطين بأساليب شخصية متباينة بشكل كبير عبر القرون والمناطق. لهذا النوع الخاص من المشكلة اسم خاص: التعرف على النصوص المكتوبة بخط اليد (HTR)، مما يميزه عن المهمة الأكثر يسراً المتمثلة في قراءة صفحة مطبوعة.
والآن، أضف إلى ذلك طبقة المخطوطات التاريخية. جمع مؤلفو الورقة البحثية 14 كتاباً مخطوطاً حقيقياً، بإجمالي 3,043 صفحة و28,600 سطر نصي مُعلّم بشكل فردي. ثلاثة عشر من هذه الكتب هي نسخ مخططة باليد، وتمتد عبر ثلاث تقاليد مميزة للخط العربي: النسخ (خط رسمي مدور لا يزال قريباً مما قد تراه في المصحف المطبوع)، الرقعة (أسلوب خطي سريع ومبسط)، والمغربي (تقليد الخط الزاوي الذي تطور في شمال أفريقيا والأندلس، ومتميز بصرياً بما يكفي عن الخطوط العربية الشرقية لدرجة أن النموذج المدرب على أحدها قد يفشل فشلاً ذريعاً في التعامل مع الآخر). كتاب واحد هو طباعة ليثوغرافية وليس خط يدوي، وقد أُدرج خصيصاً لإضفاء بعض التنوع في التنسيق على مجموعة البيانات.
من بين الـ 28,600 سطر، هناك 27,971 سطرًا للنص الرئيسي و629 سطرًا هي تعليقات هوامش. قد يبدو عدد هوامش صغيراً مقارنة بعدد أسطر النص الرئيسي، لكنه الجزء الذي يجعل هذا الإصدار يستحق الانتباه.
الملاحظة في الهامش ليست تذييلاً، بل هي انحراف
تعامل معظم مجموعات بيانات التعرف الضوئي على الحروف (OCR) الصفحة كتيار بسيط من الأعلى إلى الأسفل ومن اليسار إلى اليمين. لكن المخطوطات الحقيقية لا تعمل بهذه الطريقة. يمكن أن تكون الهوامش (الملاحظات المكتوبة في الهوامش) تذييلات حقيقية قائمة بذاتها، أو يمكن أن تكون تصحيحات مقصودة أن تُقرأ كجزء من النص الرئيسي في نقطة محددة ودقيقة، تماماً مثل الكاتب النسيان أعلاه.
AraMS-28k هو أول إصدار، على حد علم المؤلفين، يميز بين هذه الفروق على مستوى السطر لمجموعة مخطوطات عربية تاريخية. كل سطر هامشي يتم تصنيفه كنص رئيسي أو هامش، وعندما يكون لسطر هامشي نقطة ارتباط واضحة في النص الرئيسي، فإنه يحصل أيضاً على ما يسميه الورق بـ "رابط الإدراج": رابط يعود إلى المكان الدقيق الذي ينتمي إليه هذا السطر في ترتيب القراءة.
هذا يبدو وكأنه اختيار توثيق صغير، لكنه الفرق بين مجموعة بيانات تعلم النموذج نسخ أسطر معزولة ومجموعة بيانات تعلم النموذج إعادة بناء ما يقوله المستند فعلياً عند قراءته بالترتيب. إذا كنت تبني أي تطبيق تابع للتعرف الضوئي على الحروف للمخطوطات (البحث، الترجمة، الاقتباس)، فإن الشيء الثاني هو ما تحتاجه. نسخ مثالي لكل سطر في الصفحة يكون قريباً من العدم إذا جاءت الأسطر بالترتيب الخاطئ.
الحروف التي لم يكتبها أحد فعلياً
يوجد في اللغة العربية تعقيد ثانٍ يعثر الكثير من أعمال التعرف الضوئي على الحروف (OCR) ومعالجة اللغات الطبيعية (NLP): التشكيل. هذه علامات صغيرة فوق وتحت الحروف تشير إلى الحروف القصيرة وتفاصيل النطق الأخرى. العربية المصحوفة بالكامل، مع وضع كل علامة تشكيل، واضحة تماماً للقراءة. المشكلة هي أن القليل من الناس يكتبون بهذه الطريقة يدوياً. الكتبة، مثل معظم الكتاب الأصليين للعربية اليوم، كانوا يتركون علامات التشكيل إلا حيث يكون ذلك ضرورياً حقاً، معتمدين على السياق والمفردات كما يفعل القراء الإنجليزون لاستنتاج أن "read" في الماضي بدلاً من الحاجة إلى كتابتها بشكل صريح.
هذا يخلق عدم تطابق: إذا كانت النصوص المرجعية مصحوفة بالكامل (مما يجعلها دقيقة ومفيدة كحقائق أساسية) ولكن الصور المخطوطة ليست كذلك، فإن النموذج المدرب بشكل ساذج على هذا الزوج سيتعلم تخيل علامات تشكيل لم تكن موجودة فعلياً على الصفحة. AraMS-28k يتعامل مع هذا بإصدار نسختين من نص كل سطر: النص الخام المصحوف بالكامل، ونسخة مُطابقة للتشكيل مُبسطة لتتناسب مع ما كتبه الكاتب فعلياً. هذا يمنح أي شخص يدرب نموذجاً خيار مطابقة المهمة للواقع بدلاً من الإفراط في التخصيص للصمت على الحبر غير المرئي.
كيف تُعلّم 28,600 سطر دون أن تفقد عقلك (أو دقتك)
تتسم عملية التعليق على هذا الكم الهائل من المواد التاريخية يدوياً، سطرًا تلو الآخر، وهامشًا تلو الآخر، ونقطة تلو الأخرى، بالبطء والتكلفة العالية إذا اعتمدت بشكل كامل على الخبراء البشر، كما أنها عرضة للأخطاء إذا اعتمدت بشكل كامل على التعرف الضوئي على الحروف (OCR) الآلي. لذلك، قام المؤلفون ببناء خط أنابيب يُدعى RefLAM لجمع بين المنهجين.
الفكرة الأساسية: بدلاً من مطالبة نموذج لغوي كبير متعدد الوسائط بنسخ صفحة مخطوطة من الصفر والاعتماد على الحظ، يقوم RefLAM بمطابقة مخرجات التعرف الضوئي على الحروف للنموذج مع نسخ نصية نظيفة وموثوقة تم الحصول عليها من مصادر مستقلة لنفس النص. وبعبارة أخرى، إذا كان هناك طبعة أكاديمية من الكتاب موجودة بالفعل بصيغة نصية، فإنك تستخدمها كمرجع للتحقق من تخمينات النموذج، واكتشاف الحالات التي أخطأ فيها النموذج في قراءة حرف أو حذف كلمة. تخضع كل سطر لا يزال للمراجعة البشرية، لذا فإن خط الأنابيب هو في الواقع تحقق آلي بالإضافة إلى إشراف الخبراء، وليس بديلاً عن أي منهما. هذا تصميم معقول: فالتعرف الضوئي على الحروف باستخدام النماذج اللغوية الكبيرة فقط على خط يدوي عمره 700 عام سيقع في أخطاء، والتعليق اليدوي الكامل على 28,600 سطر هو مشروع يستغرق سنوات لفريق صغير. إن ربط المرور الآلي بمصدر مستقل للحقيقة هو ما يجعل هذه المجموعة موثوقة وليس فقط سريعة.
نسخ، رقعة، مغاربي: مجموعة بيانات واحدة، وفجوة تعميم حقيقية
لا تكتفي الورقة بنشر البيانات فحسب، بل تقوم أيضاً بتشغيل تجارب خطية أساسية للتعرف على النص المكتوب بخط اليد باستخدام نظامين مفتوحين المصدر للتعرف على النصوص: Kraken، وهو محرك شائع الاستخدام في مجتمع العلوم الرقمية الإنسانية لنسخ الوثائق التاريخية، وHATFormer، وهو نموذج التعرف الأحدث المستند إلى معماريات الترانسفورمر. الهدف من تشغيل هذه النماذج الأساسية ليس الادعاء بتحقيق حالة فنية جديدة، بل إظهار مدى صعوبة مجموعة البيانات فعلياً، ومنح الباحثين المستقبليين رقماً يمكنهم التفوق عليه.
أكثر النتائج فائدة هنا هو ما يسميه المؤلفون "تدرج تعميم عبر النصوص". فقد اختبروا الأداء على صفحات تشبه ما رآه النموذج أثناء التدريب (ضمن التوزيع)، ثم على صفحات من كتب لم يرها النموذج من قبل على الإطلاق. تنخفض الدقة كلما انتقلنا من الحالة الأولى إلى الثانية، ويتناسب حجم هذا الانخفاض مع مدى اختلاف تقليد النص في الكتاب غير المرئي عما تدرب عليه النموذج. النموذج المتمكن من قراءة خط النسخ لا يقرأ الخط المغربي بشكل جيد تلقائياً، والعكس صحيح. هذه ليست نتيجة مفاجئة لمن نظر إلى مدى الاختلاف البصري بين هذه التقاليد النصية، لكن الحصول على قياس كمي لها على مجموعة بيانات حقيقية معزولة بدلاً من افتراضها، هو بالضبط النوع من الاكتشافات غير المبهرة لكنها مفيدة التي تتيح للمطورين بناء أنظمة حقيقية ضبط توقعاتهم بشكل صحيح بدلاً من التخمين.
لماذا يهم ذلك أي شخص يبني أو يشتري حلول التعرف الضوئي على الحروف (OCR)
إذا كنت تقوّم أدوات التعرف الضوئي على الحروف أو الذكاء الاصطناعي المستند إلى المستندات لأغراض تتجاوز المستندات المطبوعة النظيفة والمكتوبة بالخط اللاتيني، فإن هذه الورقة البحثية تمثل واقعاً مفيداً على ثلاثة محاور.
أولاً، "قراءة النص" و"قراءة النص بالترتيب الصحيح" هما قدرتان مختلفتان، ومعظم معايير التقييم للاختبارات تقيس الأولى فقط. يهم ترتيب القراءة بقدر ما يهم هو في الهوامش في المخطوطة: ملفات PDF متعددة الأعمدة، نماذج ذات أشرطة جانبية، وثائق تأمين ذات ملاحظات مختومة، عقود ذات تعديلات مكتوبة بخط اليد في الهامش. نظام ينسخ كل حرف بشكل صحيح لكنه يربطها معاً في تسلسل خاطئ ينتج مخرجات تبدو معقولة وهي خاطئة. تعتبر تعليقات إدراج المراسي في AraMS-28k مثالاً نادراً لمجموعة بيانات تقيس هذا فعلياً بدلاً من افتراض أن المستند هو دفق عمودي نظيف واحد.
ثانياً، تنوع الخطوط والأنماط داخل لغة واحدة هو أمر أكبر مما يبدو. "التعرف الضوئي على الحروف للعربية" ليس مشكلة واحدة؛ الخطوط مثل النسخ والرقعة والمغربي تتصرف بشكل مختلف بما يكفي بحيث يمكن لنموذج مضبوط على واحد أن يفشل على آخر، ونفس المنطق ينطبق على أنماط الخط اليدوي والخطوط والتخطيطات في أي لغة. إذا كنت تختار بين محركات التعرف الضوئي على الحروف لمنتج، اسأل عن الخطوط أو الخطوط اليدوية أو أنماط المستندات المحددة التي تم قياس أرقام المعيار عليها، وليس فقط اللغة.
ثالثاً، الحقيقة الأرضية نفسها ليست خالية من الافتراضات. تقسيم التشكيل مقابل عدم التشكيل هو تذكير بأن "النسخ الصحيح" يعتمد على ما تحاول مطابقته، النص الأكاديمي المثالي أو ما هو موجود فعلياً على الصفحة. هذا التمييز يتعمم جيداً خارج العربية: أي حقيقة أرضية للتعرف الضوئي على الحروف مبنية من نسخة مرجعية نظيفة تخاطر بتعليم النموذج لإخراج المرجع بدلاً من ما هو مكتوب فعلياً، ومن الجدير التحقق مما يقيسه معيار معين حقاً. إن طبيعة الخط العربي المتصل، واتجاهه من اليمين إلى اليسار، وتغير أشكال الحروف حسب السياق، بالإضافة إلى التشكيل الاختياري والروابط، تجعل التعرف الضوئي على الحروف أكثر صعوبة بكثير.
ما لا تدعي هذه المجموعة البيانات حله
من الجدير بالذكر أن نكون صادقين بشأن نطاق العمل. إن أربعة عشر كتاباً و3,043 صفحة تمثل إصداراً ذا معنى، وهي الأكبر من نوعها على حد علم المؤلفين، لكنها لا تزال صغيرة مقارنة بمجموعات بيانات التعرف الضوئي على الحروف للنصوص المطبوعة التي تصل إلى ملايين الصفحات، كما أن 629 سطر هامشي تمثل عينة متواضعة لتدريب نموذج على التعامل مع نقاط الإدراج بشكل موثوق بمفرده. النتائج الأساسية المُبلغ عنها هي مجرد نتائج أساسية، وليست معياراً تم حله؛ فجوة التعميم عبر النصوص التي وجدها المؤلفون هي نفسها دليل على أن النموذج المدرب على هذه البيانات لن ينتقل تلقائياً إلى المخطوطات خارج هذه التقاليد النصية الثلاث أو خارج اللغة العربية تماماً. كما يعني ترخيص CC BY-NC-SA 4.0 أنه متاح للأبحاث، وليس لتدريب منتج تجاري بشكل مباشر.
لا يقلل أي من ذلك من قيمة المساهمة. نادراً ما تحل مجموعات البيانات الجيدة المشكلة بشكل مباشر؛ بل تجعل المشكلة قابلة للقياس، وهو الشرط المسبق لأي شخص يريد حلها فعلياً. تفعل AraMS-28k ذلك بالنسبة لجزء من التعرف الضوئي على الحروف غالباً ما يتم تجاهله: المخطوطات التي لا تجلس فيها النصوص هناك بانتظار القراءة فحسب، بل يجب إعادة بنائها.