阿拉伯语手稿并非从上到下阅读,现在有一个数据集承认了这一点
参考论文: AraMS-28k: The Largest Publicly Released Line-Level Dataset of Historical Arabic Manuscripts with Margin and Insertion-Anchor Annotations — Mohamed Guechaoui, Mohamed Diaa Zellagui, Souleyman Chaib, Sahraoui Dhelim
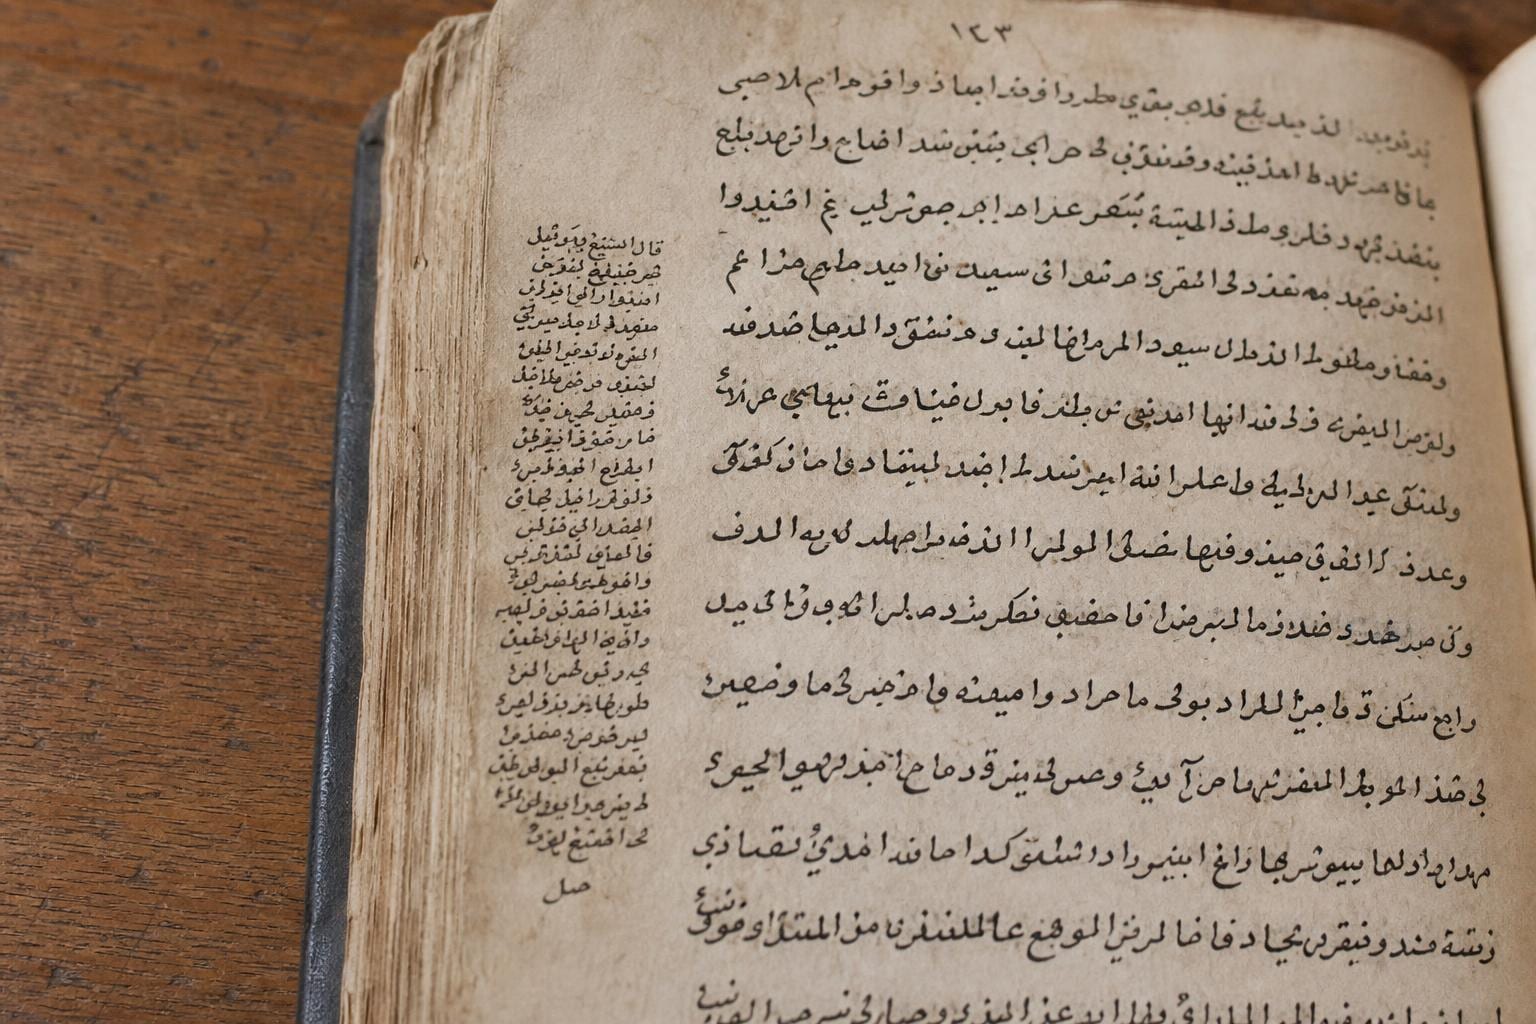
想象一下,在扫描仪被发明之前的几个世纪里,一位抄写员正在手工誊写宗教文本。写到页面中段时,他意识到几段之前漏掉了一行。没有退格键,也没有便利贴。于是,他在页边空白处用细小而拥挤的字迹补上这行缺失的内容,并画了一个微小的标记,指示它应插入的确切位置。将这种情况放大到数百页,你就得到了一份“正确”阅读顺序在页面内外曲折跳跃的手稿,任何从上到下直线读取的OCR系统都会自信地输出胡言乱语。
这就是名为 AraMS-28k 的新数据集旨在解决的确切问题。如果你关心如何从古老文档中提取文本,这确实是一件非常有用的基础设施。
为什么历史阿拉伯语文献是 OCR 的噩梦
现代 OCR 在处理现代、印刷体、左对齐文本时表现良好。一旦引入手写体,其性能就会大幅下降;而面对阿拉伯文时,挑战更是成倍增加。这是因为阿拉伯字母的形状会根据其在单词中的位置发生变化,并与相邻字母以连续流畅的线条相连。此外,这些文本通常由抄写员书写,他们在不同世纪和地区的个人书写风格差异极大。这一特定类型的问题有一个专门的名称:手写文本识别(HTR),以此区别于相对简单的印刷页面阅读任务。
现在,再将这些历史文献叠加在上述挑战之上。该论文的作者收集了 14 本真实的手稿书籍,共计 3,043 页,包含 28,600 行单独标注的文本。其中 13 本书为手抄本,涵盖了三种不同的阿拉伯文书写传统:纳斯赫体(Naskh,一种圆润、正式的字体,与印刷版《古兰经》中的字体非常接近)、鲁克体(Ruq'ah,一种快速、简化的草书风格)以及马格里布体(Maghrebi,一种在北非和安达卢西亚发展起来的棱角分明的字体传统,其视觉特征与东阿拉伯字体差异显著,以至于在一个字体上训练的模型在另一种字体上可能会表现极差)。其中一本书是石印印刷品而非手写体,特意纳入以增加数据集的格式多样性。
在 28,600 行文本中,27,971 行是正文,629 行是页边注释。虽然页边注释的数量相对于正文来说显得很少,但这正是使该数据集发布值得关注的部分。
页边注不是脚注,而是一个插入点
大多数 OCR 数据集将页面视为简单的从上到下、从左到右的文本行流。但真实的手稿并非如此运作。页边注(写在页边的注释)可能是独立的真正脚注,也可能是修正内容,旨在作为主文本的一部分在特定、精确的位置阅读,就像上面那位健忘的抄写员一样。
据作者所知,AraMS-28k 是首个在历史阿拉伯文手稿语料库中以行级标注区分这一区别的数据集。每一行页边注都会被标记为主文本或页边注,当页边注在主文本中有明确的附着点时,它还会获得论文所称的插入锚点:一个链接回该行在阅读顺序中确切位置的指针。
这听起来像是一个微小的标注选择,但它决定了数据集是教模型转录孤立的文本行,还是教模型重建文档按顺序阅读时实际表达的内容。如果你正在构建基于手稿 OCR 的任何下游应用(搜索、翻译、引用),你需要的是后者。如果文本行的顺序错误,即使完美转录了页面上的每一行,也几乎毫无用处。
没人真正写下来的元音
阿拉伯语还有一个让许多 OCR 和 NLP 工作栽跟头的细节:变音符号(diacritics)。这些是位于字母上方或下方的小标记,用于指示短元音和其他发音细节。完全标注变音符号的阿拉伯语在读音上毫无歧义。问题在于,几乎没有人手写时会这样写。抄写员,以及当今大多数阿拉伯语母语书写者,通常只在真正必要时才标注变音符号,而是依靠上下文和词汇来推断含义——就像英语读者通过上下文判断 "read" 是过去式,而不需要将其拼写出来一样。
这就造成了一个不匹配的问题:如果你的参考转录文本是完全标注变音符号的(这使得它们精确且适合作为真实标签),而手稿图像中却没有这些符号,那么在该配对数据上天真训练的模型就会“幻觉”出页面上实际上并不存在的变音符号。AraMS-28k 通过为每一行转录文本发布两个版本来解决这个问题:一个是原始的、完全标注变音符号的文本,另一个是去除变音符号的标准化版本,以匹配抄写员实际书写的内容。这为任何训练模型的人提供了选择,使其任务与现实相符,而不是在不知不觉中过拟合于“看不见的墨水”。
如何标注 28,600 行文本而不崩溃(也不牺牲准确率)
如果完全依赖人类专家,逐行、逐页边距、逐锚点地手动标注如此大量的历史材料,不仅缓慢且成本高昂;而如果完全依赖自动化 OCR,则容易出错。作者构建了一个名为 RefLAM 的流水线,以在两者之间取得平衡。
核心思路是:与其让多模态大语言模型直接“盲猜”手稿页面的转录内容并祈祷结果准确,RefLAM 将模型的 OCR 输出与独立来源的同一文本的干净转录本进行对齐。换句话说,如果该书籍的学术版本已经以打字稿形式存在,就将其作为参考,用来核对模型的猜测,从而捕捉模型误读字母或漏掉单词的情况。每一行文本仍需经过人工审核,因此该流水线实际上是自动验证加上专家监督,而非取代任何一方。这是一个合理的设计:对 700 年前的手写体进行纯 LLM-OCR 必然会出现错误,而由一个小团队手动标注 28,600 行文本则是一个耗时多年的项目。将自动化处理的结果与独立的真实来源进行比对,正是使这种组合值得信赖而不仅仅是快速的关键。
Naskh、Ruq'ah、Maghrebi:一个数据集,一个真实的泛化差距
该论文不仅发布了数据,还使用两个开源手写文本识别(HTR)系统进行了基线实验:Kraken,这是数字人文社区中广泛用于转录历史文档的引擎;以及 HATFormer,这是一个较新的基于 Transformer 的识别模型。运行基线的目的并非宣称新的最先进水平(SOTA),而是为了展示该数据集的实际难度,并为未来的研究者提供一个可超越的基准数值。
此处最有用的结果是作者所称的“跨脚本泛化梯度”。他们在与模型训练期间所见页面相似的页面(分布内)上测试了性能,然后在模型从未见过的书籍页面上进行了测试。从第一种情况过渡到第二种情况时,准确率会下降,且下降幅度与未见过的书籍的书写传统与模型训练数据之间的差异程度成正比。一个对 Naskh 脚本表现良好的模型并不会自动很好地识别 Maghrebi 脚本,反之亦然。如果你观察过这些书写传统在视觉上的差异,这一结果并不令人意外,但在一个真实的、预留的数据集上对其进行量化,而不是仅仅假设,正是那种不引人注目但极具实用价值的发现,它能让构建实际系统的研究人员正确设定预期,而不是靠猜测。
为什么这对构建或采购 OCR 的人很重要
如果您正在评估用于处理非整洁、非印刷体、非拉丁字母文档的 OCR 或文档 AI 工具,这篇论文在三个方面提供了一个有用的现实检验。
首先,“读取文本”和“以正确的顺序读取文本”是两种不同的能力,而大多数 OCR 基准测试仅针对前者。阅读顺序对于现代文档的重要性不亚于手稿中的边注:多栏 PDF、带有侧边栏的表单、带有盖章注释的保险文件以及带有手写修订的合同。一个系统如果转录了每个字符但将它们以错误的顺序拼接在一起,就会产生看似合理但实际错误的输出。AraMS-28k 的插入锚点注释是一个罕见的例子,它实际上测量了这一点,而不是假设文档是一个干净的垂直流。
其次,单一语言内部的脚本和风格变化比听起来更重要。“阿拉伯语 OCR”并不是一个问题;Naskh、Ruq'ah 和 Maghrebi 的行为差异足以让针对一种脚本调整的模型在另一种脚本上失败,同样的逻辑也适用于任何语言的手写风格、字体和布局。如果您正在为产品选择 OCR 引擎,请询问基准数字是在哪些特定脚本、手写体或文档风格上测量的,而不仅仅是哪种语言。
第三,地面真值本身并非没有假设。带元音符号和不带元音符号的元音符号分裂提醒我们,“正确的转录”取决于您试图匹配的内容,是理想化的学术文本还是页面上实际的内容。这种区别很好地推广到了阿拉伯语之外:任何基于干净参考版本构建的 OCR 地面真值都有风险教模型输出参考版本而不是实际书写的内容,因此值得检查给定的基准测试真正测量的是哪一个。对于主要关注拉丁字母的模型,其局限性在应对汉字等表意文字时尤为明显,因为汉字的密集布局和复杂结构需要不同的处理方法。
本数据集声称无法解决的问题
诚实地说明其适用范围是必要的。14本书和3,043页是一个有意义的发布,也是作者所知的同类数据集中最大的,但与包含数百万页的印刷文本OCR数据集相比,它仍然很小,而629条页边线对于训练一个能够可靠地处理插入锚点的模型来说,样本量也很有限。报告的基线正是基线,而不是一个已解决的基准;作者发现的跨脚本泛化差距本身就表明,在此数据上训练的模型不会自动迁移到这三个书写传统之外或完全阿拉伯语之外的手稿。CC BY-NC-SA 4.0许可证意味着它可用于研究,而不是直接用于训练商业产品。
这些都不影响其贡献。好的数据集很少能直接解决问题;它们使问题变得可衡量,这是任何人真正解决问题的前提。AraMS-28k为通常被忽视的OCR部分做到了这一点:那些文本不仅仅是坐在那里等待被阅读,而是需要被重建的手稿。