अरबी पांडुलिपियाँ ऊपर से नीचे नहीं पढ़ी जातीं, और अब एक ऐसा डेटासेट है जो इसे स्वीकार करता है
आधारित शोध-पत्र: AraMS-28k: The Largest Publicly Released Line-Level Dataset of Historical Arabic Manuscripts with Margin and Insertion-Anchor Annotations — Mohamed Guechaoui, Mohamed Diaa Zellagui, Souleyman Chaib, Sahraoui Dhelim
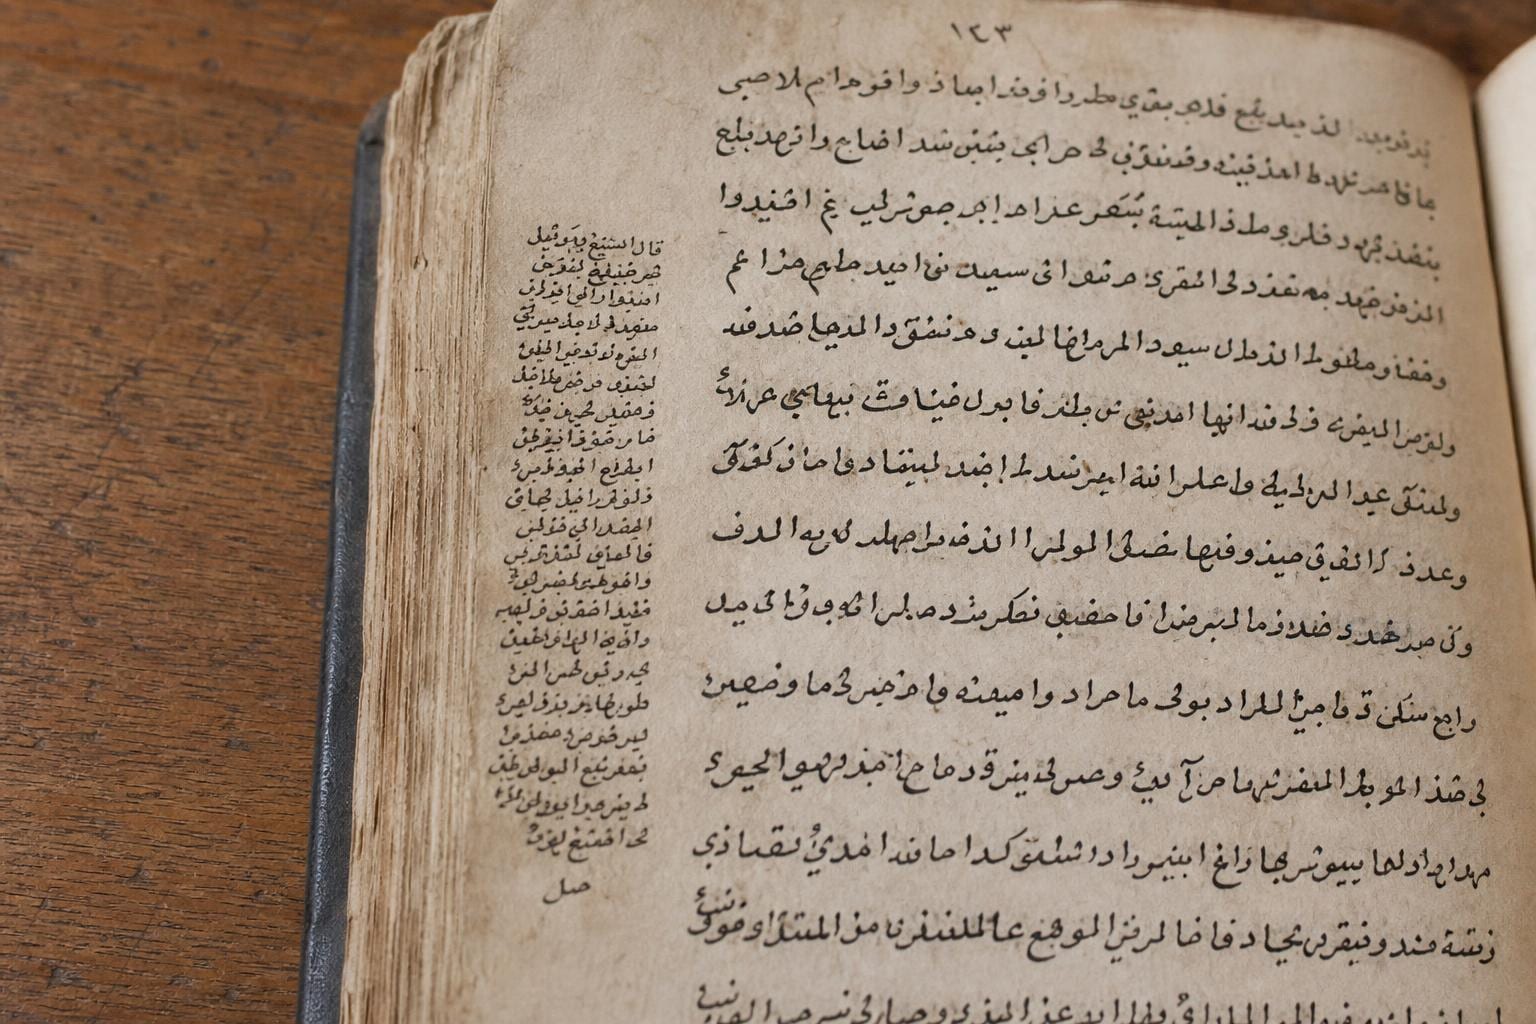
कल्पना कीजिए एक लेखक का, जो सदियों पहले, किसी स्कैनर की कल्पना होने से भी पहले, धार्मिक पाठ को हाथ से कॉपी कर रहा है। पृष्ठ के बीचों-बीच उसे एहसास होता है कि कुछ पैराग्राफ पीछे एक पंक्ति छूट गई है। कोई बैकस्पेस नहीं, कोई स्टिकी नोट नहीं। इसलिए वह छूटी हुई पंक्ति को किनारे में, छोटे और संकुचित अक्षरों में लिखता है, और एक छोटा सा निशान बनाता है जो सटीक रूप से दिखाता है कि वह पंक्ति कहाँ फिट होगी। इसे सैकड़ों पृष्ठों से गुणा करें और आपको एक हस्तलिखित पाठ मिलता है जहाँ "सही" पढ़ने का क्रम पृष्ठ से बाहर और वापस झिगझाता है, और कोई भी OCR सिस्टम जो सीधी रेखा में ऊपर से नीचे पढ़ता है, आत्मविश्वास के साथ अर्थहीन परिणाम देगा।
यही वह सटीक समस्या है जिसका समाधान एक नए डेटासेट AraMS-28k द्वारा किया जा रहा है, और यदि आपको पुराने दस्तावेज़ों से टेक्स्ट निकालने की परवाह है, तो यह इंफ्रास्ट्रक्चर का एक वास्तव में उपयोगी टुकड़ा है।
ऐतिहासिक अरबी हस्तलिखित पांडुलिपियां OCR के लिए क्यों एक सिरदर्द हैं
आधुनिक OCR आधुनिक, मुद्रित, बाएं-संरेखित (left-aligned) पाठ के लिए अच्छा है। जैसे ही आप हाथ से लिखे पाठ को पेश करते हैं, यह बहुत संघर्ष करता है, और विशेष रूप से अरबी लिपि के साथ यह और भी अधिक संघर्ष करता है, क्योंकि अरबी अक्षर शब्द में अपनी स्थिति के आधार पर आकार बदलते हैं, अपने पड़ोसियों से एक निरंतर बहती हुई रेखा में जुड़ते हैं, और अक्सर विभिन्न शताब्दियों और क्षेत्रों में विभिन्न व्यक्तिगत शैलियों वाले लेखकों द्वारा लिखे जाते थे। इस समस्या के इस विशेष रूप का अपना नाम है: हस्तलिखित पाठ पहचान (Handwritten Text Recognition), या HTR, जो मुद्रित पृष्ठ पढ़ने की तुलनात्मक रूप से शांत कार्य से अलग है।
अब उस पर ऐतिहासिक पांडुलिपियों को जोड़ दें। लेखकों ने कुल 3,043 पृष्ठों और 28,600 व्यक्तिगत रूप से एनोटेटेड पाठ पंक्तियों वाले 14 वास्तविक पांडुलिपि पुस्तकों को एकत्र किया। इनमें से तेरह पुस्तकें हाथ से की गई प्रतियां हैं, जो तीन भिन्न अरबी लिपि परंपराओं को कवर करती हैं: नस्ख (Naskh, एक गोल, औपचारिक लिपि जो आज भी मुद्रित कुरान में देखे जाने वाले पाठ के करीब है), रुक़ाह (Ruq'ah, एक तेज, सरलीकृत सुरुक्की शैली), और मग्रेबी (Maghrebi, वह कोणीय लिपि परंपरा जो उत्तरी अफ्रीका और अंडालूसिया में विकसित हुई, दृश्य रूप से पूर्वी अरबी लिपियों से इतनी भिन्न कि एक पर प्रशिक्षित मॉडल दूसरे पर बुरी तरह विफल हो सकता है)। एक पुस्तक हस्तलिखित होने के बजाय लिथोग्राफेड प्रिंट है, जिसे विशेष रूप से डेटासेट को कुछ प्रारूप विविधता प्रदान करने के लिए शामिल किया गया है।
28,600 पंक्तियों में से, 27,971 मुख्य पाठ की हैं और 629 मार्जिन एनोटेशन हैं। मुख्य पाठ की गिनती के मुकाबले यह मार्जिन संख्या छोटी लगती है, लेकिन यह डेटासेट का वह हिस्सा है जो इस रिलीज को ध्यान देने योग्य बनाता है।
मार्जिन में लिखा नोट फुटनोट नहीं, बल्कि एक विचलन है
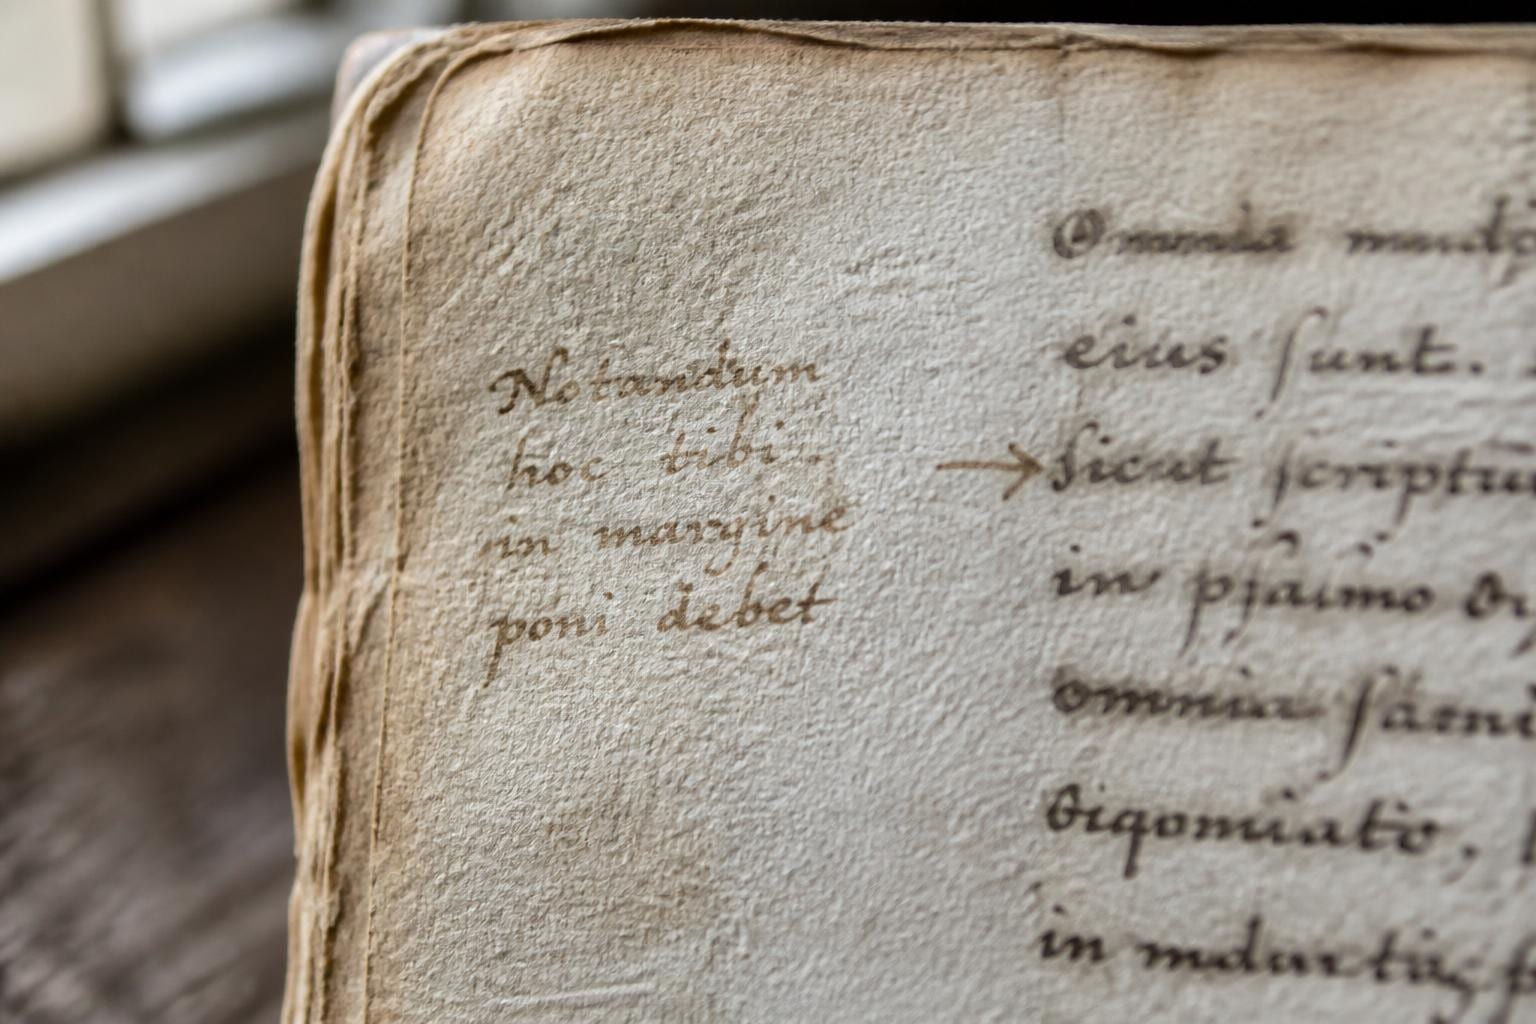
ज्यादातर OCR डेटासेट किसी पृष्ठ को लाइनों का एक सरल ऊपर-से-नीचे, बाएं-से-दाएं स्ट्रीम मानते हैं। वास्तविक प्रतिलिपियां (manuscripts) इस तरह काम नहीं करतीं। मार्जिनलिया (मार्जिन में लिखे गए नोट्स) वास्तविक फुटनोट हो सकते हैं जो अलग से खड़े होते हैं, या वे सुधार हो सकते हैं जिन्हें मुख्य पाठ के एक विशिष्ट, सटीक बिंदु पर पढ़ा जाना चाहिए, ठीक वैसे ही जैसे हमारा ऊपर भूलखोरी वाला लेखक था।
जितना लेखकों को पता है, AraMS-28k पहली रिलीज है जो एक ऐतिहासिक अरबी प्रतिलिपि कॉर्पस के लिए लाइन स्तर पर उस भेद को एनोटेट करती है। हर मार्जिन लाइन को मुख्य-पाठ या मार्जिन के रूप में लेबल किया जाता है, और जब किसी मार्जिन लाइन का मुख्य पाठ में कोई स्पष्ट संलग्न बिंदु होता है, तो उसे पेपर द्वारा 'इंसेर्शन एंकर' (insertion anchor) भी कहा जाता है: एक लिंक जो वापस उसी जगह पर जाता है जहां वह लाइन पढ़ने के क्रम में आती है।
यह एक छोटी सी एनोटेशन चयन जैसा लगता है, लेकिन यह एक डेटासेट और दूसरे के बीच का अंतर है जो मॉडल को अलग-थलग लाइनों को ट्रांसक्राइब करना सिखाता है और एक ऐसा मॉडल जो दस्तावेज़ को क्रम में पढ़ने पर वास्तव में क्या कहता है, उसे पुनर्निर्माण करना सिखाता है। यदि आप प्रतिलिपि OCR (खोज, अनुवाद, उद्धरण) पर कोई डाउनस्ट्रीम एप्लिकेशन बना रहे हैं, तो आपको दूसरी चीज़ की आवश्यकता है। यदि लाइनें गलत अनुक्रम में वापस आती हैं, तो पृष्ठ की हर लाइन का एक परिपूर्ण ट्रांसक्रिप्शन लगभग बेकार है।
वो स्वर जो किसी ने वास्तव में नहीं लिखे
अरबी में एक और मुश्किल है जो OCR और NLP काम को अक्सर उलझा देती है: दीएक्रिटिक्स (diacritics)। ये अक्षरों के ऊपर और नीचे छोटे निशान होते हैं जो छोटे स्वरों और उच्चारण की अन्य विवरणों को दर्शाते हैं। पूरी तरह स्वरबद्ध अरबी, जिसमें हर दीएक्रिटिक चिह्नित हो, पढ़ने में अस्पष्ट नहीं होती। समस्या यह है कि लगभग कोई भी इसे हाथ से इसी तरह नहीं लिखता। लेखक, जैसे आज के अधिकांश अरबी के स्थानीय लेखक, केवल तभी दीएक्रिटिक्स छोड़ देते हैं जब वह वास्तव में आवश्यक हो, संदर्भ और शब्दावली पर भरोसा करते हुए, ठीक वैसे ही जैसे अंग्रेजी पाठक संदर्भ से यह अनुमान लगाते हैं कि "read" शब्द का अर्थ बीत चुका काल है, इसे स्पष्ट रूप से लिखे जाने की आवश्यकता नहीं होती।
इससे एक असंगति उत्पन्न होती है: यदि आपकी संदर्भ ट्रांसक्रिप्शन पूरी तरह स्वरबद्ध हैं (जो उन्हें सटीक और ग्राउंड ट्रुथ के रूप में उपयोगी बनाती हैं) लेकिन मanuscript छवियाँ नहीं हैं, तो एक मॉडल जो इस जोड़ी पर सीधे तौर पर प्रशिक्षित होता है, वह उन दीएक्रिटिक्स को हैलुसिनेट करना सीख लेता है जो कभी भी भौतिक रूप से पृष्ठ पर नहीं थे। AraMS-28k इसका समाधान प्रत्येक पंक्ति की ट्रांसक्रिप्शन के दो संस्करण जारी करके करता है: कच्चा, पूरी तरह स्वरबद्ध पाठ, और एक दीएक्रिटिक-सामान्यीकृत संस्करण जो लेखक द्वारा वास्तव में लिखे गए सामग्री से मेल खाने के लिए सरल बनाया गया है। यह किसी भी मॉडल को प्रशिक्षित करने वाले को यह विकल्प देता है कि वह कार्य को वास्तविकता से मिलाए बजाय अदृश्य स्याही के लिए चुपचाप ओवरफिट होने से बचे।
28,600 पंक्तियों को कैसे लेबल करें बिना दिमाग खोए (या सटीकता खोए)
इतनी मात्रा में ऐतिहासिक सामग्री को हाथ से, पंक्ति-दर-पंक्ति, मार्जिन-दर-मार्जिन, और एंकर-दर-एंकर एनोटेट करना धीमा और महंगा होता है यदि आप केवल मानव विशेषज्ञों पर निर्भर हैं, और त्रुटिपूर्ण होता है यदि आप केवल स्वचालित OCR पर निर्भर हैं। लेखकों ने इस अंतर को पाटने के लिए RefLAM नामक एक पाइपलाइन विकसित की।
मुख्य विचार: एक मल्टीमोडल लार्ज लैंग्वेज मॉडल से मैन्युस्क्रिप्ट पृष्ठ को बिना किसी पूर्व जानकारी के ट्रांसक्राइब करने के लिए कहने और सर्वोत्तम परिणाम की उम्मीद करने के बजाय, RefLAM मॉडल के OCR आउटपुट को उसी पाठ की स्वतंत्र रूप से प्राप्त स्वच्छ ट्रांसक्रिप्शन के साथ संरेखित करता है। दूसरे शब्दों में, यदि किताब का कोई विद्वान संस्करण पहले से ही टाइप किए गए रूप में मौजूद है, तो आप मॉडल के अनुमानों की जांच करने के लिए उसे एक संदर्भ के रूप में उपयोग करते हैं, उन मामलों को पकड़ते हैं जहां मॉडल ने एक अक्षर को गलत पढ़ा या एक शब्द को छोड़ दिया। हर पंक्ति को फिर भी मानव समीक्षा के माध्यम से रूट किया जाता है, इसलिए पाइपलाइन वास्तव में स्वचालित सत्यापन और विशेषज्ञ निगरानी का संयोजन है, न कि किसी एक का विकल्प। यह एक समझदारी भरा डिज़ाइन है: 700 साल पुराने हाथ की लिखावट पर शुद्ध LLM-OCR गलतियां करेगा, और 28,600 पंक्तियों का शुद्ध मैनुअल एनोटेशन एक छोटी टीम के लिए एक बहु-वर्षीय परियोजना है। स्वचालित प्रक्रिया को सत्य के एक स्वतंत्र स्रोत के खिलाफ आधारित करना इस संयोजन को केवल तेज होने के बजाय विश्वसनीय बनाता है।
नस्ख, रुक़ाह, मग्रिबी: एक डेटासेट, एक वास्तविक सामान्यीकरण अंतर
यह पेपर केवल डेटा जारी नहीं करता है। यह दो ओपन-सोर्स HTR (हैंडराइटन टेक्स्ट रिकग्निशन) सिस्टम का उपयोग करके बेसलाइन प्रयोग भी चलाता है: Kraken, जो ऐतिहासिक दस्तावेज़ों की प्रतिलिपि बनाने के लिए डिजिटल मानविकी समुदाय में व्यापक रूप से उपयोग किया जाने वाला इंजन है, और HATFormer, जो एक अधिक हालिया ट्रांसफॉर्मर-आधारित रिकग्निशन मॉडल है। बेसलाइन चलाने का उद्देश्य नया स्टेट-ऑफ-द-आर्ट दावा करना नहीं है; बल्कि यह दिखाना है कि डेटासेट वास्तव में कितना कठिन है और भविष्य के शोधकर्ताओं के लिए एक ऐसा संख्यात्मक मानक प्रदान करना है जिसे तोड़ा जा सके।
यहाँ सबसे उपयोगी परिणाम वह है जिसे लेखक क्रॉस-स्क्रिप्ट जनरलाइज़ेशन ग्रेडिएंट (cross-script generalization gradient) कहते हैं। उन्होंने प्रदर्शन की जाँच ट्रेनिंग के दौरान मॉडल द्वारा देखी गई पृष्ठों के समान पृष्ठों (इन-डिस्ट्रिब्यूशन) पर की, फिर उन किताबों के पृष्ठों पर की जिन्हें मॉडल ने कभी नहीं देखा था। सटीकता में कमी तब आती है जब आप पहले मामले से दूसरे मामले की ओर बढ़ते हैं, और उस कमी का आकार उस अंतर के साथ मेल खाता है कि अज्ञात किताब की लिपि परंपरा मॉडल की ट्रेनिंग से कितनी भिन्न है। एक मॉडल जो नस्ख के साथ सहज है, वह स्वचालित रूप से मग्रिबी को अच्छी तरह नहीं पढ़ पाता, और इसके विपरीत भी। यदि आपने देखा है कि ये लिपि परंपराएँ दृश्य रूप से कितनी भिन्न हैं, तो यह परिणाम आश्चर्यजनक नहीं है, लेकिन एक वास्तविक, होल्ड-आउट डेटासेट पर इसे मात्रात्मक रूप से प्रमाणित करना, बजाय इसके कि इसे माना जाए, ठीक उसी प्रकार का अस्वच्छंद लेकिन उपयोगी निष्कर्ष है जो वास्तविक सिस्टम बनाने वालों को अनुमान लगाने के बजाय उम्मीदों को सही ढंग से सेट करने की अनुमति देता है।
OCR बनाने या खरीदने वाले किसी के लिए यह क्यों मायने रखता है
अगर आप साफ़, मुद्रित, लैटिन-स्क्रिप्ट दस्तावेज़ों से परे किसी भी चीज़ के लिए OCR या डॉक्यूमेंट-AI टूल्ज़ का मूल्यांकन कर रहे हैं, तो यह पेपर तीन मोर्चों पर एक उपयोगी वास्तविकता जाँच (reality check) है।
पहला, "टेक्स्ट पढ़ना" और "टेक्स्ट को सही क्रम में पढ़ना" अलग-अलग क्षमताएँ हैं, और अधिकांश OCR बेंचमार्क केवल पहली चीज़ का परीक्षण करते हैं। पढ़ने का क्रम आधुनिक दस्तावेज़ों के लिए उतना ही महत्वपूर्ण है जितना कि किसी हस्तलिखित प्रति के मार्जिन नोट्स के लिए: मल्टी-कॉलम PDFs, साइडबार वाले फॉर्म्स, स्टैम्प्ड एनोटेशन वाले बीमा दस्तावेज़, या मार्जिन में हाथ से लिखे संशोधनों वाले अनुबंध। एक सिस्टम जो हर किरदार को सही ढंग से ट्रांसक्राइब करता है लेकिन उन्हें गलत अनुक्रम में जोड़ता है, वह आउटपुट देता है जो तार्किक लगता है लेकिन गलत होता है। AraMS-28k के इंसर्शन-एंचर एनोटेशन एक दुर्लभ उदाहरण हैं कि एक डेटासेट वास्तव में इसका मापन करता है बजाय इसके कि यह मान ले कि दस्तावेज़ एक साफ़ ऊर्ध्वाधर धारा है।
दूसरा, एक ही भाषा के अंदर स्क्रिप्ट और शैली में भिन्नता इतनी बड़ी बात है जितनी लगती है। "अरबी OCR" एक समस्या नहीं है; नस्ख, रुक़ा और मग्रेबी इतने अलग व्यवहार करते हैं कि एक के लिए ट्यून किया गया मॉडल दूसरे पर विफल हो सकता है, और इसी तर्क का अनुप्रयोग किसी भी भाषा में हाथ से लिखने की शैलियों, फ़ॉन्ट्स और लेआउट पर होता है। अगर आप किसी प्रोडक्ट के लिए OCR इंजनों के बीच चुनाव कर रहे हैं, तो पूछें कि बेंचमार्क संख्याएँ किस विशिष्ट स्क्रिप्ट, हाथ या दस्तावेज़ शैली पर मापी गई थीं, न कि केवल किस भाषा पर।
तीसरा, ग्राउंड ट्रुथ स्वयं धारणाओं से मुक्त नहीं है। स्वरित-विरुद्ध-अस्वरित दीक्रिटिक स्प्लिट एक याद दिलाता है कि "सही ट्रांसक्रिप्शन" इस बात पर निर्भर करता है कि आप किससे मेल खाने की कोशिश कर रहे हैं, आदर्श विद्वान पाठ या पृष्ठ पर भौतिक रूप से लिखा हुआ। वह भेद अरबी से परे अच्छी तरह सामान्यीकृत होता है: किसी भी OCR ग्राउंड ट्रुथ जो एक साफ़ संदर्भ संस्करण से बना है, उसका खतरा है कि वह मॉडल को वास्तव में लिखे गए बजाय संदर्भ को आउटपुट करने के लिए सिखा सकता है, और यह जाँचने योग्य है कि एक दिया गया बेंचमार्क वास्तव में क्या माप रहा है। मजबूत अंग्रेजी OCR का मतलब यह नहीं है कि देवनागरी OCR भी उतना ही अच्छा होगा; देवनागरी की जटिल संयुक्त वर्णों और शिरोरेखा संरचनाओं के कारण यहाँ अक्सर अलग चुनौतियाँ आती हैं।
यह डेटासेट क्या हल करने का दावा नहीं करता
स्कोप के बारे में ईमानदार होना जरूरी है। चौदह किताबें और 3,043 पेज एक महत्वपूर्ण रिलीज हैं, और लेखकों को ज्ञात इस प्रकार के सबसे बड़े डेटासेट हैं, लेकिन लाखों पेज वाले प्रिंटेड-टेक्स्ट OCR डेटासेट्स की तुलना में यह अभी भी छोटा है, और 629 मार्जिन लाइनें मॉडल को इंसर्शन एंकर्स को भरोसेमंदी से संभालने के लिए प्रशिक्षित करने के लिए एक मध्यम नमूना है। रिपोर्ट किए गए बेसलाइन ठीक वही हैं, बेसलाइन, कोई हल किया हुआ बेंचमार्क नहीं; लेखकों द्वारा पाया गया क्रॉस-स्क्रिप्ट जनरलाइजेशन गैप स्वयं यह सबूत है कि इस डेटा पर प्रशिक्षित मॉडल स्वचालित रूप से इन तीन लिपि परंपराओं या अरबी से बाहर के हस्तलिखित दस्तावेजों पर स्थानांतरित नहीं होगा। और CC BY-NC-SA 4.0 लाइसेंस का मतलब है कि यह शोध के लिए उपलब्ध है, सीधे तौर पर वाणिज्यिक उत्पाद को प्रशिक्षित करने के लिए नहीं।
इनमें से कोई भी योगदान को कमजोर नहीं करता। अच्छे डेटासेट दुर्लभ रूप से किसी समस्या को सीधे तौर पर हल करते हैं; वे समस्या को मापने योग्य बनाते हैं, जो किसी द्वारा वास्तव में इसे हल करने की पूर्व शर्त है। AraMS-28k OCR के उस हिस्से के लिए ऐसा करता है जिसकी आमतौर पर उपेक्षा की जाती है: वे हस्तलिखित दस्तावेज जहां टेक्स्ट सिर्फ पढ़े जाने के लिए इंतजार नहीं करता, उसे पुनर्निर्मित किया जाना होता है।