アラビア語写本は上から下には読まれない、そしてそれを認めるデータセットが今登場
元論文: AraMS-28k: The Largest Publicly Released Line-Level Dataset of Historical Arabic Manuscripts with Margin and Insertion-Anchor Annotations — Mohamed Guechaoui, Mohamed Diaa Zellagui, Souleyman Chaib, Sahraoui Dhelim
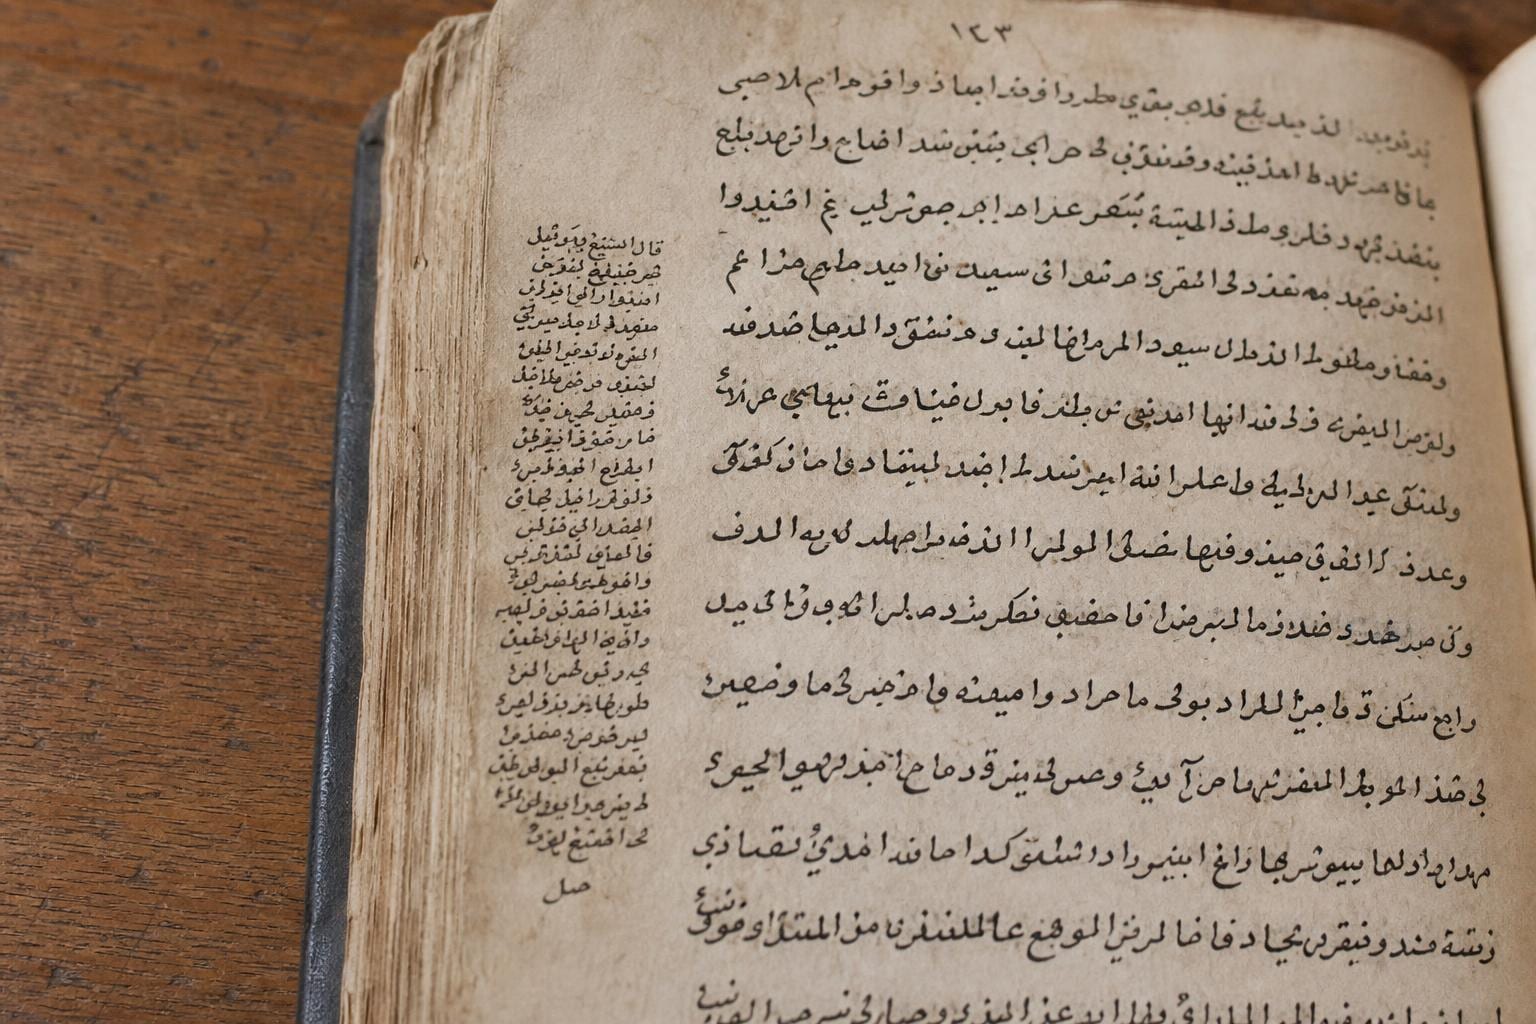
スキャナーの存在すら想像されなかった何世紀も前の、宗教文書を筆写する写経師を想像してください。ページの中ほどまで進んだところで、数段落前にある行を飛ばしてしまっていることに気づきます。バックスペースキーも付箋もありません。そこで、写経師は欠落した行を余白に小さくぎゅうぎゅうに書き込み、それを本来の位置に挿入するための小さな印を付けます。これを数百ページ分に拡大すると、「正しい」読み順がページ外へ蛇行して戻ってくるような写本ができあがります。そして、上から下へ一直線に読み取るOCRシステムは、堂々と無意味な出力を生成することになります。
このまさにその問題を解決しようとしているのが、AraMS-28kという新しいデータセットです。古い文書からテキストを抽出することに少しでも関心があるなら、これは真に有用なインフラストラクチャと言えます。
歴史的アラビア語写本がOCRにとって悪夢である理由
現代のOCRは、現代の印刷された左揃えのテキストには優れています。しかし、手書き文字が導入されると大きく苦戦し、特にアラビア文字ではさらに困難を極めます。その理由は、アラビア文字が単語内の位置によって字形が変化し、隣接する文字と連続した流れるような線として連結されるためです。さらに、何世紀にもわたって地域や書写士によって個人スタイルが大きく異なっていました。この問題の特定の側面には独自の名称があり、印刷されたページを読むという比較的容易なタスクと区別するために、手書き文字認識(HTR)と呼ばれています。
さらに、歴史的な写本をその上に重ねてみましょう。本論文の著者たちは、合計3,043ページ、28,600行の個別に注釈付けされたテキストを含む14冊の実際の写本を収集しました。これらのうち13冊は手書きのコピーで、3つの異なるアラビア文字の伝統を網羅しています。ナスク体(丸みを帯びた格式高い書体で、印刷されたクルアーンで見られるものに近い)、ルカ体(速く簡略化された筆記体)、そしてマグレブ体(北アフリカとアンダルスで発展した角張った書体で、東アラビア文字とは視覚的に十分に異なり、一方の文字で訓練されたモデルが他方で大きく失敗する可能性があります)。1冊は手書きではなくリトグラフ印刷で、データセットにフォーマットの多様性を持たせるために意図的に含まれています。
28,600行のうち、27,971行が本文、629行が余白の注釈です。この余白の数は本文の数に比べて小さく見えますが、このデータセットのリリースが注目すべき価値を持つ理由となる部分です。
余白の注釈は脚注ではなく、迂回である
多くのOCRデータセットは、ページを単純な上から下へ、左から右へのラインのストリームとして扱う。しかし、実際の写本はそう単純には動かない。余白の注釈(マージナリア)は、独立した本物の脚注である場合もあれば、特定の正確な箇所で本文の一部として読むべき修正である場合もある。上記の忘れっぽい写経師の場合と同様である。
AraMS-28kは、著者の知る限り、歴史的アラビア語写本コーパスに対して、この区別をラインレベルで注釈付けた最初のリリースである。すべての余白のラインは、main-text(本文)またはmargin(余白)としてラベル付けされ、余白のラインが本文に明確な接続点を持つ場合、論文で「insertion anchor(挿入アンカー)」と呼ばれる、そのラインが読み順において正確にどこに属するかを示すリンクも付与される。
これは小さな注釈の選択のように聞こえるかもしれないが、これは孤立したラインを転写することをモデルに教えるデータセットと、文書が順序立てて読まれたときに実際に何と言っているかを再構築することをモデルに教えるデータセットとの違いである。写本OCR(検索、翻訳、引用)に基づくダウンストリームアプリケーションを構築している場合、必要なのは後者である。ページ上のすべてのラインの完璧な転写でも、ラインが誤った順序で返ってくれば、ほぼ無意味である。
実際には書き留められていない母音
アラビア語には、多くのOCRやNLPの作業を妨げるもう一つの複雑さがあります。それが「点字(diacritics)」です。これは文字の上下につけられる小さな記号で、短母音やその他の発音の詳細を示します。すべての点字が記された完全な母音表記のアラビア語は、読む際に曖昧さがありません。しかし、問題は、手書きでそのように書く人がほとんどいないという点です。写本を書いた写本家や、現代の多くのアラビア語ネイティブスピーカーは、文脈や語彙に頼って、本当に必要な場合を除いて点字を省略します。これは、英語の読者が文脈から「read」が過去形であると推測し、それを明記する必要がないのと同じです。
これにより、不整合が生じます。参照となる転写テキストが完全な母音表記(これにより正確で、正解データとして有用)である一方、写本の画像がそうではない場合、そのペアリングで素朴に訓練されたモデルは、ページに物理的に存在しなかった点字を幻覚として生成してしまいます。AraMS-28kは、各ラインの転写テキストを2つのバージョンで公開することでこれを処理しています。1つは生データで完全に点字付きのテキスト、もう1つは写本家が実際に書いたものに合わせて点字を正規化したバージョンです。これにより、モデルを訓練する人は、見えないインクに静かに過剰適合するのではなく、タスクを現実に合わせて調整する選択肢を得ることができます。
28,600行のラベリングを、精神を病むことなく(かつ精度を落とすことなく)行う方法
膨大な歴史資料を、行ごとに、余白ごとに、アンカーごとに手作業で注釈付けするのは、純粋に人間の専門家に依存すると時間とコストがかかり、純粋に自動化されたOCRに依存するとエラーが発生しやすい。著者たちはこのギャップを埋めるために、RefLAMというパイプラインを構築した。
基本的なアイデアは、マルチモーダル大規模言語モデルに写本のページをいきなり文字起こしさせて結果に期待するのではなく、RefLAMがモデルのOCR出力を、同じテキストの独立して入手したクリーンな文字起こしと照合することにある。言い換えれば、その本の学術版がすでにタイプされた形で存在している場合、それを参照として使い、モデルの推測結果をチェックして、モデルが文字を読み違えたり単語を落としたりした場合を捕捉する。すべての行は依然として人間のレビューを経由するため、このパイプラインはどちらかを置き換えるものではなく、自動検証と専門家の監督を組み合わせたものである。これは理にかなった設計である。700年前の手書き文字に対して純粋なLLM-OCRを適用すると間違いが生じ、28,600行を純粋に手作業で注釈付けするのは小規模チームにとって数年を要するプロジェクトとなる。自動化された処理を独立した真実の源と照合することで、この組み合わせは単に速いだけでなく、信頼性の高いものとなる。
Naskh、ルクーア、マグレブ:1つのデータセット、そして現実的な汎化ギャップ
本論文はデータセットの公開だけでなく、2つのオープンソースの手書き文字認識(HTR)システムを用いたベースライン実験も実施しています。それらは、歴史的文書の文字起こしにおいてデジタルヒューマニティーズ分野で広く利用されているエンジンであるKrakenと、より最近のトランスフォーマーベースの認識モデルであるHATFormerです。ベースラインを実行する目的は、新しい最良の性能(state of the art)を主張することではありません。むしろ、データセットの実際の難易度を示し、将来の研究者が上回るべき数値を提供することにあります。
ここで最も有用な結果は、著者が「クロススクリプトの汎化グラデーション」と呼んでいるものです。モデルが学習中に類似のページを見た場合(インディストリビューション)と、モデルが全く見たことのない本からのページで性能をテストしました。精度は前者から後者へ移行するにつれて低下し、その低下の大きさは、見知らぬ本の書写伝統がモデルの学習対象からどれほど異なるかによって連動します。Naskhに慣れたモデルが自動的にMaghrebiを正確に読むわけではなく、その逆も同様です。これらの書写伝統が視覚的にどれほど異なるかを考慮すれば、これは驚くべき結果ではありません。しかし、仮定ではなく、実際のホールドアウトデータセット上でこれを定量化したことは、実システムを構築する人々が推測ではなく正確な期待値を設定できるようにする、地味だが有用な発見の典型例です。
OCRの構築・購入を検討するすべての方にとってなぜ重要なのか
クリーンな印刷されたラテン文字の文書以外の用途でOCRやドキュメントAIツールを評価している場合、本論文は3つの側面から有用な現実チェックとなります。
第一に、「テキストを読み取る」ことと、「正しい順序でテキストを読み取る」ことは異なる能力であり、ほとんどのOCRベンチマークは前者のみをテストしています。読み取り順序は、写本の余白注釈だけでなく、現代の文書(マルチカラムPDF、サイドバー付きフォーム、スタンプ注記のある保険書類、余白に手書きの修正がある契約書など)においても同様に重要です。すべての文字を正しく転写しても、間違った順序で結合してしまうシステムは、一見妥当に見えるが実際には誤った出力を生成します。AraMS-28kの挿入アンカー注釈は、文書を単一のクリーンな垂直ストリームと仮定するのではなく、実際にこの能力を測定するデータセットの稀な例です。
第二に、単一言語内での文字体系やスタイルのばらつきは、思われている以上に大きな問題です。「アラビア語OCR」は単一の問題ではなく、ナスク体、ルカ体、マグレブ体はそれぞれ異なる挙動を示すため、ある体系に最適化されたモデルが別の体系で失敗することがあります。この論理は、あらゆる言語の手書きスタイル、フォント、レイアウトにも適用されます。製品用のOCRエンジンを選択する際は、どの言語かだけでなく、ベンチマークの数値がどの特定の文字体系、手書き、または文書スタイルで測定されたかを問いかけるべきです。
第三に、グラウンドトゥルース(正解データ)自体も仮定から自由ではありません。母音記号付きと無しの分割は、「正しい転写」が、理想化された学術テキストとページ上に物理的に書かれているもののどちらに一致させようとするかによって異なることを思い出させます。この区別はアラビア語を超えて広く一般化されます。クリーンな参照版から構築されたOCRグラウンドトゥルースは、実際に書かれているものではなく参照版を出力するようにモデルを学習させるリスクがあり、特定のベンチマークが実際に何を測定しているかを確認する価値があります。日本語のOCRやVLMモデルにとって最も困難なケースの一つである、縦書きの日本語(漢字+仮名)を扱えない場合、その欠落は日本語読者にとって実用的な適用範囲の制限を意味します。
このデータセットが解決すると主張していないこと
範囲について正直に述べる価値がある。14冊、3,043ページという規模は意義あるリリースであり、著者が知る限り同種のデータセットとしては最大のものだが、数百万ページに及ぶ印刷テキストのOCRデータセットと比較すれば依然として小さく、629本の余白線は、挿入アンカーを確実に処理するモデルを単独で訓練するには控えめなサンプル数である。報告されているベースラインはまさにそれ、つまりベースラインであり、解決済みのベンチマークではない。著者が見出したクロススクリプトの汎化ギャップ自体が、このデータで訓練されたモデルが、この3つのスクリプト伝統の外側、あるいはアラビア語全体から外れた写本に自動的に転移しないことを示す証拠である。また、CC BY-NC-SA 4.0ライセンスは、商用製品の訓練には直接使用できず、研究目的での利用であることを意味する。
これらのことは、その貢献を損なうものではない。優れたデータセットは、問題を即座に解決するものではなく、問題を測定可能にするものであり、それは実際に問題を解決するための前提条件である。AraMS-28kは、通常無視されがちなOCRの一部分、すなわち、テキストがただそこに存在して読まれるのを待っているのではなく、再構築しなければならない写本において、その役割を果たしている。