Los manuscritos árabes no se leen de arriba a abajo, y ahora hay un conjunto de datos que lo admite
Basado en: AraMS-28k: The Largest Publicly Released Line-Level Dataset of Historical Arabic Manuscripts with Margin and Insertion-Anchor Annotations — Mohamed Guechaoui, Mohamed Diaa Zellagui, Souleyman Chaib, Sahraoui Dhelim
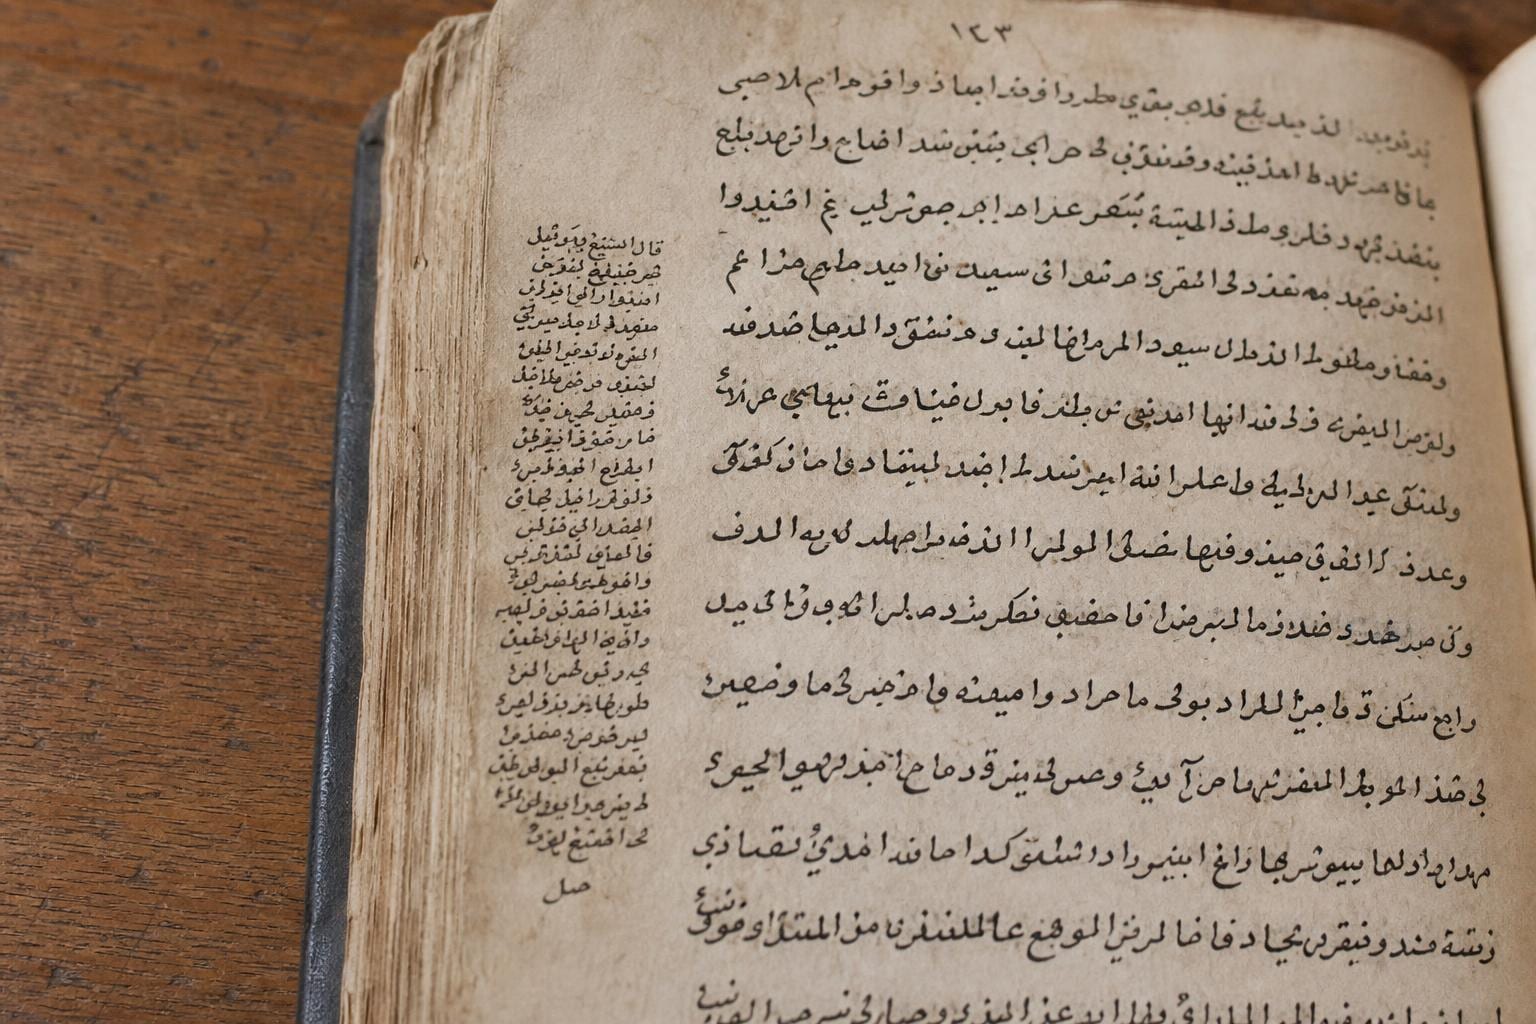
Imagina a un escriba copiando un texto religioso a mano, siglos antes de que nadie imaginara un escáner. A mitad de la página, se da cuenta de que se saltó una línea unos párrafos atrás. No hay retroceso, ni nota adhesiva. Así que escribe la línea faltante en el margen, pequeña y apretada, y dibuja una pequeña marca que indica exactamente dónde encaja de nuevo. Multiplica eso por cientos de páginas y obtienes un manuscrito donde el orden de lectura "correcto" zigzaguea fuera de la página y vuelve, y cualquier sistema de OCR que lea de arriba a abajo en línea recta producirá con confianza un sinsentido.
Ese es exactamente el problema que un nuevo conjunto de datos llamado AraMS-28k busca resolver, y es una pieza de infraestructura genuinamente útil si te interesa extraer texto de documentos antiguos.
Por qué los manuscritos árabes históricos son una pesadilla para el OCR
El OCR moderno funciona bien con texto impreso moderno y alineado a la izquierda. Tiene muchas dificultades en cuanto se introduce la escritura manuscrita, y aún más con la escritura árabe específicamente, porque las letras árabes cambian de forma dependiendo de su posición en una palabra, se conectan con sus vecinas en una línea continua y fluida, y a menudo fueron escritas por escribas con estilos personales muy diferentes a lo largo de los siglos y las regiones. Esta variante particular del problema tiene su propio nombre: reconocimiento de texto manuscrito, o HTR, distinguiéndolo de la tarea comparativamente sencilla de leer una página impresa.
Ahora añada manuscritos históricos a eso. Los autores del artículo reunieron 14 libros de manuscritos reales, con un total de 3.043 páginas y 28.600 líneas de texto anotadas individualmente. Trece de los libros son copias manuscritas, que abarcan tres tradiciones distintas de escritura árabe: Naskh (una escritura redondeada y formal, aún cercana a lo que se vería en un Corán impreso), Ruq'ah (un estilo cursivo rápido y simplificado) y Maghrebi (la tradición de escritura angular que se desarrolló en el norte de África y Al-Ándalus, visualmente distinta de las escrituras árabes orientales, de modo que un modelo entrenado con una puede fallar gravemente con la otra). Un libro es una impresión litográfica en lugar de manuscrito, incluido específicamente para darle al conjunto de datos cierta variedad de formatos.
De las 28.600 líneas, 27.971 son de texto principal y 629 son anotaciones al margen. Ese número de márgenes parece pequeño en comparación con el de texto principal, pero es la parte del conjunto de datos que hace que esta publicación valga la pena prestarle atención.
La nota al margen no es una nota a pie de página, es un desvío
La mayoría de los conjuntos de datos de OCR tratan una página como un flujo simple de líneas de arriba a abajo y de izquierda a derecha. Los manuscritos reales no funcionan así. Las anotaciones marginales (notas escritas en los márgenes) pueden ser notas a pie de página genuinas que se leen de forma independiente, o pueden ser correcciones destinadas a leerse como parte del texto principal en un punto específico y preciso, exactamente como el escriba olvidadizo mencionado anteriormente.
AraMS-28k es, según los autores, la primera publicación que anota esta distinción a nivel de línea para un corpus de manuscritos árabes históricos. Cada línea del margen se etiqueta como texto principal o margen, y cuando una línea del margen tiene un punto de unión inequívoco en el texto principal, también recibe lo que el artículo denomina un ancla de inserción: un enlace hacia el lugar exacto donde esa línea pertenece en el orden de lectura.
Esto puede parecer una pequeña decisión de anotación, pero es la diferencia entre un conjunto de datos que enseña a un modelo a transcribir líneas aisladas y uno que enseña a un modelo a reconstruir lo que el documento realmente dice cuando se lee en orden. Si estás desarrollando cualquier aplicación posterior basada en OCR de manuscritos (búsqueda, traducción, citas), lo que necesitas es la segunda opción. Una transcripción perfecta de cada línea de una página es casi inútil si las líneas se devuelven en el orden incorrecto.
Las vocales que nadie escribía realmente
El árabe tiene una segunda particularidad que complica mucho el trabajo de OCR y PLN: los diacríticos. Se trata de pequeñas marcas situadas sobre y debajo de las letras que indican vocales cortas y otros detalles de pronunciación. El árabe completamente vocalizado, con cada diacrítico marcado, es inequívoco a la lectura. El problema es que casi nadie escribe así a mano. Los copistas, al igual que la mayoría de los hablantes nativos de árabe hoy en día, omitían los diacríticos excepto cuando eran realmente necesarios, confiando en el contexto y el vocabulario, de la misma manera que los lectores de inglés infieren por el contexto que "read" está en pasado, sin necesidad de que se escriba explícitamente.
Esto crea una discrepancia: si las transcripciones de referencia están completamente vocalizadas (lo que las hace precisas y útiles como verdad de base), pero las imágenes de los manuscritos no lo están, un modelo entrenado ingenuamente con ese emparejamiento aprenderá a alucinar diacríticos que nunca estuvieron físicamente en la página. AraMS-28k aborda este problema publicando dos versiones de la transcripción de cada línea: el texto crudo, completamente diacritizado, y una versión normalizada de diacríticos, reducida para coincidir con lo que un copista escribió realmente. Esto ofrece a quien entrena un modelo la opción de adaptar la tarea a la realidad, en lugar de sobreajustarse silenciosamente a "tinta invisible".
Cómo etiquetar 28.600 líneas sin perder la cabeza (ni la precisión)
Anotar manualmente este volumen de material histórico, línea por línea, margen por margen y ancla por ancla, es lento y costoso si se depende exclusivamente de expertos humanos, y propenso a errores si se confía únicamente en la OCR automatizada. Los autores construyeron una tubería llamada RefLAM para encontrar un punto medio.
La idea central: en lugar de pedirle a un modelo de lenguaje multimodal grande que transcriba una página de manuscrito desde cero y esperar lo mejor, RefLAM alinea la salida de OCR del modelo con transcripciones limpias y obtenidas de forma independiente del mismo texto. En otras palabras, si ya existe una edición académica del libro en formato mecanografiado, se utiliza como referencia para verificar las suposiciones del modelo, detectando casos en los que el modelo leyó mal una letra u omitió una palabra. Cada línea sigue siendo revisada por humanos, por lo que la tubería es realmente una verificación automática más supervisión experta, no un reemplazo de ninguna de las dos. Es un diseño sensato: la OCR-LLM pura sobre escritura manuscrita de 700 años de antigüedad cometerá errores, y la anotación manual pura de 28.600 líneas es un proyecto de varios años para un equipo pequeño. Fundamentar el paso automatizado contra una fuente de verdad independiente es lo que hace que la combinación sea confiable en lugar de simplemente rápida.
Naskh, Ruq'ah, Maghrebi: un conjunto de datos, un verdadero hueco de generalización
El artículo no solo publica los datos. También ejecuta experimentos de reconocimiento de texto manuscrito (HTR) de línea base utilizando dos sistemas HTR de código abierto: Kraken, un motor ampliamente utilizado en la comunidad de humanidades digitales para transcribir documentos históricos, y HATFormer, un modelo de reconocimiento basado en transformers más reciente. El objetivo de ejecutar las líneas base no es afirmar un nuevo estado del arte; es mostrar qué tan difícil es realmente el conjunto de datos y proporcionar a los futuros investigadores un número que superar.
El resultado más útil aquí es lo que los autores llaman un gradiente de generalización entre scripts. Probaron el rendimiento en páginas similares a las que el modelo vio durante el entrenamiento (dentro de la distribución), y luego en páginas de libros que el modelo nunca había visto. La precisión disminuye al pasar del primer caso al segundo, y la magnitud de esa disminución se correlaciona con cuán diferente es la tradición de escritura del libro no visto de lo que el modelo entrenó. Un modelo que se siente cómodo con Naskh no lee automáticamente bien Maghrebi, y viceversa. Ese no es un resultado sorprendente si has visto cuán visualmente diferentes son estas tradiciones de escritura, pero tenerlo cuantificado en un conjunto de datos real y retenido, en lugar de asumido, es exactamente el tipo de hallazgo poco glamoroso pero útil que permite a las personas que construyen sistemas reales establecer expectativas correctamente en lugar de adivinar.
Por qué importa para quien construye o compra OCR
Si estás evaluando herramientas de OCR o de IA documental para algo más allá de documentos impresos limpios y en escritura latina, este artículo es una útil realidad en tres frentes.
Primero, "leer el texto" y "leer el texto en el orden correcto" son capacidades distintas, y la mayoría de los benchmarks de OCR solo prueban la primera. El orden de lectura importa tanto en documentos modernos como en las notas al margen de un manuscrito: PDFs de varias columnas, formularios con barras laterales, documentos de seguros con anotaciones selladas, contratos con enmiendas manuscritas al margen. Un sistema que transcribe cada carácter correctamente pero los une en la secuencia equivocada produce una salida que parece plausible pero es incorrecta. Las anotaciones de anclaje de inserción de AraMS-28k son un ejemplo raro de un conjunto de datos que realmente mide esto, en lugar de asumir que un documento es un flujo vertical limpio.
Segundo, la variación de escritura y estilo dentro de un solo idioma es más importante de lo que parece. "OCR árabe" no es un solo problema; Naskh, Ruq'ah y Maghrebi se comportan de manera lo suficientemente distinta para que un modelo ajustado para uno falle en otro, y la misma lógica se aplica a estilos de escritura a mano, fuentes y diseños en cualquier idioma. Si estás eligiendo entre motores de OCR para un producto, pregunta sobre qué escrituras, manos o estilos de documento específicos se midieron los números del benchmark, no solo sobre qué idioma.
Tercero, la verdad fundamental (ground truth) no está libre de suposiciones. La división entre diacríticos vocalizados y no vocalizados es un recordatorio de que "la transcripción correcta" depende de lo que intentas coincidir: el texto académico idealizado o lo que está físicamente en la página. Esa distinción se generaliza bien más allá del árabe: cualquier verdad fundamental de OCR construida a partir de una edición de referencia limpia corre el riesgo de enseñar al modelo a producir la referencia en lugar de lo que realmente está escrito, y vale la pena verificar qué es lo que un benchmark dado está realmente midiendo.
Lo que este conjunto de datos no pretende resolver
Conviene ser honestos sobre el alcance. Catorce libros y 3.043 páginas constituyen un lanzamiento significativo y el más grande de su tipo que los autores conocen, pero sigue siendo pequeño en comparación con los conjuntos de datos de OCR de texto impreso que alcanzan los millones de páginas, y 629 líneas de margen son una muestra modesta para entrenar un modelo que maneje los anclajes de inserción de manera fiable por sí solo. Las líneas base reportadas son exactamente eso, líneas base, no un punto de referencia resuelto; la brecha de generalización entre scripts que los autores encontraron es en sí misma evidencia de que un modelo entrenado con estos datos no se transferirá automáticamente a manuscritos fuera de estas tres tradiciones de escritura o fuera del árabe por completo. Y la licencia CC BY-NC-SA 4.0 significa que está disponible para investigación, no para entrenar un producto comercial directamente.
Nada de eso resta valor a la contribución. Los buenos conjuntos de datos rara vez resuelven un problema por completo; hacen que el problema sea medible, lo cual es la condición previa para que alguien realmente lo resuelva. AraMS-28k hace eso para una parte del OCR que suele ser ignorada: los manuscritos donde el texto no solo está allí esperando ser leído, sino que tiene que ser reconstruido.