Manuscritos árabes não são lidos de cima para baixo, e agora há um conjunto de dados que admite isso
Baseado em: AraMS-28k: The Largest Publicly Released Line-Level Dataset of Historical Arabic Manuscripts with Margin and Insertion-Anchor Annotations — Mohamed Guechaoui, Mohamed Diaa Zellagui, Souleyman Chaib, Sahraoui Dhelim
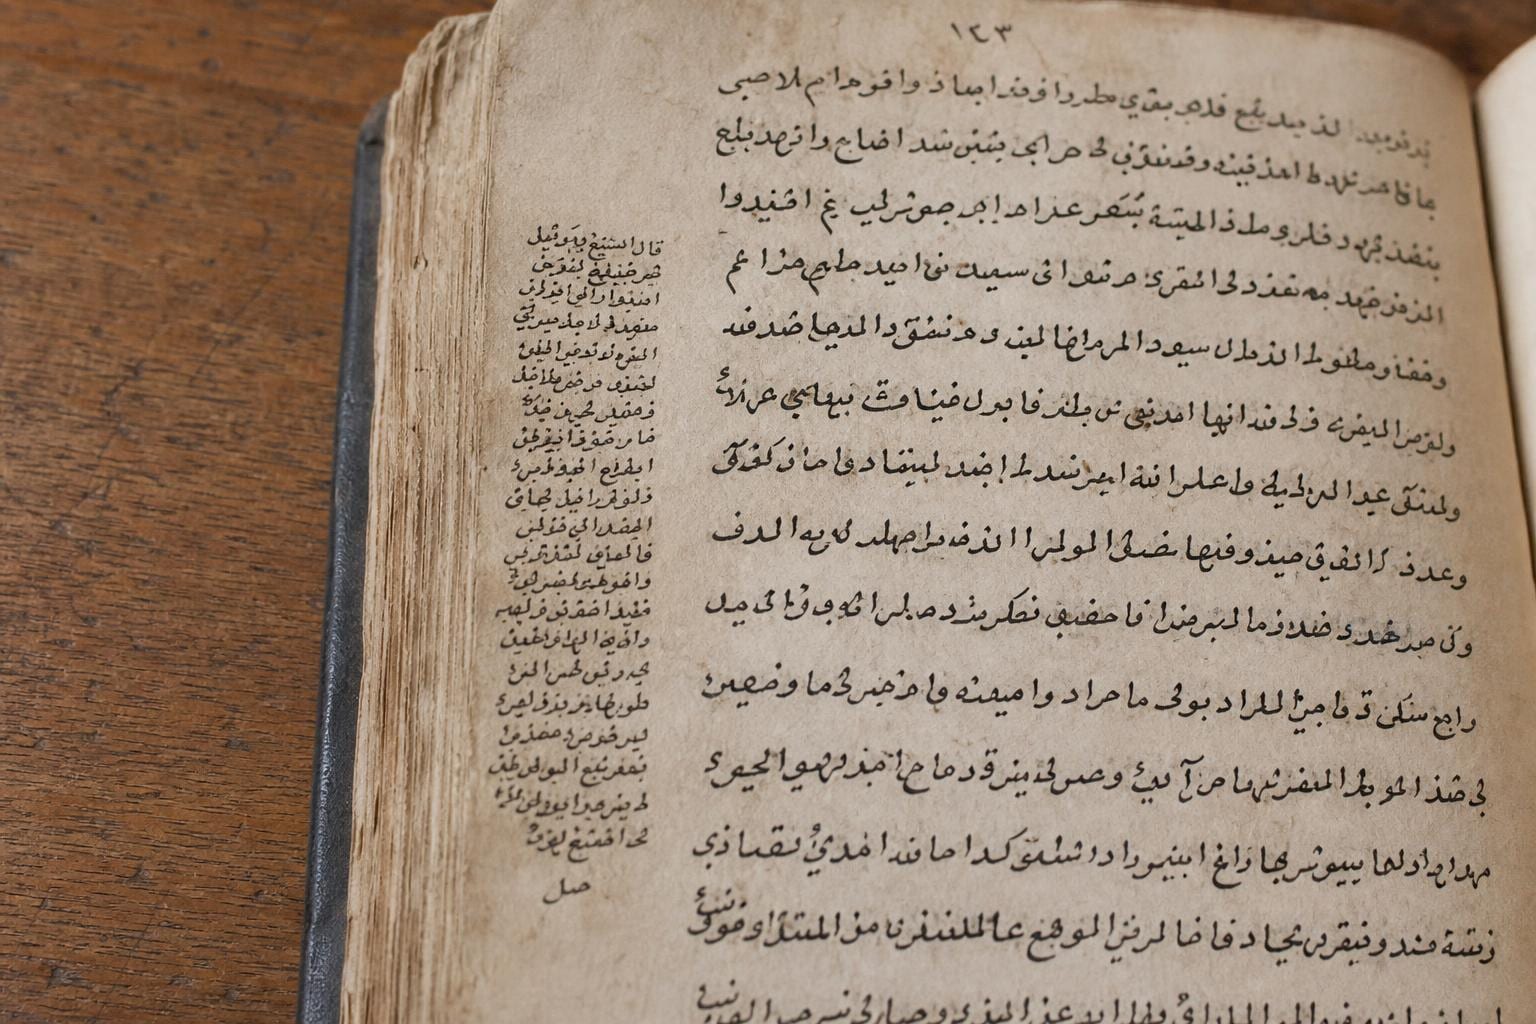
Imagine um escriba copiando um texto religioso à mão, séculos antes que alguém imaginasse um scanner. No meio da página, ele percebe que uma linha foi pulada alguns parágrafos atrás. Não há backspace, nem post-it. Então, ele escreve a linha faltante na margem, pequena e apertada, e desenha uma pequena marca indicando exatamente onde ela deve ser inserida. Multiplique isso por centenas de páginas e você terá um manuscrito onde a ordem de leitura "correta" faz zigue-zague fora da página e de volta, e qualquer sistema de OCR que leia de cima para baixo em linha reta produzirá, com confiança, um texto sem sentido.
Esse é exatamente o problema que um novo conjunto de dados chamado AraMS-28k busca resolver, e é uma peça de infraestrutura genuinamente útil se você se importa em extrair texto de documentos antigos.
Por que os manuscritos árabes históricos são um pesadelo para o OCR
O OCR moderno é bom com textos modernos, impressos e alinhados à esquerda. Ele tem muita dificuldade assim que você introduz manuscritos, e tem ainda mais dificuldade com o script árabe especificamente, porque as letras árabes mudam de forma dependendo de onde estão na palavra, conectam-se aos vizinhos em uma linha contínua e fluida, e eram frequentemente escritas por escribas com estilos pessoais muito diferentes ao longo dos séculos e regiões. Este sabor particular do problema tem seu próprio nome: reconhecimento de texto manuscrito, ou HTR, distinguindo-o da tarefa comparativamente tranquila de ler uma página impressa.
Agora, empilhe manuscritos históricos sobre isso. Os autores do artigo reuniram 14 livros de manuscritos reais, totalizando 3.043 páginas e 28.600 linhas de texto individualmente anotadas. Treze dos livros são copiados à mão, abrangendo três tradições distintas de script árabe: Naskh (um script arredondado e formal, ainda próximo do que você veria em um Alcorão impresso), Ruq'ah (um estilo cursivo rápido e simplificado) e Maghrebi (a tradição de script angular que se desenvolveu no Norte da África e na Andaluzia, visualmente distinta o suficiente dos scripts árabes orientais para que um modelo treinado em um possa falhar gravemente no outro). Um livro é uma impressão litografada em vez de manuscrito, incluído especificamente para dar ao conjunto de dados alguma variedade de formato.
Das 28.600 linhas, 27.971 são de texto principal e 629 são anotações de margem. Esse número de margem parece pequeno em comparação com a contagem de texto principal, mas é a parte do conjunto de dados que torna este lançamento digno de atenção.
A nota na margem não é uma nota de rodapé, é um desvio
A maioria dos conjuntos de dados de OCR trata uma página como um fluxo simples de linhas, de cima para baixo e da esquerda para a direita. Manuscritos reais não funcionam dessa maneira. As marginalia (notas escritas nas margens) podem ser notas de rodapé genuínas que se sustentam sozinhas, ou podem ser correções destinadas a serem lidas como parte do texto principal em um ponto específico e preciso, exatamente como o escriba esquecível acima.
O AraMS-28k é o primeiro lançamento, segundo os autores, a anotar essa distinção no nível de linha para um corpus de manuscritos árabes históricos. Cada linha de margem recebe a etiqueta de texto principal ou margem, e quando uma linha de margem tem um ponto de anexação inequívoco no texto principal, ela também recebe o que o artigo chama de âncora de inserção: um link de volta para exatamente onde essa linha pertence na ordem de leitura.
Isso parece uma pequena escolha de anotação, mas é a diferença entre um conjunto de dados que ensina um modelo a transcrever linhas isoladas e um que ensina um modelo a reconstruir o que o documento realmente diz quando lido na ordem. Se você está construindo qualquer aplicativo downstream baseado em OCR de manuscritos (busca, tradução, citação), é a segunda coisa que você precisa. Uma transcrição perfeita de cada linha em uma página é quase inútil se as linhas retornarem na sequência errada.
As vogais que ninguém realmente anotava
O árabe tem uma segunda particularidade que atrapalha muito o trabalho de OCR e PLN: os diacríticos. São pequenos sinais acima e abaixo das letras que indicam vogais curtas e outros detalhes de pronúncia. O árabe totalmente vocalizado, com todos os diacríticos marcados, é inequívoco na leitura. O problema é que quase ninguém escreve assim à mão. Os escribas, assim como a maioria dos falantes nativos de árabe hoje, omitiam os diacríticos, exceto quando genuinamente necessários, confiando no contexto e no vocabulário, da mesma forma que leitores de inglês inferem que "read" está no passado pelo contexto, em vez de precisar que isso seja explicitado na grafia.
Isso cria uma discrepância: se as transcrições de referência forem totalmente vocalizadas (o que as torna precisas e úteis como verdade fundamental), mas as imagens dos manuscritos não estiverem, um modelo treinado ingenuamente nesse pareamento aprenderá a alucinar diacríticos que nunca estiveram fisicamente na página. O AraMS-28k lida com isso disponibilizando duas versões da transcrição de cada linha: o texto bruto, totalmente diacritizado, e uma versão normalizada de diacríticos, simplificada para corresponder ao que um escriba realmente escreveu. Isso oferece a quem treinar um modelo a opção de alinhar a tarefa à realidade, em vez de superajustar silenciosamente a "tinta invisível".
Como anotar 28.600 linhas sem perder a cabeça (ou a precisão)
Anotar manualmente esse volume de material histórico, linha por linha, margem por margem, âncora por âncora, é lento e caro se você depender puramente de especialistas humanos, e propenso a erros se depender puramente de OCR automatizado. Os autores construíram um pipeline chamado RefLAM para equilibrar as duas abordagens.
A ideia central: em vez de pedir a um grande modelo de linguagem multimodal que transcreva uma página de manuscrito do zero e torcer pelo melhor resultado, o RefLAM alinha a saída de OCR do modelo com transcrições limpas e independentes do mesmo texto. Em outras palavras, se já existe uma edição acadêmica do livro em formato digitado, você usa isso como referência para verificar as suposições do modelo, capturando casos em que o modelo leu uma letra incorretamente ou omitiu uma palavra. Cada linha ainda passa por revisão humana, então o pipeline é realmente uma verificação automática mais supervisão especializada, não um substituto para nenhum dos dois. Esse é um design sensato: OCR puro com LLM em caligrafia de 700 anos vai cometer erros, e a anotação manual pura de 28.600 linhas é um projeto de vários anos para uma equipe pequena. Ancorar a passagem automatizada em uma fonte de verdade independente é o que torna a combinação confiável, e não apenas rápida.
Naskh, Ruq'ah, Maghrebi: um único conjunto de dados, um verdadeiro gap de generalização
O artigo não apenas libera os dados. Ele também executa experimentos de linha de base para reconhecimento de texto manuscrito (HTR) usando dois sistemas de HTR de código aberto: Kraken, um mecanismo amplamente utilizado na comunidade de humanidades digitais para transcrever documentos históricos, e HATFormer, um modelo de reconhecimento mais recente baseado em transformers. O objetivo de executar as linhas de base não é reivindicar um novo estado da arte; é mostrar o quão difícil o conjunto de dados realmente é e dar aos pesquisadores futuros uma métrica para superar.
O resultado mais útil aqui é o que os autores chamam de gradiente de generalização entre scripts. Eles testaram o desempenho em páginas semelhantes às que o modelo viu durante o treinamento (in-distribution) e, em seguida, em páginas de livros que o modelo nunca viu antes. A precisão cai ao passar do primeiro caso para o segundo, e a magnitude dessa queda acompanha o quão diferente a tradição de escrita do livro não visto é daquela em que o modelo foi treinado. Um modelo que se sai bem com Naskh não lê Maghrebi automaticamente bem, e vice-versa. Esse não é um resultado surpreendente se você já observou o quão visualmente diferentes são essas tradições de escrita, mas tê-lo quantificado em um conjunto de dados real e retido, em vez de assumido, é exatamente o tipo de descoberta despretensiosa e útil que permite que pessoas que constroem sistemas reais definam expectativas corretamente, em vez de adivinhar.
Por que isso importa para quem constrói ou compra soluções de OCR
Se você está avaliando ferramentas de OCR ou de IA para documentos para algo além de documentos impressos limpos em alfabeto latino, este artigo é uma útil realidade em três frentes.
Primeiro, "ler o texto" e "ler o texto na ordem correta" são capacidades diferentes, e a maioria dos benchmarks de OCR testa apenas a primeira. A ordem de leitura é tão importante para documentos modernos quanto para notas de margem em um manuscrito: PDFs com múltiplas colunas, formulários com barras laterais, documentos de seguro com anotações carimbadas, contratos com emendas manuscritas na margem. Um sistema que transcreve cada caractere corretamente, mas os une na sequência errada, produz uma saída que parece plausível, mas está errada. As anotações de âncora de inserção do AraMS-28k são um exemplo raro de um conjunto de dados que realmente mede isso, em vez de assumir que um documento é um fluxo vertical limpo.
Segundo, a variação de script e estilo dentro de um único idioma é mais significativa do que parece. "OCR árabe" não é um único problema; Naskh, Ruq'ah e Maghrebi se comportam de maneira diferente o suficiente para que um modelo ajustado para um possa falhar em outro, e a mesma lógica se aplica a estilos de caligrafia, fontes e layouts em qualquer idioma. Se você está escolhendo entre motores de OCR para um produto, pergunte em quais scripts, mãos ou estilos de documentos específicos os números do benchmark foram medidos, não apenas em qual idioma.
Terceiro, a verdade fundamental (ground truth) não está livre de pressupostos. A divisão entre diacríticos vocalizados e não vocalizados é um lembrete de que "a transcrição correta" depende do que você está tentando corresponder: o texto acadêmico idealizado ou o que está fisicamente na página. Essa distinção se generaliza bem além do árabe: qualquer verdade fundamental de OCR construída a partir de uma edição de referência limpa corre o risco de ensinar um modelo a produzir a referência em vez do que está realmente escrito, e vale a pena verificar qual deles um determinado benchmark está realmente medindo.
O que este conjunto de dados não afirma resolver
Vale a pena ser honesto sobre o escopo. Quatorze livros e 3.043 páginas constituem um lançamento significativo, e o maior do seu tipo do qual os autores têm conhecimento, mas ainda é pequeno em comparação com conjuntos de dados de OCR de texto impresso que chegam a milhões de páginas, e 629 linhas de margem são uma amostra modesta para treinar um modelo a lidar com âncoras de inserção de forma fiável por si só. As linhas de base reportadas são exatamente isso, linhas de base, não um benchmark resolvido; a lacuna de generalização entre scripts que os autores encontraram é em si mesma evidência de que um modelo treinado nestes dados não transferirá automaticamente para manuscritos fora destas três tradições de script ou fora do árabe inteiramente. E a licença CC BY-NC-SA 4.0 significa que está disponível para investigação, não para treinar um produto comercial diretamente.
Nada disso diminui a contribuição. Bons conjuntos de dados raramente resolvem um problema diretamente; eles tornam o problema mensurável, o que é a condição prévia para alguém realmente resolvê-lo. O AraMS-28k faz isso para uma parte do OCR que é geralmente ignorada: os manuscritos onde o texto não apenas fica lá esperando para ser lido, ele precisa ser reconstruído.